BPaaS時代に必要な新職種「AIオペレーションマネージャー」とは

―人とAIの境界を設計するBPaaS AIオペレーション像―
kubellでBPaaSでAIエージェントベースのサービスに取り組んでいる藤井です。現在は、まずは経理領域をメインにBPaaS化に取り組んでおります。
本記事の想定読者
SaaSに携わるPdM・エンジニア・Opsリーダー向けに、「Sell Work / BPaaS時代のAIオペレーション設計」を体系化した内容です。「ソフトウェアだけでは顧客の課題を解決しきれない」「業務そのものを提供するにはどう設計すればいいか悩んでいる」と感じる方の参考になればと思いまとめました。
「AIオペレーションマネージャー」という職種、聞いたことはありますか?
本記事では、AIオペレーションマネージャーを「人とAIの境界を設計し、業務プロセスを再構築する責任者」と定義し、その必要性と役割を解説します。
まずは、この役職が求められる背景を理解するために、現場で起きている「あるある」を振り返ってみましょう。
SaaS導入後の「あるある」
・SaaSを入れたのに、結局申請方法や科目をExcelで管理している
・ツールに詳しい人が退職したら、業務が止まった
・複数のシステムを行き来して、1つの処理を完了させている
・「自動化」したはずなのに、教育やマニュアル化などの手作業が増えている
・経費精算SaaSで選択すべき科目の問合せが多く、結局運用コストが高くなってしまった
心当たりはありませんか?
SaaSは業務効率化の切り札だったはずです。しかし現実には、ツールが増えるほど業務は複雑になり、「あっちで申請、こっちで承認、結果はスプレッドシート」という状態が生まれています。
この構造的な問題に対する一つの解が、「ソフトウェアの提供」から「業務そのものの提供」へのシフトです。
Sell SoftwareからSell Workへ
SaaS企業のビジネスモデルは「Sell Software」ソフトウェアを売ることでした。顧客は自らツールを操作して業務を遂行し、提供者はソフトウェアの機能改善に注力していました。
しかし今、新しいモデルが台頭しています。「Sell Work」業務そのものを売るモデルです。
Sell Workモデルでは、ソフトウェアは「提供手段」に過ぎません。顧客にとっての価値は「業務が完了すること」です。
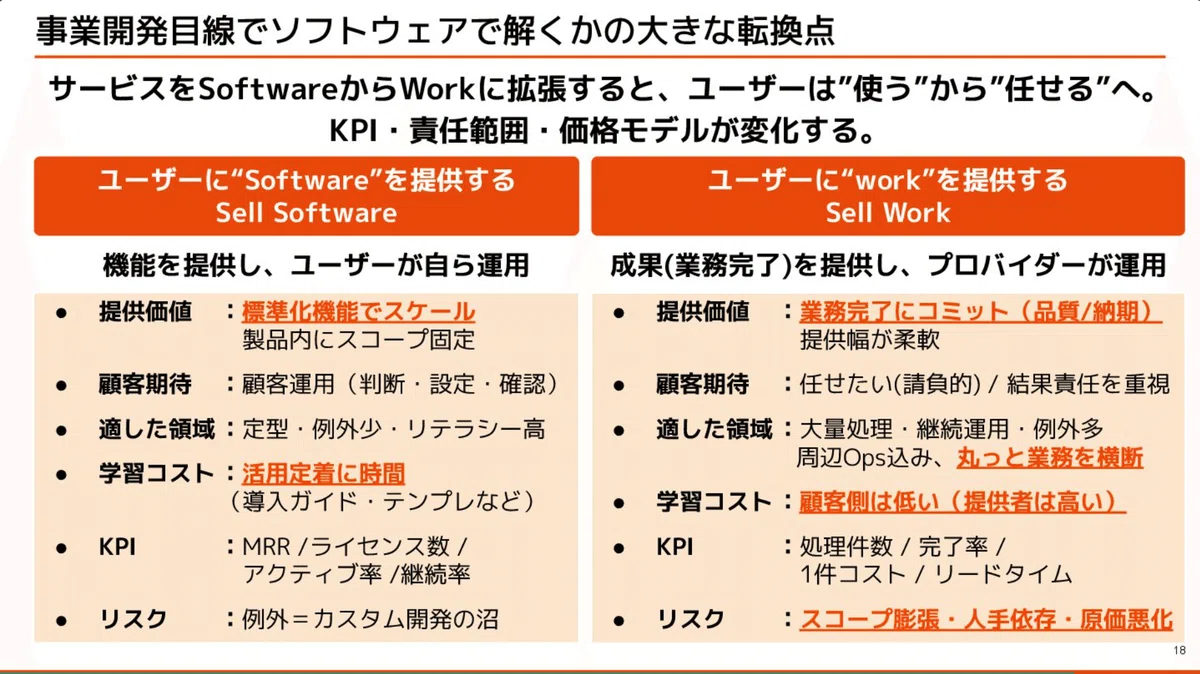
業務というのは、これまでシステム化や自動化出来ていない領域も含まれています。また、業務の内容によって判断や幅が存在します。
私自身、ERPや業務システムに関わる中で、「ソフトウェアだけではただの箱になってしまう」という限界を感じることがありました。どれだけUXを磨いても、結局はユーザーの入力サポートから抜け出せない。「そもそも、このシステムへの入力作業自体、いらないのではないか?」そんな根源的な問いが、BPaaSへのシフトの背景にあります。
AIの進化がもたらす新しい問い
「この業務、人がやるべきですか?AIがやるべきですか?」
かつては「自動化できる/できない」の二択でした。ルール化できる業務はシステムで自動化し、それ以外は人が対応するシンプルな構造でした。
しかし、LLMの登場で、この境界が曖昧になりました。「ルール化は難しいが、なんとなくのパターンはある」という業務領域にAIが踏み込めるようになったからです。
そして、新しい問いが出現しています。
どこまでAIに任せていいのか
AIが判断できないケースは誰が対応するのか
AIの判断精度をどう改善し続けるのか
単にツールを入れるだけでは解決できない課題です。それは「誰が、いつ、どのようにAIと協働するか」という設計の問題だからです。
この「人とAIの境界設計」を専門に担う役割として、「AIオペレーションマネージャー」という新しい役割の必要性を日々感じています。
BPaaSの構造を理解する
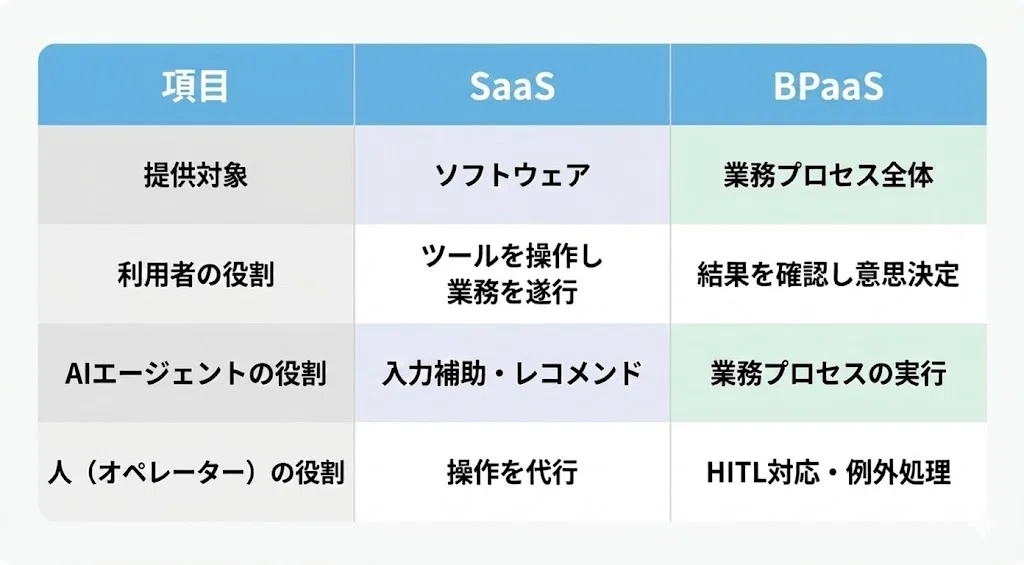
SaaSとBPaaSにおけるオペレーションの違いとは何か
BPaaS(Business Process as a Service)は「業務プロセス全体をサービスとして提供する」モデルです。従来のSaaSが「ソフトウェア」を提供するのに対し、BPaaSは「業務そのもの」を提供します。
システムがあるからこそ、プロセスはバラバラになる
BPaaSの理想は、業務オペレーションのインフラです。
では様々なシステムやツールを導入し、DXやAI推進すればよいのでしょうか。
現実は異なっています。
システムが増えるほど、業務担当者は複数の画面を行き来することになります。経費精算を例にとると:
申請はSaaS Aで行う
承認フローはSaaS Bで管理される
会計処理はSaaS Cに連携する
エラーが発生したらチャットに通知が来る
対応履歴はスプレッドシートで管理する
「効率化を目指したプロセス」が、皮肉にも「あっちこっち見る」状態を生み出しています。
「それはBPOに過ぎないのでは?」
ここまで読んで、「結局、業務を代行するならBPO(Business Process Outsourcing)と同じではないか」と思った方もいるかもしれません。
確かに、従来のBPOも「業務プロセスを提供」するモデルでした。しかし決定的な違いがあります。
従来のBPOは、人がすべての業務を遂行し、スケールには人員増加が必要でした。品質は個人のスキルに依存し、コスト構造は労働集約型です。
AIを活用したBPaaSでは、AIが定型・パターン業務を処理し、人はエッジケースと高度な判断に集中します。スケールにAIの処理能力を活用でき、コスト構造は技術投資で改善可能です。
つまり、BPaaSの競争力は「AIと人の協働をどう設計するか」にかかっています。次章で解説するHuman-in-the-Loop(HITL)は、その設計の核心の1つです。
Human-in-the-Loop(HITL)の本質
HITLとは何か
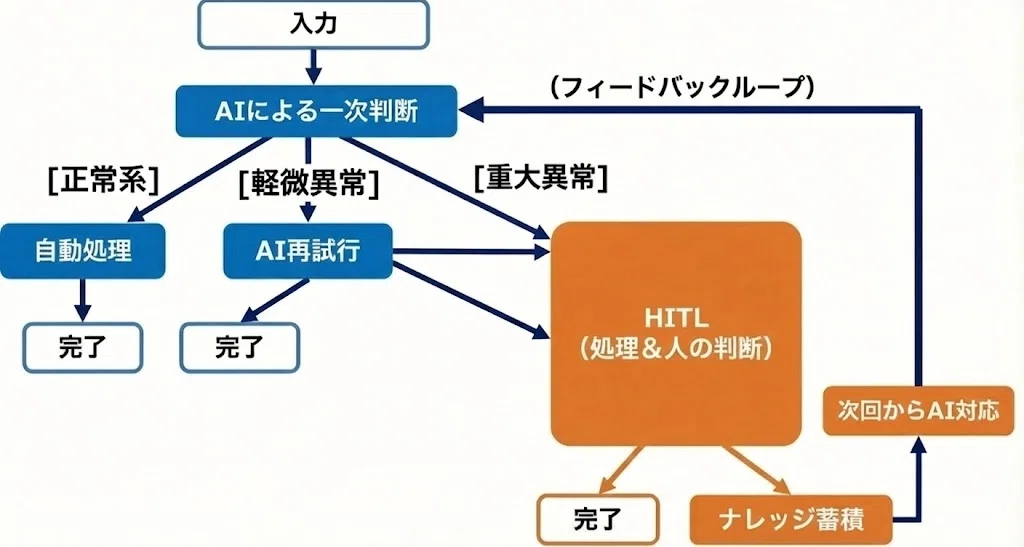
Human-in-the-Loop(HITL)とは、自動化されたプロセスの中に人間の判断を介在させる設計パターンです。
具体的には以下のケースで人が介入します:
イレギュラー発生時:プロセス進行中に想定外の事象が起き、システムがアラートを上げた場合
AIの能力不足時:最初からAIでは判断できない領域として定義されている場合
イメージは下記のようなフローを想定してます。
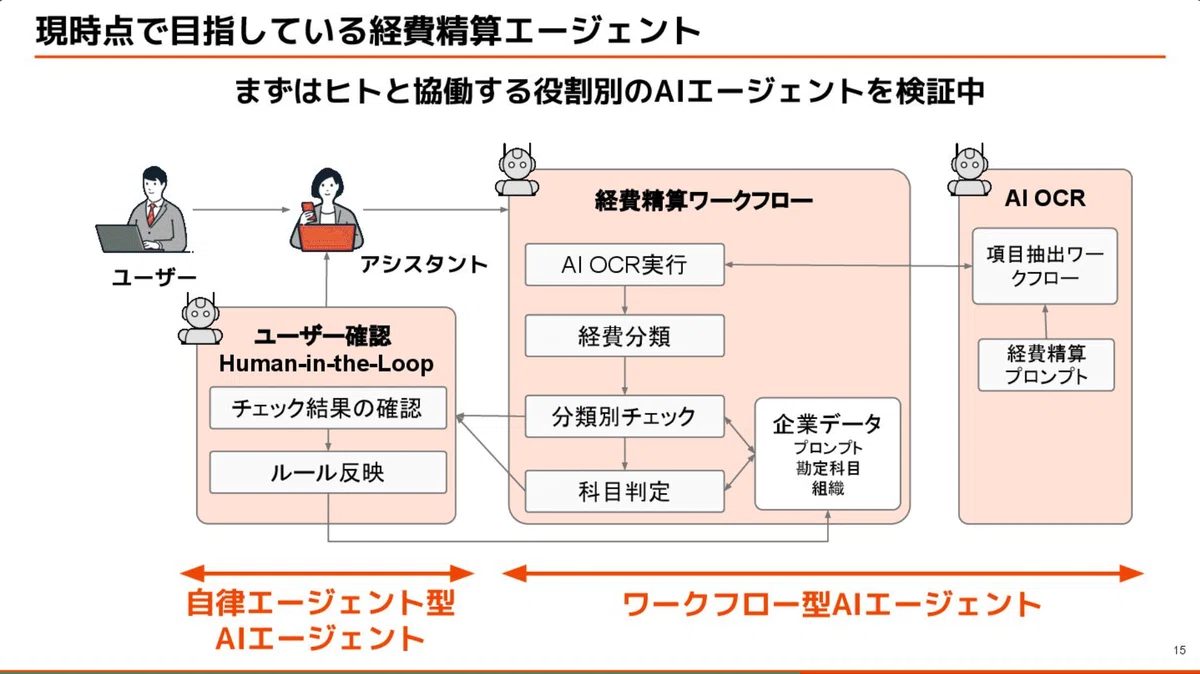
詳しくはこちらもみていただけると嬉しいです。
HITLの本質は「相互学習」にある
HITLの本質は、単に「エラーになったから人が対応する」ことではありません。人とAIが相互に学び合う構造を作ることです。
従来のオペレーションでは、人が能動的にプロセスを回していました。判断し、実行し、結果を確認する。主体は人間でした。
HITL型のオペレーションでは、構造が変わります。AIが処理を実行し、人は「AIが対応できないケース」に対応します。そして重要なのは、人の対応履歴がAIの学習データになるという点です。
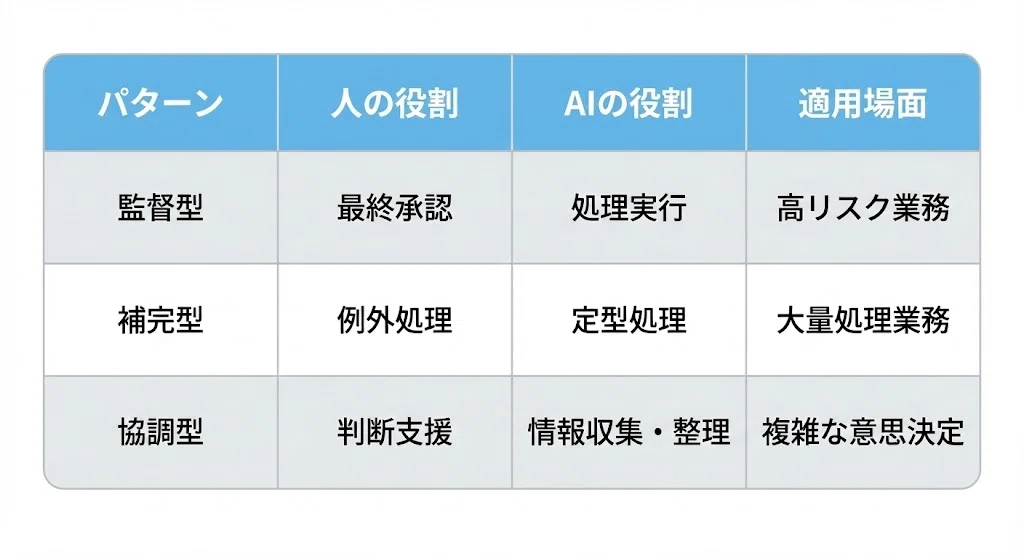
HITLの3つのパターン
業務によって、人とAIの関わり方は異なります。
ここで新たな問いが生まれます。
「では、誰がこのHITLの構造自体を設計し、運用するのか?」
【例】チャット上で動くHITLフロー
具体的なイメージを持っていただくために、経費精算における実際のHITLフローを紹介します。
パターン①:補完型(情報収集)
AIは処理を進めたいが、必要な情報が不足しているケースです。
🤖 Bot: 経費申請の処理に追加情報が必要です
━━━━━━━━━━━━━━━━━━━━━━━━
📄 申請者: 田中太郎
💰 金額: ¥45,000
📝 摘要: 「クライアント接待 会食」
🏷️ AI推定科目: 接待交際費
━━━━━━━━━━━━━━━━━━━━━━━━
❓ 接待費として処理するため、出席者情報を入力してください:
  [📝 出席者を入力]
ポイント:
・AIは科目判定は完了している(接待交際費と確定)
・処理に必要な「出席者情報」だけを人に補完してもらう
・人は判断ではなく、情報提供だけを行う
AIの強みは「即時性」
従来の経費精算フローでは、申請者が提出し、経理担当者が後から確認していました。担当者が忙しければ翌日、月末なら数日後になることも。時間が経つと、担当者は「あの申請、何だったっけ?」と脳がスイッチしており、確認に余計な時間がかかります。
AIなら、申請した瞬間に即時チェックが走ります。
・24時間365日、疲れずにチェック
・申請者の記憶が鮮明なうちに追加情報を求められる
・担当者は「AIが迷ったケース」だけに集中できる
この「即時性」こそを利用して補完的な処理を行うこともAIオペレーションの重要な点です。
パターン②:監督型(最終承認)
AIの判定に自信がなく、人の最終判断を仰ぐケースです。
🤖 Bot: 新しい経費申請がAI判定に回りました
━━━━━━━━━━━━━━━━━━━━━━━━
📄 申請者: 鈴木花子
💰 金額: ¥12,000
📝 摘要: 「社内MTG用 軽食」
🏷️ AI推定科目: 会議費(信頼度: 58%)
⚠️ 判定理由: 「社内」「MTG」から会議費と推定。
  ただし「軽食」が福利厚生費の可能性あり。
━━━━━━━━━━━━━━━━━━━━━━━━
👆 判定してください:
  [✅ 会議費で承認] [🔄 福利厚生費に変更] [❌ 差し戻し]
ポイント:
AIが「なぜ迷っているか」を明示(信頼度58%、会議費 or 福利厚生費)
人が最終判断を行い、その結果をAIが学習する
これが「Human-in-the-Loop」の具体像です。補完型では人は「情報提供者」、監督型では人は「最終判断者」。人が介入するのは「AIが迷ったとき」か「情報が不足しているとき」だけで、その対応履歴は次のAI改善に活かされます。
kubellの場合は、全てのパターンを使用します。
人のオペレーターがサービスに存在するBPaaSの特性を活かしLLMの精度が埋めきれない最終承認を許容し、段階的な改善を狙います。
例外の早期発見による人による補完。
全体の判断に必要な情報提示など多要素で用いることで生産性を向上させます。
AIオペレーションマネージャーという役割
なぜ新しい役割が必要なのか
これまで、業務を効率化する方法は主に4つでした:
人をマネージする:教育、マニュアル整備、人員配置の最適化
自動化:RPA、ワークフローツールの導入、マクロ、GAS
UXを改善する:使いやすいインターフェース設計
エクセレントなExcel:特定の担当者がパッと見て分かるExcelの作成
しかしAIの登場により、業務設計には新しい問いが加わりました。
「これは人がやるべきか?プロダクトで自動化すべきか?AIに任せるべきか?いつ切り替えるべきか?」
この判断を行い、BPaaS全体のオペレーション構造を設計・管理するのが「AIオペレーションマネージャー」です。
私は、BPaaSの開発と検証を繰り返すうちに、これまでのようなプロダクト開発体制ではうまくいかないのでは?と何となく感じていました。
ユースケース検証を行うことで徐々に解像度があがり言語化した際にプロダクト提供との違いが明確になってきました。
プロダクトと業務運用の横断、良い意味でも悪い意味でも打ち手のバリエーションの広さです。
きっかけは、データやCS体制はどうするのですか?というような質問があったときに、これってドメインとAIわからないと、全体の改善が回らずにインフラにならないのでは?です。
AIオペレーションマネージャーの4つの責務
責務①:業務プロセスの分類と理解
最初の責務は、現在の業務フローのパターン分類と理解することです。
単に可視化する事ではありません。
具体的なアクション:
・業務の「入力→処理→出力」を構造化する
・どこに暗黙知が埋まっているかを特定する
・判断が発生するポイントを洗い出す
・例外パターンを網羅的に収集する
・多くのサンプルを検証し構造化する
業務の理解なしで、AIの適用判断はできません。「思考プロセスが言語化、構造化されていないもの」は設計できないからです。
責務②:AI適用可能性の判断(仕分け)
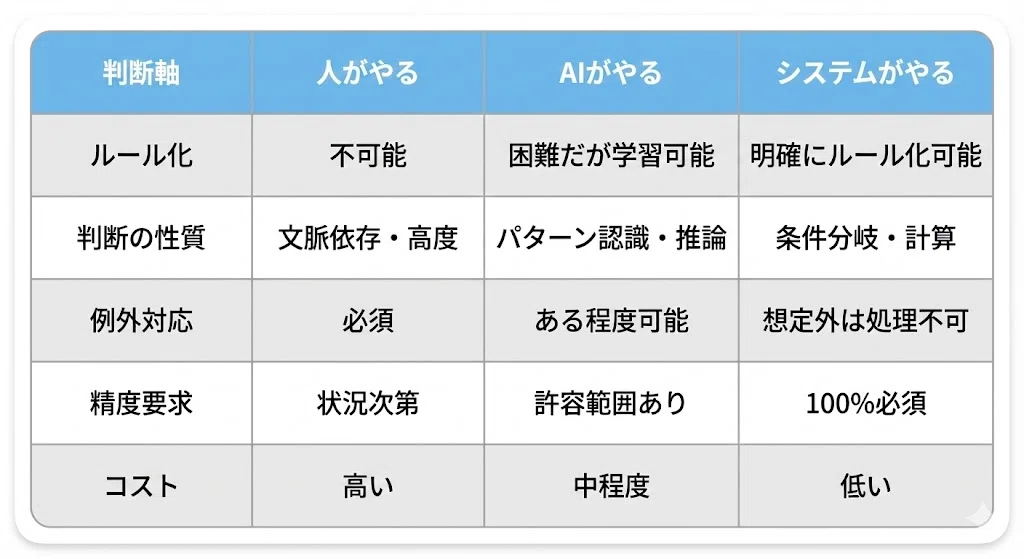
すべての業務をAI化すべきではありません。AIオペレーションマネージャーは、業務を「人」「AI」「システム」の3つに仕分けます。
仕分けの基本原則:
ロジック化できる → システム(ルールベース処理)
パターンはあるが例外が多い → AI(LLM)
文脈依存・高度な判断 → 人
なぜ「システム」を分けるのか:
ロジック化できる業務にAIを使う必要はありません。「if A then B」で処理できるものに、LLMの推論コストをかける必要はありません。
技術的には、初期はLLMの判定であるが、段階的に軽量な分類モデルやEmbedding類似度で意図判定のみを行い、処理自体は既存のAPIやスクリプトに流すRoutingパターンが有効です。LLMの推論コストを最小化しつつ、柔軟性を確保できます。
逆に、ルールベースで処理できないからといって、すぐに人に回すのも非効率です。パターン認識や曖昧な入力の解釈はAIの得意領域です。
仕分けの具体例:
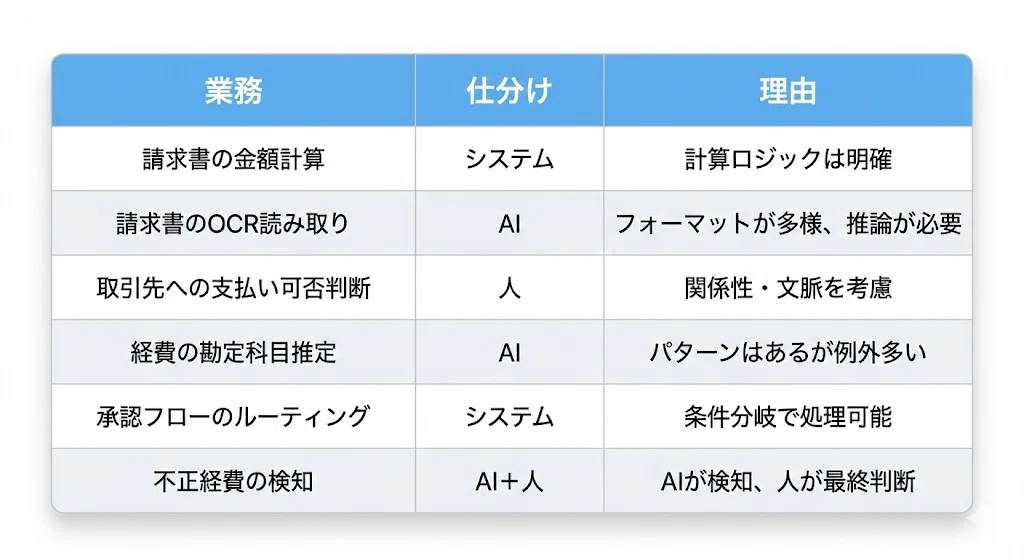
ロジック化可能性・頻度・コストを天秤にかけ、オペレーションの構造を設計するのがAIオペレーションマネージャーの仕事です。
現場で起きがちな間違い:
・ロジック化できる業務→「AIで」と過剰投資
・AIで処理可能な業務→「難しそうだから人で」と放置
・人が判断すべき業務→「AIで効率化したい」と無理に自動化
この仕分けの精度が、オペレーション全体の効率性を左右します。
責務③:Human-in-the-Loopの設計
HITLの設計は、AIオペレーションマネージャーの中核的な責務です。
設計すべき要素:
・どのタイミングで人が介入するか
・何を人が判断するべきか
・フォールバックの条件(AIが「わからない」と判断する基準)
・人が判断すべきケースの定義
・介入後の処理フローと必要な情報
重要なのは、「人が介入しやすい設計」にすることです。
AIが判断できないケースで人を呼び出しても、人が状況を把握できなければ意味がありません。AIが「なぜ判断できなかったのか」「どの情報が不足しているのか」を明示する設計が必要です。
責務④:フィードバックループの構築
HITLで人が対応したケースは、貴重な学習データです。
AIオペレーションマネージャーは、このデータを活用するフィードバックループを構築します。
フィードバックループの設計:
人の対応履歴を記録する仕組み(入力・出力・修正内容のペアをPreference Dataとして蓄積)
パターン分析によるAI改善ポイントの特定(評価Datasetを用いたRegression Testで劣化を検知)
プロンプトまたはモデルへのフィードバック
改善効果の測定(本番トラフィックでのOnline Evalと、Curated Test SetでのOffline Evalの併用)
判断すべき問い:
・個別対応で終わらせるのか
・ナレッジとして蓄積し、将来のAI判断に活用するのか
この見極めが、AI精度の継続的な向上につながります。
暗黙知の言語化:誰が、どう言語化するのか
なぜ言語化が必要なのか
AIに業務を任せるためには、業務の「言語化」が必須です。しかしこれは単なるマニュアル作成ではありません。
組織の中には、言語化されていない判断基準が大量に存在します。
暗黙知の具体例:
・「この請求書は変だから確認して」→何が「変」なのかを定義
・「ケースバイケースで対応」→どのケースでどう判断するかを列挙
・「あの人に聞けばわかる」→その人の頭の中にある判断基準
・「経験的にこれは危ない」→過去のトラブルパターン
これらの暗黙知は、言語化されない限りAIには渡せません。
適切なアーキテクチャをベースにしたコンテキストこそが競争優位
AIは誰でも使える。差別化はコンテキストで決まる。
「AIは誰でも使える。では何が差別化になるのか?」答えは「コンテキスト」です。
同じLLMを使っていても、業務に最適化されたコンテキスト(判断基準、例外パターン、業界特有の知識)を持っている企業と、そうでない企業では、AIの出力品質が全く異なります。
「コンテキスト」は、暗黙知を「検索可能かつ推論に使える形」で言語化する必要があり、単なるドキュメント化では不十分です。
暗黙知を言語化できる企業だけが、AIとの真の協働を実現できます。
人間とシステムとAIがインタラクティブに混ざり合う世界では、「何を言語化し、何を人に残すか」の見極めが
競争優位になります。
誰が言語化するのか:ドメインエキスパートの役割
では、この言語化は誰が担うのでしょうか。
AIオペレーションマネージャーが設計した構造の中で、実際にHITL対応を行い、暗黙知を言語化するのが「ドメインエキスパート」です。
ドメインエキスパートは、HITLの中で実際に業務を遂行する専門家です。単純作業をこなすオペレーターとは異なり、以下の役割を担います。
ドメインエキスパートの責務:
コンテキストの理解:なぜこのケースが例外なのかを把握する
判断基準の言語化:「なんとなく」を「明確なルール」に変換する
AIへのフィードバック:対応結果をAIの学習データとして整備する
オペレーターへの教育:言語化した判断基準を他のメンバーに伝達する
ドメインエキスパートは、HITLのフォールバック先として対応するだけではありません。対応を通じて得られた知見を、AIと人の両方に反映させることが本質的な役割です。
AIオペレーションマネージャーとドメインエキスパートの関係
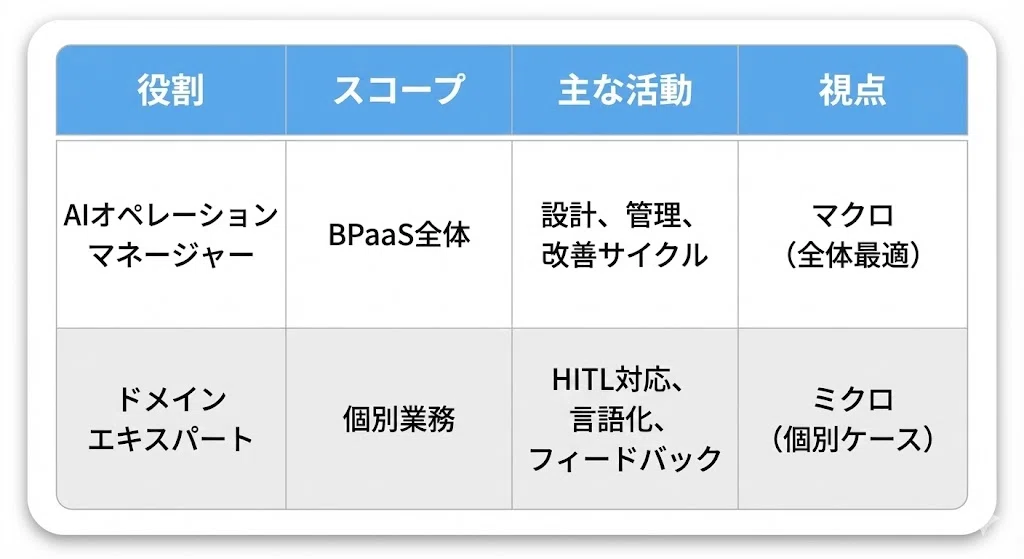
ドメインエキスパートが現場で蓄積する知見を、AIオペレーションマネージャーが全体設計に反映する。この連携がBPaaSの継続的改善を可能にします。
オペレーションのアーキテクチャを設計する
ここまで読んだ方は「結局、具体的にどんな設計をすればいいの?」と思ったはずです。
この章では、AIオペレーションマネージャーが実際に設計すべき5つの要素を解説します。
「アーキテクチャ」とは何を設計することなのか
ソフトウェア開発には「アーキテクト」という役割があります。システム全体の設計思想を決め、各コンポーネントの責務を定義する役割です。
AIオペレーションマネージャーは、業務オペレーションにおけるアーキテクトです。
しかし、「オペレーションのアーキテクチャ」とは具体的に何を設計することなのでしょうか?
設計要素①:共通レイヤと個別レイヤの分離
「どこまでを共通化し、どこからを個別対応にするか?」
オペレーションには、顧客や業務に依存しない「共通処理」と、個別の文脈に応じた「個別処理」があります。
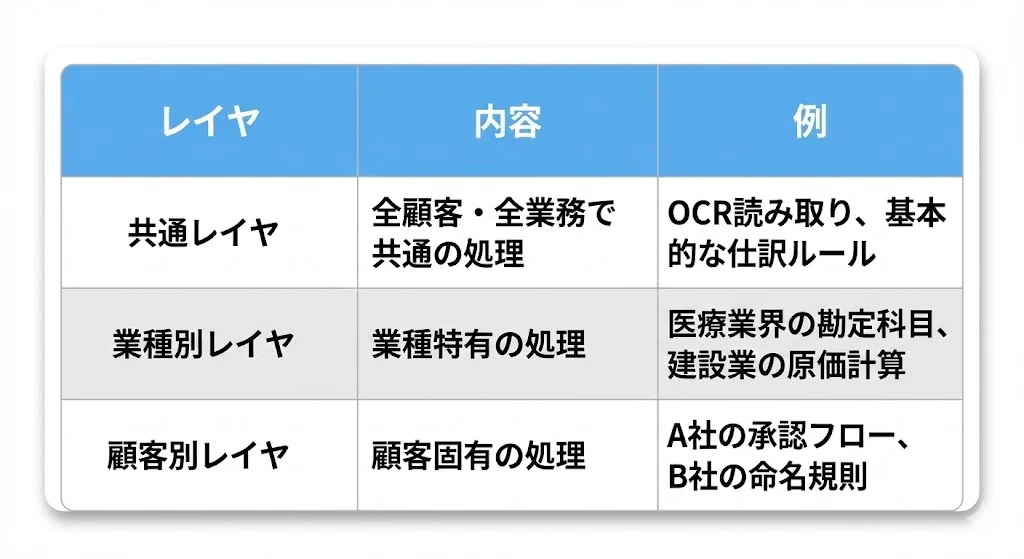
共通レイヤはAIで高精度に自動化し、個別レイヤは顧客ごとの設定やHITLで対応する。この分離設計がスケーラビリティを決めます。
設計要素②:責任分解点の定義
「どこでAIの責任が終わり、人の責任が始まるのか?」
責任分解点を曖昧にすると、問題が発生したときに誰が対応すべきかわからなくなります。
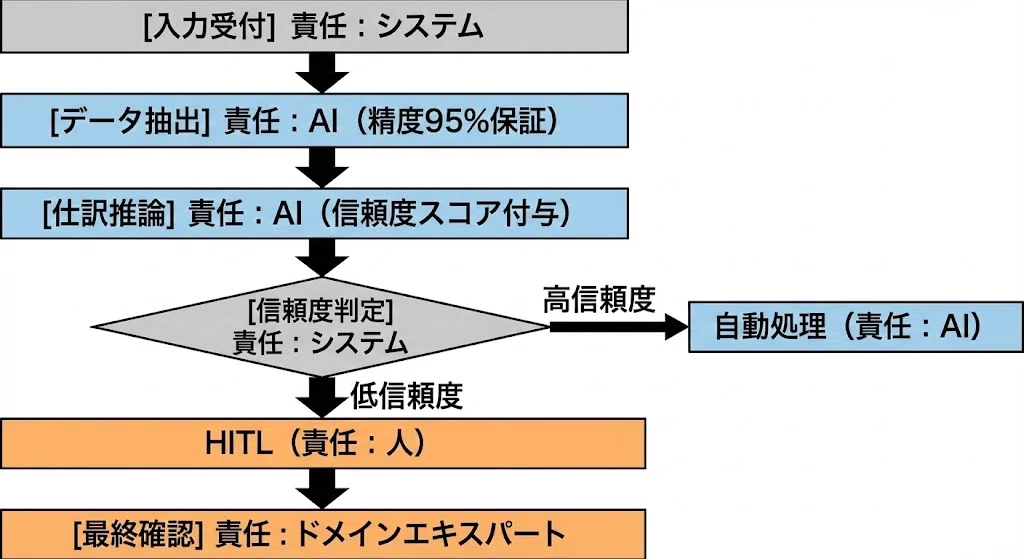
各ステップで「誰が責任を持つか」を明示することで、問題発生時の対応フローも明確になります。
設計原則:ソフトウェアアーキテクチャからの借用
オペレーション設計にも、ソフトウェア設計の原則が応用できます。エンジニアリングの知見を活かすことで、保守性・拡張性の高いオペレーションが構築できます。
オペレーションにおける共通利用するメソッドとプロセス固有なメソッドを分け、適切な責務粒度を持たせます。
ソフトウェアだけではなく人のオペレーションに加えて、コンテキストの顧客独自性やコンセプトドリフトの有無も関連するため、粒度感は分けることで生産性が高まるかの観点も含まれることになります。
アーキテクトとしては、中々、興味深いテーマだと考えています。
プロダクト開発と同様に原則を全て厳密に利用することはありませんが、基本的な考え方になります。
原則①:Single Responsibility(単一責任)
各処理ステップは、1つの責務だけを持つべきです。
❌ Bad: 「経理チーム」が申請受付から仕訳確定まで一気通貫で担当
    → どこで詰まっているか不明、改善ポイントが特定できない

✅ Good: 申請受付(システム)→ 科目判定(AI)→ 例外対応(HITL)→ 承認(人)
    → 各ステップの処理時間・エラー率を個別に計測・改善可能
責務を分離することで、「仕訳がおかしい」という問題が発生したとき、「OCRの問題か?判定ロジックの問題か?入力データの問題か?」を切り分けられます。
原則②:Liskov Substitution(置換可能性)
人とAIは「同じインターフェース」で設計します。
【インプットアウトプットの例】
・入力: 経費申請データ(証憑画像、過去仕訳RAGデータ)
・出力: 勘定科目、信頼度スコア、判断理由
このインプットアウトプットをある程度、統一しておけば、以下のような段階的移行が可能になります。
・初期は人が100%対応
・徐々にAIの比率を上げる
・精度が下がればいつでも人に戻せる
「人→AI」の切り替えだけでなく、「AI→人」への切り戻しを想定した設計が重要です。
これらの原則は、エンジニアには馴染み深いものです。オペレーション設計に適用することで、「なんとなく」の設計から「原則に基づいた」設計へと進化させることができます。
設計要素③:コンテキストによる動的な分岐
「同じ業務でも、状況によって処理を変えるべきか?」
オペレーションは静的ではありません。以下のような企業毎のコンテキストによって、処理を動的に変える設計が必要です。
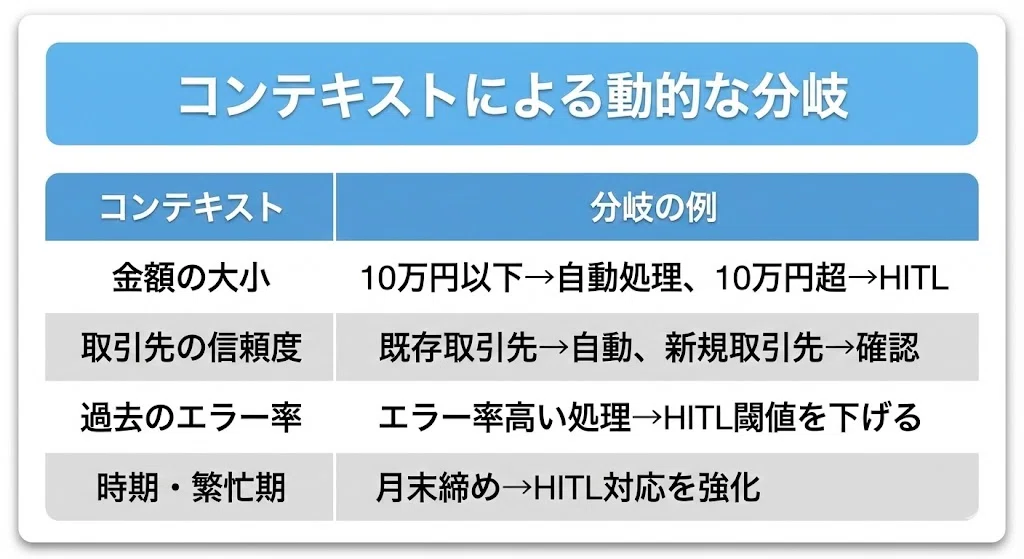
この動的分岐のルールを設計するのも、AIオペレーションマネージャーの責務です。
実装としては、分岐ロジックを入出力のフィルタリングという伝統的な考え方や外部設定ファイルで管理し、運用しながら閾値を調整できる設計にしておくことがポイントです。また、Latency Budget(処理時間の上限)を意識し、分岐判定自体がボトルネックにならないよう注意が必要です。
設計要素④:HITLの挟み方
「どのタイミングで、どのように人を介在させるか?」
HITLの挟み方には複数のパターンがあります。
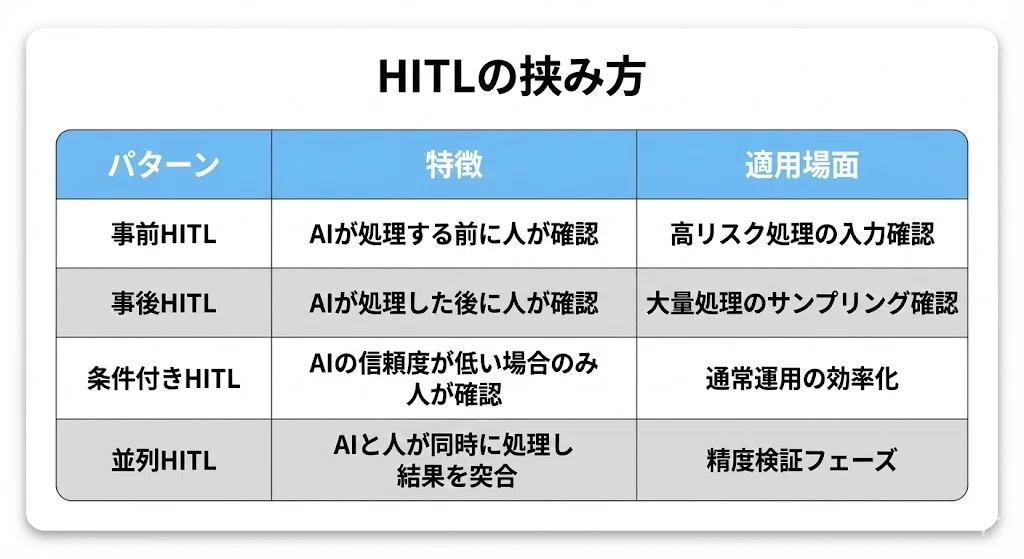
業務の性質とリスクに応じて、適切なHITLパターンを選択します。
Fail-safe:迷ったら人に回す
HITLの設計で最も重要な原則は「Fail-safe(安全側に倒す)」です。
Routingの段階で「既知パターン」と「例外ケース」を判定し、例外は人に回します。
「自動化率を上げたい」という誘惑は常にあります。しかし、例外ケースを無理に自動処理しようとすると、後から修正コストが膨らみます。
例外パターンの定義は保守的に始め、運用データを見ながら「既知パターン」を徐々に拡張していくのが鉄則です。「まず安全に、次に効率化」の順序を守ることで、顧客の信頼を損なわずにAI活用を進められます。
設計要素⑤:データとして何を残すか
「将来のAI改善のために、何を記録すべきか?」
オペレーションの実行結果は、次のAI改善の材料です。しかし、すべてを記録するとコストが膨らみます。
記録すべきデータ:
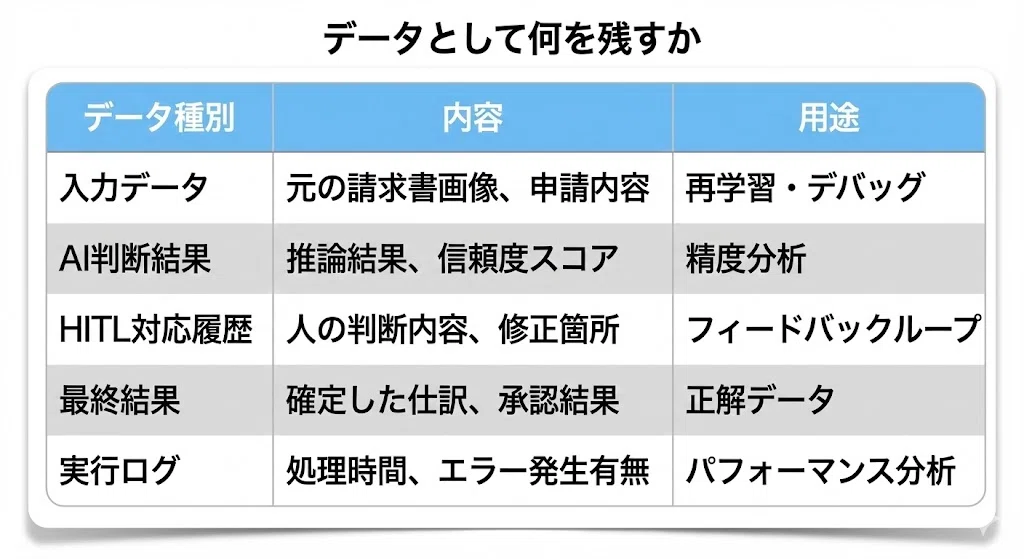
特に重要なのは「HITL対応履歴」です。人がどう判断したかの記録が、AIの精度向上に直結します。
これを実現するには、入力から最終出力までを追跡できるトレース基盤が必要です。
AIの構造を理解している人が、業務設計をする
従来、業務設計は「業務を知っている人」が、システム設計は「システムを知っている人」が担ってきました。
しかしAI時代には、この両方を理解し、「人とAIの境界をどこに引くか」を設計できる人材が必要です。
AIオペレーションマネージャーに求められる知識例:
・LLMの挙動理解(Lost in the Middle問題、Long Context時の精度劣化、Hallucinationの発生パターン)
・RAG設計(Chunk戦略、Query Decomposition、HyDE、Re-rankingの使い分け)
・エージェント設計(Planning、Routing、Reflection、Multi-Agent Orchestration)
・評価設計(Offline/Online Evalの設計、Regression Test)
・運用設計(Fallback Chain、Latency Budget、Cost Attribution)
・業務ドメインの深い理解
これらすべてを深く理解している必要はありません。重要なのは「何が存在するかを把握していること」です。技術的な選択肢を知っていれば、エンジニアと対等に議論し、適切な意思決定ができます。
これらを踏まえ、運用データが改善に回り、改善がさらにデータを生む好循環を意識した設計が求められます。
どんな人がAIオペレーションマネージャーに向いているか
AIオペレーションマネージャーは「業務」と「AI」の両方を理解する必要があるため、以下のようなバックグラウンドを持つ人が向いています。
まだ、試行錯誤のため、まだ私の単なる仮説ですが。。
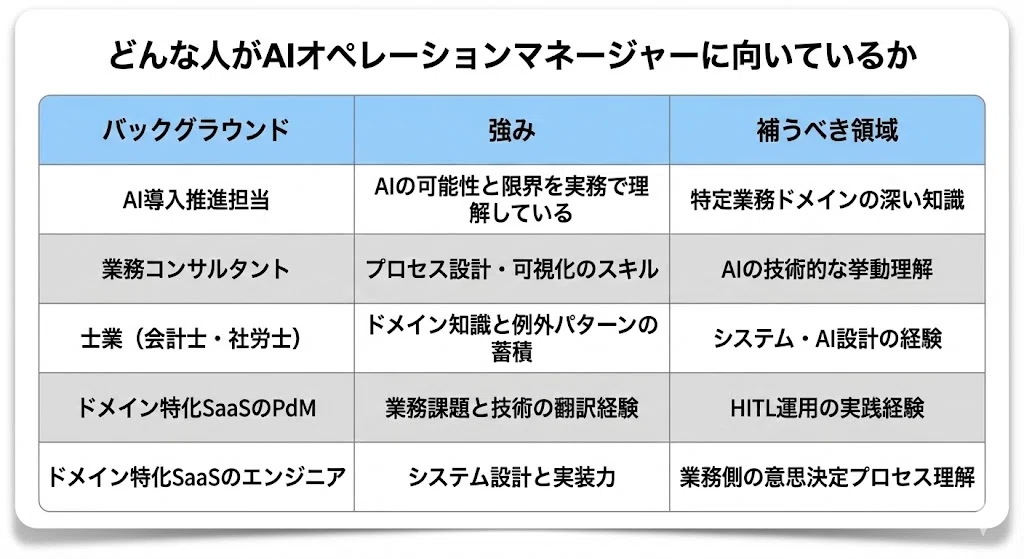
共通するのは「業務の現場を知っていて、かつ技術に対する好奇心がある」ことです。どちらか一方だけでは、人とAIの境界を適切に引くことはできません。
この知識を組み合わせることで「オペレーションのアーキテクチャ」を設計できます。
まとめ
BPaaSの現場は、AIの進化によって大きく変わろうとしています。その変化を「受動的に」受け入れるのではなく、「能動的に」設計する。それがAIオペレーションマネージャーの役割です。
AIオペレーションマネージャーの4つの責務:
業務プロセスの棚卸と可視化
AI適用可能性の判断(仕分け)
Human-in-the-Loopの設計
フィードバックループの構築
オペレーションアーキテクチャの設計要素:
共通レイヤと個別レイヤの分離
責任分解点の定義
コンテキストによる動的な分岐
HITLの挟み方
データとして何を残すか
オペレーションの設計者として、人とAIの最適な配置を考える。暗黙知を言語化し、AIが活躍できる環境を整える。これがこれからのビジネスに求められる新しいスキルセットです。
AIは「使う」ものから「協働する」ものへ変わりました。
その協働の設計者が、AIオペレーションマネージャーです。
この記事が参考になりましたら、ぜひフォローやコメントをお願いします。AIオペレーションの設計についてご質問があれば、お気軽にお声がけください。
We are hiring!
Kubellでは今、まさにこの記事で書いたことを実践しています。
まずはバックオフィス業務において、「どこまでAIに任せるか」「どこで人が介入するか」を日々設計し、改善し続けています。正解がない領域だからこそ、仮説を立てて検証するサイクルを高速で回せる環境があります。
「プロダクトとオペレーションの境界を設計する」という、これまでにない役割に挑戦したい方。一緒にBPaaS時代のアーキテクチャを作りませんか。
少しでも興味を持っていただいた方は、ぜひ採用ページも覗いてみてください。