言語AIの進化史①チューリング・テスト

今回から言語AIの進化史のシリーズを開始します。第一回で取り上げるのは「チューリング・テスト」です。これを取り上げたのには理由があります。
チューリング・テストを発案したのは、イギリスの数学者アラン・チューリング(Alan Turing)です。彼は、コンピュータ科学や人工知能などの分野において非常に重要な貢献をしました。
映画「イミテーション・ゲーム/エニグマと天才数学者の秘密」でその名前を知った人も多いでしょう。第2次世界大戦中に、チューリングはナチス・ドイツのエニグマ暗号機を解読することで連合国の勝利に大きく貢献しました。
また、2015年のスティーブ・ジョブスの映画でもチューリングについて言及されており、後世への影響の大きさが伺えます。
さて、チューリング・テストは、アラン・チューリングが1950年に『Computing Machinery and Intelligence』で発案した人工知能に対するテストです。単純化した説明をすると、人間が見えないところにいる相手と会話をして、その相手がコンピュータだと見破れなかったら、そのコンピュータには知能があるとするというものです。
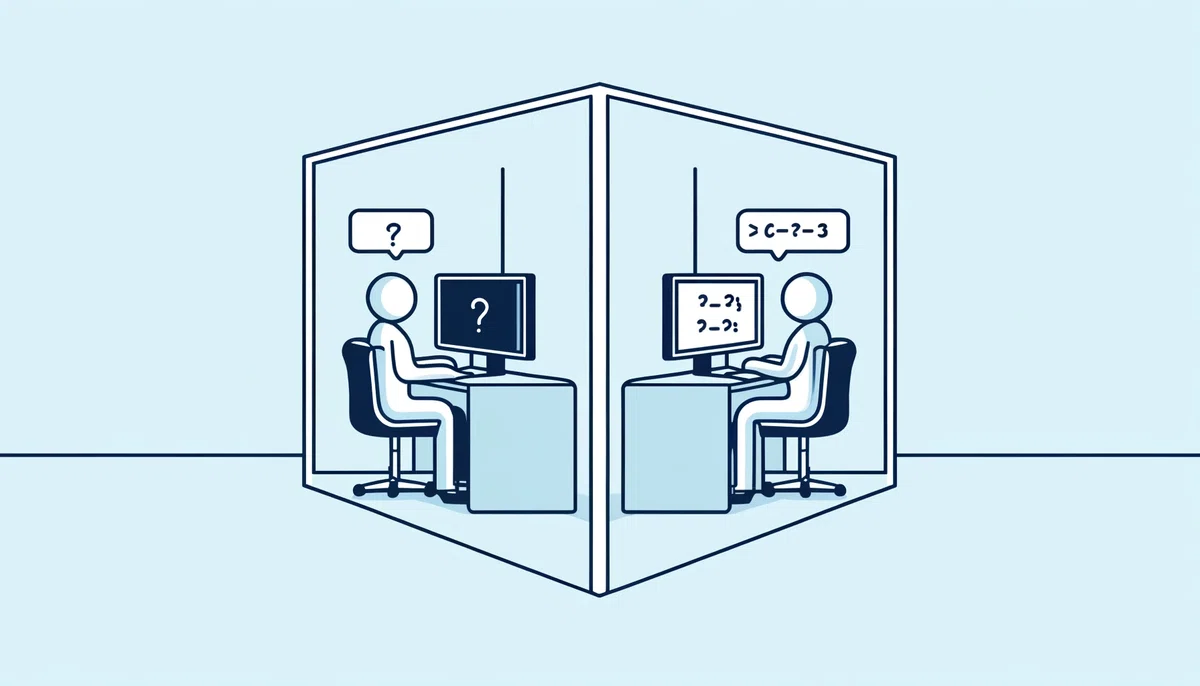
その知性を判定は、文字のみでの交信に制限されます。よって、会話はキーボードとディスプレイのみといった状況で行われることを想定しています。
ちなみに、このテストが発案された当初は、初期の電子コンピュータは存在していました。たとえば、1946年のENIAC(Electronic Numerical Integrator and Computer)などが有名です。しかし、現在のような高性能で広く普及したコンピュータはまだ存在していませんでした。
チューリング・テストは、機械の知能を評価するための理論的な枠組みを提供しています。しかし、機械がどの程度知能を持っているかを実験的に証明するための直接的な方法ではなく、知能の本質についての議論を促すためのものと捉えられます。
特に興味深いところは、言語による受けごたえを知性の判断基準としていることです。「話をして機械だとわからないのであれば、それはもう人間のような知能を有する」というアプローチであり、言語を理解し生成する能力は知性なくしては可能ではないという考えが根底にあると言えます。
一方でしかし、判断するのはあくまでも人間による主観に過ぎません。よって、チューリング・テストや似たようなテストが不十分であるという意見も多くあります。このことは、知性の評価の難しさを意味しています。
なお、現在の大規模言語モデル(LLMs)でも、会話の自然さや質問に対する適切な応答能力は重視されています。よって、チューリング・テストが設定した基準は、LLMsの開発という文脈においてもある程度の重要性を持ちます。
そのため、このシリーズの初回の記事としてチューリング・テストとそれに関連した概念の解説を取り上げました。
イミテーション・ゲーム
実際のチューリング・テストは、アラン・チューリングが1950年に発表した論文『Computing Machinery and Intelligence』で、「イミテーション・ゲーム」として知られる設定で行われます。
このゲームには3人の参加者が含まれます。1人は審査官(人間)、他の2人は被験者(1人は人間、もう1人は機械)です。
審査官は別の部屋に座り、被験者と文字ベースのインターフェース(キーボードとスクリーン)を通じて会話を行います。よって、会話は完全に文字ベースで行われ、音声や視覚的な手がかりは一切使用されません。審査官はどちらの被験者が人間であるかを判断する役割を担います。よって、審査官は質問を投げかけ、それに対する被験者の回答を基に判断を行います。
一方、機械の目的は、自分が人間であると審査官に信じさせることです。審査官が機械と人間を区別できない場合、その機械は「知能がある」と見なされます。
「イミテーション・ゲーム」と呼ばれる理由は、このテストが「機械が人間の知能を模倣する能力」をゲーム形式で評価するからです。
近年に大きな成功を収めたChatGPTなどの大規模言語モデルでは、人間による評価が高くなる応答をするように訓練されます。
つまり、現在でもチューリング・テストと同様なアプローチが人工知能の評価に使われていると考えることができます。
しかし、チューリング・テストに対する批判もあります。
それは、「人間を模倣する能力が知性と言えるでしょうか。知能を持たないけど巧みにプログラムされた機械でもテストに合格できる可能性はないでしょうか」といったものです。
知能を持たないけど巧みにプログラムされた例としてイライザがあります。
人工無能:イライザ
イライザ(ELIZA)は、1966年にジョセフ・ワイゼンバウムが発表しました。単純な自然言語処理プログラムですが、心理カウンセラーのように人間と対話できると評判になりました。
現在でも、LinuxやmacOSで使えるエディタのemacsに標準でインストールされておりESC、x、doctorとタイプすると起動することができます。
イライザは、ルールに従ってそれらしい返答をするプログラムであり、人工知能とは程遠いもので人工無能と呼ばれています。人間の会話は多くのパターン的な応答を含むので、さまざまな質問に対する自然な応答を事前に準備しておくことで、ある程度の会話が可能となっています。
それでも、イライザを本物のセラピストだと信じる人もいました。人間の会話の多くは決まり文句などで埋められているので、人間の思い込みを誘導することができればそれだけで十分な効果を出してしまうのでしょう。
このように、人間が思い込みによってコンピュータへの感情移入をする傾向をイライザ効果と呼びます。
このことは、アルゴリズムに従って応答する機械が、チューリングテストを通過できる可能性を示唆しています。
ChatGPTなどの大規模言語モデルでは、より人間らしい自然な受けごたえをすることが重要視されています。
例えば、RLHF(Reinforcement Learning with Human Feedback、人間のフィードバックによる強化学習)が行われたりします。
また、ChatGPTを使っていると、同じ質問に対する2つのこの異なる返事が表示され、どちらを好むのかを聞かれることがあります。これは、人間による評価のデータを集めてさらに訓練に活かすために行われていると考えられます。
それは、より巧みな返答ができるためのパターンを集めることと似ていなくもありません。
興味深いことに、イライザを開発したワイゼンバウムは、ユーザーがイライザに心を開く様子にショックを受けたそうです。そして、コンピュータの技術に対して批判的にさえなりました。
「人間らしい感情や知恵を欠くので、コンピュータに人間にとって重要な決定を任せてはいけない」と主張したそうです。
ワイゼンバウムはユダヤ教徒で、ナチス・ドイツから逃れて米国に渡った経緯もあり、全体主義によるテクノロジーの悪用を特に警戒していたそうです。
現代においても、このような警告は(チャットボットに限らず)AI全体にも通じるところがあります。そのような意見を持つ人はIT業界でも珍しくありません。
よって、人間らしい会話ができるというだけの基準では、知性は判断できないだけでなく、人間にとって有害になる可能性さえあるわけです。
次に紹介する、中国語の部屋という思考実験では、会話のような情報交換から知性を判断することを積極的に批判しています。
中国語の部屋
アメリカの哲学者ジョン・サールは、1980年に発表した「Minds, Brains, and Programs」(心、脳、プログラム)という論文の中で、中国語の部屋という思考実験を提唱しました。これは、形式的なシステムがどれほど知的に見えても、実際には意味を理解していないことを示すためのものです。
この思考実験の設定では、ある部屋の中は、中国語を全く理解しない人物(以下、「操作者」と呼ぶ)がいます。この操作者は英語を理解し話すことができます。また、部屋の外には、中国語を話す人々がいて、彼らは部屋に中国語の質問を入力します。
部屋の中には、非常に詳細なマニュアル(ルールブック)があり、中国語のシンボルの組み合わせを見て、その出力シンボルを決定するための規則が書かれています。このマニュアルは英語で書かれており、操作者はその指示に従って仕事を行います。
つまり、操作者は中国語のシンボルを操作していますが、中国語の意味を全く理解していません。彼は単にマニュアルに従ってシンボルを処理しているだけです。
もっというと、コンピュータがプログラムに従ってシンボルを処理することと、実際にその意味を理解することは別であるという議論です。
中国語の部屋という思考実験を通して、ジョン・サールは、プログラムがどれほど巧妙であっても、意味を理解し意識を持つことはできないと主張しています。これは、人工知能が知能を持っているかどうかの議論に対して深い影響を与えました。
近年の大規模言語モデルの登場によって、大量のパターンを認識・処理するようになると、やがて本質的な理解へと変わる、という見解があります。
大量のデータを利用した教師なし事前学習によって、GPT1は入力文章内の情報をもとに続きの文章をもっともらしく生成することに成功しました。
さらに、GPT3では、少数の例を見せるだけで、そのパターンに従った文章を生成できるという文脈内学習も可能になりました。つまり、与えられた文章の意図を汲んで文章を生成するということです。
これが、「ただシンボルを処理しているだけ」なのか「指示をある程度は理解している」のかは「理解」や「知性」とは何かの定義がはっきりしないとなんとも言えない問題です。
しかし、一言に人工知能と言っても範囲が広すぎるので、一概に全てのAIを否定することなりかねません。AIにも段階を考えた方が良さそうです。
強いAIと弱いAI
人工知能を語るときに強いAIと弱いAI(Strong AI、Weak AI)という概念があります。最近では、強いAIは、General AIとかAGIとか呼ばれます。また、弱いAIはNarrow AIとはANIとか呼ばれます。
弱いAIは、特定のタスクに特化して設計された人工知能で、例えば音声認識、画像分類、言語翻訳などの特定の機能を実行します。これらのシステムは、与えられた問題領域内で非常に優れた性能を発揮しますが、その領域を超えると機能しません。
近年、弱いAIは大きな進歩を遂げました。また、弱いAIを組み合わせたマルチもダルなモデルも多く登場しました。
強いAIは、人間のようにあらゆる認知タスクをこなせる汎用的な人工知能を指します。これは、自ら学習し、推論し、異なる状況に適応できる知能を持つことを目指しています。
しかし、現在の技術では強いAIは、まだ実現されているとは言えません。
強いAIである人間と機械のAIの違いを考えると、人間は現実の世界と関連づけて意味を理解している点があります。
そのため、中国語の部屋のように、意味を理解していなくとも、文章は生成するAIは弱いAIでしか無いという主張が成り立ちます。
例えば、「犬」についての文章を生成したとしても、言語モデルが現実の「犬」を理解しているわけではない、と。
このような主張はシンボルグラウンディングの問題として捉えられます。
シンボルグラウンディングの問題
1990年に認知科学者のスティーブン・ハルナッドは、シンボルグラウンディング問題(記号接地問題)を提唱しました。
文字通り読むと「記号(シンボル)を地につける問題」となりますが、これは、システムが処理するシンボルがどのようにして実世界の意味と結びつけられるかをどうすればコンピュータが扱えるのかという問題です。
先ほどの例にあったように、現実の「犬」とシンボルとしての「犬」をコンピュータは同じものだと認識しているのか。それとも単にピクセルの値から計算した結果として「犬」の画像を処理しているだけなのか。これも簡単に答えられる問題ではありません。
また、シンボルグラウンディングと関連して、身体性という概念があります。これは、人間の知能が成立しているのは身体があるからだという考え方です。つまり、身体を通して知覚した情報は膨大なため、知性はシンボル(記号)を使って物事を認知し思考することようになった。つまり、身体性のおかげでシンボルグラウンディングが出来るようになったとするわけです。
そうすると、見たり触ったりして外界と相互作用できる身体がないと現実の概念を捉えきれないという主張になります。これも今日でもよく議論される概念です。
近年のマルチモダルなAIは、言語だけでなく、画像や音声も同時に処理できるようになっています。また、ロボット技術の進歩も著しく、人間同様にスムーズな動作も可能となっています。これらを推し進めれば、人間のように五感(あるいはそれ以上の知覚)を有した身体性のあるAIの登場もそう遠くはなさそうです。
すると、シンボルグラウンディングの問題は解決されるのでしょうか。これもわかっていません。
身体性や知覚もあり言語も人間らしく処理できるのならば、知性と呼ぶためには何が足りないのでしょうか。
あとは、精神性くらいしか残っていないようです。
自意識と量子効果
自分が存在することを知らないと本当の知性とは呼べないという考えもあります。人間は、知性が無い(あるいは低い)と考えられる生物には自意識(Self-consciousness)がないと感じます。
これも人によりけりで、植物にも自意識はあると考える人もいるでしょう。ただし、一般に知性があるとは、自分と環境の区別などを通して自意識が必要だと考えるのはごく普通です。
コンピュータのプログラムはどこまで行っても決定論的であり、そこには自意識が入り込む余地はありません。コンピュータの生成する乱数でさえ擬似的であり、シードから連なる決まったシーケンスの数値を生成しているに過ぎません。
そんなコンピュータに自意識が宿ることはあるのでしょうか。
数理物理学者のロジャー・ペンローズは「皇帝の新しい心ーコンピュータ・心・物理法則」(1989)の中で意識は脳内の微細な管に生じる量子効果が絡んでいるので、既存のコンピュータでは強いAIは実現できないと主張しました。
ロジャー・ペンローズはブラックホールの研究で有名なスティーブン・ホーキングと共同研究をしたことでも知られています。
確かに、量子力学の世界では、ランダムな事象が基本原理となっており、決定論的では無いのですが、正直言って彼の主張の真偽は定かではありません。
ただし、真の知性を持つためには自意識が必要なのかという議論も今日でもよく聞かれます。
ローブナーコンテスト
1991年から毎年開催されていたローブナーコンテストは、AIチャットボットの競技会で、標準的なチューリングテスト形式で行われていました。
人間の審判員が2つの画面を通して人間とコンピュータとチャットをします。その応答に基づき、審判員はどちらが人間でどちらがコンピュータかを判定します。最も人間らしい会話を模倣できるチャットボットが評価され、賞が授与されました。
しかし、ローブナーコンテストは、2020年以降は開催されていません。
理由は定かではありませんが、Loebner Prizeの創設者であり、主要なスポンサーでもあったHugh Loebnerが2016年に亡くなったことが大きな要因の一つとして考えられます。彼の死後、賞の運営や資金提供が困難になった可能性があるからです。
もしかすると、チューリング・テストそのもの、あるいはコンテストの実施の仕方が、AIの本質的な知能や理解を測るには適していないというコンセンサスがあったのかもしれません。
1950年の論文の中でアラン・チューリングは、50年以内に質問者が5分間質問した後の判定で30%はコンピュータを人間だと誤判定すると予測した。
しかし、現在でもチューリングテストにパスするレベルのソフトウェアは出現しているとは言えません。
次回予告
今回は、言語AIを哲学的な側面から考察しましたが、次回からはより技術的な進化史へと舵を切ります。
お楽しみに!
