
日本のAIロボット開発を加速させる「AI Robot Japan」が第一回イベントを開催 [PR] #ai_robot_tokyo

「AIロボット持ち込み勉強会 〜VLA・模倣学習の最前線〜」が、2026年3月16日、東京・渋谷にある「Sakura Deeptech Shibuya」で開催されました。主催は有志団体「AI Robot Japan」。参加人数はおおよそ150名。FastLabel、Ugo、ABEJAからのプレゼン、ロボット持ち込み、4社からのライトニングトーク等もあり、かなり盛り上がりました。ざっくりとレポートします。
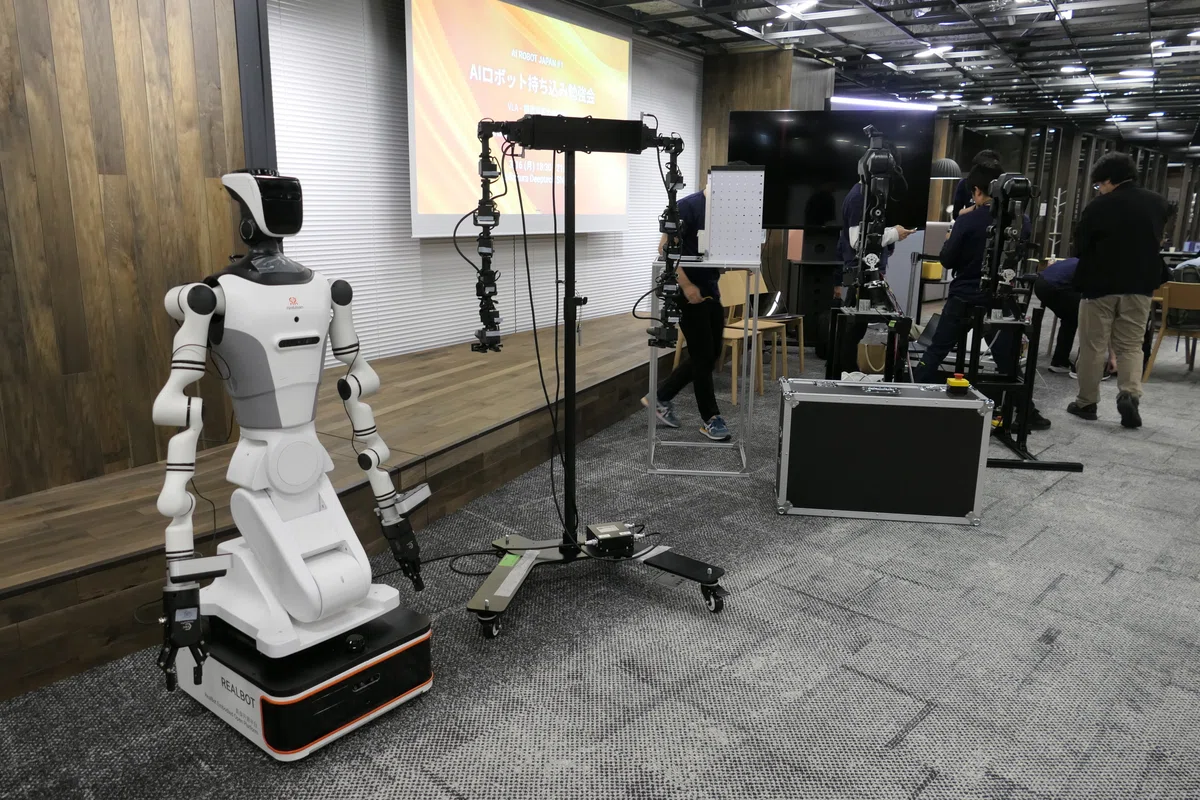
様々な技術人材を接続するコミュニティ「AI Robot Japan」
今回のイベントを主催した「AI Robot Japan」とは「AIロボットを盛り上げたい有志の集まり」です。2月に立ち上がったばかりです。AIロボットを中核として、研究・開発から社会実装までを一気通貫で推進することを狙っているそうです。
AI Robot Japan というAIロボットコミュニティを立ち上げました。
— Yuki Nanri | Algomatic Robotics CEO (@neonankiti) February 4, 2026
発端は、Abejaの @peisuke から勉強会やらない?と誘われたことでした。
正直自分の会社が忙しいのですが、AIロボット領域を盛り上げるために個人活動としてめちゃくちゃコミットしてます。
自分の会社に利益をもたらさないので…
発起人は、ABEJAの藤本敬介さん、Algomaticの南里勇気さん、Ugoの松井健さんの3名。2025年8月に3社によって行われた勉強会で「コミュニティを作ろう」という話で盛り上がり、結成に至ったということだそうです。
異分野の実業会から生まれたAIロボット勉強会コミュニティ、とても楽しかったです!もっと盛り上げていきます!#airobot pic.twitter.com/Lp0BDzPhvt
— Ken MATSUI|AIロボット会社CEO (@mkftr) August 21, 2025
AI Robot Japanのコンセプトは越境、手を動かす、リスペクトしあう
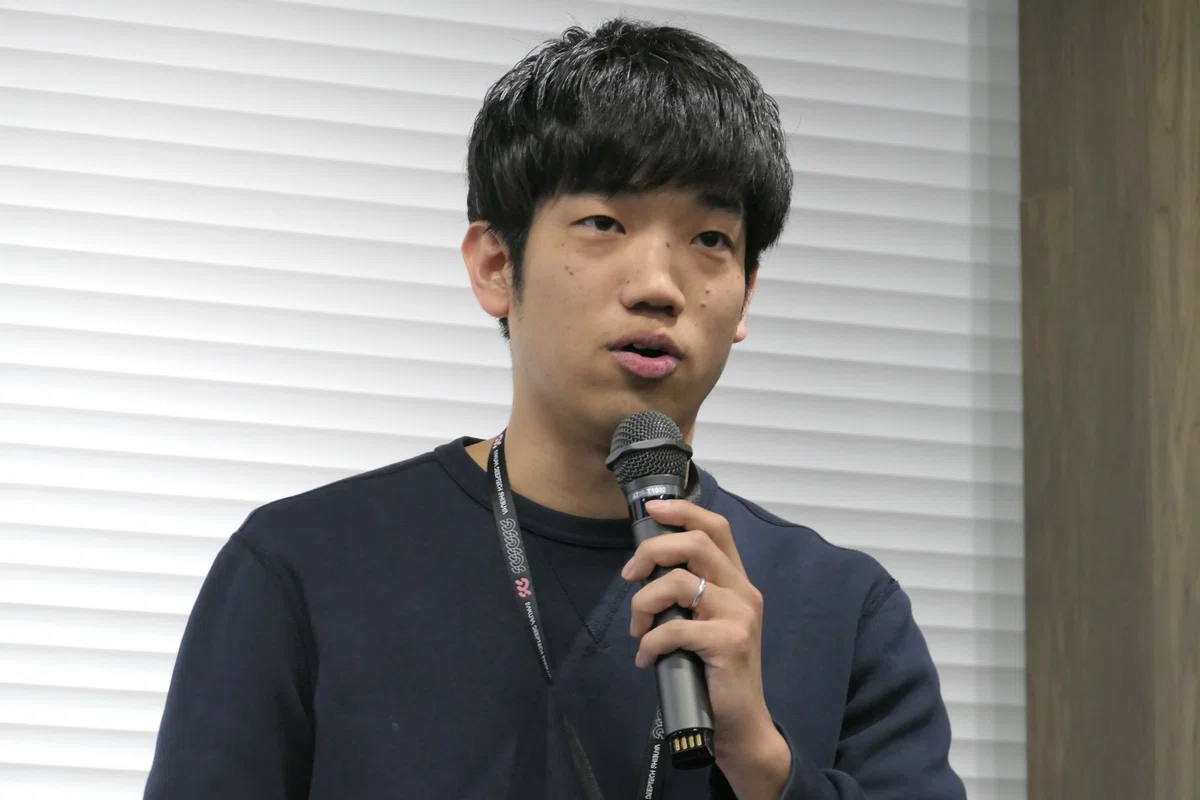
今回の勉強会で司会をつとめたAlgomaticの南里勇気さんは、AI Robot Japanのコンセプトについて、
越境せよーAI・ソフトウェア・ハードウェアの壁を超え、領域を横断してつながる
手を動かせー論文や議論だけでなく、実機・デモ・プロトタイピングで未来を形にする
リスペクトせよー初心者も実務者も、互いを尊重し安心して挑戦できる場をつくる
の3つを挙げました。人材や事業を融合させながらロボット実装を進めていきたいと思って設立したとのことです。
会場は「Sakura Deeptech Shibuya」
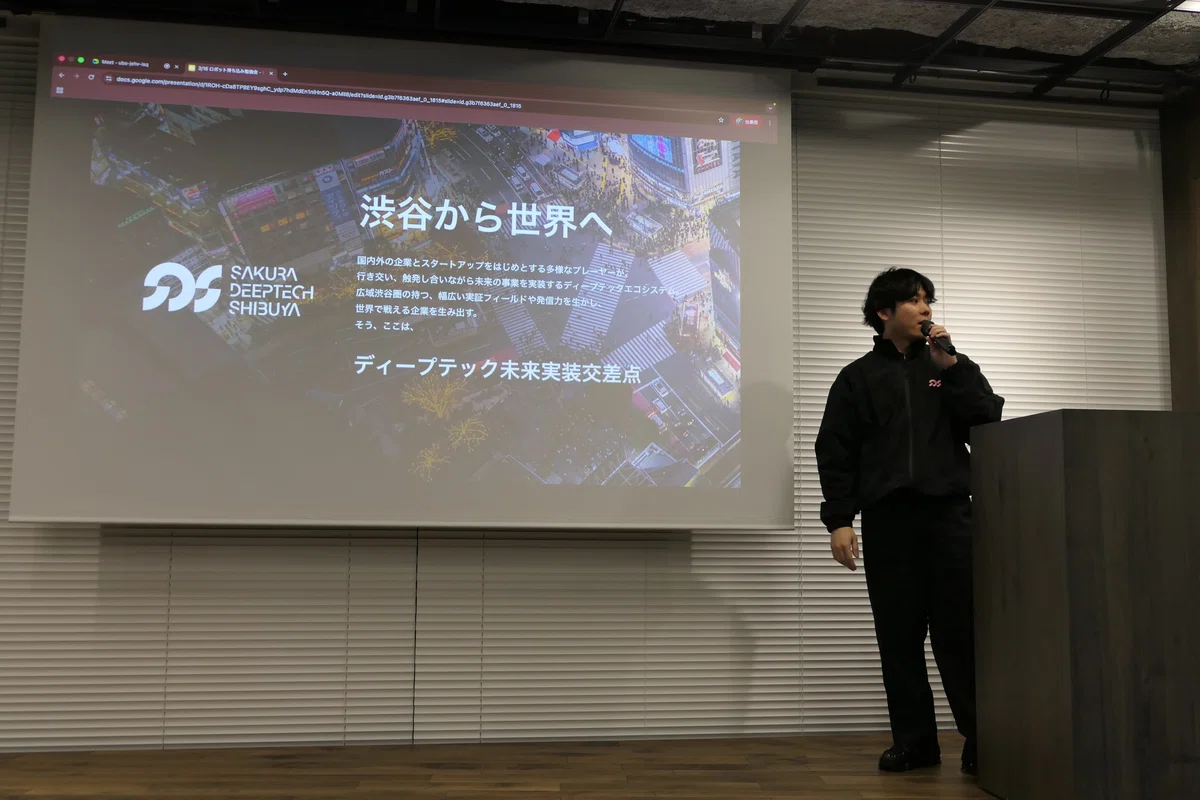
ちなみに会場となった渋谷サクラステージ「Sakura Deeptech Shibuya」は、東急不動産とスクラムスタジオが運営し、「渋谷から世界へ」を掲げてディープテックスタートアップの成長を支援することを目指した場です。
この場所については、新規事業創出のためのアクセラレータープログラムを運営するVCのスクラムベンチャーズ合同会社の山田隆太朗さんが紹介しました。ちなみにスクラムベンチャーズは、ロボット分野ではApptronik(アプトロニック)に投資しています。
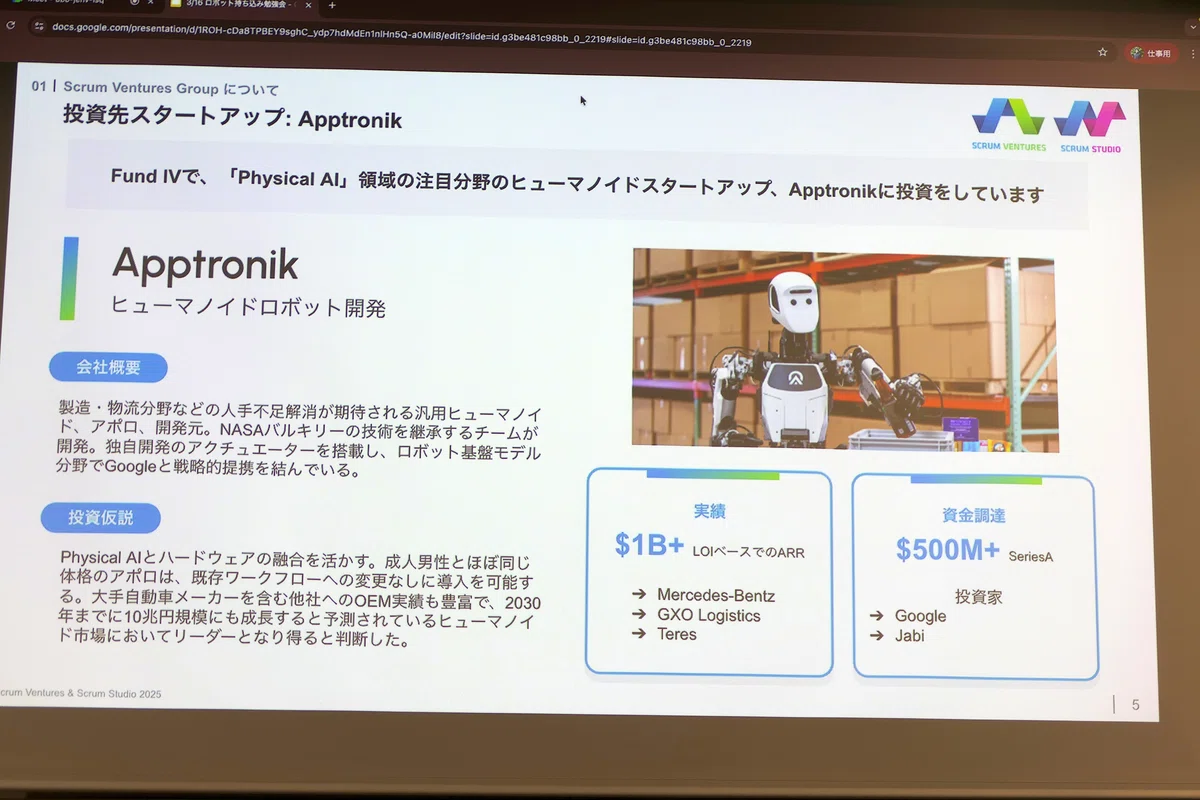
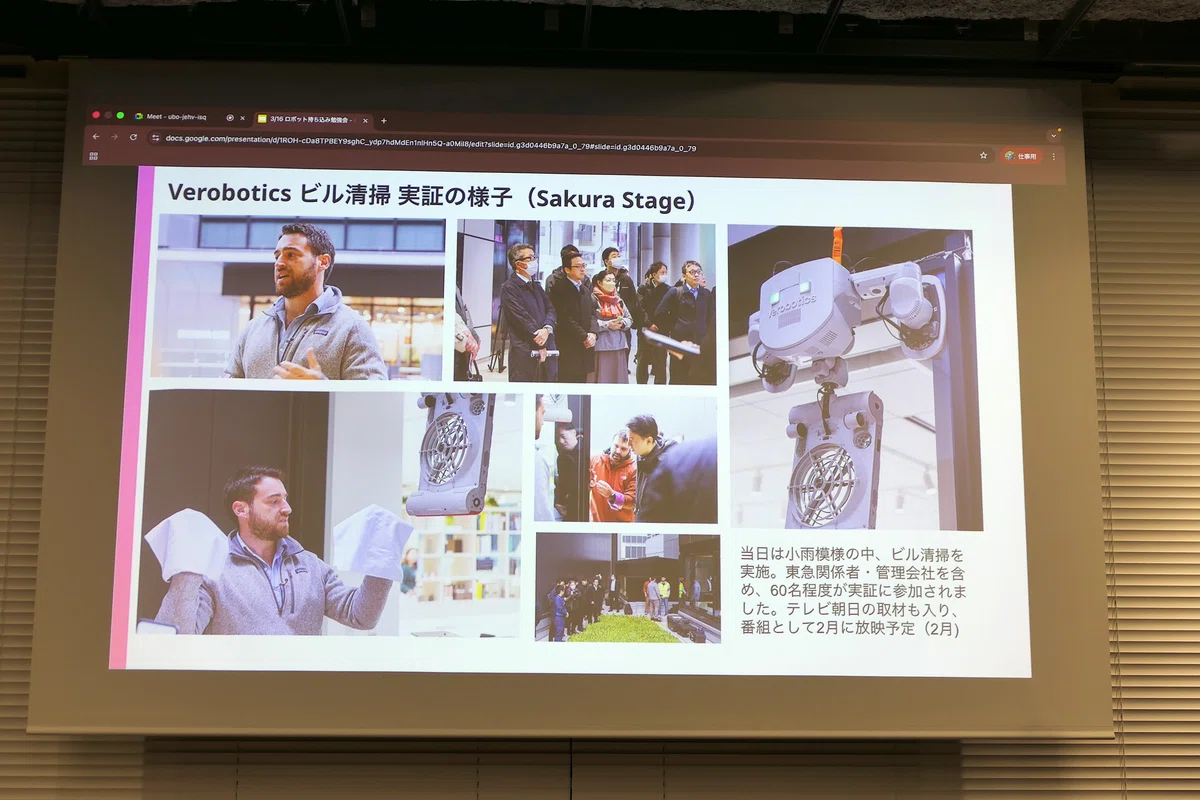
「Sakura Deeptech Shibuya」のメリットについては、東急不動産のアセットを活かして「渋谷」という場所でフィジカルAIの実証の場を提供できる点が強みだと紹介しました。イスラエルのVerobotics(ベロボティックス)による窓ガラス清掃の実証実験を行なったこともあるそうです。
AI学習に必要なデータパイプラインを手がけるFastLabel
トップバッターとして登壇したのは、AI学習を支えるデータの作成・管理・評価などをサポートするAIインフラプラットフォームを提供するFastLabel(ファーストラベル)株式会社代表取締役の鈴木健史さんです。
鈴木さんは従来の「モデル中心(モデルセントリック)」のアプローチから「データ中心(データセントリック)」のアプローチへのパラダイムシフトを説明し、AIロボティクス分野における深刻なデータ不足の問題を指摘しました。解決策として、リアルなロボット操作データ、シミュレーションデータ、人間の行動ビデオ(ヒューマンビデオ)という3層のデータピラミッドを活用するアプローチを紹介して、平和島に設立した「データ収集工場」での取り組みや、VR/ARデバイスを用いたテレオペレーション、データ収集・管理プラットフォーム、人間のデータ活用など、具体的な技術や事例を交えながら、高品質なデータをスケーラブルに生成するためのオペレーションと基盤の重要性を強調しました。
データに関する課題解決を支援するFastLabelの事業と取り組み
FastLabelは2020年に創業し、AI開発における教師データの課題解決を専門とするスタートアップです。機械学習をバックグラウンドに持つ鈴木氏が、社会実装における「教師データ作成」の課題に直面し、創業に至ったとのこと。
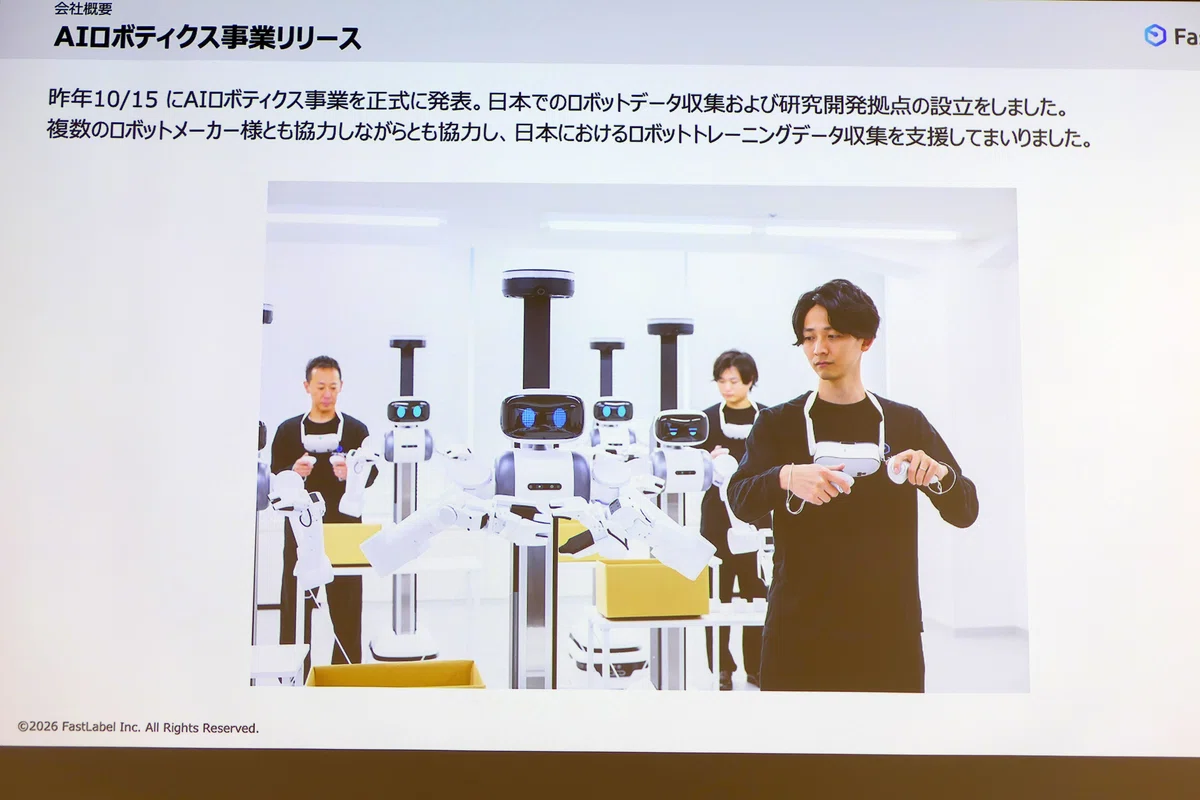
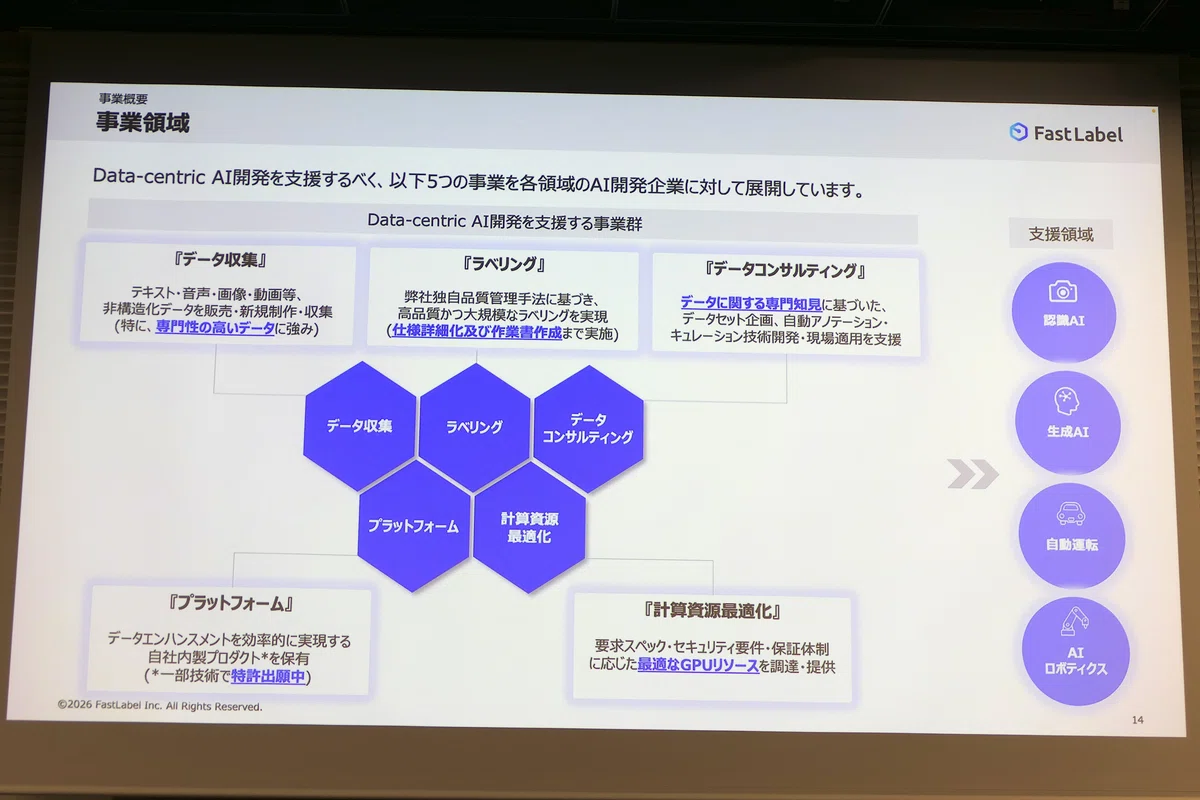
創業以来、データの課題解決に取り組んでいます。初期は自動運転領域の開発支援や、生成AIのデータ面での支援を行っていましたが、2025年初頭からフィジカルAIの検証を開始。2025年10月に正式な事業としてリリースしました。日本版の「データ収集工場」を立ち上げるべく、ugoのロボットなどを活用し、平和島に拠点を設けています。ロボット、自動運転、生成AI、認識AIなど多岐にわたる領域で、データに関する課題解決を支援しているのがFastLabelです。
データセントリックAIの重要性
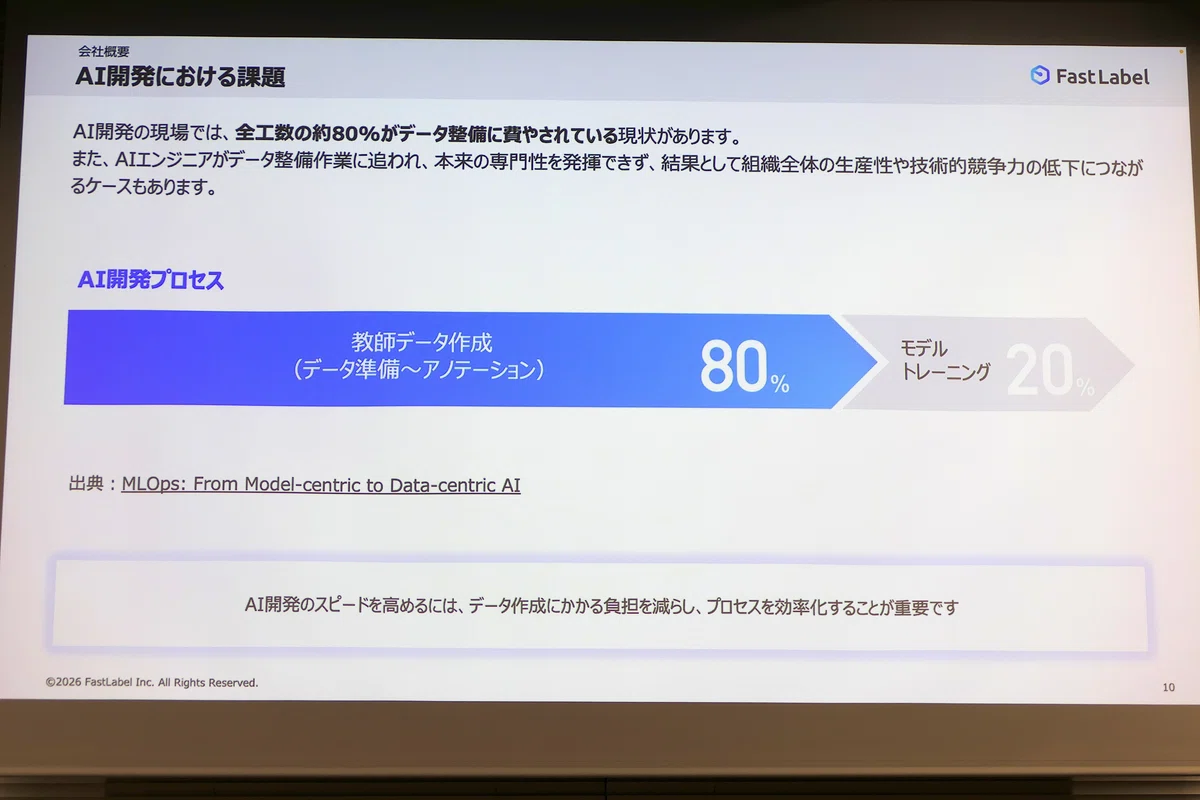
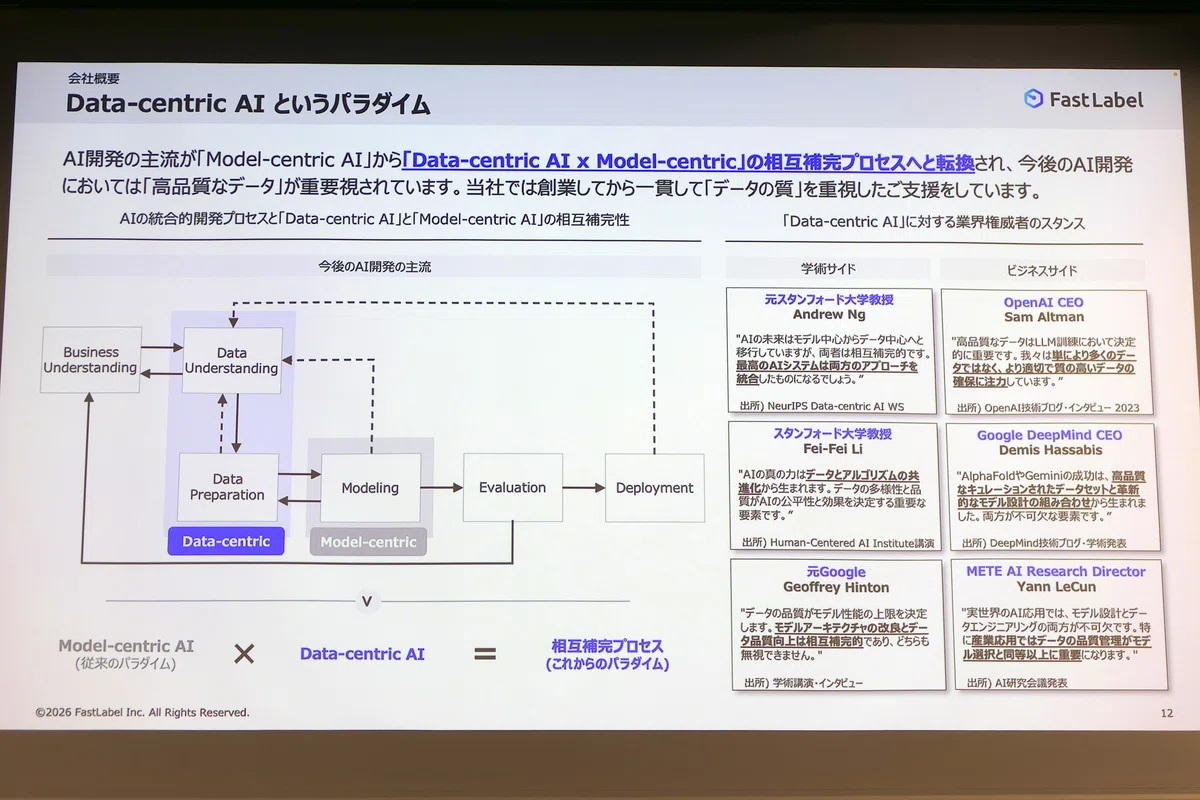
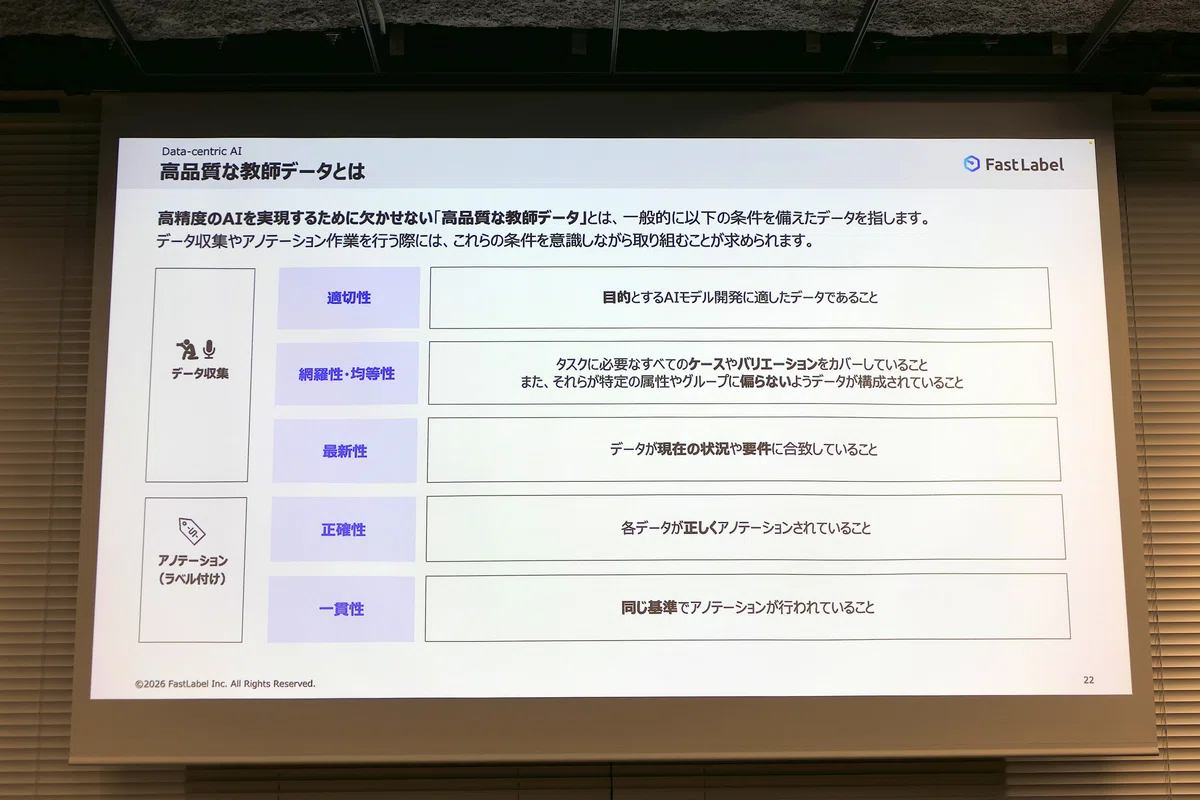
AIを学習させるためには教師データが必要です。例えば、画像内の「車」や「人」の位置を人間が示す(アノテーションする)ことで作成されます。AIはこのような教師データを大量に学習することで、初めて自動で物体を認識できるようになりますが、非常に手間のかかる作業であり、AI開発プロジェクトの工数の約80%が教師データの作成に費やされていると言われています。
AIの性能を高める手法としては二つのアプローチがあります。
一つ目は」モデルセントリック」アプローチ。アルゴリズム自体を改善してAIの性能を高めるアプローチです。
もう一つが「データセントリック」アプローチで、モデルやアルゴリズムを固定し、データの「質」と「量」を改善することで、AIの性能を向上させるアプローチです。
特にデータの多様性は重要です。たとえば自動運転の場合、都市部の昼間の走行データだけを集めても意味がなく、あらゆる状況(天候、時間帯、場所など)の様々なデータを網羅的に収集する必要があります。ロボティクスにおいても同様です。
AI開発プロセス全体(要件定義、準備、学習、デプロイ)で、データのフィードバックを元にデータを改善していくループを回すことも重要になります。
AIロボット開発におけるデータ不足
特に課題となるのは主に強化学習が用いられる歩行などのロコモーションタスクではなく、模倣学習が用いられる「マニピュレーションタスク」におけるデータです。
テキスト、画像、動画といったデータと比較して、ロボットの行動データ(エピソード数)は圧倒的に不足しています。ロボティクス分野は「深刻なデータ不足」を抱えているのです。論文の解析結果でも、フィジカルAIリサーチにおける最大のペインポイントは「スケーラブルなデータ収集」であると指摘されています。
ではロボットに必要なデータとは? 鈴木さんは3層構造ピラミッドで紹介しました。
人間が遠隔操作して収集する実機のリアルなテレオペレーションデータと、シミュレーター上で生成されるデータ(合成データ)、人間の行動を撮影したビデオデータ(ヒューマンビデオ)です。
データ収集・生成のトレンド
海外では、数百~数千人規模のオペレーターが数十台単位のロボットを操作する「データ収集工場」で、大規模なデータ収集が行われています。FastLabelではVRゴーグルや、より直感的に操作可能なデバイスを用いてロボットを遠隔操作して、データを収集しています。
最近は、より低コストかつスケーラブルなデータ取得方法を各社が開発しはじめていますが、そのデータをロボット用に変換するパイプラインは必要です。
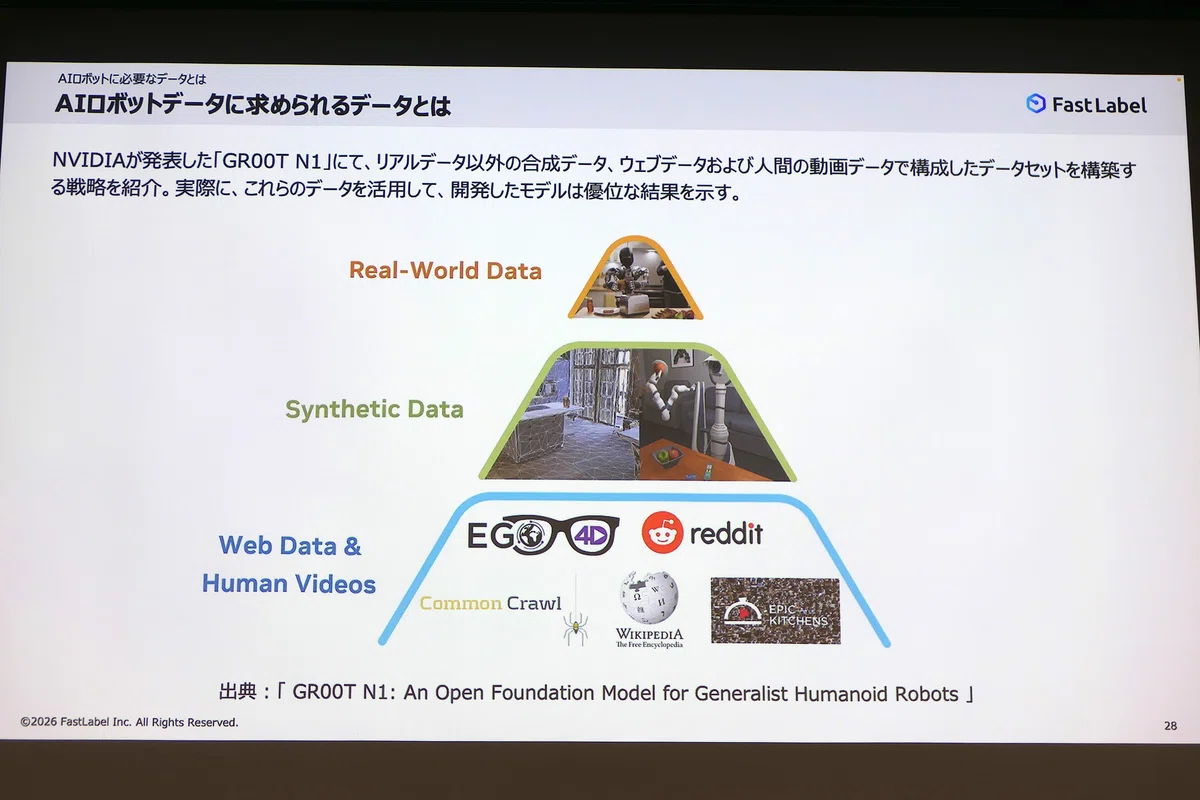
また、人間の行動ビデオを教師あり学習に混ぜ込むアプローチもあります。人間がカメラとリストバンドを装着してタスクを行い、そのデータを使うことで、ロボットが未経験のタスクを実行できる可能性が示されています。
最近の研究では2万時間のヒューマンビデオ、50時間の中間学習データ、そしてわずか4時間の実機ロボットデータで、ロボットが良好に動作することが報告されています。
FastLabelのプラットフォーム
このような状況のなか、FastLabelでは高品質なデータ収集のためにプラットフォームを開発しています。
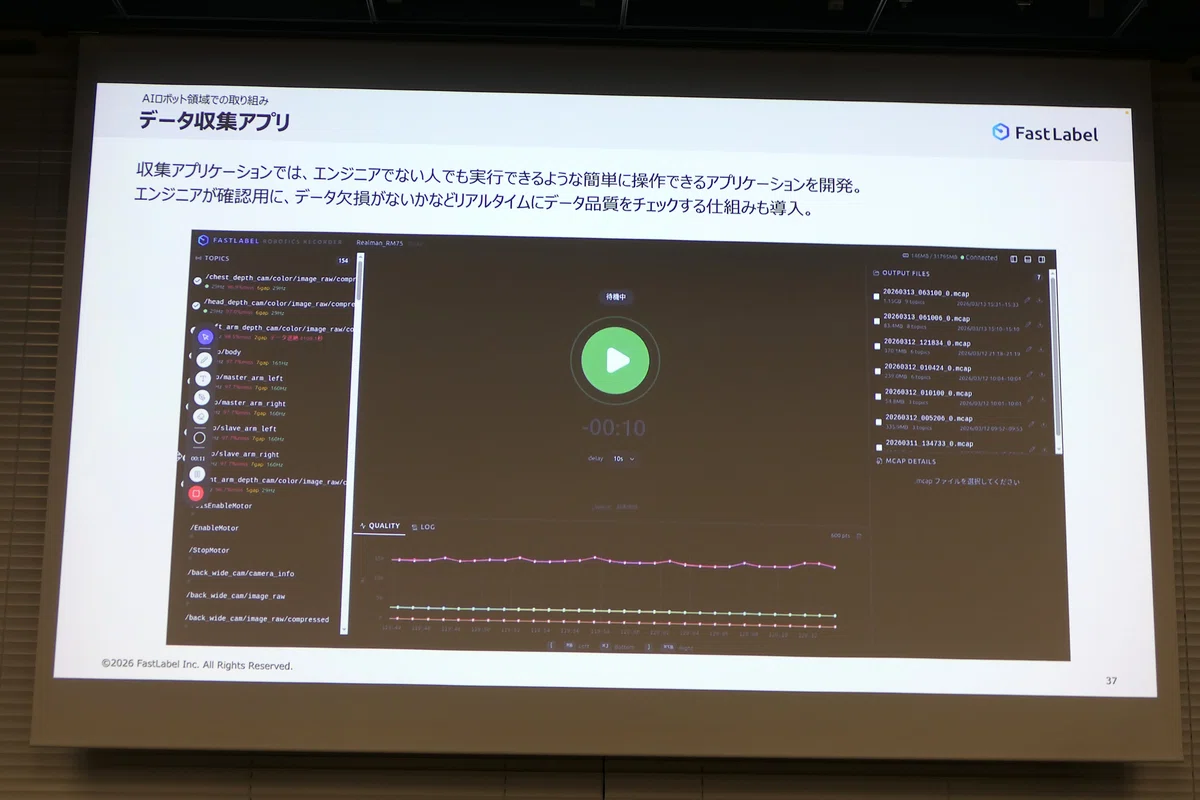
エンジニアでなくても簡単にデータ収集を開始・停止できる簡易なデータ収集アプリケーションは、データの品質をチェックする機能も備えています。
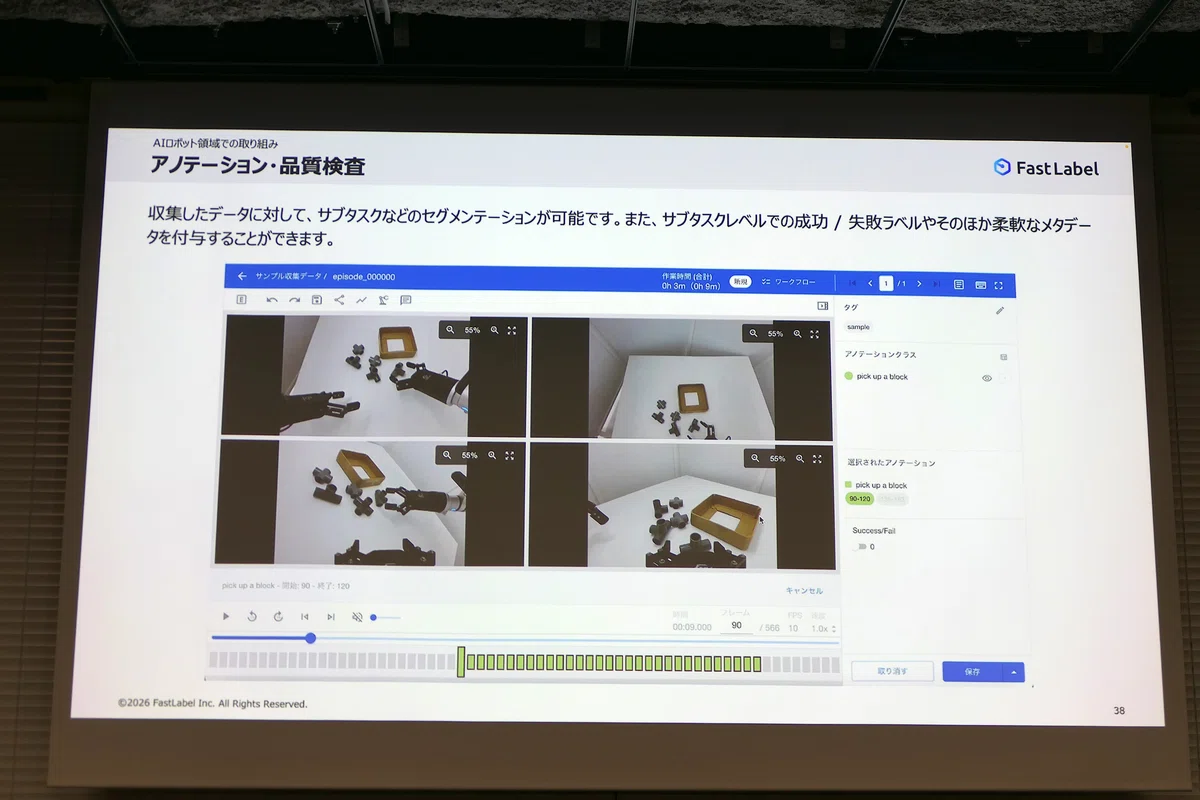
データ管理・アノテーション基盤もあり、収集後のデータに対し、タスクの成功・不成功ラベルの付与や、サブタスクごとのセグメンテーション(区切り分け)が可能です。
ロボットの関節(ジョイント)データを3Dモデルに反映させ、異常な動きがないかを3Dモデル上で品質を確認する仕組みも導入しています。
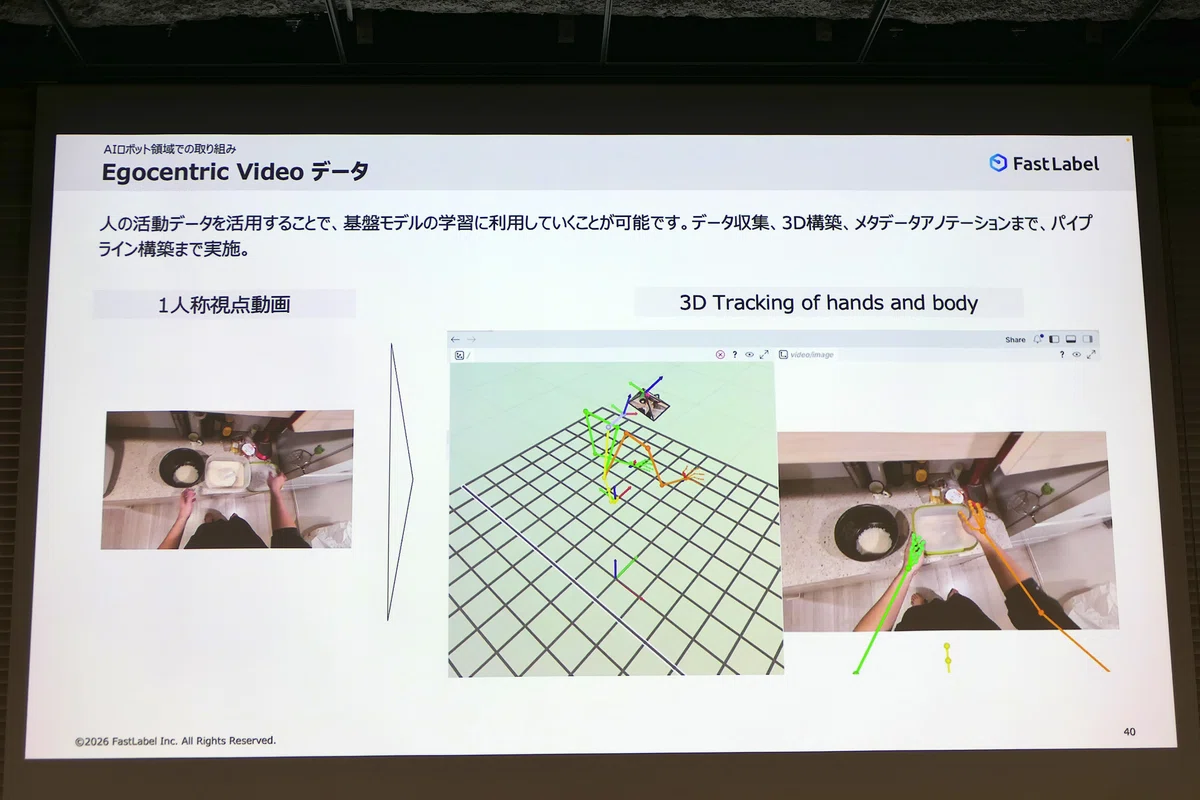
人間の一人称視点ビデオ(エゴセントリックビデオ)から、コンピュータビジョンモデルを用いて手や体の3Dトラッキング情報を復元し、ロボット用のデータに変換する取り組みも行っています。
また、高価で動かすのが難しい実機ロボットの代わりに、シミュレーション上でテレオペレーションを行う仕組みも開発しています。NVIDIA Isaac Sim上でリアルなアセット(たとえばugoのロボット等)を再現し、ドメインランダマイゼーション等でデータを増やす取り組みも行っています。
なお、必要なデータ量は、簡単なタスクなら50エピソードくらいですみますが、複雑なタスクだと100時間くらい必要だそうです。テレオペレーターは常に募集中で、「うまい人のデータだとロボットが憑依したように動く」そうです。
ugoの「AIロボット向け模倣学習キット」
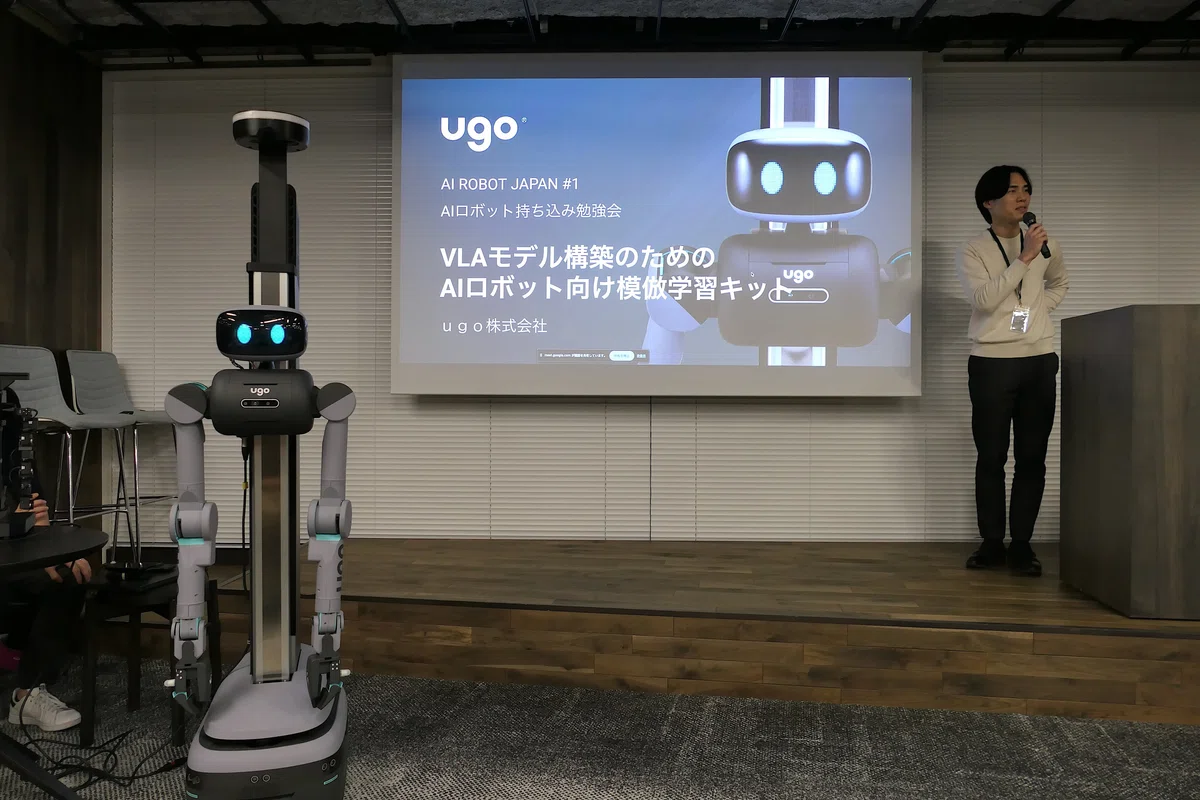
続いて、ugo株式会社の松井健さんが登壇しました。ugo(ユーゴー)は主に点検・警備分野のロボット事業を行っている会社で、設計・開発・量産・修理まで一貫内製化しています。
2025年10月からはフィジカルAIのための「AIロボット向け模倣学習キット」も開発・販売しており、松井さんは主にその技術概要と活用法を紹介しました。
既存ビジネスとフィジカルAIへの移行
松井さんはもともとソフトウェアエンジニアで、テクノロジー分野での起業を3回経験しています。東京や中国・深圳の工場と連携したIoT関連機器の量産を経験したことから「動くIoT」の必要性を実感し、ロボット領域へ入ったそうです。そのためugoの根幹にはIoT視点があります。現在の体制はおおよそ90名弱。自社内にロボット生産ラインを作り、量産し、出荷しています。
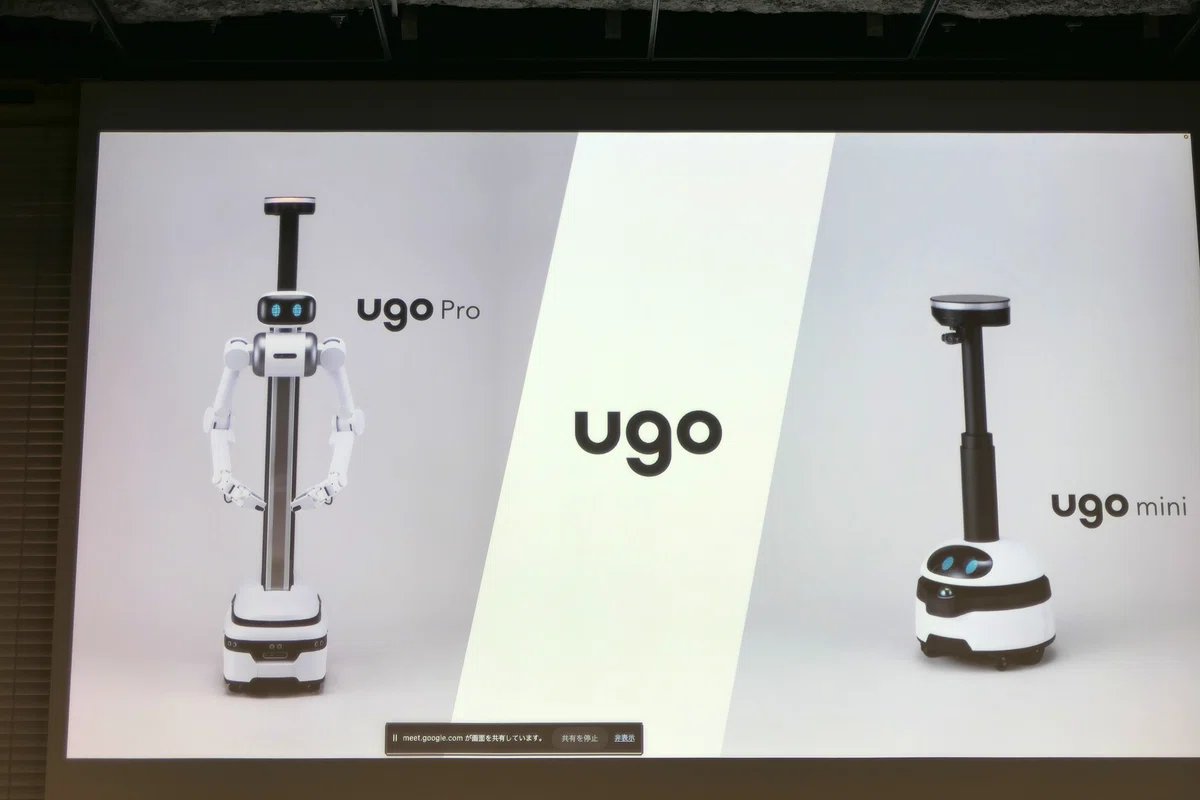
現在の主要プロダクトは双腕型の「ugo pro」と、簡易で点検専用モデルの「ugo mini」の2機種体制。ROSやSLAMを使ったルールベースで制御しています。
いっぽう、現実世界の理解を行動に変える「フィジカルAI」が登場しています。センサーで外界の状況を把握し、3D空間・物理を踏まえた思考を行動へ落とし込むAIです。車だと自動運転、ロボットでは自律動作ということになります。
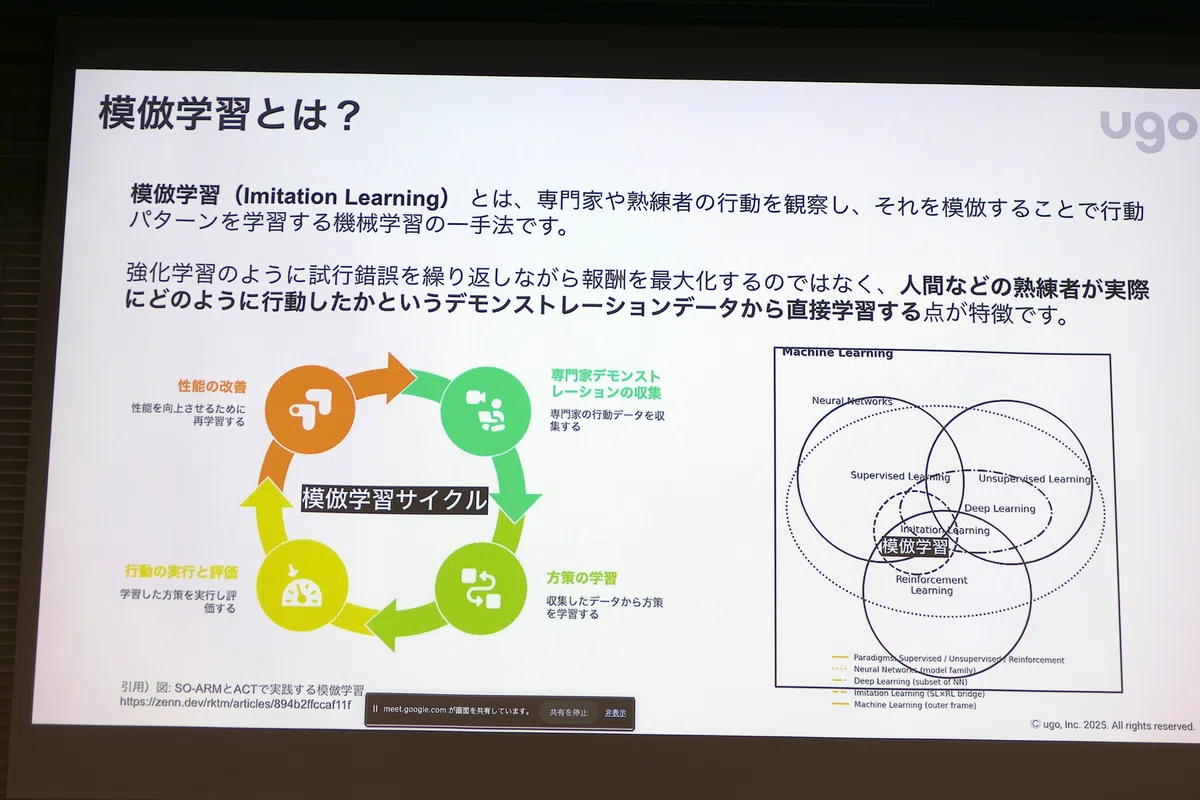
そのためのVLA(Vision-Language-Action)モデルの学習のためには大量・多様なデータが重要です。そこで米中、そして日本国内でもデータ収集拠点がビジネス化しており、今後はその「データの売買」という新たなビジネスも発生するだろうと松井さんたちは考えています。
ugo模倣学習キット
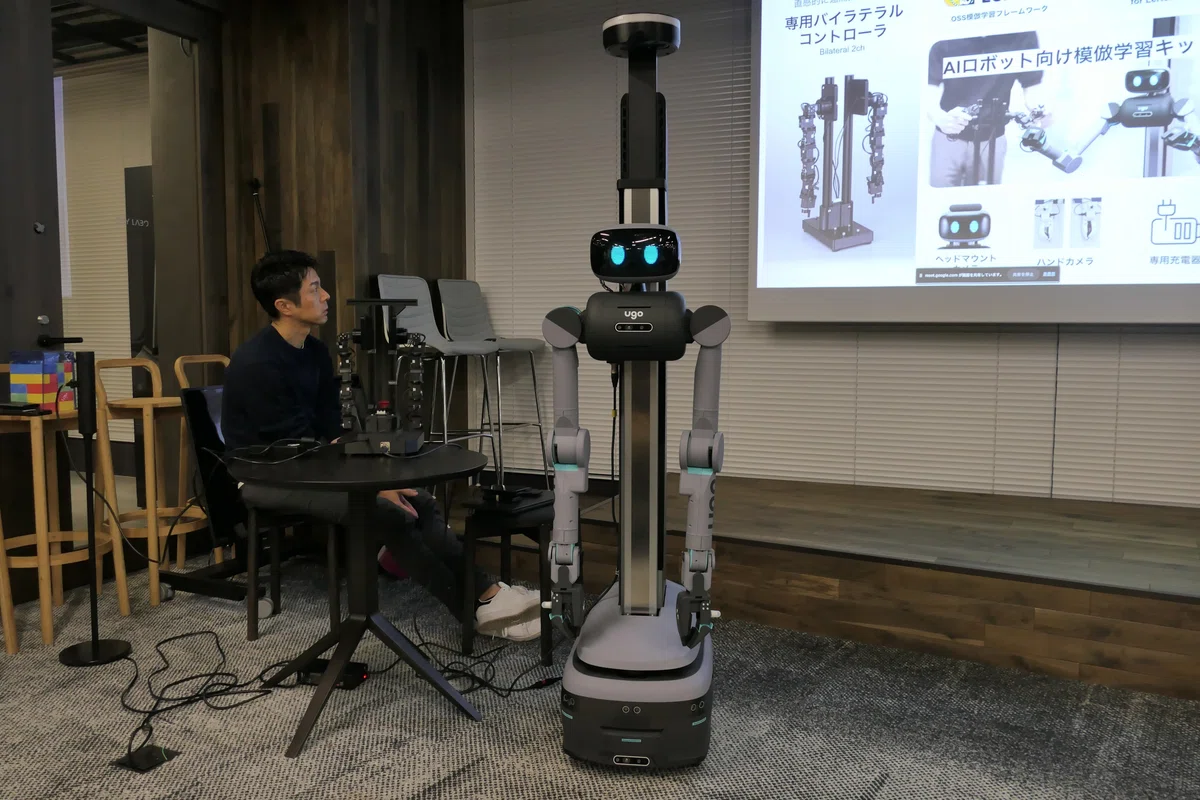
そこでugoが開発したのが「模倣学習キット」です。2025年夏に企画し、三ヶ月足らずで製品化しました。
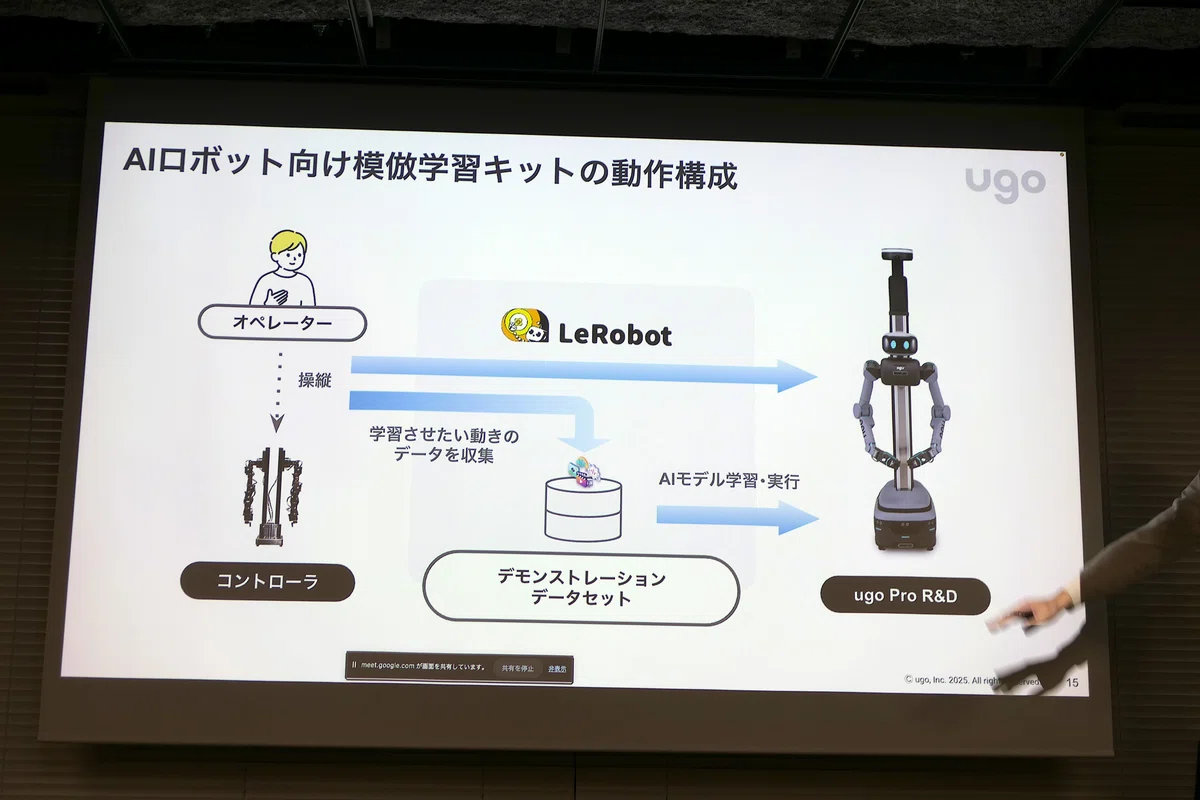
構成は専用バイラテラル・コントローラー(リーダー)、片腕7自由度のロボット(フォロワー)、頭部+左右ハンドのマルチカメラとなっています。コントローラーもロボットと同軸構成です。VRコントローラーだと「空を切る」操作になってしまいますが、バイラテラル(双方向通信)を用いることで、ロボット側の力覚・反動を操作者へ返す、直感操作を実現しました。グリッパーの掴み操作もフィードバックされます。通信周期は40Hzです。
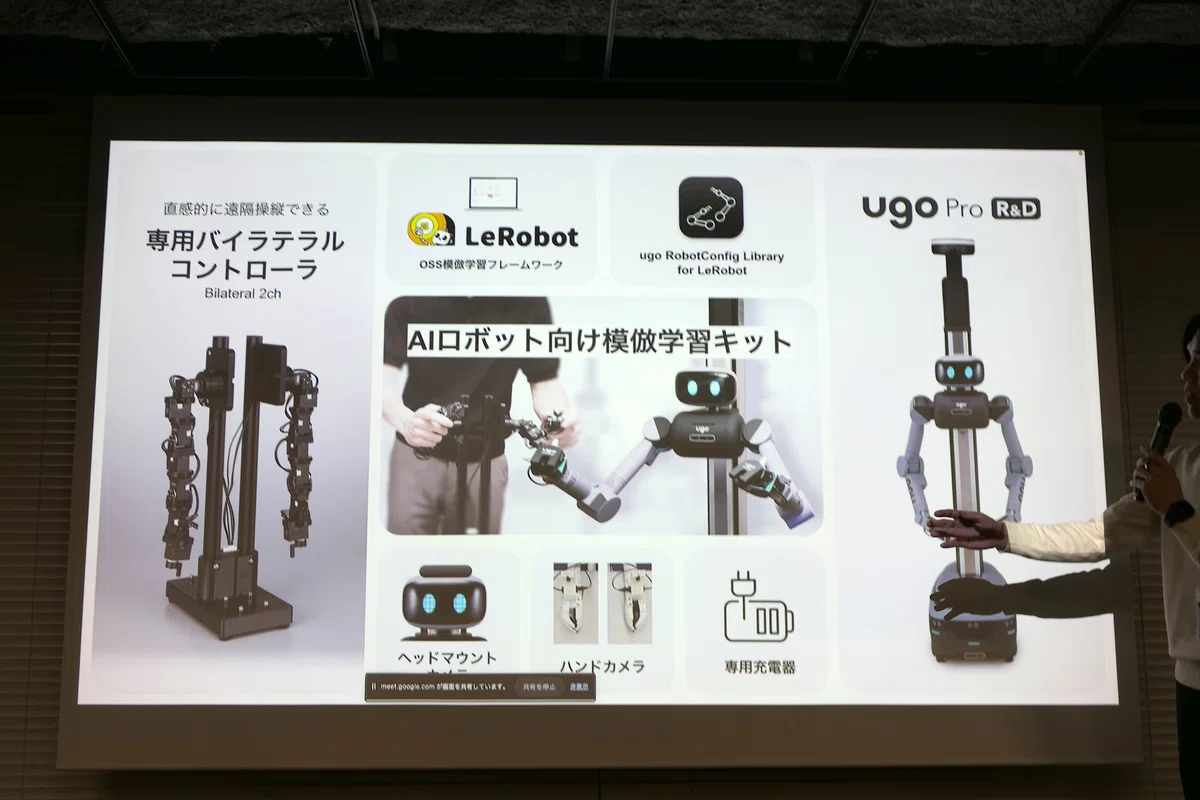
ロボットの模倣学習・強化学習を行うために広く用いられているフレームワーク「LeRobot」に対応させるためのプラグインや、テレオペ用マルチカメラ映像ツールはオープンソースとして公開しています。
「LeRobot」フレームワークとは
なお、「LeRobot」とは、機械学習アプリ作成ツールを開発しているHugging Face(ハギングフェイス)によるロボット学習向けオープンソースライブラリ/フレームワークです。データ収集から学習、実機推論までの統合パイプラインを提供しています。
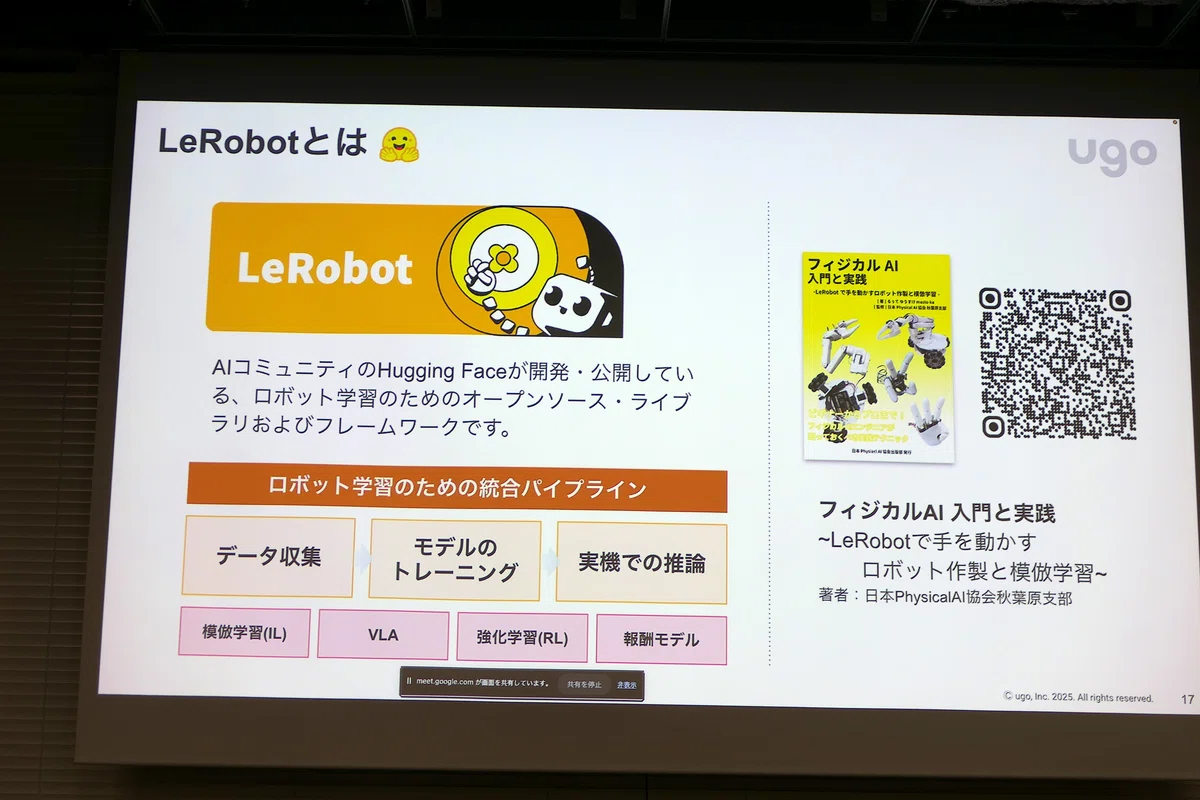
LeRobotの特徴は、模倣学習、VLA、強化学習など様々な学習方法に対応し、ハードウェアについても低価格モデルから高価格モデルまで幅広く対応しているところです。柔軟なプラグインアーキテクチャにより、所定のルールでクラスを作成するだけで新規ハードウェアを容易に追加できるのです。
サポートするポリシー/モデルとしては、ACT(Action Chunking with Transformer)、Diffusion Policyのようなベーシックな手法から、「SmolVLA」や、Physical Intelligenceの「π0/π0.5」、NVIDIAの「GR00T」など、多くのポリシーに対応しています。
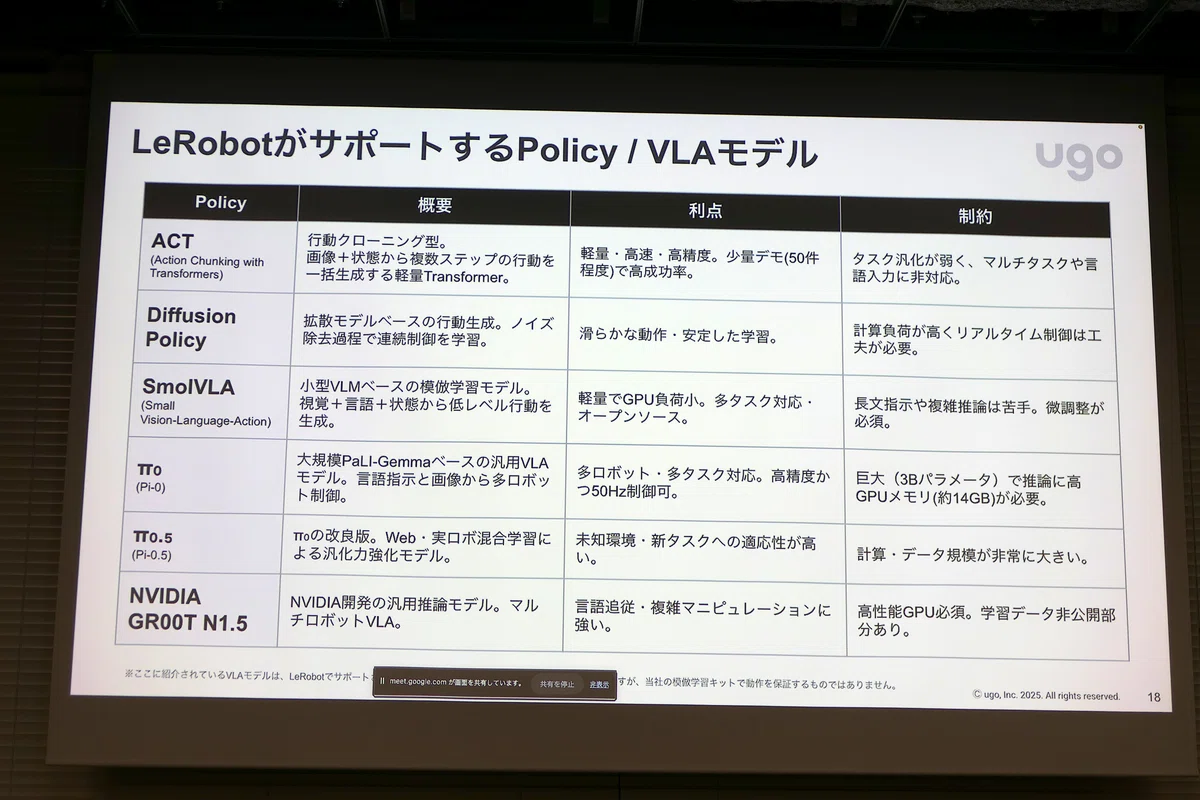
オープンソースで公開されていることから、今後もコミュニティで、どんどんと対応ロボットが拡大していくことが期待されています。
「ugo pro」の「LeRobot」対応の実装詳細
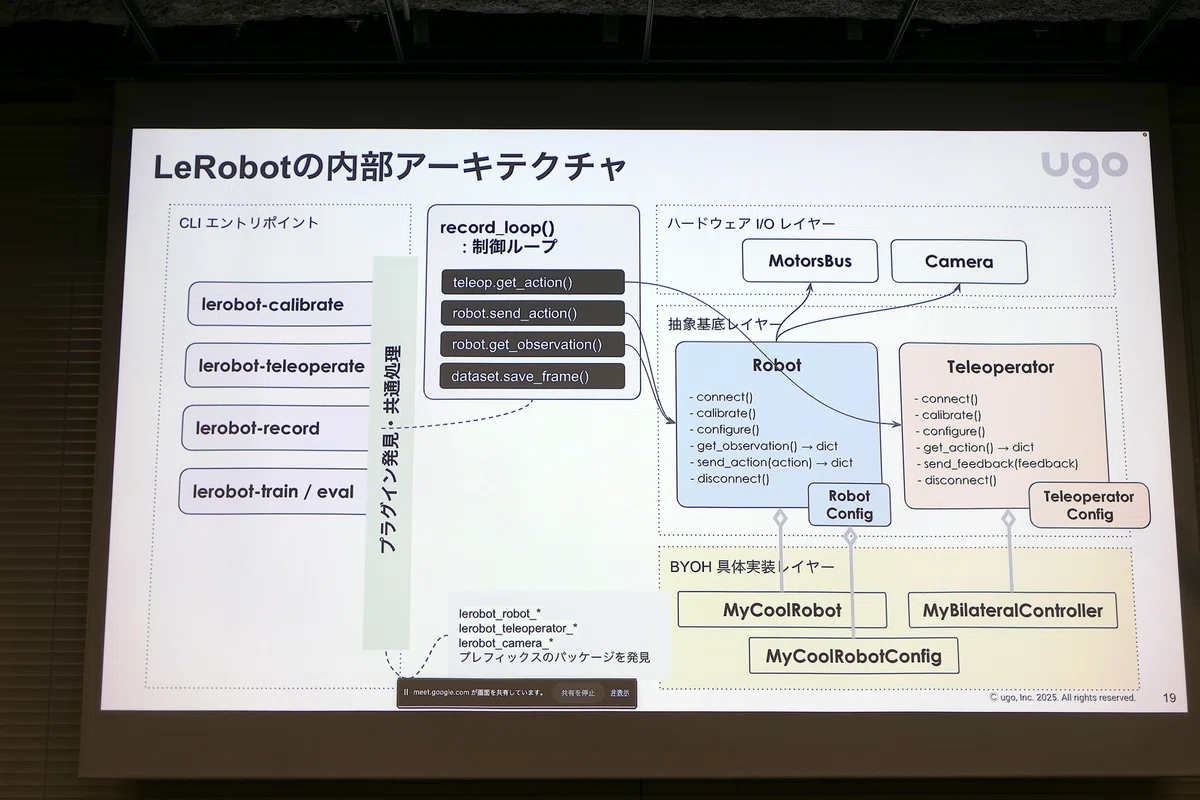
LeRobotはプラグイン方式を採用しており、抽象レイヤーにはRobotクラスとTeleoperatorクラスを持っています。ugoにおいてもこれらを継承し、「ugo proロボット」「バイラテラルコントローラー」等のクラスを実装しました。
LeRobotではドキュメント準拠の形式でパッケージ名を定義すると自動認識してくれますので、柔軟なハードウェア追加が可能です。
代表的なコマンドとしてはキャリブレーション、テレオペレーション、record(収録)、トレーニング(学習/推論)などがあります。
レコーディングのメインループは、getAction(テレオペ制御入力取得: VR/バイラテラル等)、sendAction(ロボットのアクチュエータへ指示)、getObservation(関節角度・カメラ等センサー情報取得)、saveFrame(1フレーム記録)となっています。つまり、アクション取得→指示送信→観測取得→保存で、必要データの収集と指示送信を各関数で実装するシンプル構成です。
アーム型のロボットのみならず移動系のロボットにも適用可能です。センシング入力とアクチュエータ出力が実装できれば学習環境を構築できます。
データ収集・学習運用のワークフロー
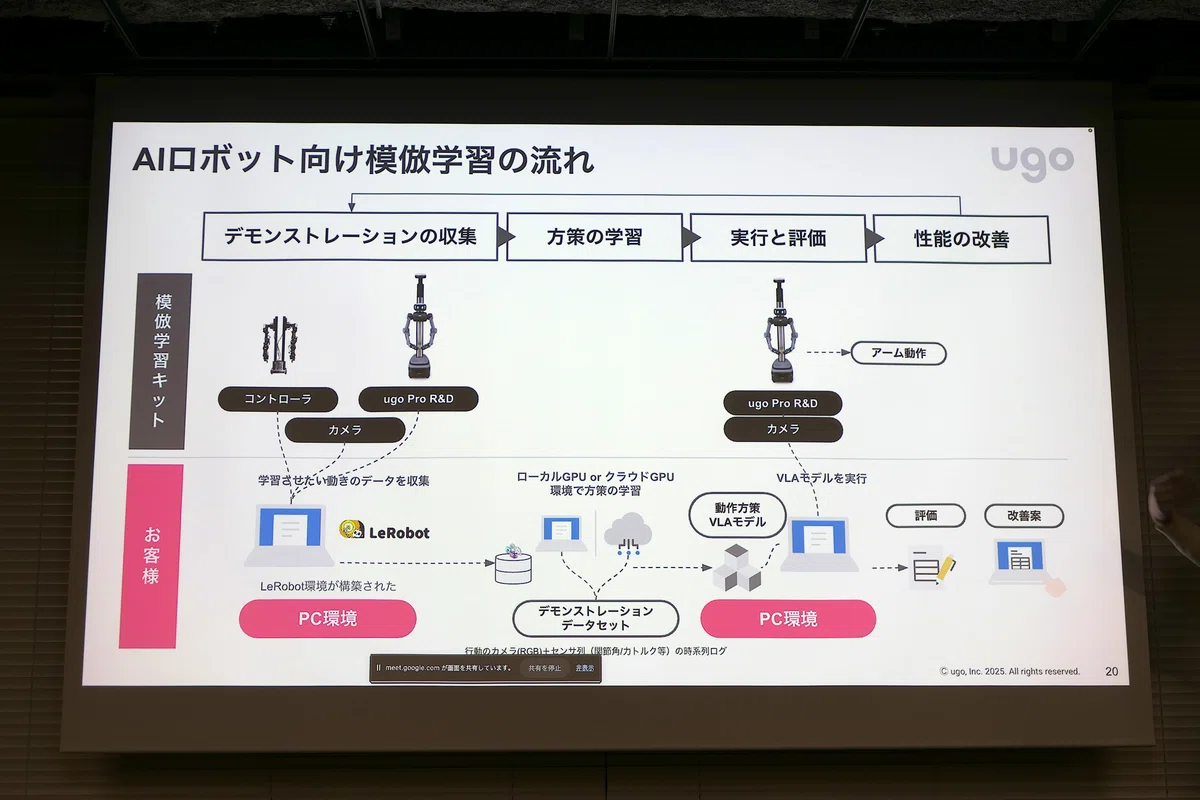
データ収集から学習・推論までの流れは以下のとおりです。
遠隔操作でデモを実行し、関節角度・映像をエピソード単位で記録します。それをローカル保存、またはHugging Faceクラウドへアップロードします。これを繰り返すことで、数十〜数千エピソードを蓄積できたら、動作ポリシーやVLAモデルを学習させます。ローカルGPUでもクラウドGPUでも学習は可能です。
学習させたあとは、学習済みモデルをロボットへ展開して推論・自律動作を実施し、フィードバックに基づく反復改善を行います。
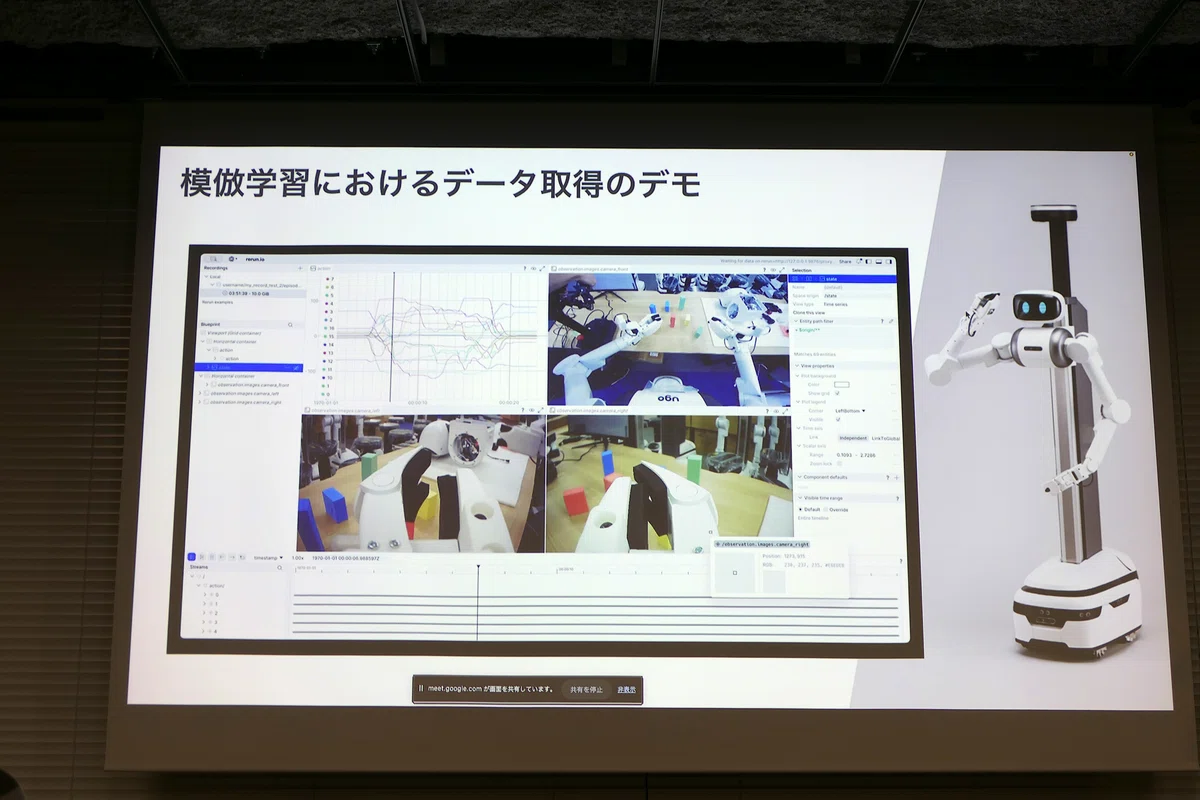
そのための可視化・ツール群としては、頭部・左右ハンドカメラの同期映像や各サーボの関節情報を時系列で表示・記録するオープンソース可視化ツールや、オペレーター向けには、テレオペ映像ツールを提供し、遠隔操作を支援します。なお遠隔操作といっても、ロボット学習用データ取集においては、近距離でのテレオペのことが多くなります。
模倣学習のためのデータ品質向上の指針
データは量も大事ですが、品質もとても重要です。そのためにはタスク設計、カメラ配置、多様性などが重要です。
タスクについては明確でシンプルなタスクから開始し、基本動作を安定化ささせることがまずは重要です。
カメラについては、対象物が確実に画角へ収まるよう調整すべきです。照明・影・背景など周囲影響に留意して誤動作を抑制する必要があります。
汎化させるためには多様性も重要ですが段階的に行うべきです。照明、把持位置、物体の形・色・向き・配置を少しずつ拡張していきます。一度に増やしすぎると性能劣化や不安定化を招きます。
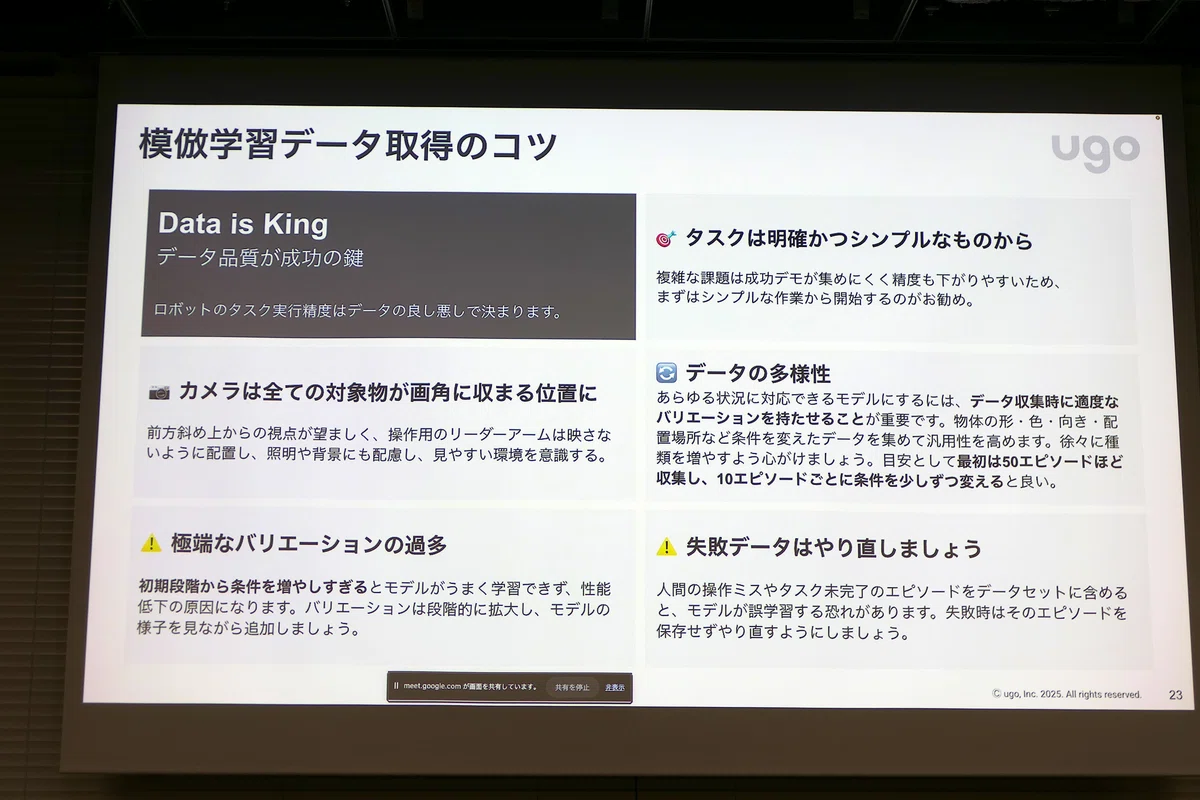
また、失敗データはそのままにせず、除去し、やり直しすべきです。大量収集していると失敗データが紛れ込みがちですが、放置するとモデルのバランスが崩壊することもあります。プラットフォーム運用でも品質管理を重視しなければなりません。
最後に松井さんは「一緒にラーニングロボットをやりましょう」と呼びかけました。
ABEJAのフィジカルAIへの取り組み
最後に登壇したのはAI社会実装を強みとする株式会社ABEJA(アベジャ) 。まず、同社のエンボディドインテリジェンスグループで事業開発を手がける栗林徹さんが、VLA立ち上げ待ちのあいだに、同社と今日のデモ等の概要を紹介しました。
ABEJAは2012年創業。ディープラーニングの台頭以降、小売領域の機械学習ソリューションなどの社会実装に注力しているスタートアップです。IoT近傍からセンシングだけではなくアクチュエーション、すなわち「フィジカルAI」へと領域を拡張しています。
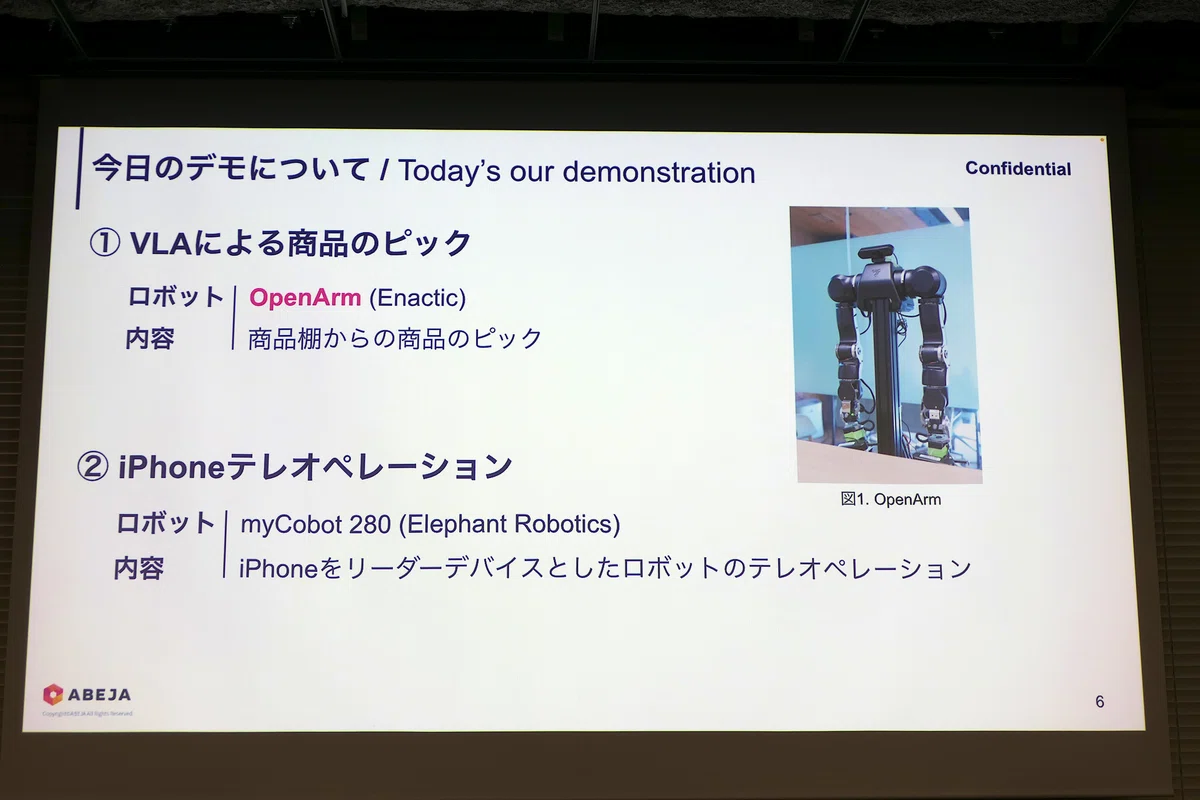
今回は、Enacticのオープンソースの双腕ロボットアーム「OpenArm」を一部改造し、リーダーアームとフォロワーアームのペアで紹介。デモではVLA(π0.5)を使って「ウィダーインゼリー」を取って右側のカゴへ入れる、いわゆるピック&プレースにしようとするというデモを行いました。現時点ではまだまだちょっと難しいようです。
なお、デモはもう一つあり、小型のロボットアーム「MyCobot」をiPhone(ARKit)で操作する簡易なテレオペレーションでした。実機デモが見られるのはリアルイベントならではです。
VLA(視覚-言語-アクション)モデルとは
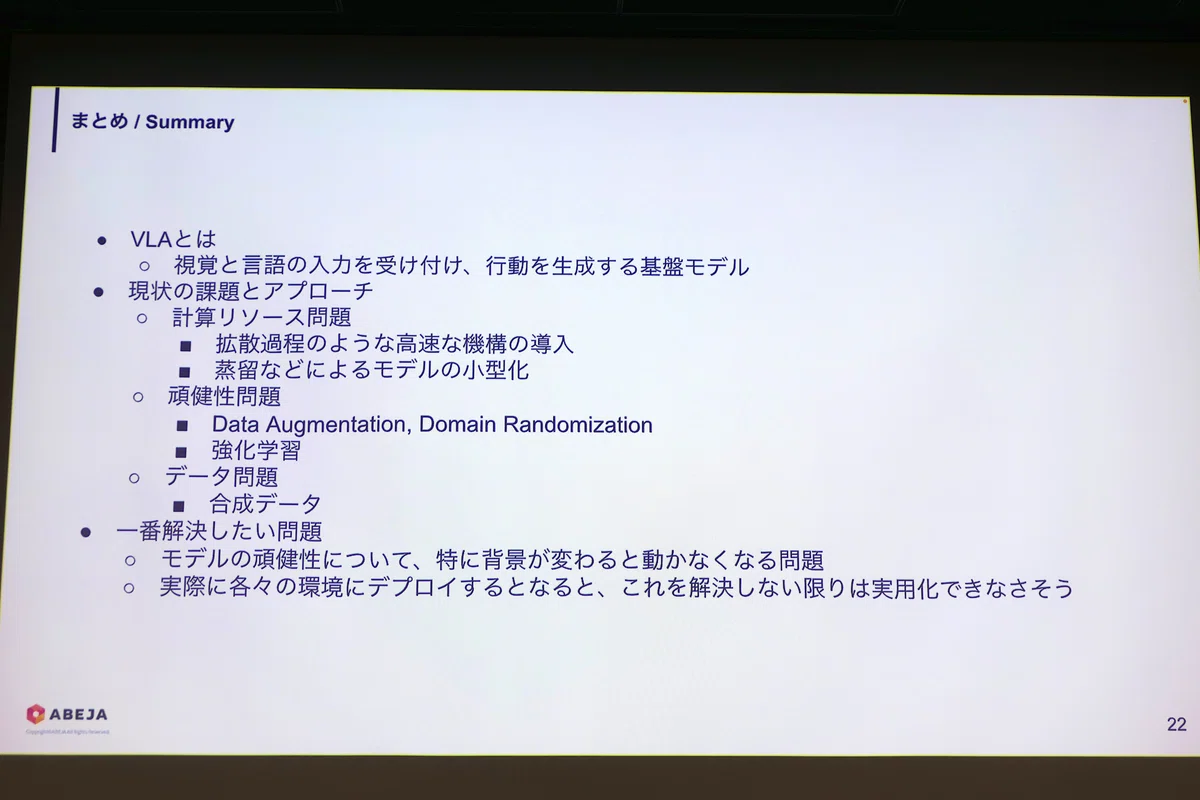
とりあえずデモを行い「なかなか難しい」ということを会場参加者たちで共有したあと、同社データサイエンティストの岩城史享さんが登壇し、VLAの活用の現状と課題について講演しました。
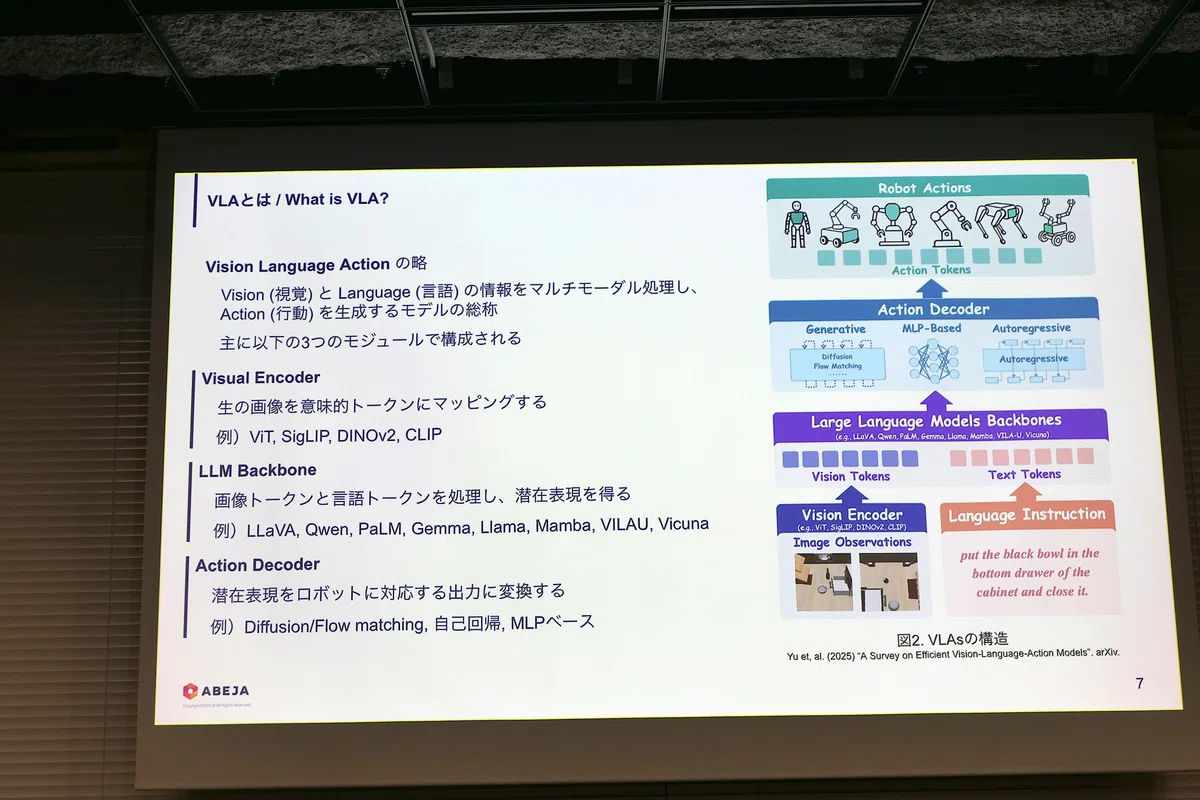
VLA(Vision-Language-Action)とは視覚と言語の情報をマルチモーダル処理し、ロボット動作コードを生成するモデル群のことです。基本的に、画像を言語的に扱える意味トークンへマッピング「ビジュアルエンコーダ」と、画像・言語トークンを処理し潜在表現を獲得する「LLMバックボーン」、そして潜在表現からロボット制御の実コードに変換する「アクションデコーダ—」の3モジュールから構成されています。
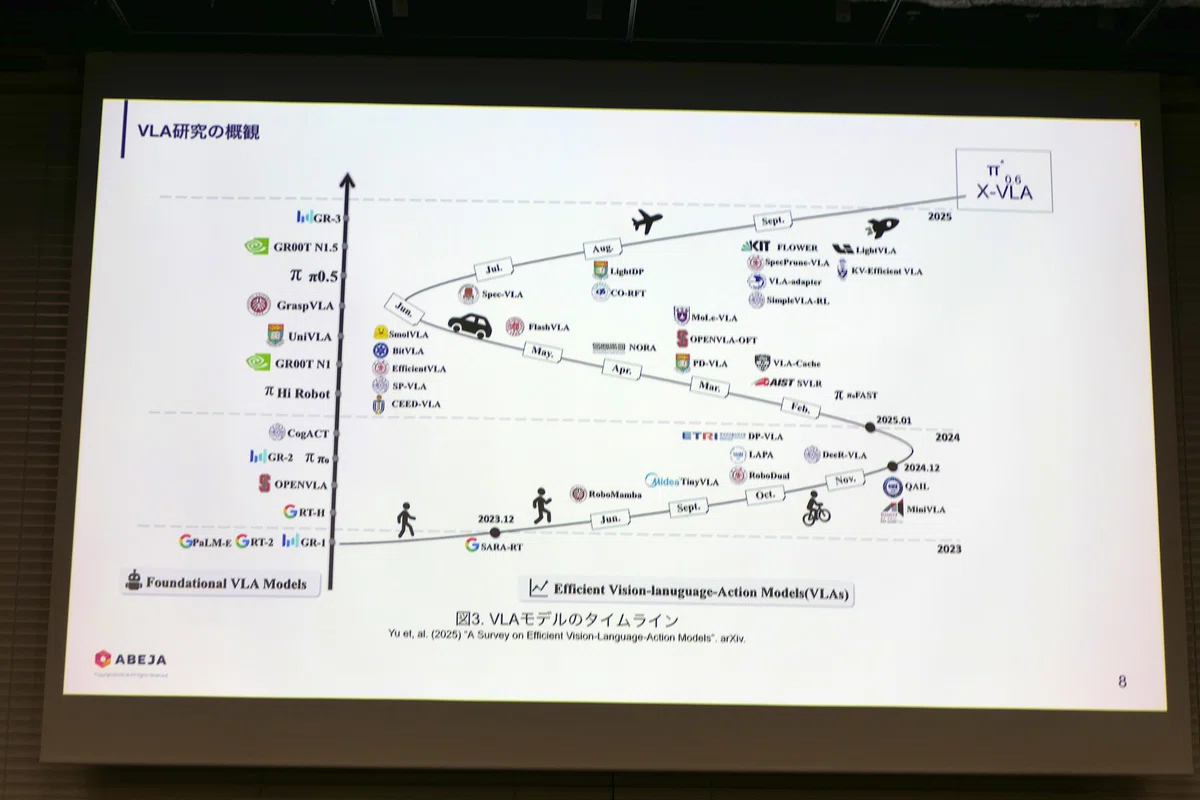
「VLA」という言葉が登場したのは2023年、Google DeepMindの「RT-2」からで、そのあと、Physical Intelligenceのπシリーズ(π0、π0.5、π0.6など)や、NVIDIAのGROOTなどが登場しました。RT-2は約55Bと巨大なモデルでしたが、π0系は3.3B、X-VLAは0.9Bへと小型化が進行している点も興味深いところです。
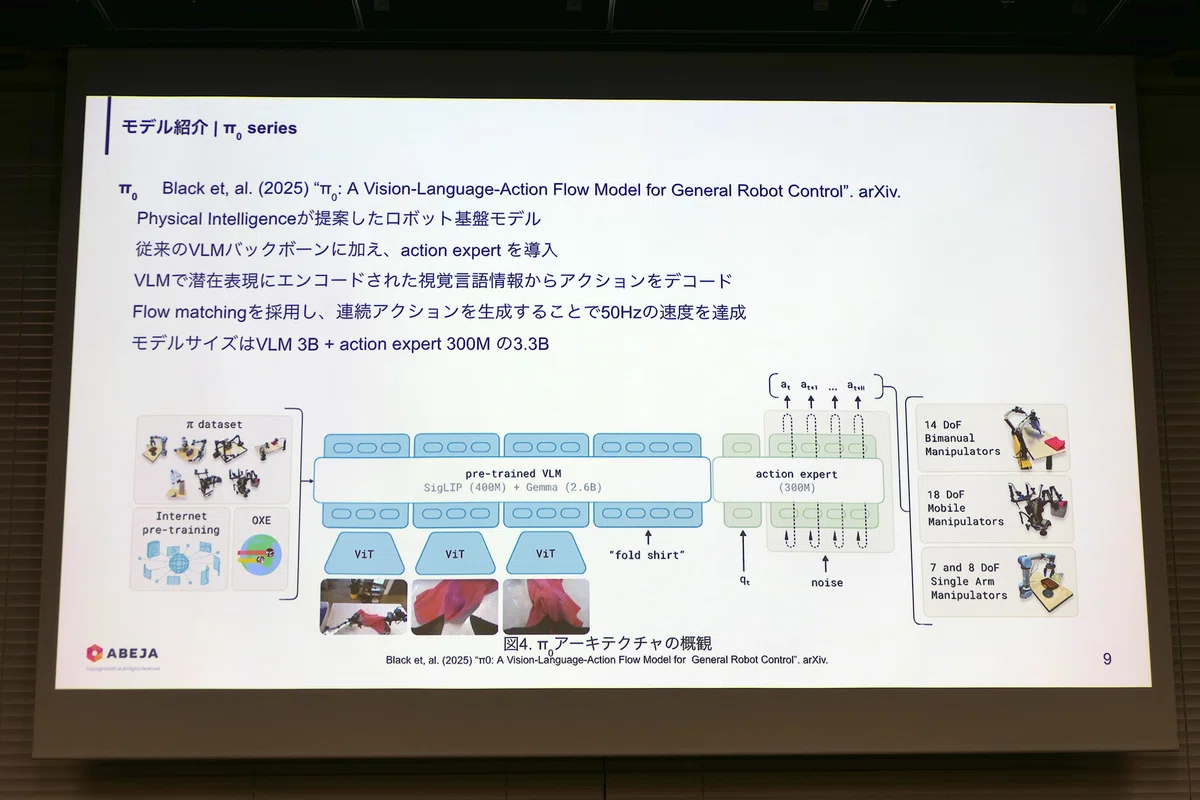
π0の特徴は、VLMバックボーンにアクション生成を担わせるのではなく、「ActionExpert」というモジュールにアクション生成させたところです。拡散モデルの一種である「Flow Matching」を用いて、50Hzで滑らかで連続的なアクション軌道を生成しています。いま、多くの人たちが検証に用いているモデルは「π0.5」です。
社会実装の壁と技術的アプローチ
社会実装の壁として岩城さんが挙げたのは、計算リソース、頑健性、データの3つです。
課題1:計算リソース(推論速度・資源制約)
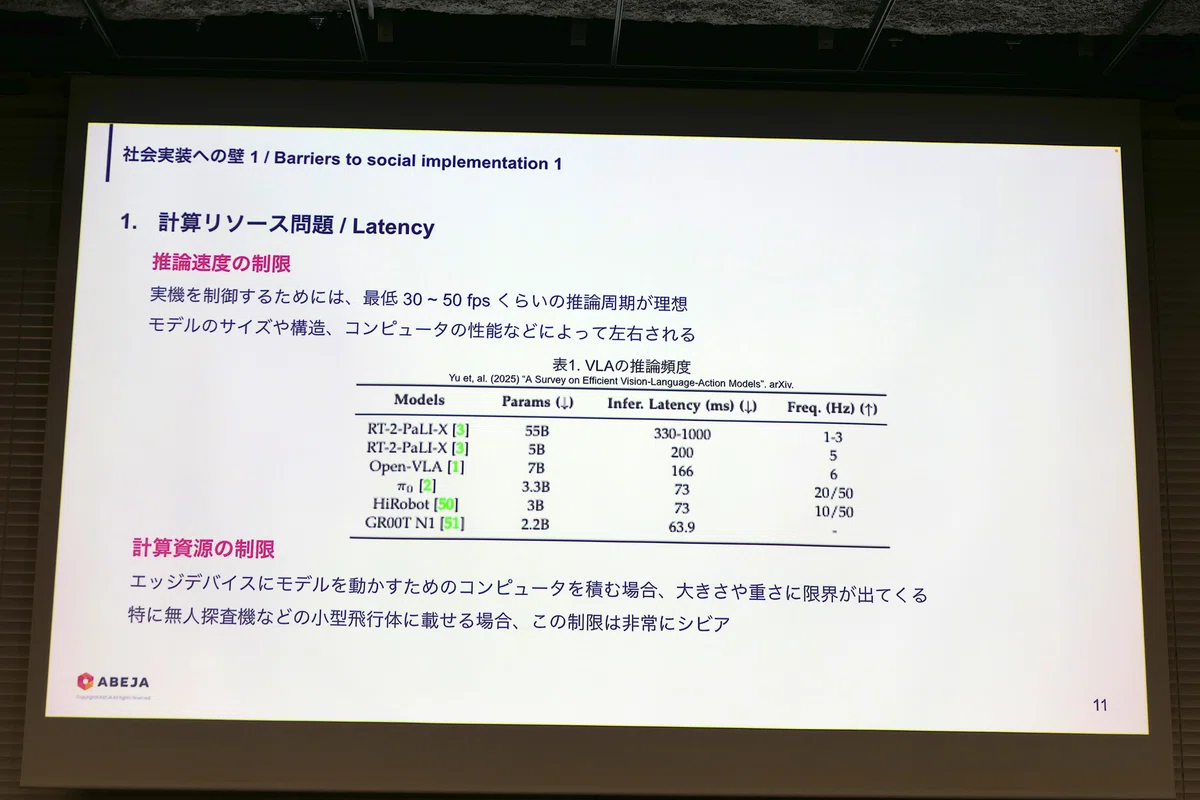
実機制御では理想的に30〜50 FPSの推論周期が望ましいのですが、それはモデルサイズ・構造・ハード性能に依存します。
また、エッジデバイス搭載時にはコンピュータのサイズや消費電力の制約があります。「特にUAV搭載の場合はボトルネックになり得る」と岩城さんは指摘しました。
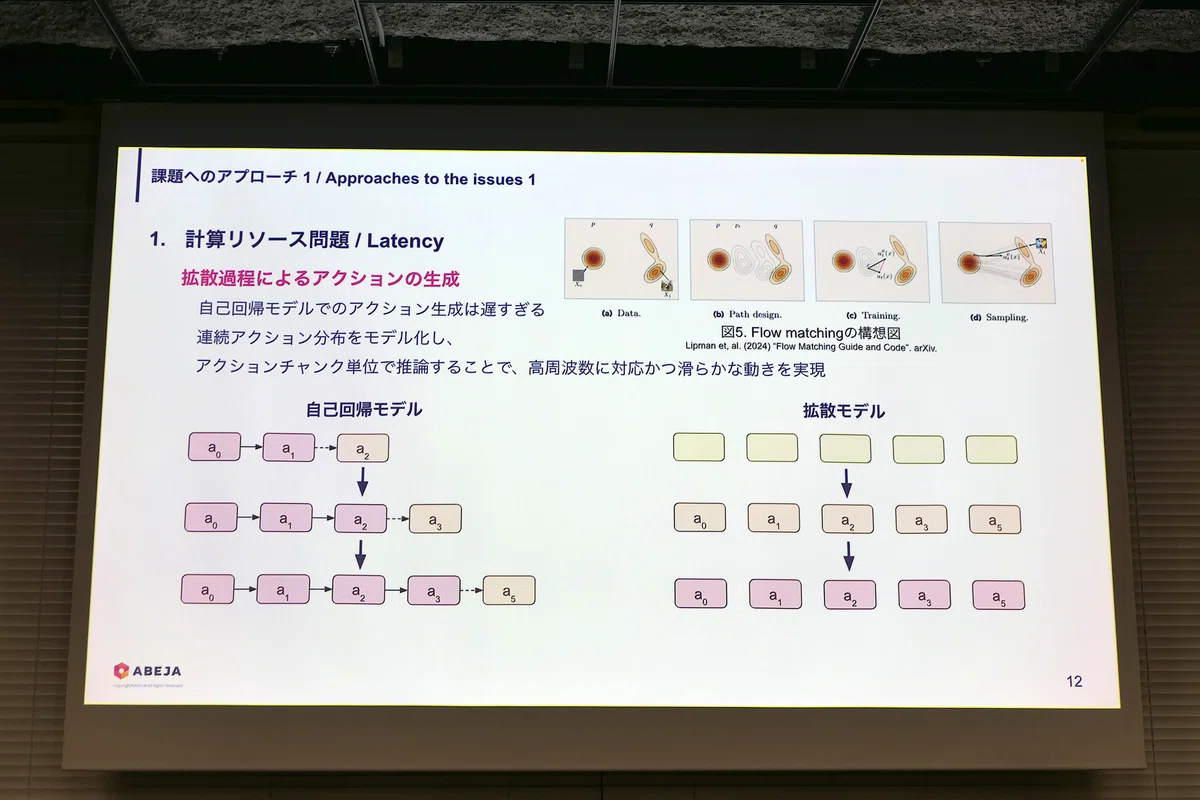
推論速度も問題です。自己回帰型(RT-1/RT-2/OpenVLA)は逐次生成なので遅く、OpenVLAは約6FPSと不十分です。
対策の一つは「π0」のような拡散モデル導入による高速化です。アクションチャンク単位の推論により高周波・滑らかな動きに対応することができます。FAST (Frequency-space Action Sequence Tokenization)という手法等で採用されているアプローチです。
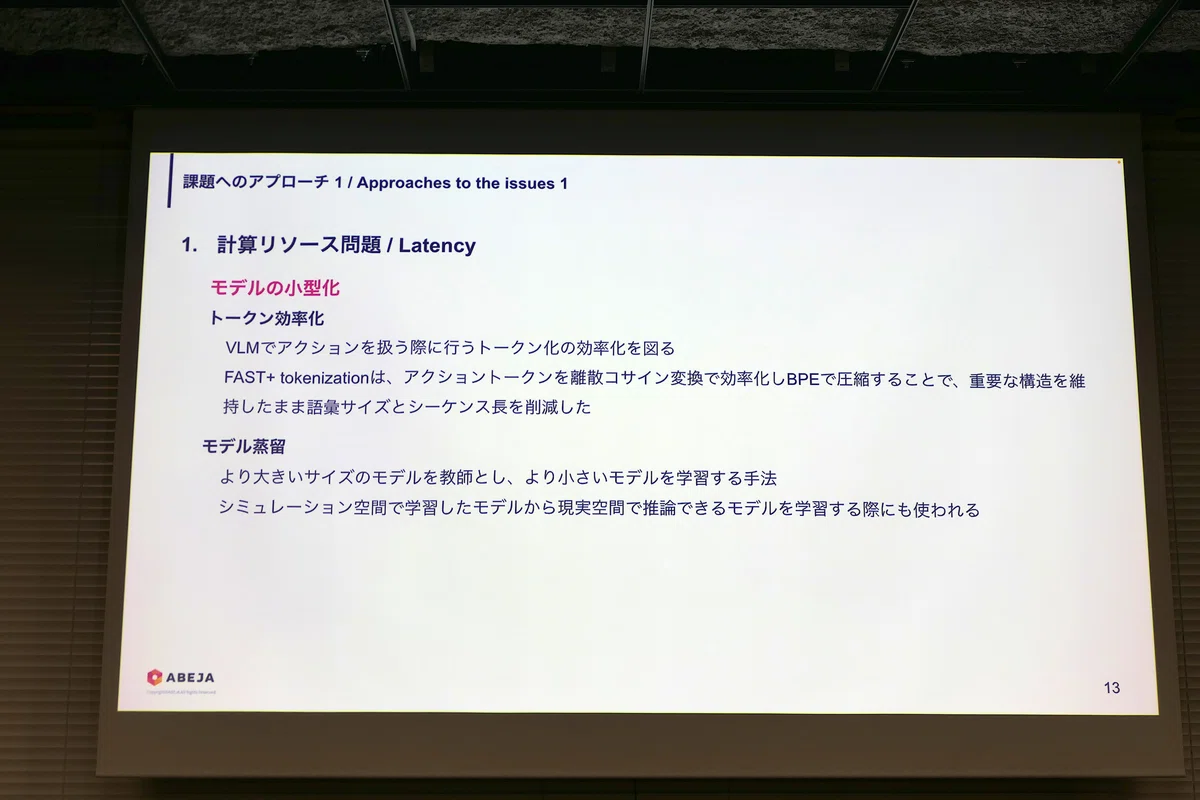
二つ目はモデルの小型化です。トークン効率化(周波数変換+BPE圧縮)により、重要構造を保持しつつロボットコードに適した表現にするのです。
モデルの「蒸留」も小型化手法の一つです。大規模モデルを教師として、小規模モデルを学習させるというテクニックですが、これは、いわば「神の視点」のような情報を用いることができるシミュレーションから、その視点を使えない現実への移行といった橋渡しにも有効です。NVIDIAの「Doorman」という研究は模倣学習なしのSim-to-Realでのドア開けを実現しました。
課題2:頑健性(環境変化・未知物体)
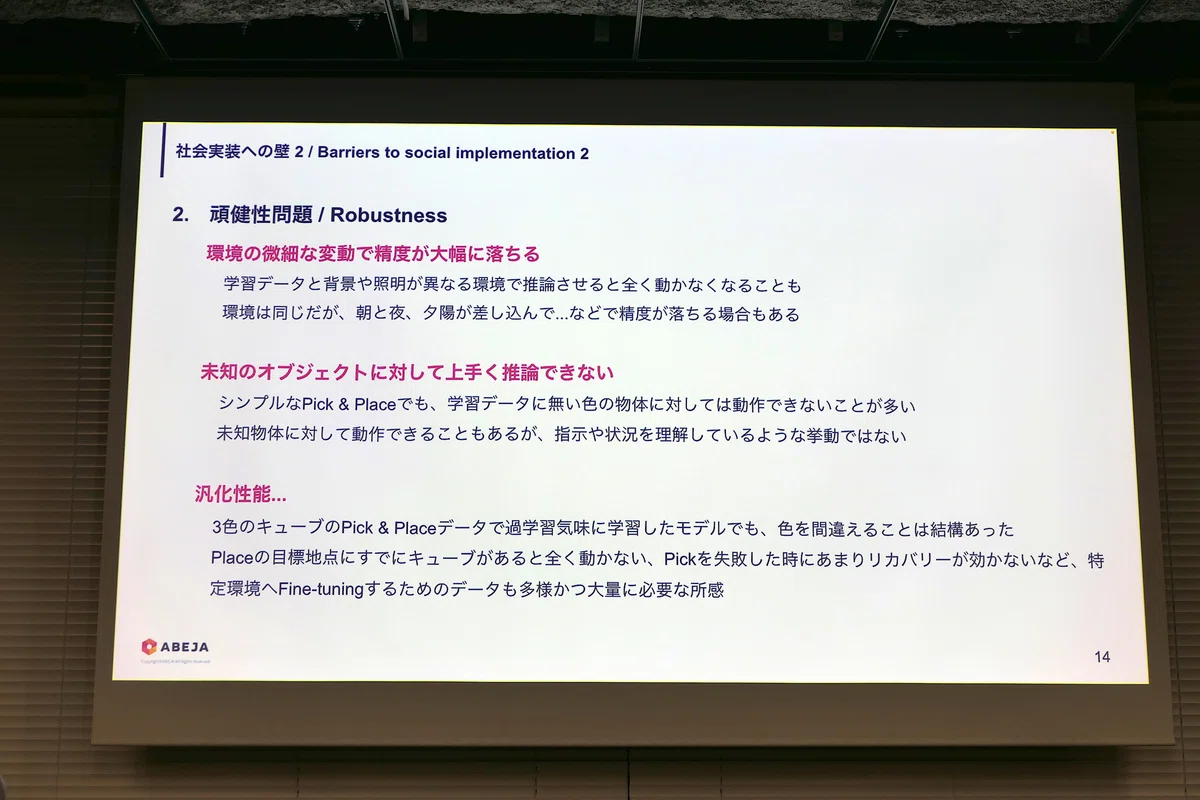
VLAは背景や照明変化で精度が著しく低下します。未知の色や物体に対しては推論が不安定になりますし、指示の理解が不安定になります。物体のピックに失敗したときのリカバリ動作などもデータに含めておく必要があります。
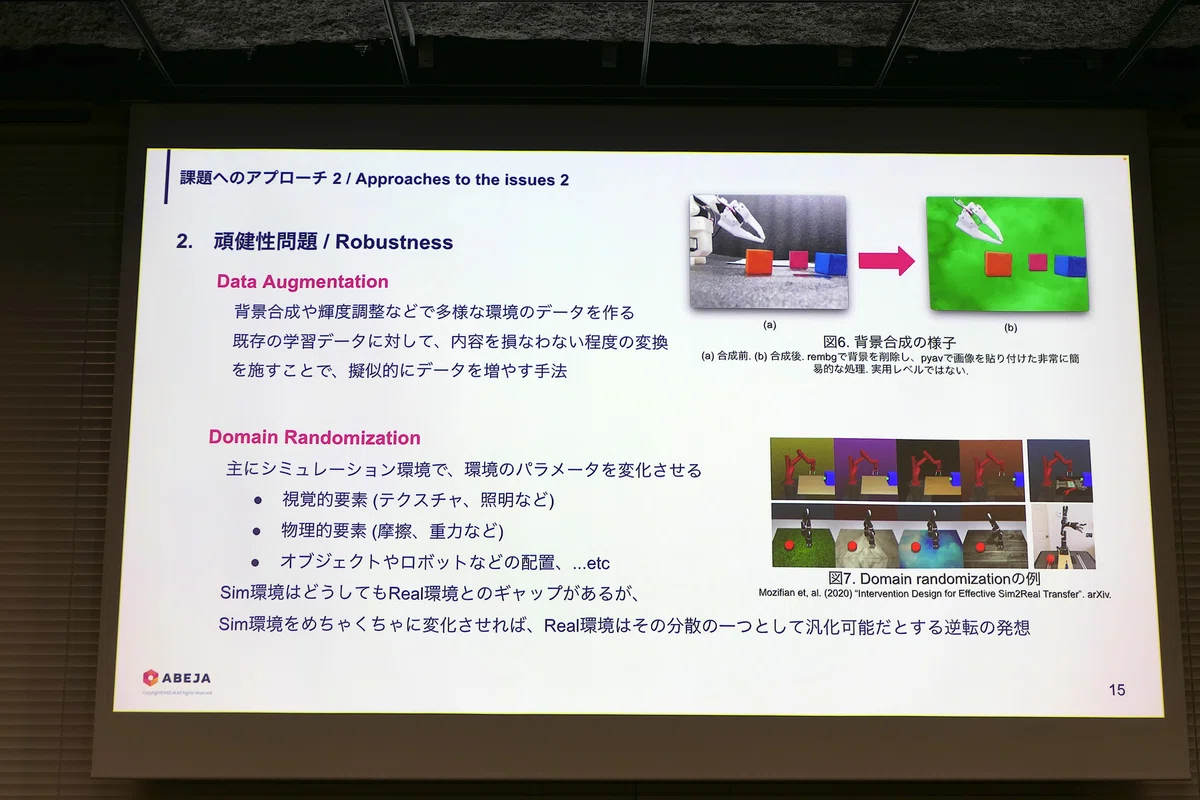
解決策としては、まずはデータの拡張です。背景合成や輝度調整を行なって多様なデータを生成することが必要です。簡易背景合成の試験はグリーンバック活用で改善見込みだということです。
シミュレータでパラメータを変動させるドメインランダマイゼーションも有効だと考えられます。ドメインランダマイゼーションによって、リアル環境を分散の一部に取り込むことができれば、リアル環境の複雑さにも対応可能になる可能性があります。
強化学習も解決法の一つです。強化学習については、ロボティクス分野ではPPO(Proximal Policy Optimization)に代表されるActor-Critic系の手法が広く用いられていますが、NVIDIAのIsaac Lab/Isaac Simにも実装されているため、実験の立ち上げ自体は比較的容易です。一方で、近年の大規模言語モデルに対する強化学習では、従来のPPOとは異なる設計思想を持つGRPO(Group Relative Policy Optimization)のような手法が用いられており、報酬の扱いや最適化の枠組みが進化している点も押さえておく必要があります。
しかしながら、これらのPPO系手法を拡散モデルにそのまま適用することは容易ではありません。PPOは方策が出力する行動の確率分布を明示的に扱い、その尤度に基づいて更新を行うアルゴリズムですが、拡散モデルはノイズ除去過程を通じてサンプルを生成するため、個々の行動に対する確率を解析的に計算することが困難です。この構造的な違いが、従来の強化学習アルゴリズムの直接適用を困難にしています。そのため、拡散モデルに適合した強化学習手法として、Trajectory PPO(TPPO)やFlow Policy Optimization(FPO)といった新しいアプローチが提案されており、これらの有効性については今後の検証が期待されています。
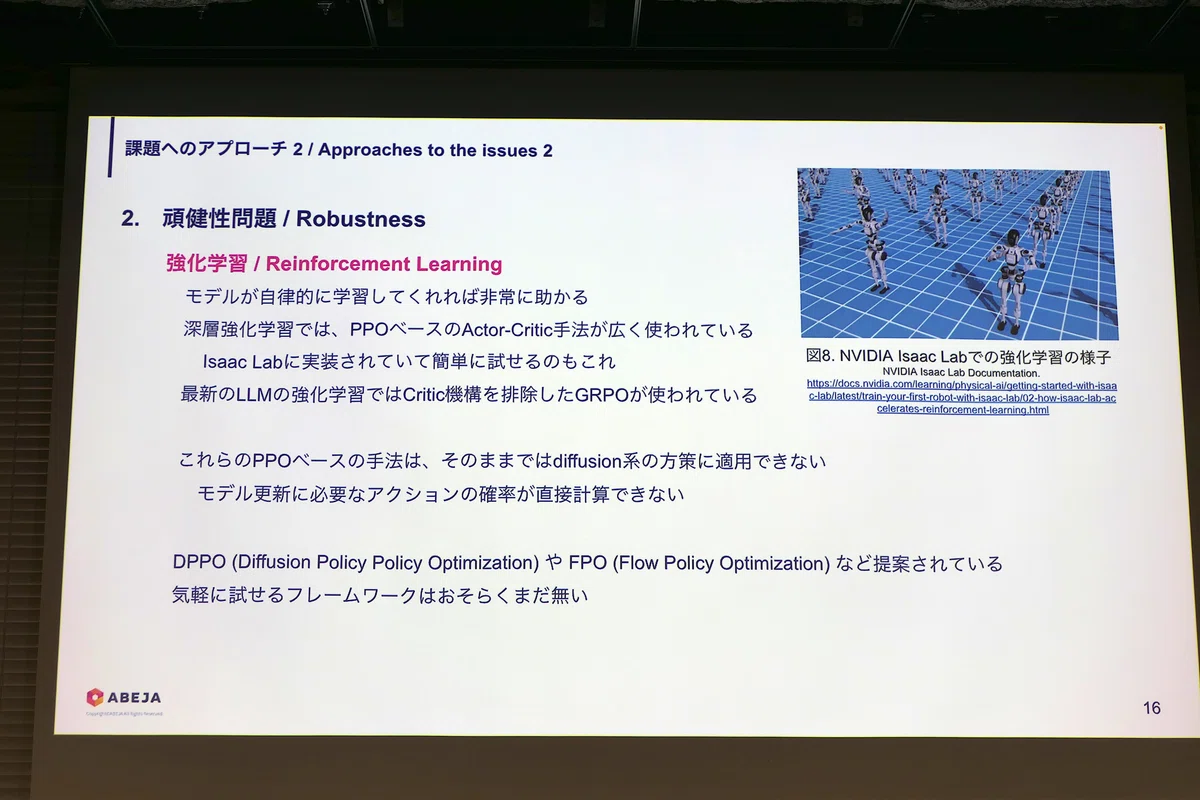
ABEJAでの実験的な取り組みも進めています。まずMLPベースの方策をPPOによって学習させ、その結果得られたポリシーをカメラを含む環境へ移行し、推論時の行動データを生成します。そして、そのデータを用いてVLAモデルの学習へと展開する、というパイプラインが試みられています。
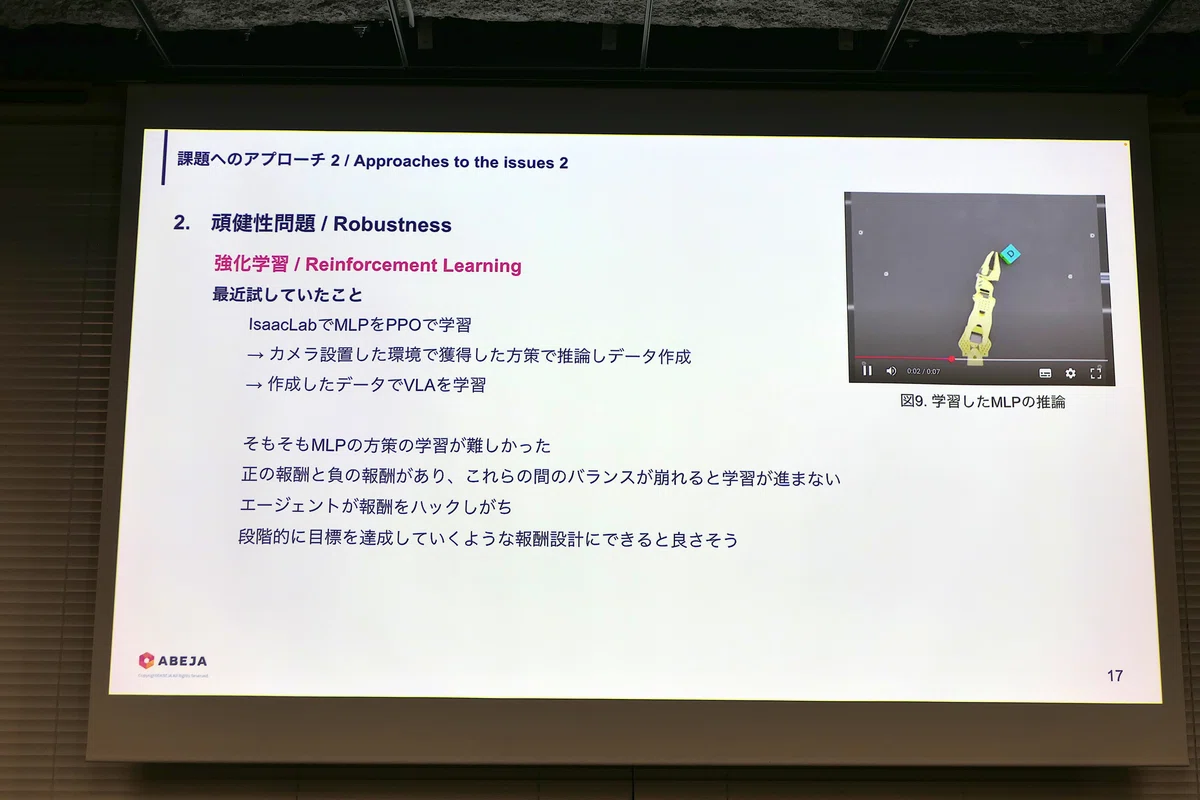
しかし現時点では、MLPによるキューブピックのような基本的な操作タスクですら十分に学習させることができず、結果として有用な行動データが得られていないため、VLA学習の段階には到達していません。
このボトルネックの主因は報酬設計にあると考えられます。強化学習では、正と負の報酬のバランスや、エージェントが意図しない形で報酬を最大化してしまう「報酬ハッキング」をいかに防ぐかが極めて重要です。
そのため、単一の最終目標に対して直接報酬を与えるのではなく、タスクの難易度を段階的に引き上げながら報酬を設計していく、いわゆるカリキュラム学習の導入が有効と考えられます。具体的には、まず対象物への接近や接触といった比較的容易な行動から学習を開始し、徐々に把持や持ち上げといったより高度な操作へと移行させ、最終的に「キューブを持ち上げる」という高難度タスクの達成に至るような報酬構造を設計することが有望です。
課題3:データ問題(模倣学習・状態空間・品質)
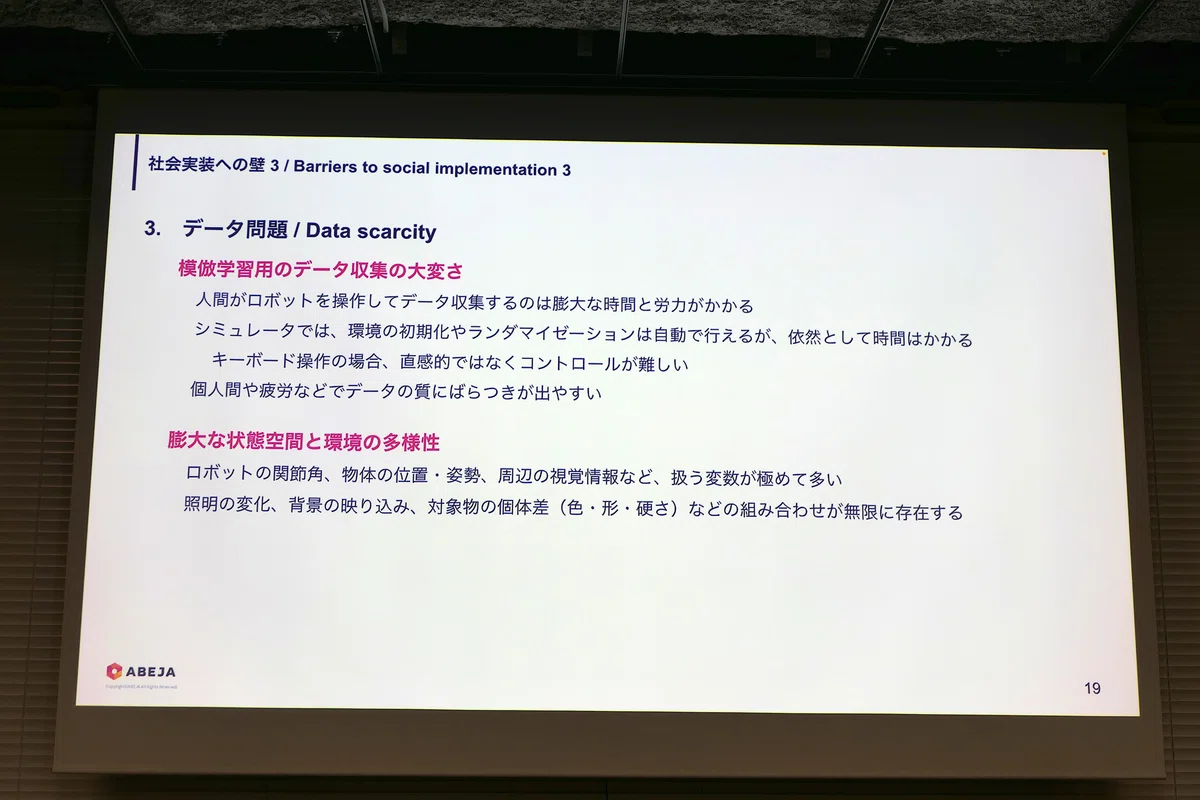
人間の遠隔操作によるデータ収集は時間・労力がかかって大変です。オペレーターは筋肉痛になるそうです。シミュレーションでも初期化・ランダム化は自動化可能ですが、時間は必要です。なかにはキーボード操作が必要な場合もあり、直感的ではありません。
また、操作には個人差もありますし、人が操作する以上、疲労によってデータ品質にばらつきが出ることもあります。またロボット関節角などは多次元ですし、状態空間は膨大です。多様かつ大規模なデータ生成は困難です。
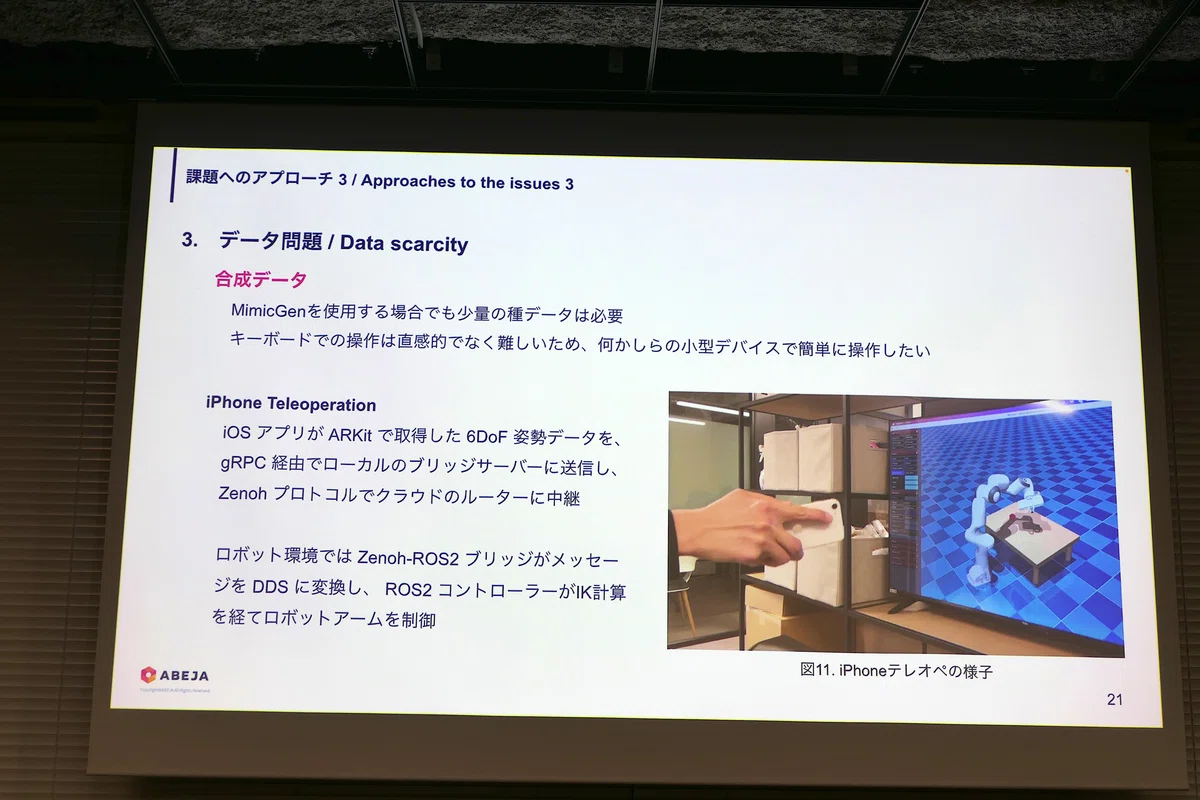
そこで期待されているのが合成データの活用です。NVIDIAのMimicGen NIMは、少量の人間テレオペデータを種として人間操作風のデータを大量生成でき、ロボットの模倣学習を支援できるとされています。
生成システム自体をスケール可能にする「Nimbus」という研究もIntern Roboticsから2026年1月に発表されましたが、コードは公開されていません。
このほか、iPhoneを使った簡易な遠隔操作も紹介されました。
岩城さんは最後に社会実装の壁として「背景が変わると動かなくなる頑健性問題が最大の障壁であり、現状での実用化は難しい」と語りました。
フードスポンサーはWeights & Biases
このあと、懇親会と、ライトニングトークが行われました。フードスポンサーは、AI開発者向けMLOpsプラットフォームを提供するWeights & Biases(ウェイツ・アンド・バイアスィズ)。同社の鎌田啓輔氏がショートプレゼンを行いました。
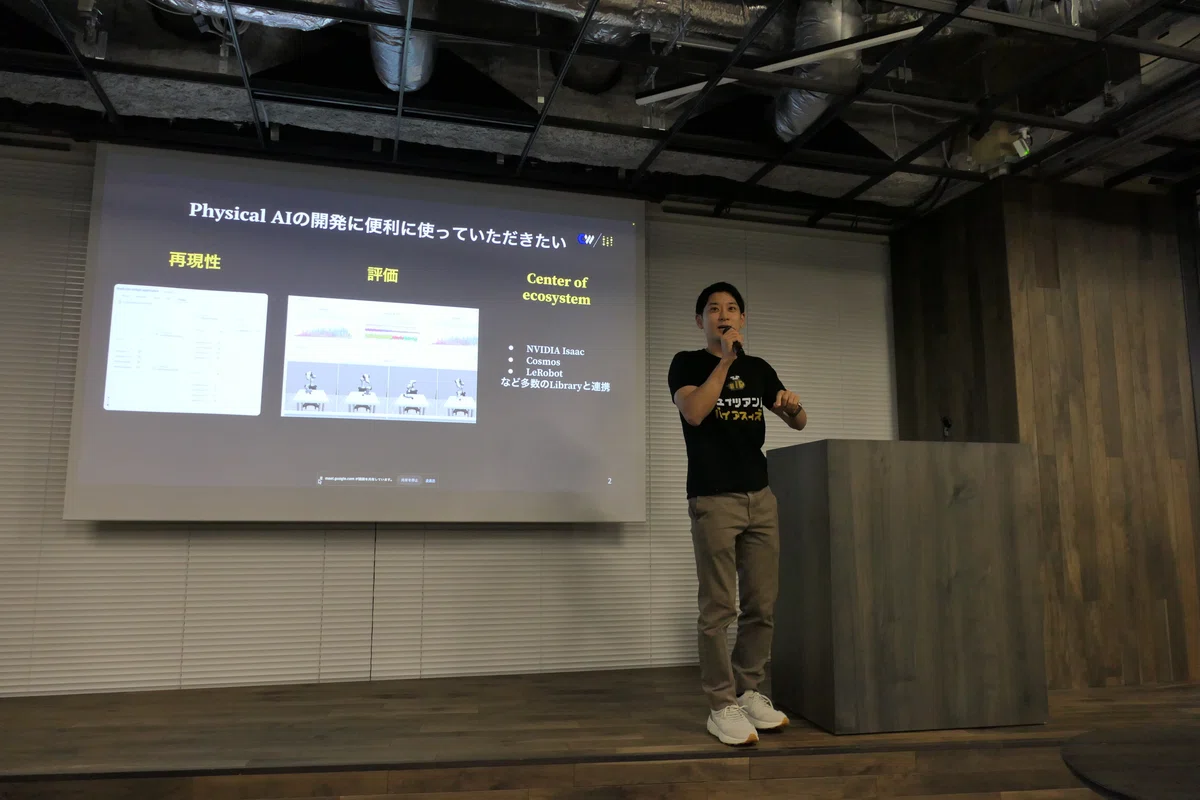
同社のMLOpsプラットフォームは、学習中のハイパーパラメータや精度などのメトリクスを自動で記録しグラフとして可視化するダッシュボード、モデルの重みデータやデータセットのバージョンを管理し再現性を確保するアーティファクト管理、ハイパーパラメータ最適化、LLM開発支援などの機能を持っています。
海外では多くのロボット企業が同社のMLOpsプラットフォームを使っているものの、国内ではあまり使われてないそうで、ぜひ使ってほしいとのことでした。
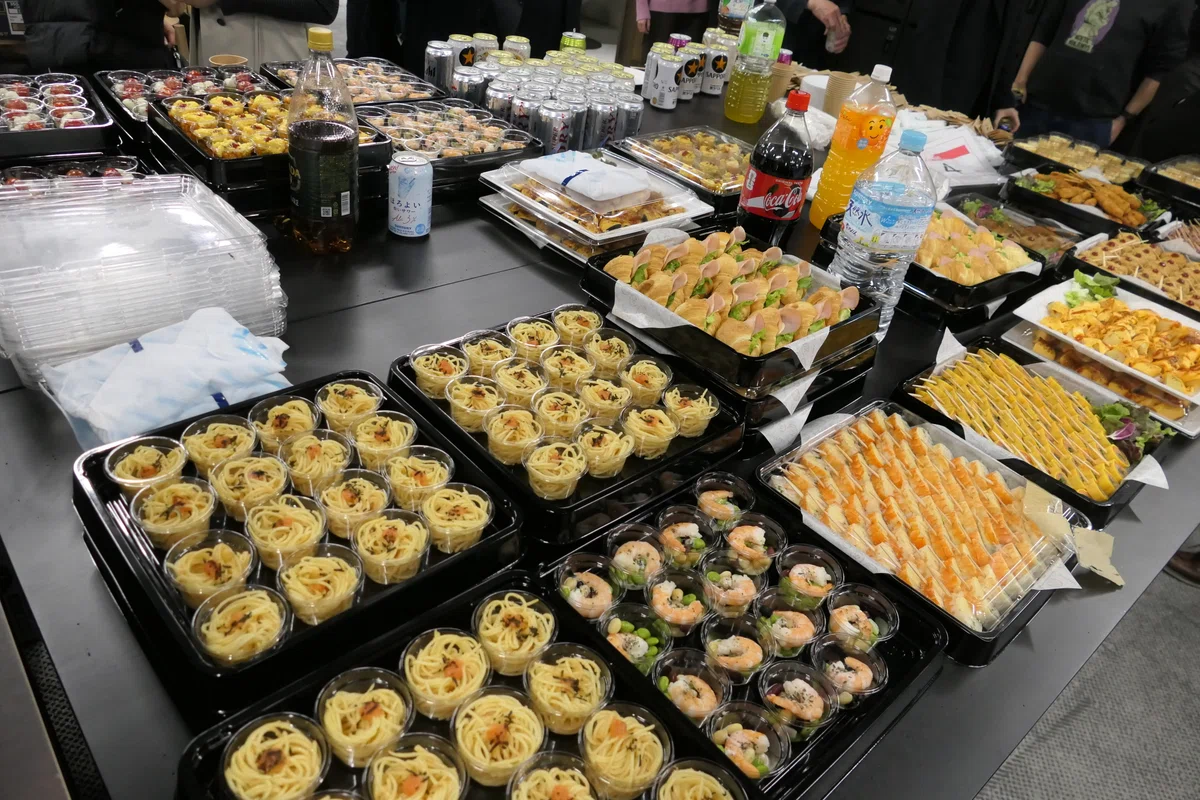
色々な食べ物が並んでいたのですが、ロボットのデモが同時並行で行われたこともあり、特に最初は多くの人が食べ物や飲み物を手に取らず、ロボットの周囲にたかっていました。
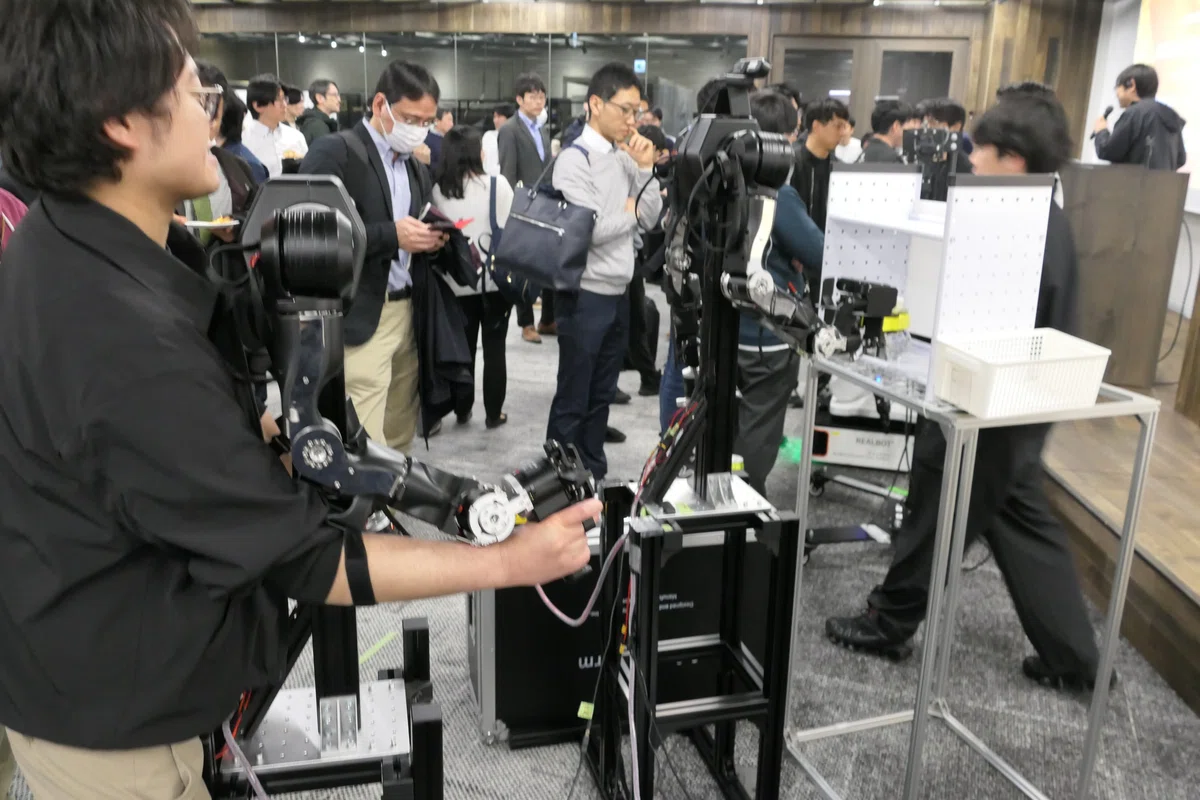
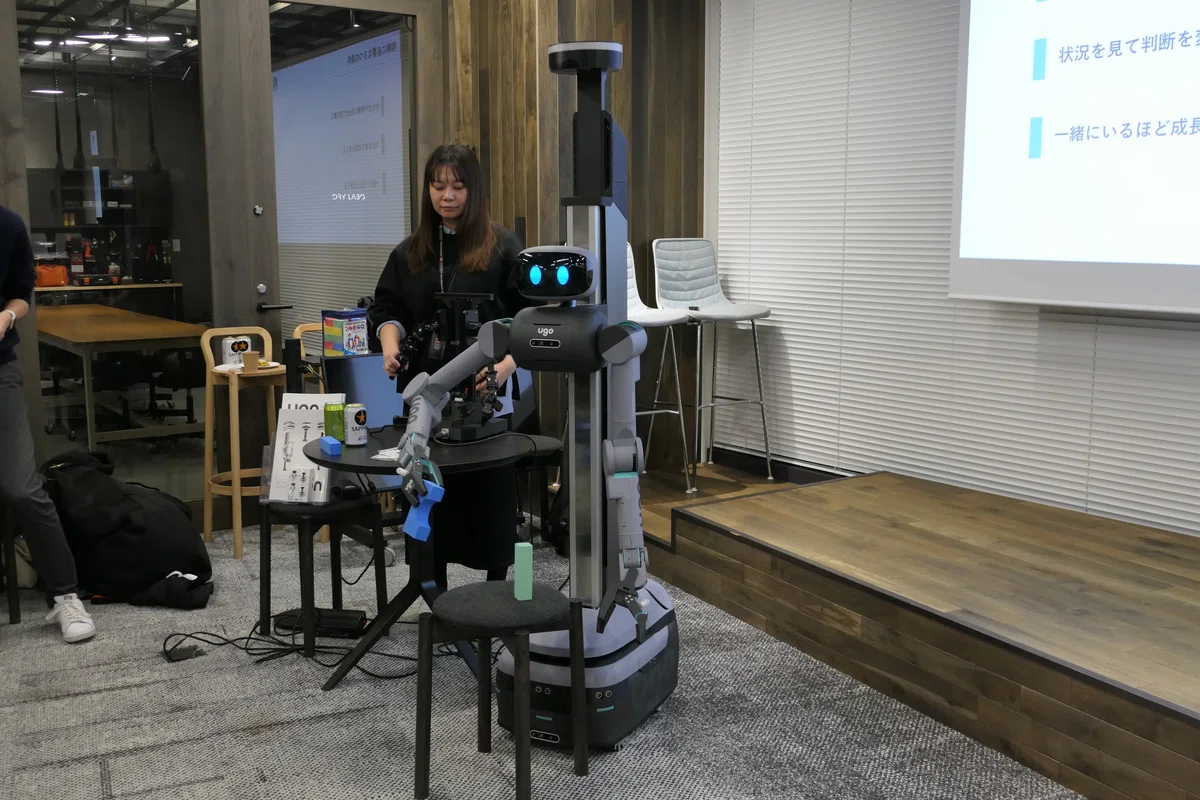
ライトニングトークには4社が登壇
歓談の最中に行われたライトニングトークには、ツバメインダストリ、AWS Japan、Omakase Robotics(オマカセロボティクス)、Forcesteed Robotics(フォースティードロボティクス)の4社が登壇し、それぞれの事業を紹介しました。
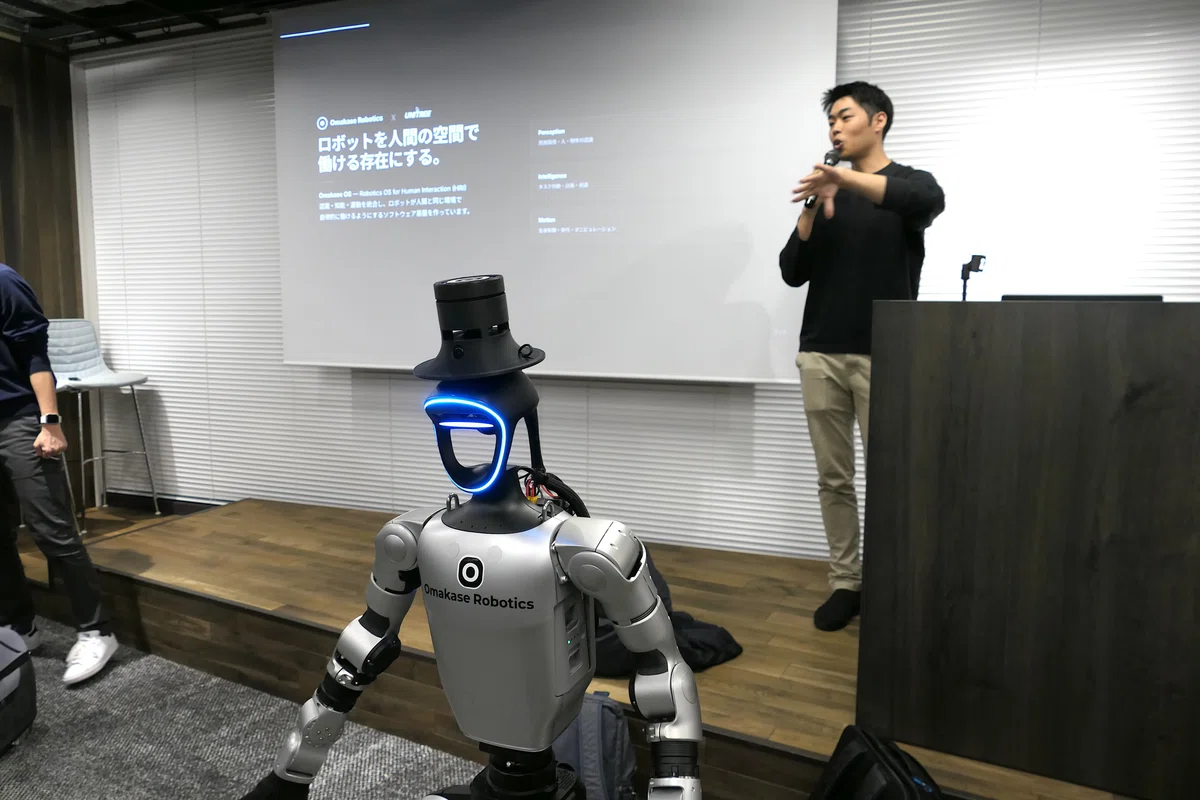
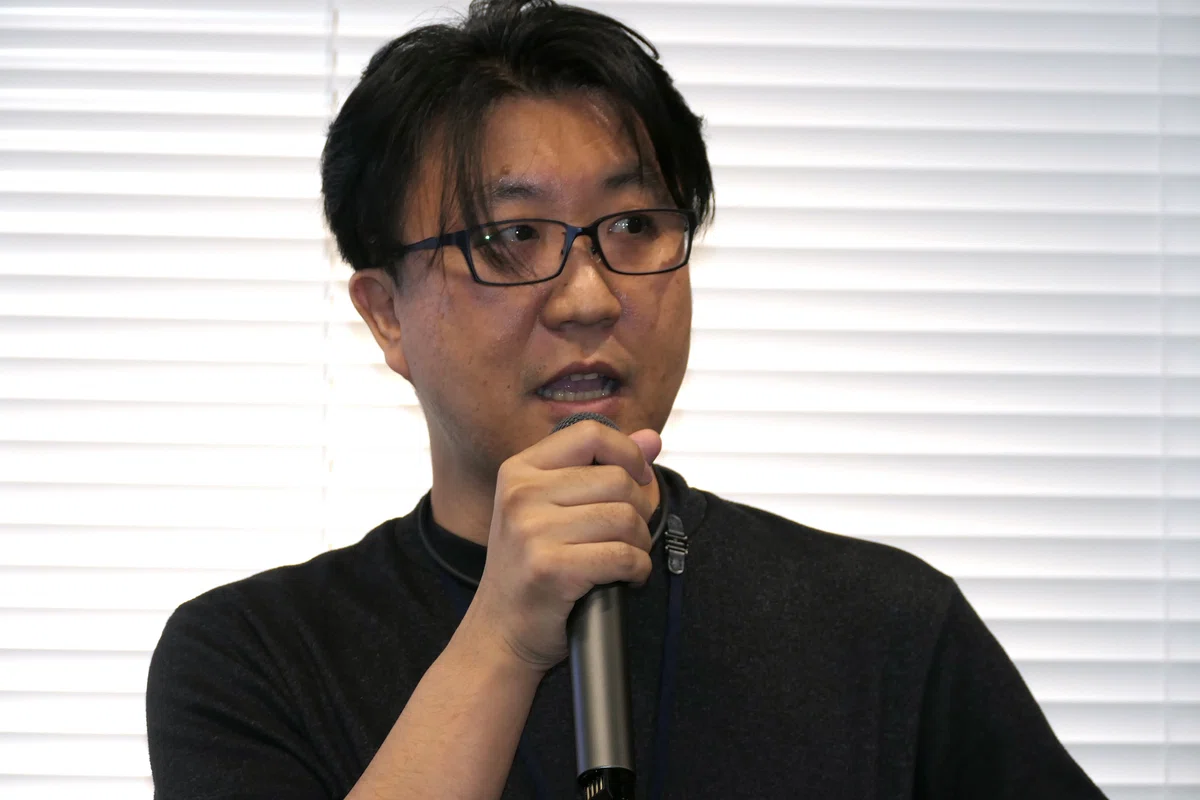
この記事もだいぶ長くなってしまったので詳細は省略しますが、それぞれみんなフィジカルAIへ取り組んでいます。本当はもう一社あったそうなのですが、マイクトラブルもあって、時間切れとなってお開きでした。
次回の「AIロボット持ち込み勉強会」は、名古屋にて、5月上旬〜中旬に行われる予定だそうです。そのほか、カンファレンスや学会シンポジウム、ハッカソンなど様々なイベントも行って盛り上げていきたいとのことでした。
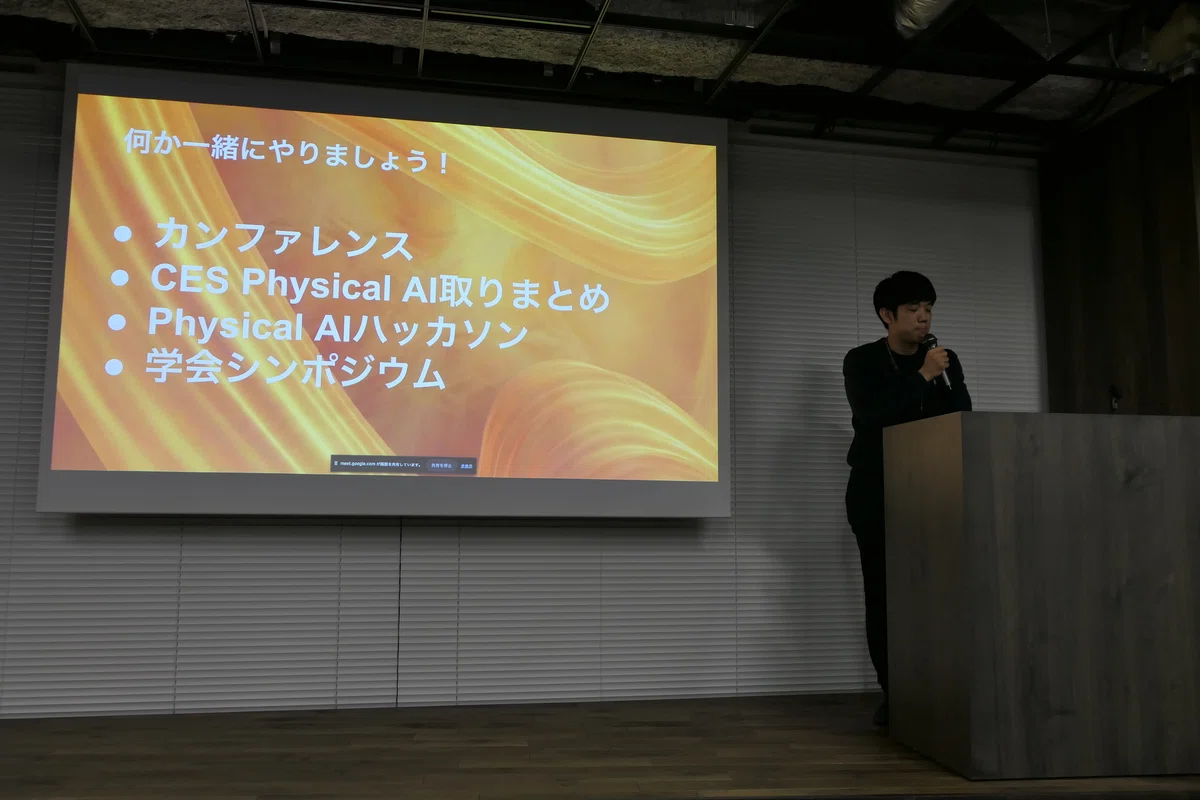
追記:2026年4月から AI Robot JapanのPodcastが始まってます
いいなと思ったら応援しよう!
 よろしければ応援お願いします! いただいたチップは活動費に使わせていただきます!
