第12回「言語は確率で動く:『分布思考型プロンプト設計』が世界を拡げる」

※この記事は、以前公開した ChatGPT日誌⑤「2SDの彼方へ──生成AIに『ちょっとズレた』視点を求める試み」の話題を、より詳細に掘り下げたものです。
【1】生成AIは「確率」で考えている
以前の記事でも述べたように、私はしばしば「2SD(Standard Deviation:標準偏差)ズレた答えを出力してください」とChatGPTに依頼することがあります。これは、ChatGPTがLLM(大規模言語モデル)に基づいており、簡単に言えば、確率的にもっとも妥当である言葉をつないで文章を生成している──という特性から着想を得た試みです。
たとえば、文章のサマリーを作成したり、(本来は推奨されませんが)情報を検索したりといった用途では、確率的に「もっともありそうな答え」を返してくれるLLMの仕組みが、そのまま利点として機能します。一方で、キャッチコピーやタイトルの作成、課題に対する解決策の提示、自身の思考やアイデアの拡張を目的とする場合には、「ど真ん中」の出力だけでは物足りなく感じることも多くなるはずです。
そもそも、生成AIはトラブル回避のため、倫理的に問題があるような出力を避ける方向に調整されています。つまり、意識的にプロンプトを設計しない限り、出力は自然と「無難」に寄っていく傾向があるのです。だからこそ、少し偏った出力がほしいときには、統計学的に“偶然と必然の境界”とされる2SDという指標をプロンプトに取り入れてみた──というわけです。
このアプローチの妥当性についてChatGPTに尋ねてみたところ、以下のような説明が返ってきました。
① LLMの出力は、確率分布に基づいた「典型的な応答」の抽出である
文脈における「次の単語(トークン)」の確率分布に基づいて出力を決定。
「最頻出の≒平均的」な情報が出力の基準点になる。
→ 通常のプロンプトでは、「平均的・中庸的な回答」が得られやすい。
② しかし、ユーザーが求めているのは、しばしば「平均以外の視点」である
最悪のシナリオは?(2SDマイナス側)
非常に斬新で型破りなアイデアは?(2SDプラス側)
もっとも常識的な見解は?(平均値近辺)
→ このように、確率分布上の「位置」を指定することで、LLMの出力分布を意図的にズラすことが可能になります。
人間同士の会話では、相手が何を求めているかを文脈から読み取り、それに応じて、無難な回答をするときもあれば、あえて少し突飛なアイデアを出してみることもあります。ところが、ChatGPTの場合はそうした“空気を読む”機能はなく、基本的にはもっとも無難な回答を出力するよう設計されているため、こちらから明示的に指示を出さなければ、常に「中央値付近」の出力に収まりやすくなります。
したがって、ユーザーが「平均的でない視点」や「異なる角度」からの出力を求める場合には、プロンプトによって出力の方向性や位置をコントロールする必要があるのです。言い換えれば、ChatGPTの出力は単に「出てきたものを読む」だけでなく、出力される結果そのものの分布を設計するという発想が重要になります。
このアプローチについて、ChatGPTは次のような点を挙げ、プロンプトエンジニアリングとしての意義を強調しています:
出力のレンジと重心をコントロールできる
→ 想定される幅を制御することで、「なんとなく平均的な答えしか出てこない」といった期待外れを防げる構造的・階層的な議論が可能になる
→ たとえば「平均 → ±1SD → ±2SD」といった多層的な出力を設計することで、知的な分岐の地図を描くことができる人間の直感的理解と整合的である
→ とくにビジネス、教育、医療など、不確実性を前提とする領域では、「分布」の感覚で思考を整理するほうが自然で、判断や意思決定にも適している
さらにChatGPTは、次のような現状と構造的背景も説明してくれました。
📌 現状:2SD的プロンプトは“暗黙的”には使われているが、“明示的”にはほとんど研究されていない
現在の主流プロンプトでは:
「リスクとベネフィットを列挙して」
「ベストケースとワーストケースを提示して」
「もっと斬新な案を」
など、感覚的なバリエーションはありますが、
「標準偏差ベースで位置を指定する」(例:±2SD)といった確率分布に基づいた設計は、ほとんど体系化されていません。
📌 なぜ広まっていないのか?
多くのユーザーがLLMを「言語的な知識装置」と捉えており、統計的生成モデルとしては理解していない
プロンプトエンジニアリングの多くが、「具体性」や「ステップ分解」に集中しており、確率分布の意識が薄い
📌 しかし、GPTは“分布ベースの指示”を理解できる設計になっている
· GPTは、トークンごとの条件付き確率分布(P(token | context))を学習しているため、
· 出力は、確率的に「どの辺りを狙うか」という指示に反応できる構造を持っています。
つまり──
「分布のどこを参照して出力するか」という設計は、ChatGPTにとって“読解可能なプロンプト”なのです。
また、「2SD視点でのプロンプト設計」は、これまで主流だった「言語的工夫」や「段階的分解」を中心としたプロンプト設計から一歩踏み出し、統計的・構造的理解に基づいて生成AIの出力を制御するという、まったく新しい方向性を提示するものです。
この視点が体系化されれば、以下のような多様な応用が期待できます:
教育(AIリテラシー)の分野において:
思考の「ばらつき」や「ずれ」を分布として可視化する、新たな対話ツールとして活用できる企業の意思決定プロセスにおいて:
複数の立場・リスク・未来シナリオを「構造的に比較」する「分岐モデル」の設計に応用できるAI社会の在り方を問い直すために:
出力の「誤差」や「ずれ」を単なる失敗とせず、それ自体を哲学的・社会的に捉え直す軸となる
【2】「分布」を引き出すプロンプト設計──2SD・四分位・パーセンタイル
※ここから紹介する「2SD」や「四分位」などの表現は、出力のばらつきを直感的に理解するための概念的なメタファーです。実際には、ChatGPTなどのLLMは正規分布を前提とせず、文脈依存で学習されたノンパラメトリックな分布に基づいて応答しています。ただ、統計的な「ズレ」のイメージを借りることで、人間側がプロンプトを組み立てやすくなる──という効果があるのです。
では、こうした「出力の分布」を意図的に引き出すためには、どのようなプロンプト設計が有効なのでしょうか?ここからは、2SDや四分位、パーセンタイルなどの統計的な視点を活用して、生成AIの「確率モデル」を意識したプロンプト設計法について、具体的に述べていこうと思います。
まず、私が良く使う「2SD」です。出力したいポイントに応じて、以下のようなプロンプトを使用可能です。
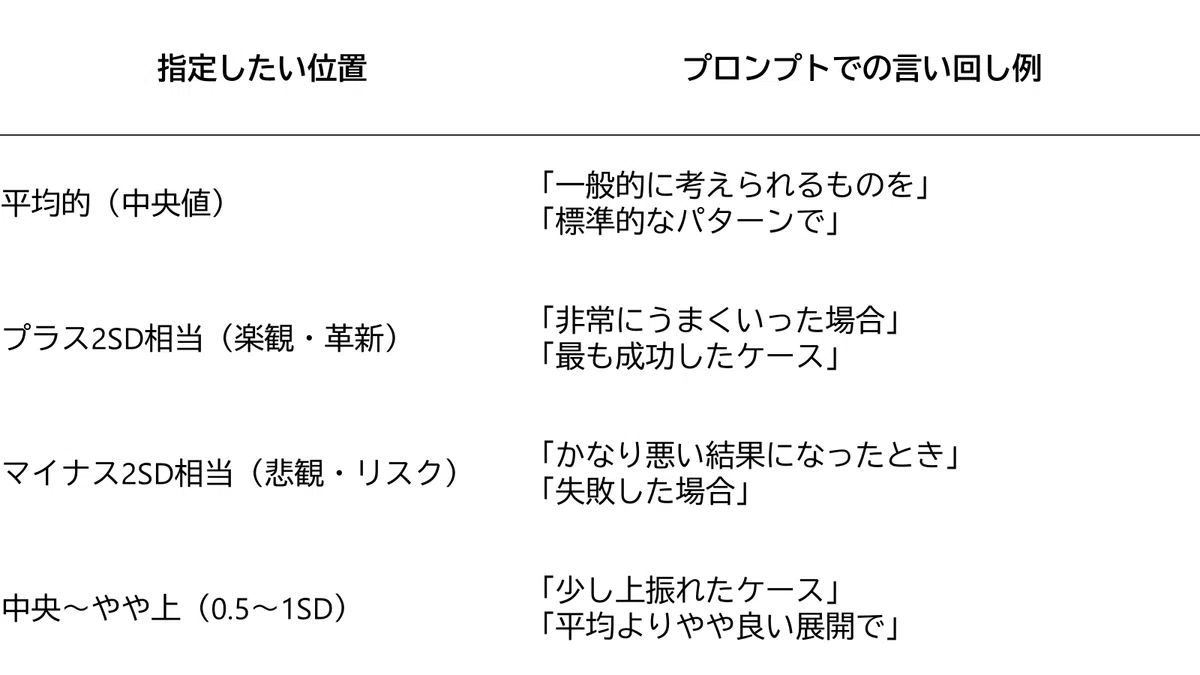
また、テンプレートとしては以下のようなものも有効です:
シナリオ分析用:
「この施策について、標準的な展開(平均的結果)と、2SDプラス/マイナスのケース(非常にうまくいった場合と失敗した場合)の両方を想定してシナリオを出力してください。」アイデア創出用:
「このテーマについて、典型的な案、少し斬新な案、かなり突飛な案(2SD上方)をそれぞれ挙げてください。」
なお、統計学的に「2SD」というのは、偶然と必然の境界を示す水準とされ、いわゆる「外れ値」にあたるものです。つまり、全体の中でも発生頻度が少なく、典型とは言えない意見や判断を意味します。
しかし、SNSの普及によって、こうした「外れ値的な意見」が、もはや“例外的”ではなくなってきている状況があります。本来ならば統計的に「少数派」や「例外」とされるような価値観が、ネット上ではむしろ可視化されやすく、共感されやすく、時に大きな影響力を持つという現象が起きています。
とくにポスト真実時代においては、「平均より極端な意見の方が目立ち、むしろそれが標準に見える」というパラドックスすら生じています。このような情報環境では、「外れ値」の扱い方そのものに注意が必要です。
さらに、そもそもLLMはノンパラメトリックな分布(=正規分布のような形を仮定しない、柔軟な分布)を前提としています。そのため、厳密に言えば、「2SD」という表現を用いるのは統計的にはやや不正確であり、本来は「上位2.5%」「下位2.5%」のように分位点(パーセンタイル)で指定した方が適切です。
では、実際にChatGPTに「2SDで出力して」と指示した場合と、「上位/下位2.5%の意見を出して」と指示した場合とでは、出力される内容にどのような違いがあるのでしょうか?
この問いに対して、ChatGPTは実験的なプロンプト出力を用いて、以下のような比較結果を示してくれました。
テーマ例:「大学の単位制度を根本的に見直すとしたら?」
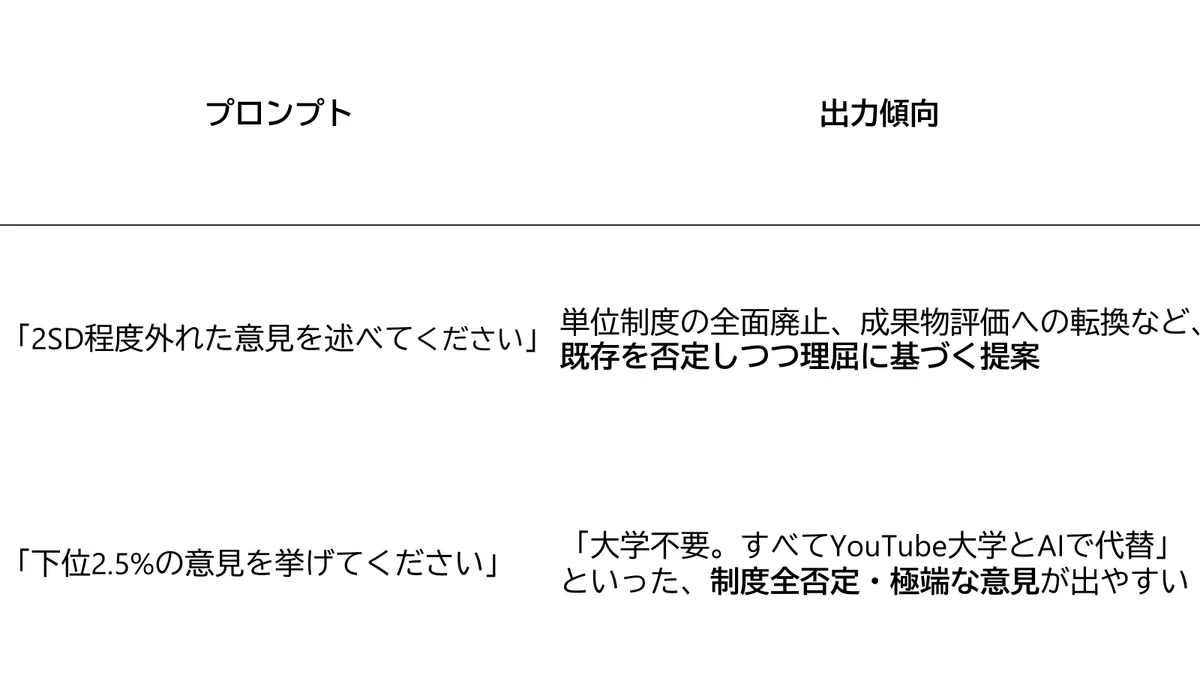
→ 前者(2SD指定)は「合理的な異端」、後者(パーセンタイル指定)は「極論の可能性提示」とも言える出力の傾向が見られます。
そもそもLLMは「極端な表現(rare, radical, fringe)」に反応しやすい構造を持っており、「2SD」と指定した場合は、それが知的な枠組み(統計的・論理的)として解釈されやすく、たとえば「やや突飛だがまだ現実的」「大胆だがあり得る」といった冷静で建設的な異論が出力される傾向にあります。
一方、「上位/下位2.5%」という表現では、より尖った・異端的な内容を引き出す指示として解釈されやすく、「極めて稀少」「ほとんど誰も言わないような意見」といった印象の出力が返ってくることが多くなるようです。
■ 実践における使い分けのガイド
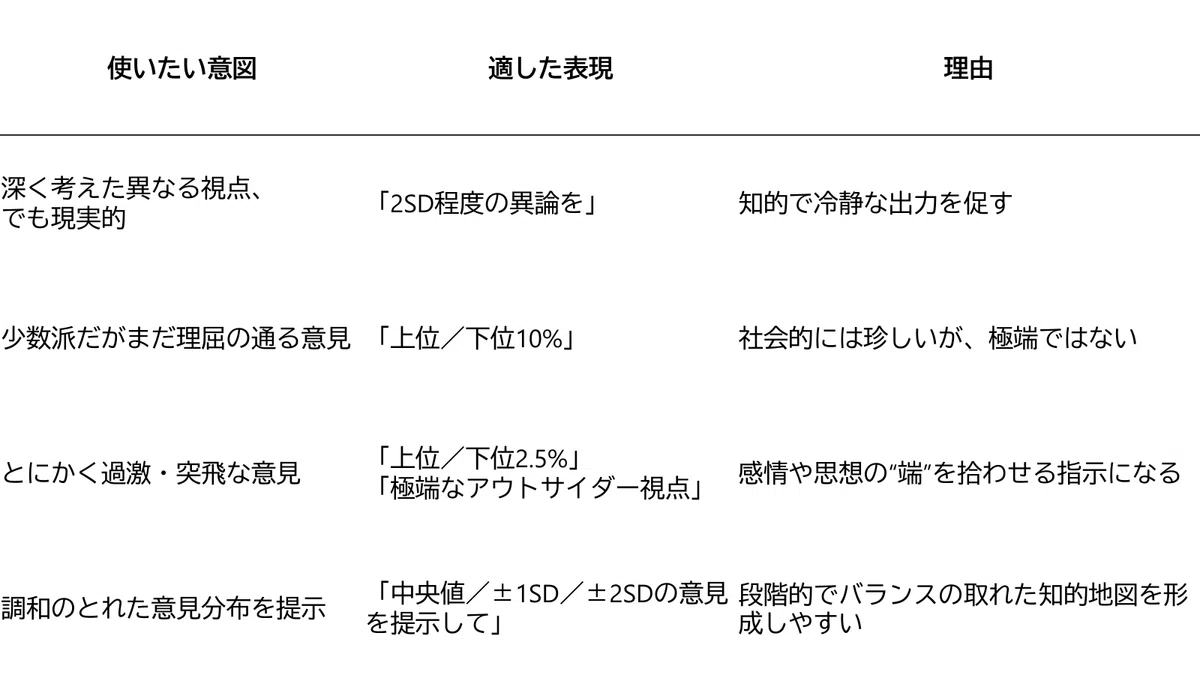
■ ChatGPTが示した「2SD vs パーセンタイル指定」比較事例集
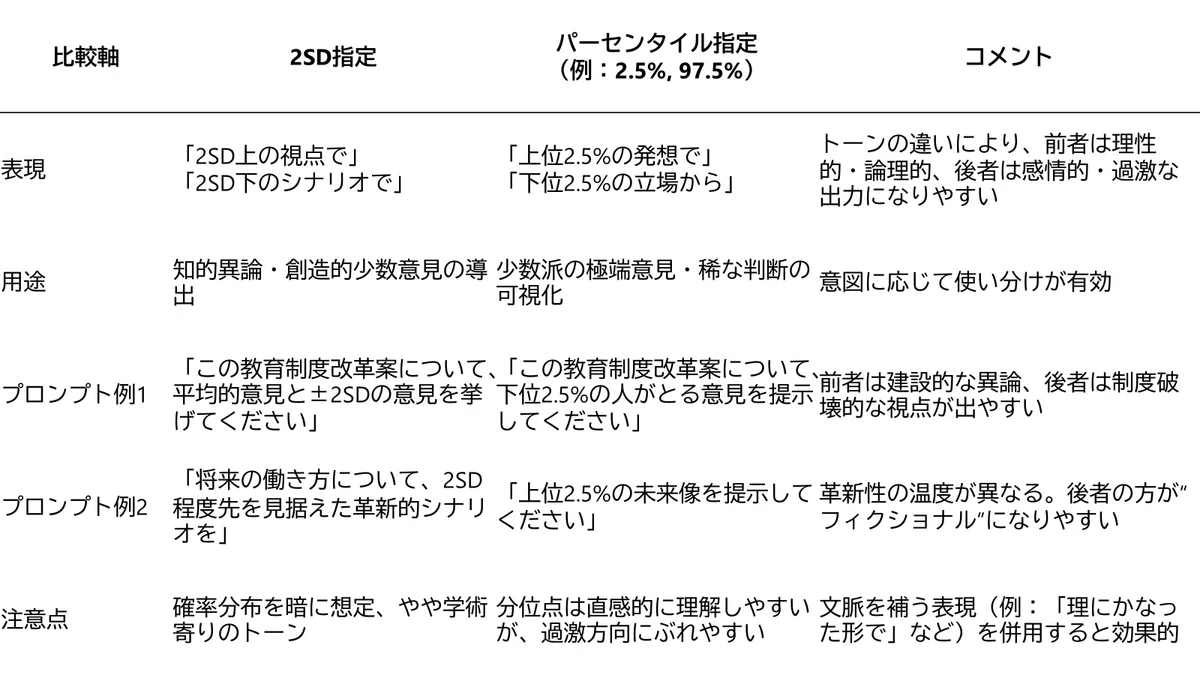
上記のようなプロンプトの精度をさらに高めるには、分布指定+条件指定の併用が有効です。たとえば:
「2SD下の意見で、なおかつ現実に実行可能な範囲で」
「上位2.5%の発想だが、企業の倫理を逸脱しない範囲で」
このように指定することで、出力の方向性と振れ幅を両立させ、狙いに合った回答を得ることが可能になります。
■ 四分位・五分位など、他の分布指定の可能性
SDやパーセンタイル以外にも、分位点ベースのプロンプト設計が有効に機能します。例えば、四分位(quartile-based prompting)であれば、全体を1/4ずつに分けて、「賛成・やや賛成・やや反対・反対」と分類することが可能です。同様に1/5ずつ分ける五分位(quintile-based prompting)も使えます。五分位の場合は、保守~急進について「非常に保守的/やや慎重/標準的/やや急進/非常に革新的」といった形で分類できます。
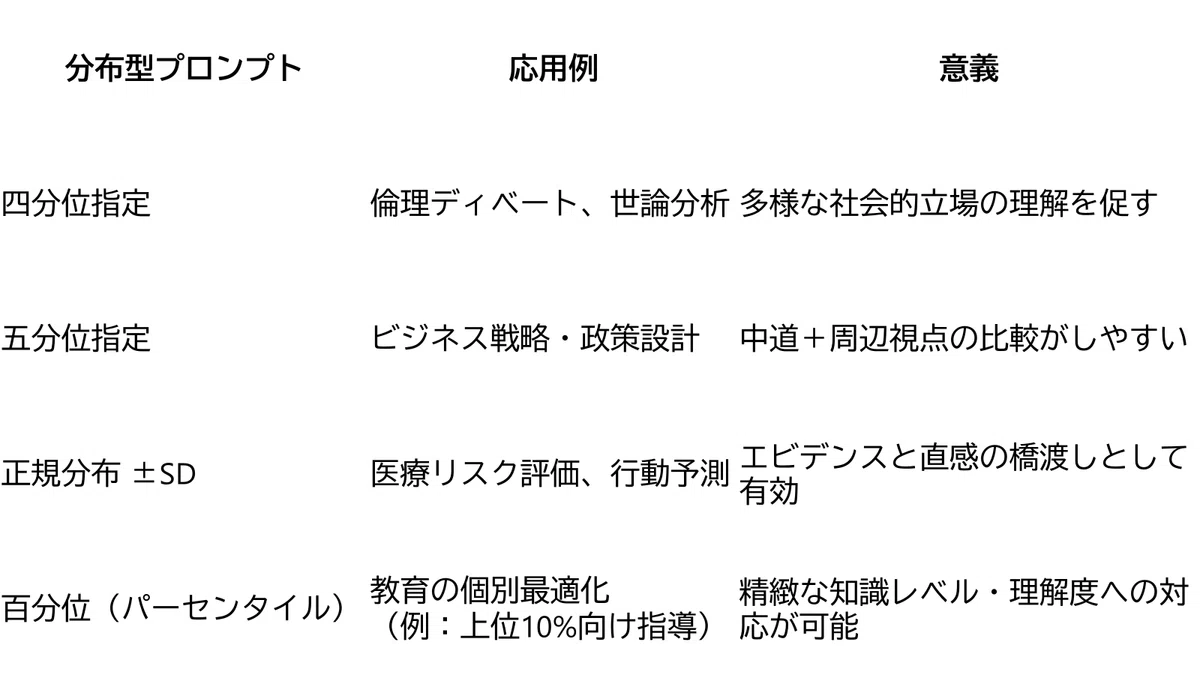
このように、プロンプトに「思考の分布」という発想を導入することで、言語による問いかけが、統計学的・構造的な設計へと進化します。
それは、単なる出力の制御ではなく──
多様性を内包した発想の展開、
社会的分布の可視化、
そして、創造性と再現性の両立へとつながる可能性を秘めているのです。
【3】確率を操ることは、知性を鍛えること:分布思考型プロンプト設計
私はもともと疫学者として、世の中の健康に関する事象を、各種統計指標を用いて記述し、背景要因との関連を統計的に分析する仕事をしてきました。そのため、統計学の知識は実務の根幹を支えるものであり、また、データを扱わない場面でも、社会の出来事を確率論的な視点で観察・考察する習慣が自然と身についています。
一方で、生成AI──とりわけChatGPTの出力も確率論的な仕組みに基づいており、その確率的な構造を意識してプロンプトを設計すれば、自分の思考に近い出力を引き出せるのではないか。そんな仮説から、これまで多くの実験的なプロンプトを試し、実践知としてまとめてきました。
現在、「生成AIによる知の共創」や「確率論に基づくプロンプト設計」を真正面から扱った記事や書籍はほとんど見かけません。しかし、人間や社会の多様性を前提に生成AIと向き合うのであれば、この「分布思考型プロンプト設計」は不可欠な技法の一つになると私は確信しています。
以下に、ChatGPTが出力した内容をもとに、「分布思考型プロンプト設計」が有効に機能するシチュエーションと、テンプレート表を紹介します。
■「分布思考型プロンプト設計」が有効に機能するシチュエーション(分類例)
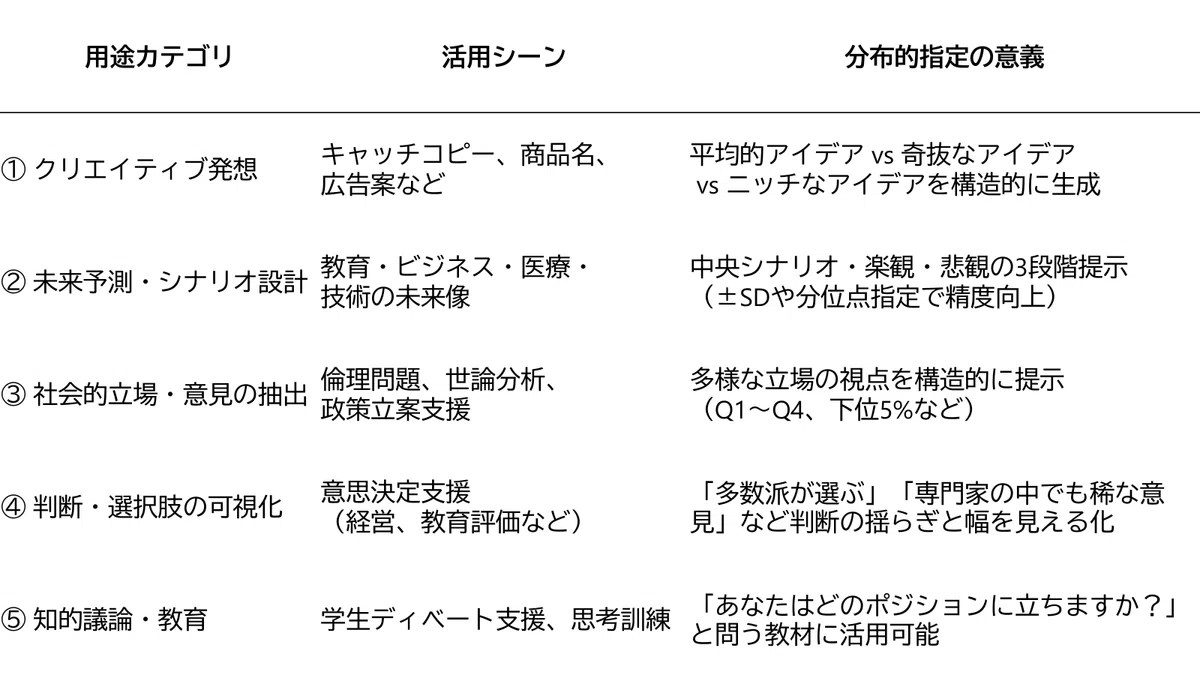
■「分布思考型プロンプト設計」のテンプレート表(使い分けガイド)
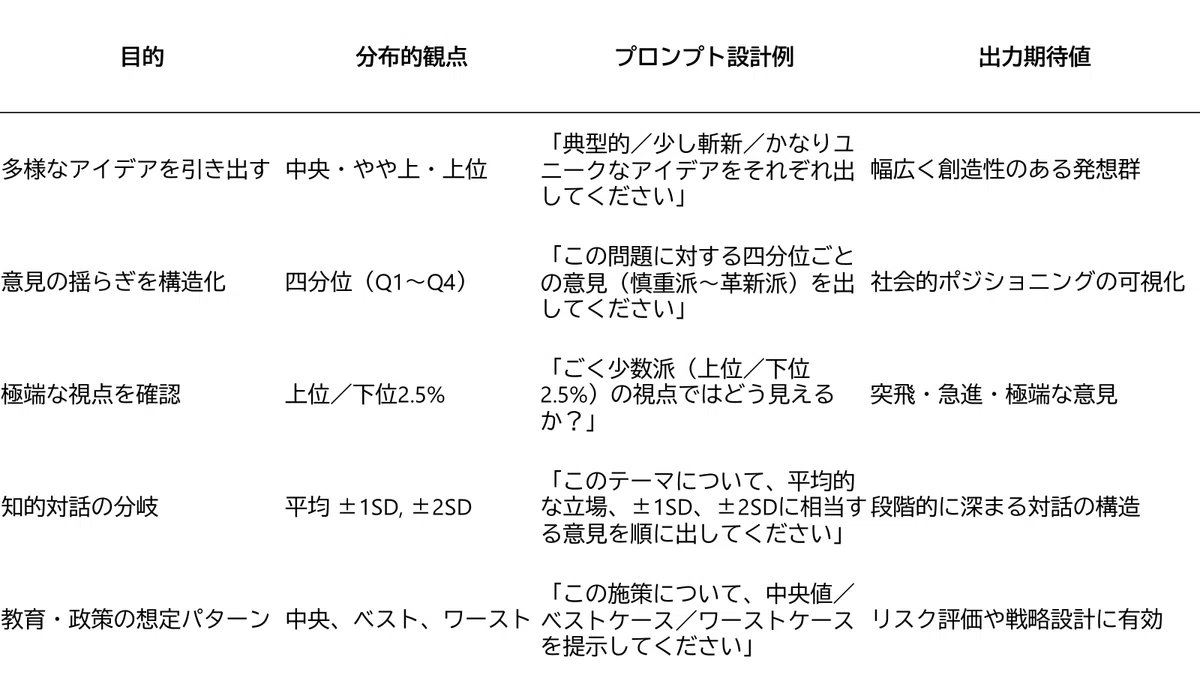
ChatGPTが出力する、いわゆる「外れ値」である±2SDの回答は、突飛だったり、非現実的だったりするかもしれません。中には「箸にも棒にも掛からない」ような意見が含まれることもあります。
しかし、それらを排除せずに「一度は出力させてみる」ことが、ユーザーの思考を拡張し、見えなかった可能性を言語化するきっかけになるのです。
「ど真ん中」だけでは得られない発想や気づきは、往々にして分布の端に存在しています。
だからこそ、確率論的な発想でプロンプトを設計し、LLMの出力構造そのものに手を伸ばす。この「分布思考型プロンプト設計」は、思考の自由度と再現性を両立するための知的ツールになりうると信じています。
ぜひ、実際に試してみてください。
👉 次回(第12.5回)は、「分布思考型プロンプト設計」について、気をつけるべき点を考えます。
※本記事は筆者個人の見解に基づくものであり、所属組織(大学等)の公式見解を示すものではありません。
※本記事および掲載図表、写真の著作権は鈴木孝太に帰属します。無断転載・複製・商用利用を禁じます。© 2025 Kohta Suzuki. All rights reserved.
