AIは「覚えたこと」を答えているだけだと思っていた
今日、ひとつ分かった。
最近、半導体ETFを観測していると、同じような言葉を何度も目にします。
NVIDIA。
GPU。
AIデータセンター。
電力。
冷却。
AIが広がればGPUが必要になる。
だから半導体需要が増える。
私は、だいたいそんな理解をしていました。
でも、ふと疑問に思いました。
そもそも、なぜAIにはこれほど大量の計算が必要なんだろう。
調べていくと、「AIは大量の情報を覚えて答えている」という自分の理解が、かなり雑だったことに気づきました。
⸻
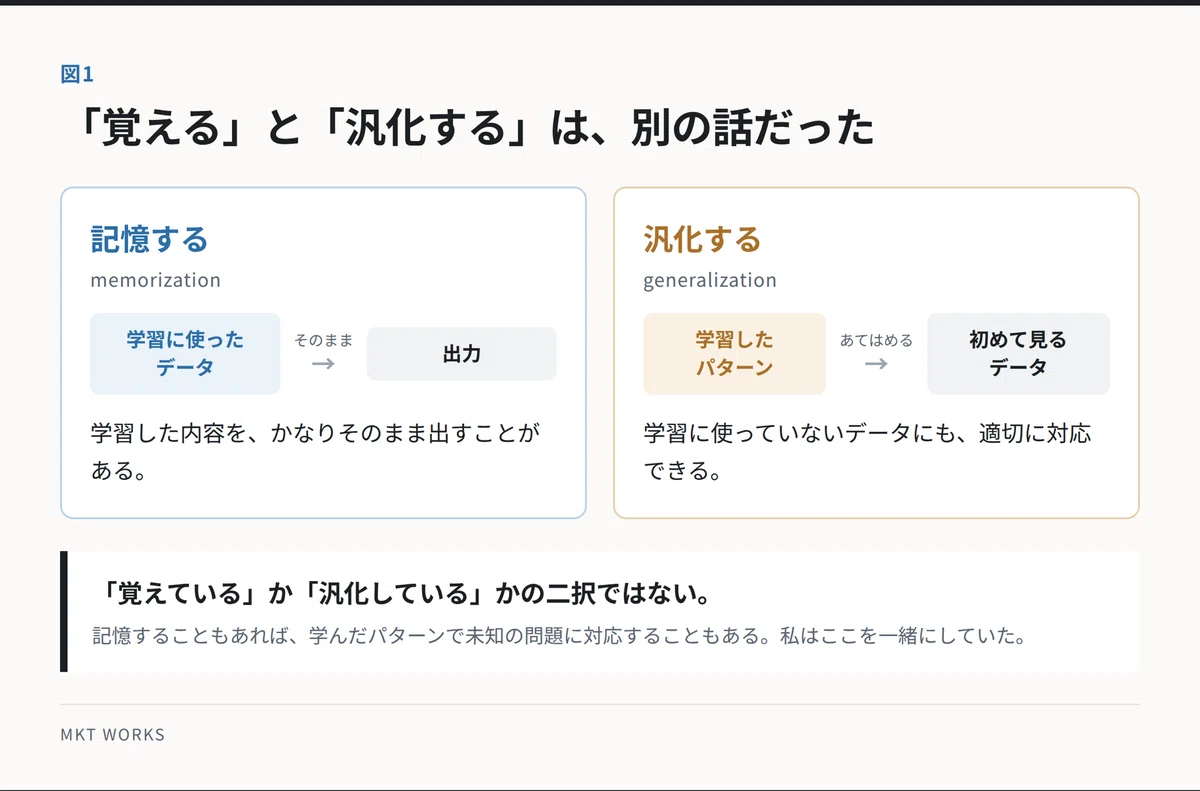
「覚える」と「汎化する」は別の話だった
AIは大量のデータを使って学習します。
その中には、学習データを記憶するような側面もあります。
大きなモデルでは、学習した内容をかなりそのまま出力することもあります。
一方で、機械学習には「汎化」という考え方があります。
学習に使ったデータだけではなく、初めて見るデータに対しても適切に対応できることです。
つまり、
「覚えている」か「汎化している」かの二択ではない。
記憶することもあれば、学習したパターンを使って未知の問題に対応することもある。
私はここを一緒にしていました。
⸻
さらに「創発」という言葉が出てきた
ここから、もう一つ知らない言葉が出てきました。
Emergence。日本語では「創発」と訳されます。
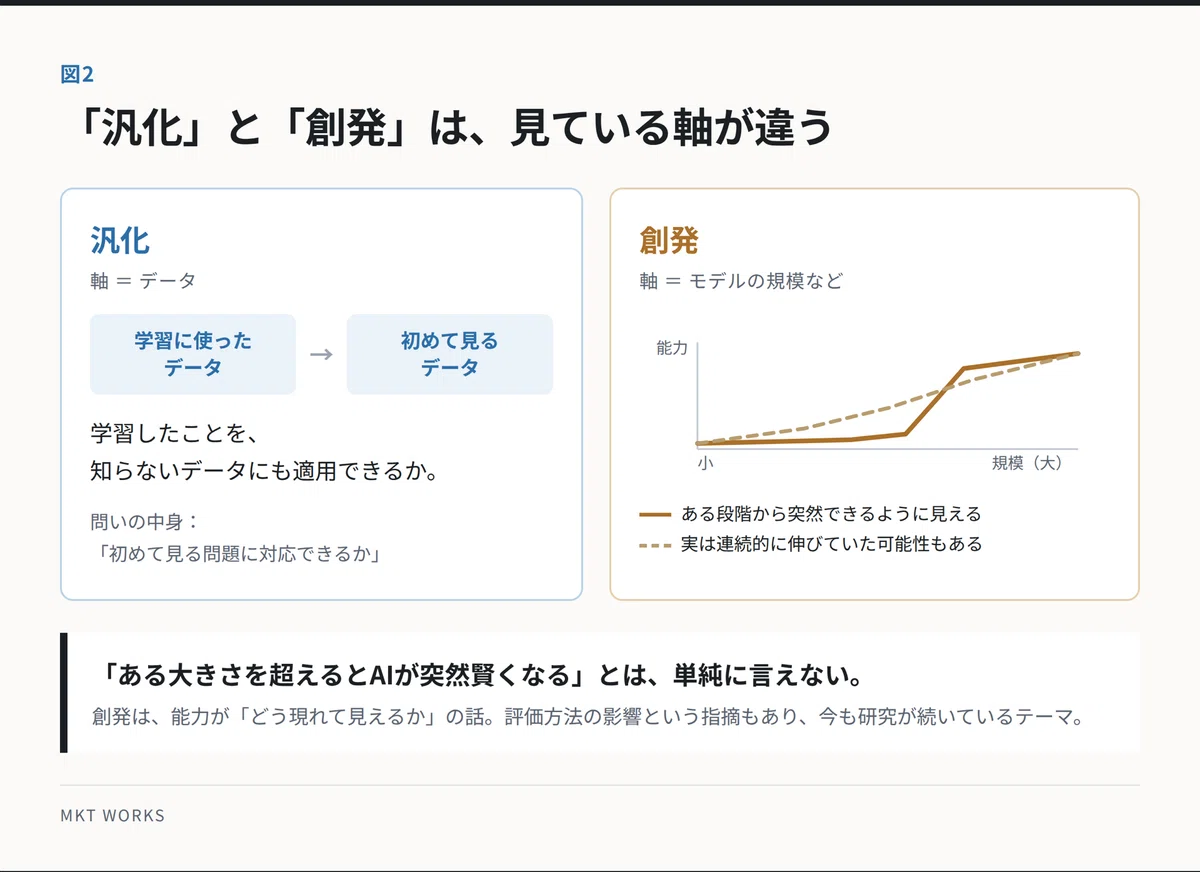
大規模言語モデルでは、モデルの規模などを大きくしていくと、小さなモデルではほとんどできなかった課題が、ある段階からできるように見えるケースが報告されています。
2022年の研究では、こうした現象が「創発的能力」として報告されました。
3桁の足し算なども、その例として挙げられています。
ただ、ここが面白いところでした。
後の研究では、
本当に能力が突然現れたのか。
という疑問も出ています。
評価方法によって、連続的に伸びていた能力が、ある地点から突然現れたように見えている可能性も指摘されています。
一方で、それだけでは創発を説明しきれないという議論や、別の角度からこの現象を捉えようとする研究もあります。
つまり、「ある大きさを超えるとAIが突然賢くなる」と単純に考えていいわけではない。
今も研究が続いているテーマのようです。
⸻
「汎化」と「創発」は同じ話ではない
最初は、この2つも似た話に見えました。
でも違いました。
汎化は、学習したことを未知のデータにも適用できるかという話。
創発は、モデルの規模などを変えていったとき、ある能力がどのように現れて見えるかという話です。
しかも創発については、その見え方自体について議論が続いています。
調べれば調べるほど、最初に考えていた「大量に覚えているAI」というイメージから離れていきました。
⸻
ここで、半導体の話につながった
そして、もう一つ分かったことがあります。
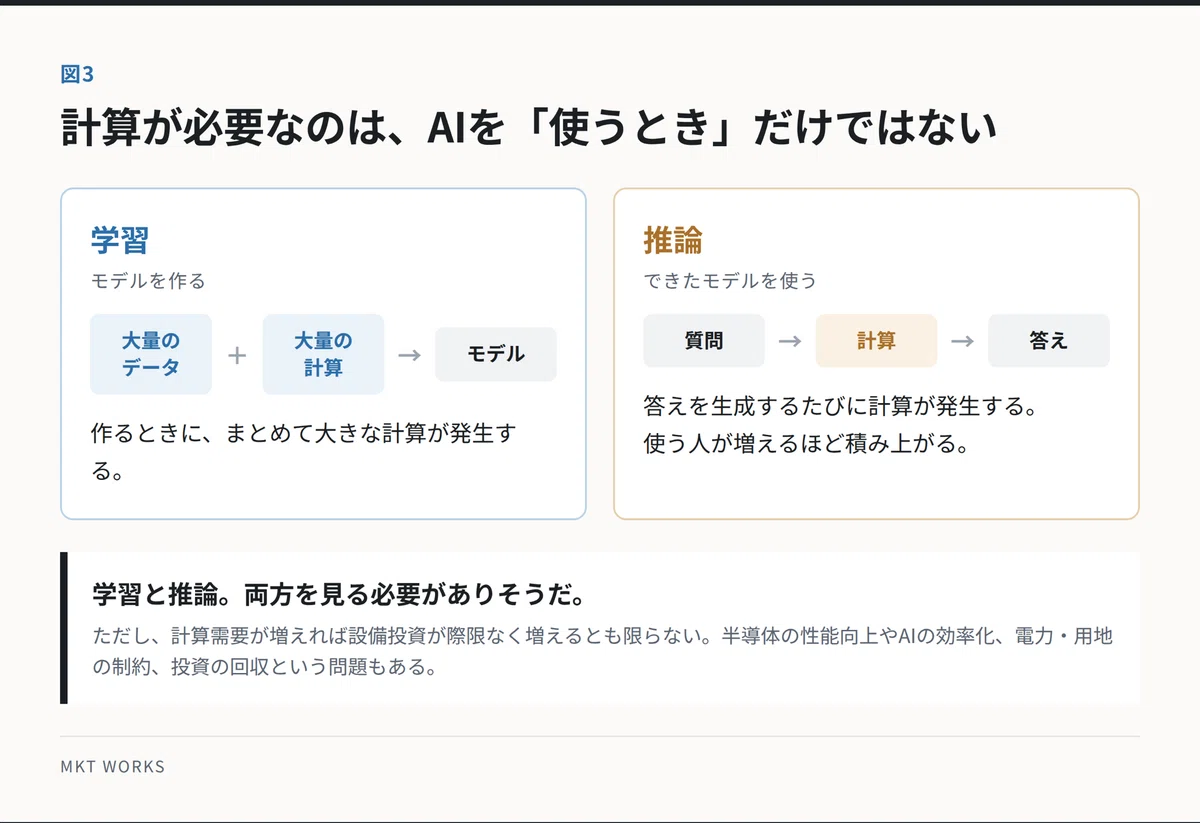
AIには、出来上がったモデルに質問して答えを出してもらう「推論」だけでなく、その前にモデルを作る「学習」でも大量の計算が必要になる。
AIの研究では、モデルの規模だけではなく、学習に使うデータ量や計算量との関係も研究されてきました。
単純に、
「モデルを大きくすれば、その分だけ賢くなる」
という話でもありません。
どれくらいのモデルに、どれくらいのデータと計算を使うのか。
その配分も重要になるようです。
ここまで来て、ようやくGPUの見え方が少し変わりました。
⸻
NVIDIAだけを見ても、全体は分からなかった
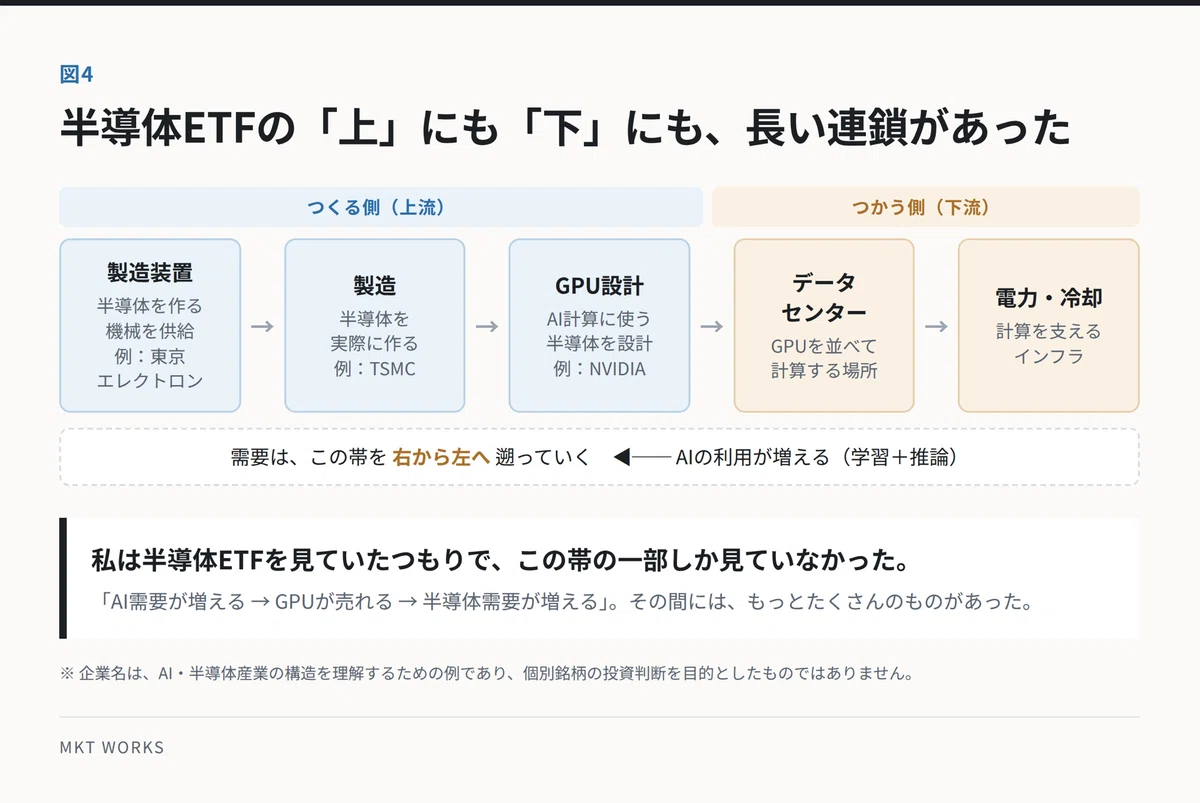
これまで私は、NVIDIA、TSMC、東京エレクトロンといった企業を「AI・半導体」という大きなくくりで見ていました。
でも、役割は全く違います。
NVIDIAはAI計算に使われるGPUなどを設計する。
TSMCは、その半導体を製造する。
東京エレクトロンは、半導体を作るための製造装置を供給する。
そして、AIを使う側を見ていくと、こうなります。
AI → 計算 → データセンター → 電力・冷却
一方、その計算を担う半導体が作られる側を遡ると、
GPU設計(NVIDIA) ← 製造(TSMC) ← 製造装置(東京エレクトロン)
となります。
ここで気づいたのは、需要が伝わっていく向きです。
AIを使う人が増える。
計算が増える。
データセンターにGPUが必要になる。
そのGPUを作る工場が動く。
その工場に製造装置が必要になる。
需要は、この連鎖を使う側から作る側へ、順番に遡っていきます。
私は半導体ETFを見ていたつもりでしたが、上にも下にも、こんなに長い連鎖がありました。
※ここで挙げた企業は、AI・半導体産業の構造を理解するための例であり、個別銘柄の投資判断を目的としたものではありません。
⸻
分かったと思ったら、また分からなくなった
ここまで調べて、
「なるほど。AIを学習させるために大量のGPUが必要なのか」
と一度は納得しました。
ところが、さらに調べると、今度は推論側の計算需要も重要になっていることが分かりました。
AIを作るための計算だけではない。
世界中の人や企業がAIを日常的に使えば、答えを生成するたびにも計算が発生します。
さらに、答えを出す過程そのものに、より多くの計算を使う手法も出てきているようです。
学習と推論。
両方を見る必要がありそうです。
ただ、計算需要が増えるからといって、設備投資が際限なく増えるとも限りません。
半導体の性能向上やAIの効率化もある。
電力やデータセンター用地などの制約もある。
そして大きな設備投資を、企業がどこまで回収できるのかという問題もあります。
ここまで来ると、また分からなくなりました。
⸻
今日、ひとつ分かった。
私はこれまで、
AI需要が増える
↓
GPUが売れる
↓
半導体需要が増える
くらいに考えていました。
でも、その間にはもっとたくさんのものがありました。
AIはどう学習するのか。
計算量を増やすと何が変わるのか。
学習と推論では何が違うのか。
その計算を誰が担い、誰が半導体を作り、誰が製造装置を供給するのか。
半導体の株価を見ているだけでは、その奥にある構造をほとんど見ていませんでした。
では、これからAIの利用がさらに広がったとき、
増えていく計算需要と、効率化・電力制約・投資回収は、どこで折り合うのだろう。
次はそこを観測してみようと思います。
⸻
関連記事
半導体ETFを観測し始めた経緯はこちらです。
→ https://note.com/lithe_pika587/n/n79ff0bd8b065
⸻
参考資料
・Wei et al., Emergent Abilities of Large Language Models(TMLR, 2022)
・Schaeffer et al., Are Emergent Abilities of Large Language Models a Mirage?(NeurIPS 2023)
・Du et al., Understanding Emergent Abilities of Language Models from the Loss Perspective(NeurIPS 2024)
・Kaplan et al., Scaling Laws for Neural Language Models(2020)
・Hoffmann et al., Training Compute-Optimal Large Language Models(NeurIPS 2022)
・OpenAI, Learning to Reason with LLMs(2024)
・東京エレクトロン「製品ラインアップ」
いいなと思ったら応援しよう!
 よろしければ応援お願いします! いただいたチップはクリエイターとしての活動費に使わせていただきます!
