全ての人にデータ分析を
この記事は note株式会社 Advent Calendar 2025 の 2日目の記事になります。
こんにちは、開発部門データユニット マネージャーの久保田です。
データ抽出・データ分析のデータユニットへの依存を解消するため、自然言語からSQLの構築ができるtext2SQLを実装し、問い合わせ業務の工数を激減させたので、そのお話です。
概要
noteでデータ基盤を担当し、データマネジメント領域も担当して数年、ずっととある課題に悩まされていました。それは「問い合わせに対する工数が全く減らない」ということです。
noteのデータユニットでは、「データの民主化」を目標に掲げていました。
そのために、
BIツールの導入・普及
各種ドキュメントの整備
問い合わせフローの確立
ハンズオンによる教育
など、思いつくことはだいたいやってきました。
ありがたいことに、社員の方のデータへの価値観は高まり各チームがKPIを設定し、日々データに基づいた意思決定が行われるようになったとは自負しています。
しかし、データの普及が高まるにつれ、問い合わせに対する工数は増えていく一方でした。ありがたいことである反面、工数が問い合わせ対応に割かれてしまい、本来やりたいこと・やるべきことができなくなってしまうという側面もありました。
そこで、このAI時代に本格的に、「誰でもデータにアクセスできる環境」の構築し「データの民主化」を目指しました。
データの民主化とは
そもそもデータの民主化とはなんでしょうか?
色々な考えがあるかと思いますが、僕は
ユーザーの知識に依存せず、正しくデータの抽出・分析ができる環境
と定義しました。
ある程度のサービスへの知識がある社員であれば、SQLを書かずに誰でもデータ分析ができたら夢の環境ですよね。
システム構成
システム構成は以下です。
必要なドキュメントはdbtから生成したり事前に用意してあり、それをclaudeにプロンプトとして渡し、テーブルの探索やSQLの生成を行います。

フローは以下です。
1、問い合わせ
slackからユーザーの入力を受け取る
2、テーブル探索
dbtの_models.yamlから生成した軽量インデックスをプロンプトに入れて、SQL構築に必要なテーブルの探索を行う
3、SQL生成
2で見つけたテーブルの定義のみdbtの_models.yamlから取得し、ER図や追加の説明などをもつドキュメントと一緒にプロンプトに渡しSQLを構築、その際にjoinの必要があれば再度テーブル探索を行い、ルールに沿ってSQLを構築
という流れです。
一度で生成を行うのではなく、探索と生成を行うことで、トークン数を削減しながら高い精度のSQL生成を行えるようにしました。
実際の動作の状況は以下のような感じです。
※見せられないものが多いので、イメージです。
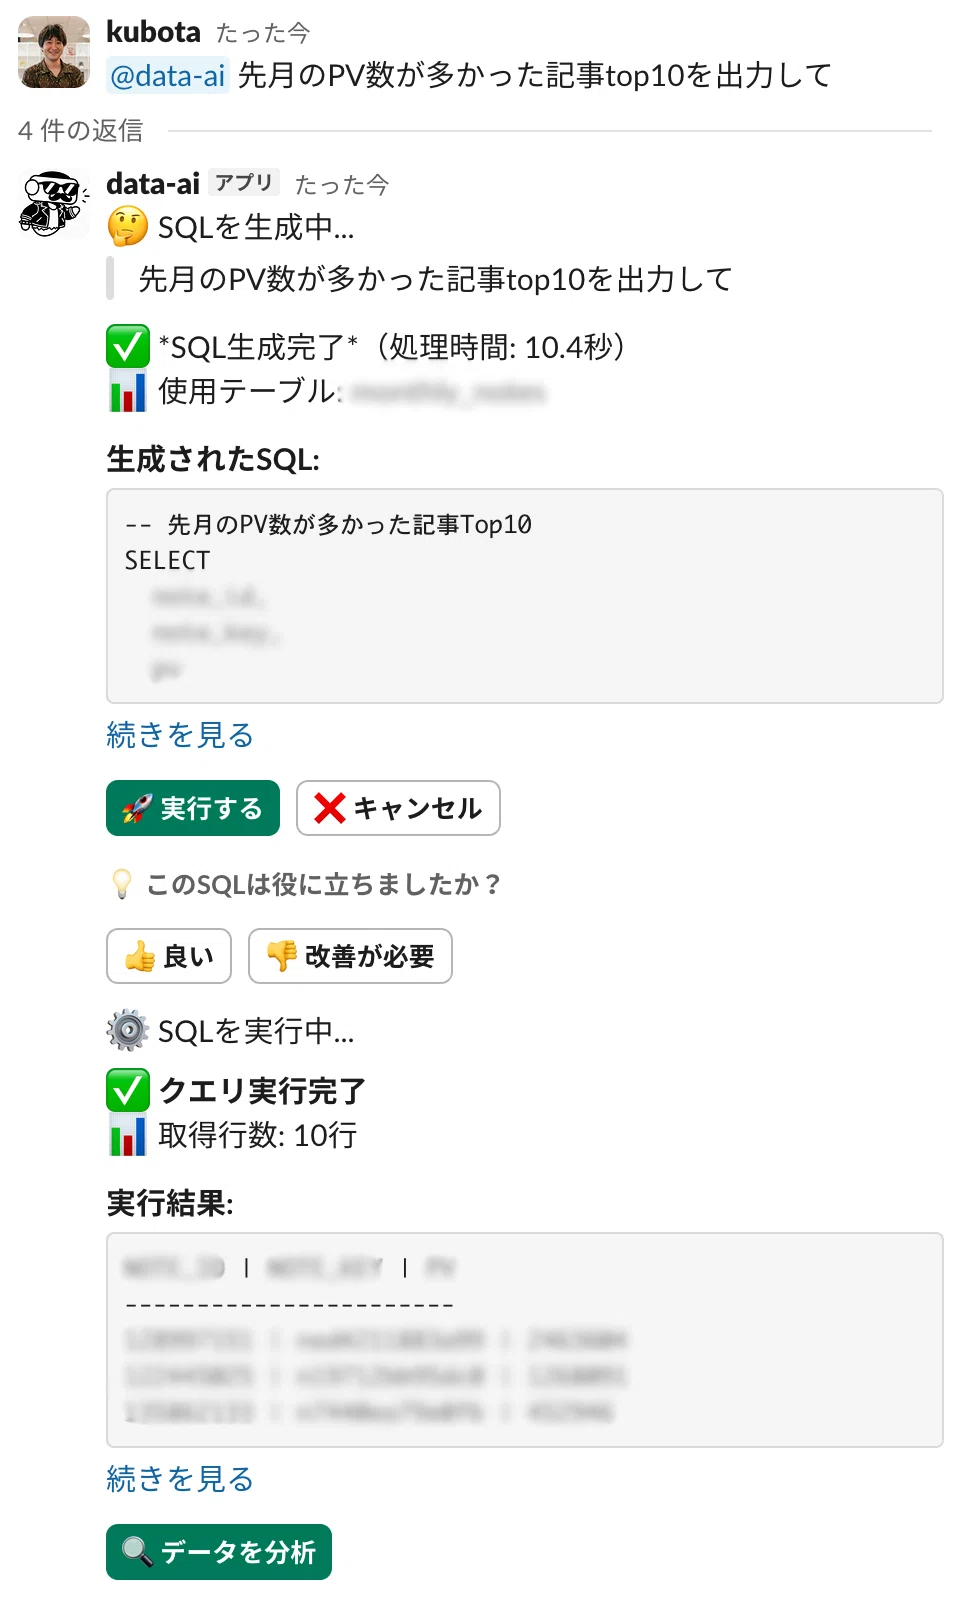
@data-aiに対して質問をすると、SQLが生成され、実行・分析まで可能にしてあります。
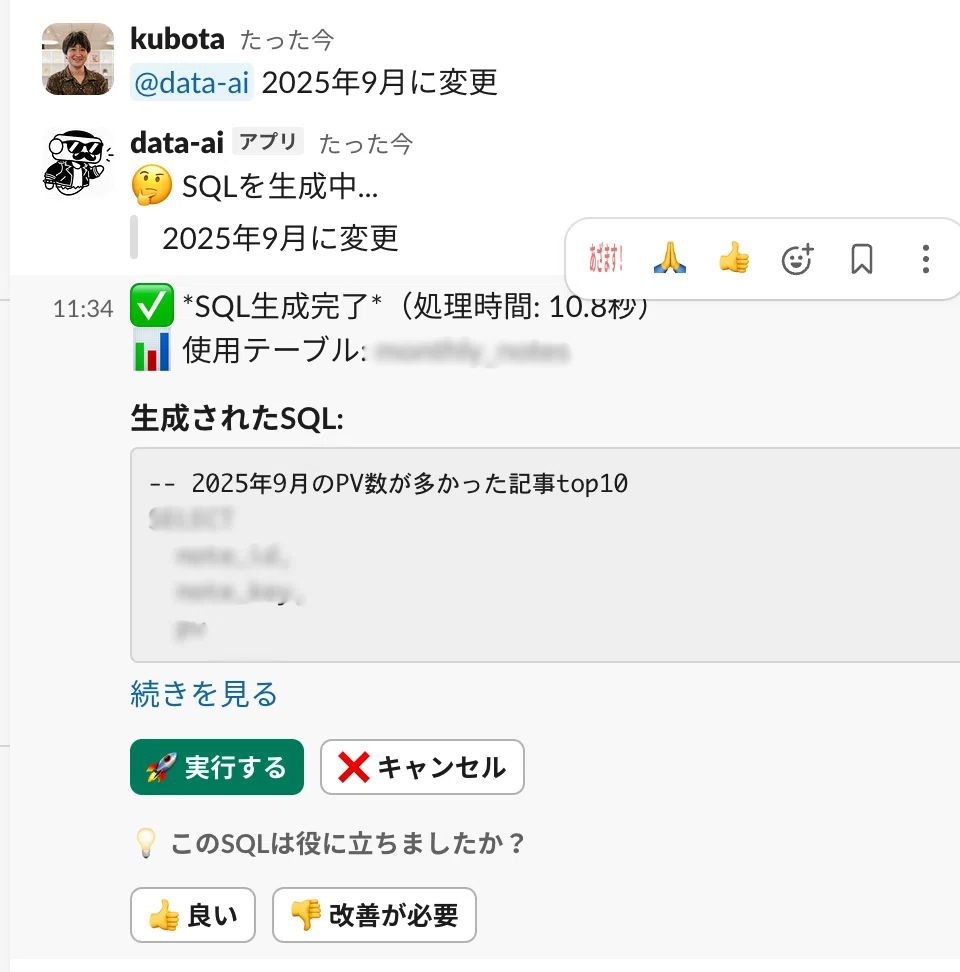
また、スレッド内の会話履歴も考慮しているため、少し修正なども可能です。
精度の向上について
まず大前提として、すでにLLMはSQLを書けます。
基本的なものから複雑なものまで、基本的には書けてしまいます。
しかし、まっさらな状態で
「noteの中で先月PVが多かった記事TOP10を抽出するSQLを書いて」
と言ってもうまくいきません。
おそらくみたことがないテーブル名を勝手に作り出すでしょう。
これを正確に行うためには、
「noteの中で先月PVが多かった記事TOP10を抽出するSQLを書いて。
テーブルには、datamart.month_notesを、PVはdatamart.month_notes.pvカラムを使ってください。
日付はdatamart.month_notes.dateカラムを使って2025年11月1日から11月30日までを条件にしてください。
また、DBはSnowflakeなので、Snowflakeで動く形式で書いてください。
最終的な出力は、id,pvです。」
とするとどうでしょうか。
おそらくほとんどの場合でうまくいきます。
彼らは、必要なテーブル・カラムがどこにあるのか・カラムの中のどの条件を使えばいいのかなどがわからないだけなのです。
しかし、ビジネスユーザーや普段データ基盤に触れていない方はこんな正確な指示は出せないですね。
なので、それをLLMに事前に教えるため、私はdbtをベースにした上記のアーキテクチャーを作成しました。
dbtにはすでにテーブル・カラムの説明を入れてあるので、2重管理になることを防ぎつつ簡単にLLMに対して知識を与えられると考えたためです。
先ほどのLLMに対しての2つ目の問い合わせの後半部分を、すでに知っているもの・探索可能なものとして伝えた、というイメージです。
この時ポイントとなるのが、如何に簡潔に・情報量を多く伝えることだと感じました。
例えば、noteには、日毎に各KPIを集計している中間テーブルがあります。(仮にkpi_dailyとします。)
このテーブルは、以下のような構造でした。
| カラム名      | 説明     |
| target_date | 集計実施日 |
| name        | kpi名    |
| value       | 集計した値 |
このテーブルに対して、当初は以下のような説明を与えていました。
このテーブルは、noteの各種KPIを日毎に保存しているテーブルです。nameカラムにはKPI名があり、valueカラムにはKPI名に対応した集計済みの値が入っています。
このくらいの説明で、あとは適切に行なってくれると思っていました。
が、実際は、
問い合わせ時に簡単に指定をしても、PVという条件をPV数に勝手に変えたりするなどのnameカラムの条件に見たことないものを使ったり、
こちらが使ってほしいタイミングでテーブルを作ってくれなかったり、
nameでの絞り込みを行わなかったりなど、と全くうまくいきませんでした。
そこで、以下のようにテーブル説明を変更しました。
※以下の内容は全て仮のものです。
【日次・サービス全体】サービス全体のKPIを日別に集計したテーブル。記事別・ユーザー別ではなく、全サービスの総計。
使用するときは、nameで絞り込みを必ず行うこと。
以下が対応するnameの一覧。
条件の意味=>nameの形式です。
無料記事のみのPV数=>無料記事PV
スキ数=>スキ
投稿数=>投稿された回数
webのPV数=>PV(Web)
web,appのPV数,合計PV数=>PV
会員数=>会員
AppのPV数=>PV(APP)
投稿者数,記事投稿者数=>投稿者数
ユーザー数=>ユーザー
用途:
- 昨日・今日のサービス全体の主要指標確認
- 日毎のGMV、PV数などの推移分析
- サービス全体の日次トレンド把握
主要指標: 総PV数、GMV、ユーザー数、記事数、投稿数
粒度: サービス全体(記事別・ユーザー別ではない)
時間範囲: 日別データ
こうすることで、
「日毎のPV数の遷移を教えて」
「昨日の会員数を教えて」
などの質問だけで、LLMがSQLを正確に生成することが可能になりました。
joinについて
joinに関しては、ER図を用いてjoinを可能にしました。
当初は基本的にデータマートのみを扱えるようにしていたのですが、ユーザーのリクエストを見ていると、どうも無理そうだと気がつきました。
というのも、僕が想定しているよりも、社員の皆さんは、高度な質問をしていることがわかったからです。
この要望に応えるためには、joinを柔軟に行えるようにする必要性が出てきました。
しかし、テーブル説明などに書くのも網羅的でないし、仮に書いたとしても、見たことないjoinの条件を作ってしまったりしていました。
こちらを解消するために、ER図を作成し、SQL生成時に読み込ませることで、最適なjoinをできるようにしました。
工夫した点
その他の工夫した点は以下となります。
slackで完結できるようにした
当初はstreamlitで開発をしていたのですが、streamlitだと以下の課題がありました。
- 誰がどのような質問をしたのかわからない
- いちいちブラウザでページを開いて、というのが面倒
特に、誰がどのような質問をしたのかわからない、というのはかなり課題に感じていました。
LLMである以上、100%の精度でSQLを構築することは不可能です。
もちろん利用のログは取っているのですが、誰が、というのは補足できませんでした。
その状況で誰がどのような質問をしたのかわからない状況だと仮に間違ったクエリーを作成してそれを経営判断に使ってしまうというリスクがあります。
そのため、どのようなやり取りがなされているかを監視する必要があると考えました。
そこで、slackにアプリを作成し、実行できるチャンネルを限定することで、結果として上記の2つの課題を同時に解消し、また間違っている結果に対して即座にサポートに入ることができました。
テストを中心とした開発
このシステムは、全てLLMで開発しました。
そのため、各機能をコンポーネントにし、テストを作成し、実装したものが基準を満たすか、ということを何百回も試しました。
単体テストと統合テストを用意することで、各テストに対して、どこで精度が落ちているのかをわかるようにすることで、精度を向上することができました。
verified queryを登録できるようにした
slackでSQLを発行後、正しいSQLを構築できたときに評価をできるようにしました。
こうすることで、継続的に賢くなれる仕組みを構築しました。
こちらのデータもSQL構築時に読み込ませています。
効果
まだまだハルシネーションを起こすことも多いですが、導入後、データユニットへの問い合わせの8割以上はこちらのシステムのみで解決できるようになりました。
また、まだ社内の認知も低いので、今後はより精度の向上や機能追加に努め、全社員が使えるようにしていく予定です。
ガバナンスについて
AIでデータ分析などをやらせる際に気になるのはやはりガバナンスの部分かと思います。
もちろんこのAIで使ったデータは、AIサービスの学習データとして提供はしておらず、またnoteではデータ基盤に個人情報は含めておりません。
よってAIに対し、ユーザーのデータを提供することはありません。
このAI時代にデータ関連の業務をAIに任せるためには絶対にダメなラインを設定し、ある程度のリスクは許容しつつ運用していくのがベストだと感じております。
コストについて
現時点では、モデルはclaude-opus-4-5-20251101を使っています。
全てClaudeのAPIを利用していて、1問い合わせに対して、3~5円くらいのコスト感です。
大体ですが、今までの対応コストは1時間/人でした。月で30回問い合わせがあったとして、30時間/人の工数が150円ほどに削減できていると考えると、劇的な改善と言えます。
まとめ
AIでSQL生成・データ分析を行わせるには、メリット・デメリット多数あるかと思います。
確かにまだまだ精度は100%とは言えず、体感的にも60%くらいに感じます。
しかし、AIによる進化は凄まじく、正しい指示を与えれば難解なSQLでもAIは即座に生成してくれます。
SQLの生成はもう人間がやる仕事ではないと感じました。
しかしデータを使った意思決定はまだ人間の仕事です。
この時代にデータエンジニア・データアナリストがやるべき仕事は、AIがデータを正しく取得できる環境を整え、人間に意思決定を行わせることなのかもしれません。
こちらでは書ききれないような工夫した点・苦労した点などまだまだあるのでもしご興味のある方はお声がけください。
お読みいただきありがとうございました。
