PoCで終わらせない。noteで実装したtext2SQL。工数を160時間削減した設計と運用の全記録
はじめに
「PoCは成功したけど、本番運用に進めない」—text2SQL実装でこの壁にぶつかっているエンジニアは多いのではないでしょうか。
私たちはこの壁を乗り越え、現在では社内のデータ問い合わせの65%を自動解決し、約160時間(20人日)の工数削減を実現しています。SQL生成の成功率は 94.6% まで向上しました。
この記事では、本番運用できるtext2SQLを実現するために、どんな技術選定・アーキテクチャ設計・運用改善を行ったのか公開します。
text2SQLとは?なぜ導入したのか
text2SQLの基本概念
text2SQLは、自然言語からSQLを自動生成する技術です。「先月の売上を教えて」といった平易な言葉を、LLM(大規模言語モデル)が適切なSQLクエリに変換し、データベースから結果を取得します。
この技術により、SQLを書けない非エンジニアでも、データに直接アクセスできるようになります。いわゆる「データの民主化」を実現する手段として、注目を集めています。
私たちが抱えていた課題
導入の背景には、3つの大きな課題がありました。
データエンジニア・データアナリストへの問い合わせ過多: 日々大量のデータ抽出依頼に対応し、本質的な業務に時間を割けない
社内ユーザーの課題: データが欲しい時に誰に聞けばいいか分からず、結果が出るまで数時間から数日かかる
BIツールの限界: あらかじめ設計されたダッシュボードでしか分析できず、柔軟な要望に対応できない
目標: 全社員が自律的に、即座にデータを活用できる状態を作る。
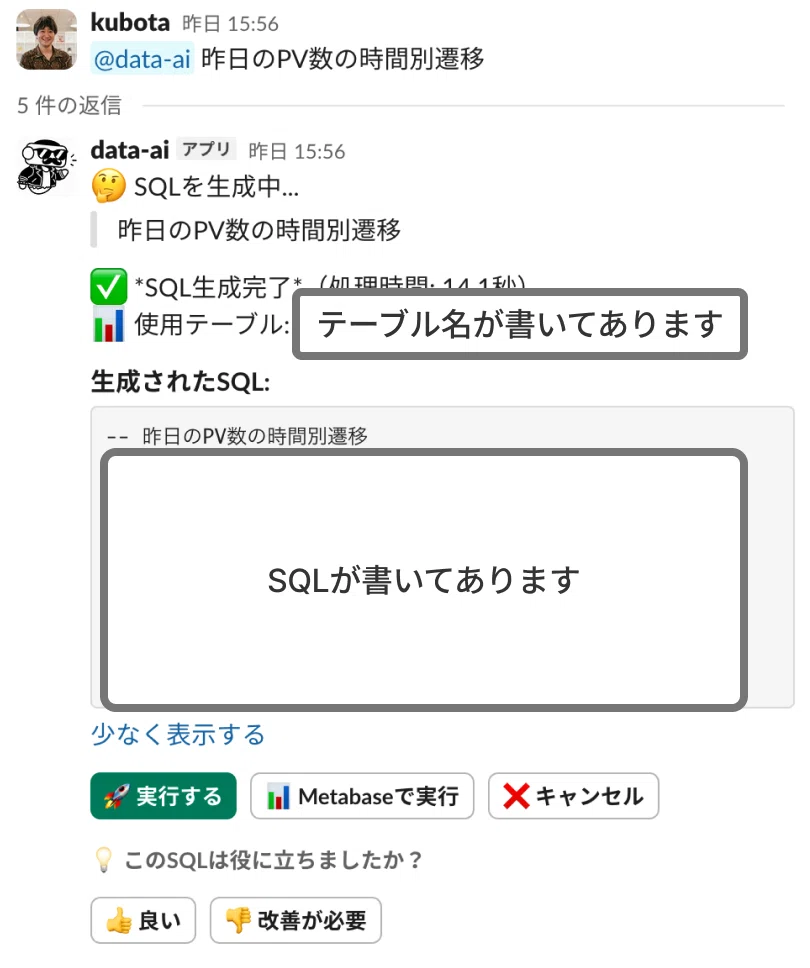
以下は実際に利用している画面のスクショです。
システムアーキテクチャ
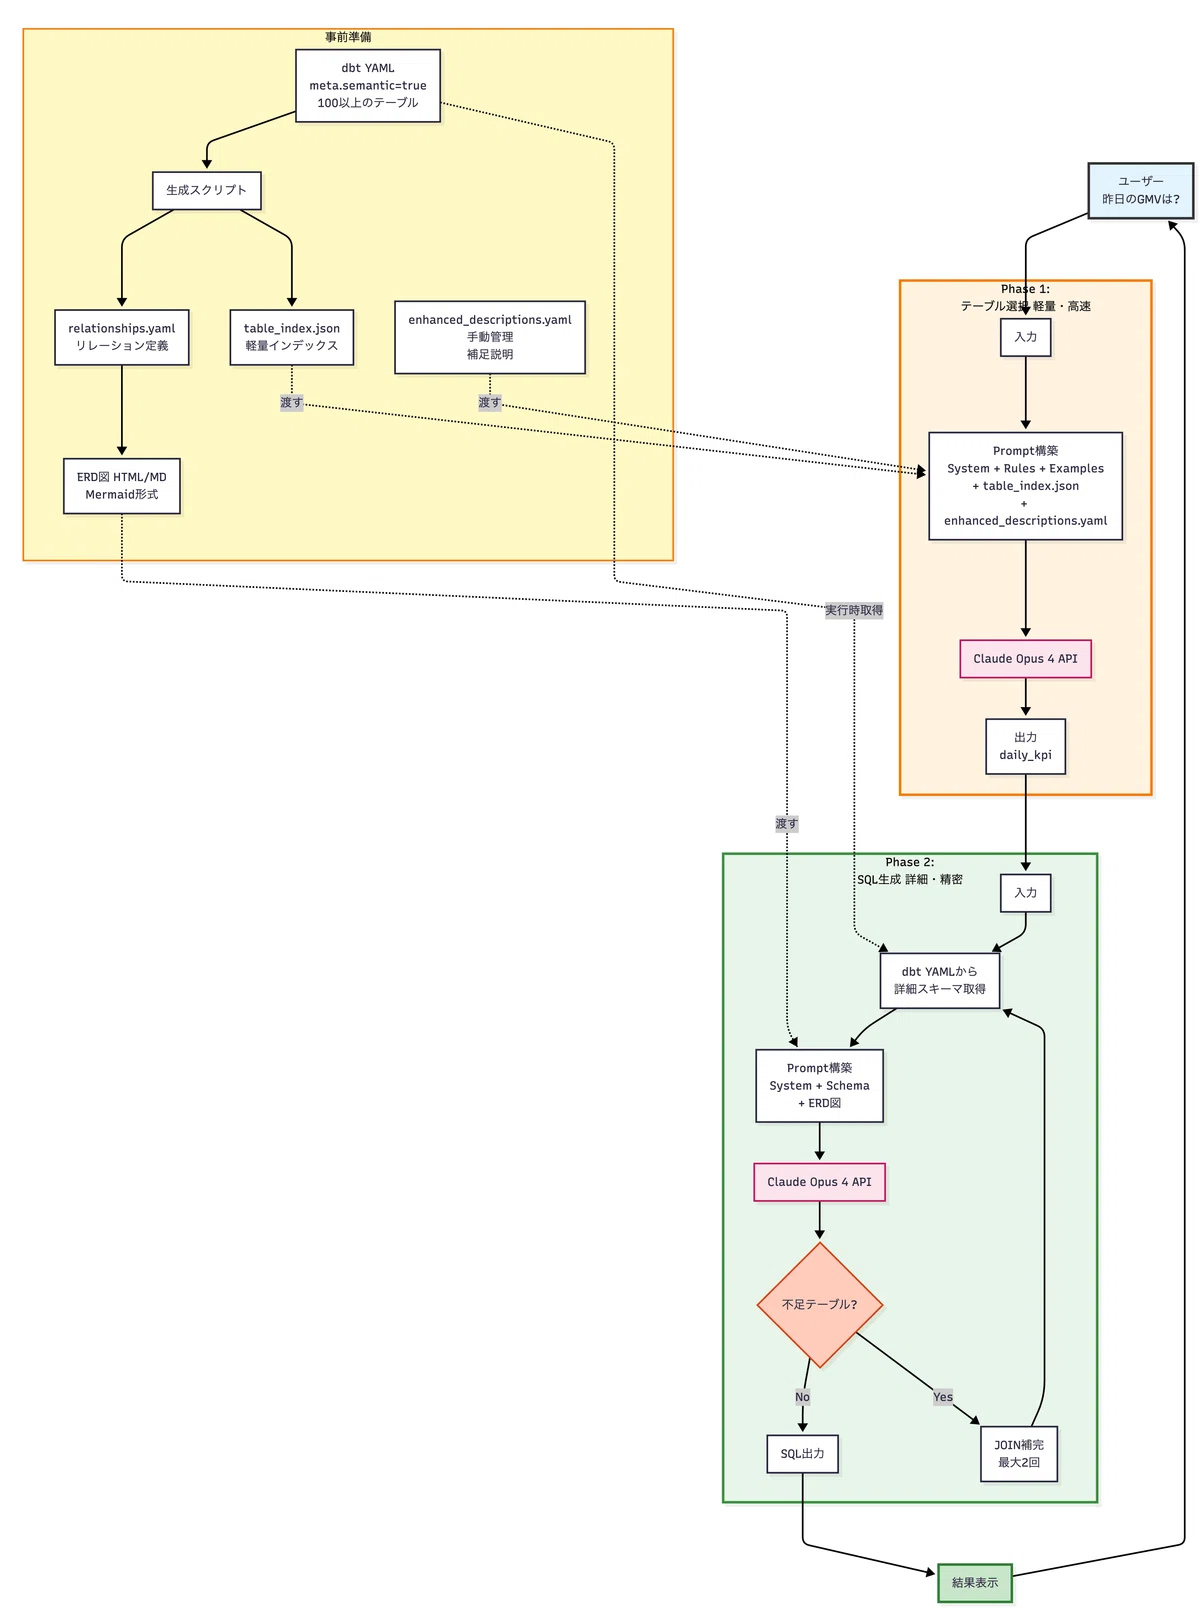
システム構成の全体像
text2SQLシステムは、以下のようなシンプルな構成で動作しています。
ユーザー(Slack)
  ↓
API(バックエンド)
  ↓
LLM(GPT-4等)
  ↓
生成されたクエリーをSlackに返却
 ↓
ユーザーが必要に応じて実行
ユーザーがSlackで自然言語のクエリを入力すると、バックエンドAPIがそれを受け取ります。APIはLLMにクエリとスキーマ情報を送信し、LLMが適切なSQLを生成します。生成されたSQLをユーザーに返却し、ユーザーが必要に応じてSnowflakeで実行し、結果をSlackに返却する流れです。
技術スタック
主要な技術要素は以下の通りです。
UI: Slack(既存のコミュニケーション基盤を活用)
バックエンド: Python
LLM: 高性能モデルをAPI経由で使用
データベース: Snowflake
データモデル管理: dbt(データ変換とスキーマ定義を一元管理)
認証・認可: Snowflakeのロールベースアクセス制御
RAG用のベクトルDBは、当初検討して検証しましたが、どうしても複雑なjoinやテーブル数が増えたときに適切なテーブルを探すことが難しく、最終的には不要と判断しました。(ここは私の技術力不足だと感じています。)
データフロー
ユーザーがSlackで自然言語クエリを入力(例:「先月のアクティブユーザー数を教えて」)
バックエンドがクエリを受け取り、前処理
LLMにプロンプトとスキーマ情報を送信
LLMが2段階プロンプトでSQLを生成(適切なテーブル選択→SQL構築)
生成されたSQLをユーザーに返却
ユーザーが必要に応じてSQLを実行
結果をSlackに返却(表形式)
技術要素の深掘り
RAGから軽量インデックスへの転換
初期はRAG(Retrieval-Augmented Generation)でテーブルを選択していましたが、ベクトル検索の精度が不安定で、チューニングにも時間がかかりました。
そこで、全テーブルの軽量インデックス(テーブル名+説明文)を直接LLMに渡す方式に転換しました。150テーブルでも約50K tokens程度で、コンテキストに十分収まります。RAG用のインフラが不要になり、シンプルかつ安定した設計を実現できました。
問い合わせの65%を自動解決した2段階プロンプト設計
軽量インデックスを採用したことで、プロンプト設計がシンプルになりました。現在のシステムは、2段階のプロンプトでSQLを生成しています。
Phase 1: テーブル選択
最初のステップでは、ユーザーのクエリに対して、どのテーブルが必要かをLLMに判断させます。
このとき、全150テーブルの軽量インデックスをコンテキストに含めます。各テーブルには、以下の情報が含まれています。
テーブル名
テーブルの説明(どんなデータが入っているか)
主要なカラム名と説明
加えて、ルールを自然言語で記述します。
例:
「日毎の集計が必要なら `daily_*` テーブルを使用する」
「ユーザー属性が必要なら `users` テーブルをJOINする」
「売上データは `sales` テーブルだが、返品を含む場合は `sales_with_returns` を使う」
ルールをコードではなくプロンプトに書くことで、柔軟な変更が可能になりました。
Phase 2: SQL生成
Phase 1で選択されたテーブルのみ、詳細なスキーマ情報を取得してLLMに渡します。
全カラムの名前、型、説明
ERD図(テーブル同士の関係を視覚的に表現)
このとき、厳密なバリデーションルールを設定します。
「スキーマに存在しないカラムは使用しない」
「集計関数を使う場合、GROUP BYを忘れない」
「日付範囲を指定する場合、適切なインデックスカラムを使う」
などです。
また、このときにjoinが必要な場合は再度テーブル検索をし、構築に必要なテーブルを取得します。
軽量インデックスの利点
シンプルで安定: ベクトル検索が不要で、毎回同じ結果が得られやすい
高速な改善サイクル: dbt YAMLの説明文を修正すれば即座に反映
保守性の向上: RAG用インフラが不要
この2段階プロンプト設計により、データ関連の問い合わせの65%をtext2SQLで自動解決できるようになりました。
dbtをシングルソースとしたスキーマ管理
text2SQLの精度を左右するのは、兎にも角にも、スキーマ情報の管理です。
当初はテーブルを限定して運用していましたが、多様な問い合わせに対応できませんでした。そこで、100以上のテーブルから柔軟にクエリを組み立てる方針に転換しました。
スキーマ情報はdbtで一元管理しています。以下の情報をdbt YAMLファイルのmeta情報などを利用して管理することで、データモデルとtext2SQL定義が乖離せず、保守性が高まりました。
スキーマ定義(カラム名、型)
テーブル・カラムの説明
text2SQL対象フラグ(`meta.semantic: true`)
テーブル間のJOIN条件は別途 `config/relationships.yaml` で管理しており、LLMが不足しているテーブルを自動検出し、JOINを補完します。
設計思想・判断プロセス
シンプルさと高精度の両立
RAGを削減したことで、インフラ運用コストが削減され、その分を高性能LLMに投資できました。また、最初から全機能を実装せず、小さく始めてユーザーフィードバックをもとに拡張するアプローチで、本当に必要な機能に集中できました。
ユーザー体験の重視
text2SQLの成功には、技術的な精度だけでなく、ユーザー体験も重要です。
Slack経由での実行を可能にした:当初はstreamlitで構築していたんですが、やはりわざわざブラウザのブックマークからこのページを開いて、、、だとどうしても浸透率が低くなってしまいました。
加えて、誰がどうやって使っていて、それが成功したのか失敗したのかがわからない状態でした。
そこで、slack経由でかつ特定のチャンネルのみで実行できるようにすることで、使いやすさと管理のしやすさを実現しました。Slackのスレッド機能を活用した: slackのスレッド機能を使うことで、会話履歴を保持しながら対話を可能にすることで、「もう少し詳しく」「期間を変えて」といった自然な言葉で修正依頼を実現しました。
運用3ヶ月の成果
定量的な成果
導入から3ヶ月で、以下の成果が得られました。
自動解決率: 65%(データ関連の問い合わせのうち、text2SQLで完結した割合)
工数削減: 約160時間(20人日)
SQL生成精度: 94.6%(生成されたSQLが初回で実行成功した割合)
平均レスポンス時間: 8秒(クエリ入力からSlackへの結果返却まで)
データ基盤利用率: 50%向上(月間クエリ実行数が1.5倍に増加)
定性的な成果
非エンジニアが自律的にデータ取得: SQL知識のない社員が、必要な瞬間にデータを取得。意思決定スピードが向上
本質的な業務に集中: 単純なデータ抽出依頼が減り、データ基盤改善や深い分析に時間を割けるように
データドリブン文化の浸透: 「とりあえずデータを見てみよう」と自然に動けるようになった
これだけ見ると65%だけ?と思うかもしれませんが、私としては、非エンジニアが自律的にデータ取得できるという点が1番導入してよかった、と感じています。
それまでは「わざわざこんなこと聞くのもな、、」などの人と人が仕事するので仕方がないですが、どうしてもこうした点がボトルネックになってしまっていました。それが解決できたことが、ユーザーにとっても僕らにとっても1番の良い点だったと感じています。
失敗・ハマりどころ
主な失敗と解決策
ユーザーの意図を誤解釈
→ プロンプトにFew-shot examples(enhanced_descriptions.yaml)を追加し、特殊なケースなどのドメイン知識を教え込みました。データの説明不足
→ スキーマ説明、カラム説明、テーブルの用途を丁寧に書くことが最も重要でした。LLMのプロンプトを調整することも大事ですが、やはり一番はデータとデータの説明を整えることでした。また、命名規則を統一(`daily_`, `monthly_`等)すると、LLMがテーブルを推測しやすくなります。
今後の展開
課題
想定以上にユーザーが活用してくれる一方で、複雑なビジネスロジックや曖昧な表現のクエリ、特定の業務ドメインでは、まだ精度が低いパターンが残っています。
今後はどんどん使ってもらい、正解パターンを増やす・データソースの説明にもっとビジネスロジックを反映させるなどを経て、精度の向上に努める予定です。
また、現在のtext2SQLは単純なデータ取得には十分ですが、今後は以下の方向に進化させます。
複雑なビジネスロジックへの対応: 複数ステップのクエリ生成により、段階的なデータ加工を自動化
意思決定パートナーへの進化: 「この課題をどうすべきか?」という抽象的な相談に対し、LLMが仮説を立て、データで検証する対話的な分析支援
まとめ
本番運用できるtext2SQLを実現するには、以下が重要です。
データの説明を丁寧に書く
プロンプトよりも、スキーマ説明、カラム説明、テーブルの用途説明が精度を決める。ユーザー体験を重視する
とにかく使いやすさ、直感的に使えるということがユーザーの利用を促進します。dbtをシングルソースにする
データモデルとtext2SQL定義が乖離しないよう、dbtで一元管理する。
PoCで終わらせず、本番運用までやり切ることで、データの民主化が実現します。まずは小規模なユースケースから始めてみてください。
