自然言語で物理シミュレーションを実現:MCP-SIM
自然言語で物理シミュレーションを実現:MCP-SIM
こんにちは、makokonです。
今や物理AIが大人気ですが、その根本は物理現象をAIが以下に理解するかということです。
この論文は、AIが単なるコーディングマシンの枠を超えて、学習し、思考する「能動的な物理モデリングへの参加者」としての変化を示しています。MCP-SIMは弾性学や流体力学などの複雑な全12課題を正確に再現する物理シミュレーションを、自然言語の指示によって自動生成するマルチエージェント型AIフレームワークです。また、解説レポートを自動生成する機能も備え、教育や研究の現場での専門知識の壁を取り払う科学支援ツールとしての活用が期待できます。
MCP-SIM:言語ベースの物理シミュレーションと解説のための自己修正型マルチエージェントLLMフレームワーク
自然言語のプロンプトから高精度な物理シミュレーションを自動生成し、その物理的背景を多言語で解説する革新的なフレームワーク「MCP-SIM(Memory-Coordinated Physics-Aware Simulation)」に関する説明をしていきます。
概要
従来のシミュレーション構築には、数値ソルバーや支配方程式に関する専門知識が不可欠であった。大規模言語モデル(LLM)の活用により、自然言語によるシミュレーションの可能性が開かれたが、既存のシステムは曖昧な指示や複雑なマルチフィジックス課題に対して脆弱であった。
MCP-SIMは、
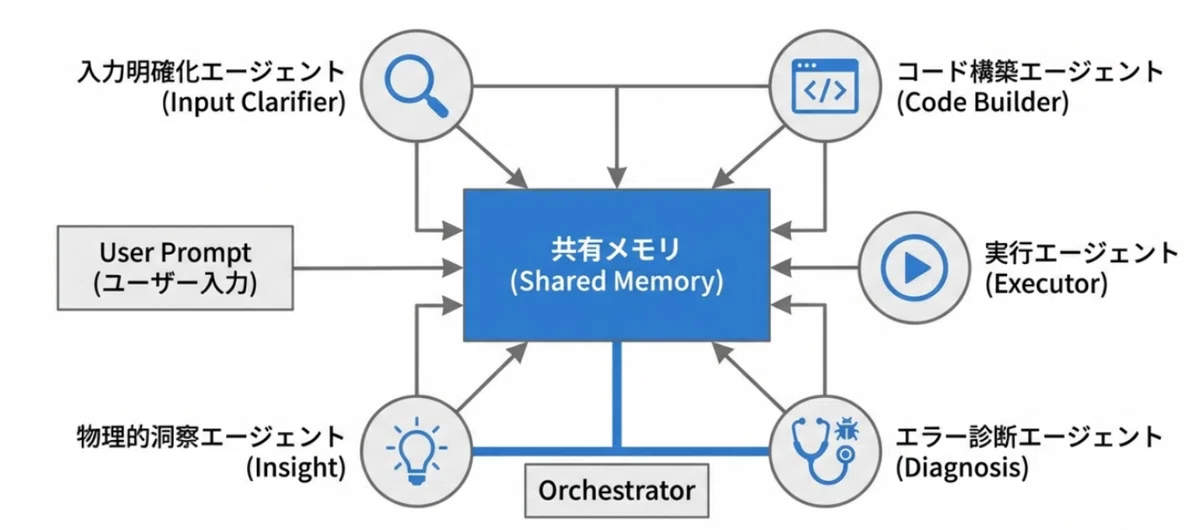
6つの専門エージェントが共有メモリを介して協力するマルチエージェント・アーキテクチャを採用
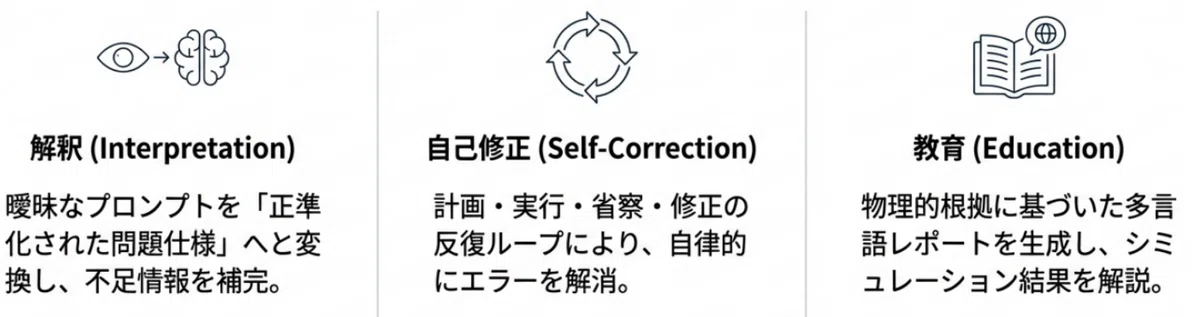
曖昧な指示を正準化された問題仕様へ変更
専門家の思考プロセスを模倣した「計画(Plan)→実行(Act)→省察(Reflect)→修正(Revise)」の反復サイクルで自律的にエラーを解消
物理的根拠に基づいたレポート作成
主な成果:
完全なタスク遂行能力: 12段階の難易度別ベンチマークにおいて、すべてのタスク(12/12)を成功させた。
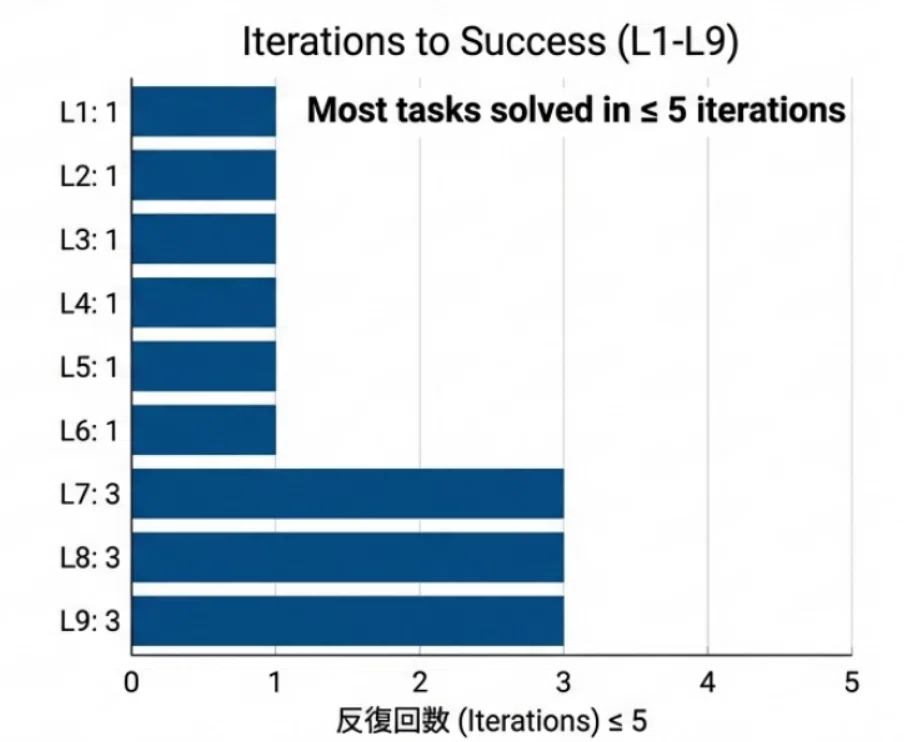
高い収束効率: ほとんどの課題において5回以内の反復で成功に到達し、従来のGPT単体モデル(B1)や人間が介在するハイブリッドモデル(B3)を大幅に上回る効率性を示した。
自己修正能力: コードのエラー、物理的な不整合、プロンプトの曖昧さを自律的に診断し、物理的知見に基づいた修正を提案・実行する。
教育的価値: シミュレーション結果だけでなく、その物理的論理やソルバーの選択理由を英語、韓国語、日本語、ドイツ語などの多言語で解説するレポートを自動生成する。
--------------------------------------------------------------------------------
1. 背景と既存手法の限界
科学・工学分野において物理シミュレーションは不可欠だが、プログラミングや数値解析の専門知識を持たない学生や研究者にとって、その壁は依然として高い。
既存のLLMアプローチの欠陥
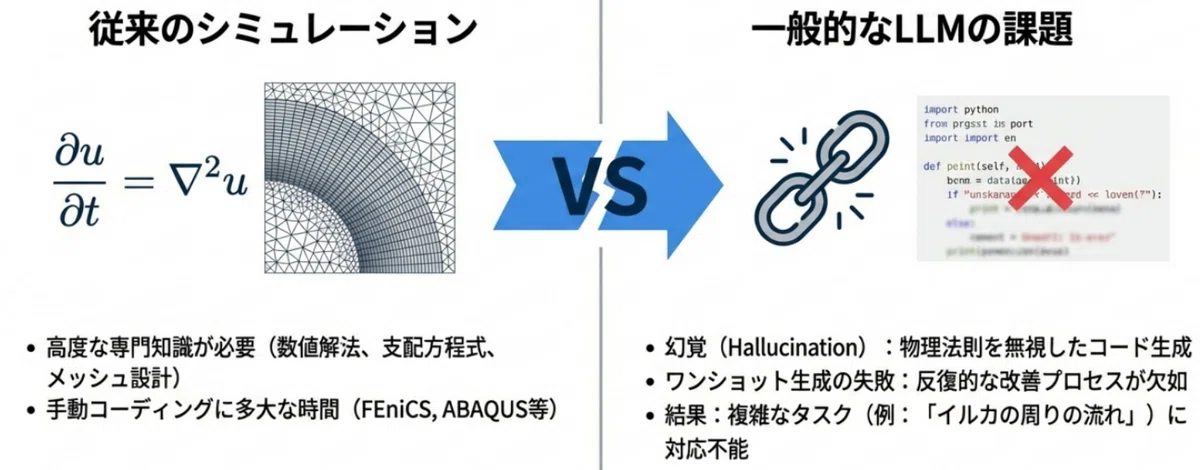
LLMには高度な専門知識がかけているばかりではなく、物理法則を無視(ハルシネーション)したり、複雑な条件に対応できなかった。
ワンショット生成の限界: 従来のLLMによるコード生成は一回限りの出力(ワンショット)に頼る傾向があり、初期プロンプトが不明確な場合に失敗しやすい。
物理的知見の欠如: 物理的な境界条件、材料特性、支配方程式(PDE)の推論能力が不足しており、物理的に妥当な結果を得ることが困難である。
ドメイン特化型の制約: 既存のマルチエージェント・システムの中には、弾性問題など特定のドメインに限定され、手動の修正を必要とするものが多い。
--------------------------------------------------------------------------------
2. MCP-SIMのアーキテクチャ
MCP-SIMは、「メモリ中心のオーケストレーター(Memory-Centric Orchestrator)」によって統制された6つの専門エージェントで構成される。
6つの専門エージェント
入力明確化エージェント(Input Clarifier Agent): 曖昧なユーザープロンプトから、ドメイン、ジオメトリ、支配方程式(PDE)、境界条件などの必須詳細を推論し、構造化されたJSON形式に変換する。
コード構築エージェント(Code Builder Agent): 推論された仕様を、物理学に基づいたヒューリスティクスを用いて、実行可能なPython/FEniCSコードに翻訳する。
シミュレーション実行エージェント(Simulation Executor Agent): サンドボックス環境でコードを実行し、実行ログの監視に加え、物理的な不整合(保存則の違反や発散など)を検知する。
エラー診断エージェント(Error Diagnosis Agent): 失敗したシミュレーションを物理的な用語で解釈し、メッシュ解像度の調整やソルバーパラメータの変更など、具体的な修正案を提案する。
入力書き換えエージェント(Input Rewriter Agent): 問題がプロンプトの根本的な曖昧さに起因する場合、診断結果に基づき初期指示を論理的に再構成する。
物理的洞察エージェント(Mechanical Insight Agent): 成功したシミュレーションに対し、その物理的原理、PDEの要約、コードの注釈を含む多言語レポートを生成する。
共有メモリによる継続的改善
中央のオーケストレーターは、プロンプトの履歴、コードのバージョン、実行ログ、適用された修正をすべて永続的な共有メモリに記録する。これにより、過去の失敗を繰り返す(退行)のを防ぎ、効率的な収束を実現する。
2-1.エキスパートを模倣した推論プロセス 計画、実行、省察、修正の自律的に収束するループ
エキスパート(熟練した専門家)の推論プロセスを模倣した、「計画 (Plan) → 実行 (Act) → 省察 (Reflect) → 修正 (Revise)」という自律的に収束するループは、物理シミュレーションのような専門知識が必要なタスクにおいて、LLM(大規模言語モデル)が単発の回答(One-shot)では失敗しやすいという課題を解決するために設計されました。
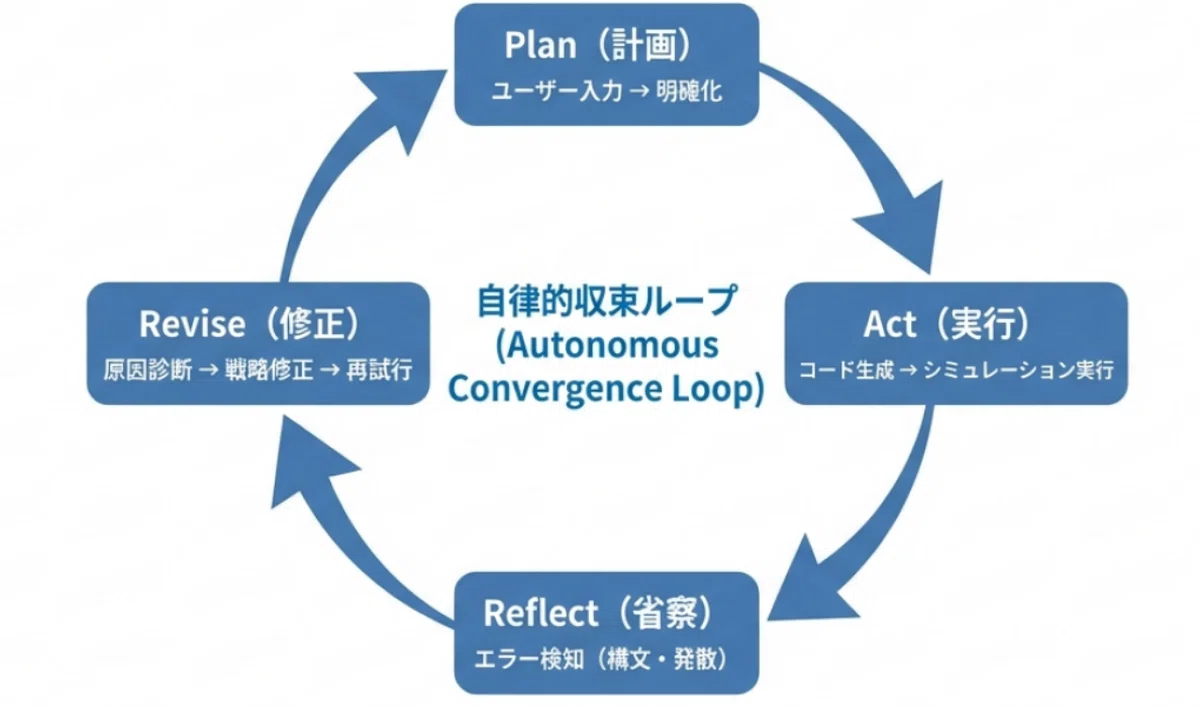
1. 推論プロセスの4段階ループ
このフレームワークは、以下の4つのフェーズを繰り返すことで、曖昧な指示からでも正確なシミュレーション結果を導き出します。
計画 (Plan): 「Input Clarifier Agent」が、ユーザーの曖昧または不完全な自然言語のプロンプトを受け取り、必要な物理パラメーター(支配方程式、境界条件、材料特性など)を推論・補完して、具体的なシミュレーションの仕様を作成します。
実行 (Act): 「Code Builder Agent」が仕様をPythonコード(FEniCSなどを使用)に変換し、「Simulation Executor Agent」がそのコードをサンドボックス環境で実行します。
省察 (Reflect): 実行中にエラーや物理的な矛盾(解の非収束や不自然な振動など)が発生した場合、「Error Diagnosis Agent」が起動します。このエージェントは失敗を「メッシュ解像度の不足」や「ソルバーの不一致」といった物理的・数値的な観点から解釈します。
修正 (Revise): 省察に基づき、「Input Rewriter Agent」がプロンプトを修正したり、診断エージェントが修正案を提示したりすることで、ループの最初に戻り、より精度の高い実行を試みます。
2. 自律的に収束させるための鍵:共有メモリ
このループが効率的に、かつ確実に「収束(成功)」するために最も重要なのが「永続的な共有メモリ (Persistent Shared Memory)」 の存在です。
履歴の活用: 各エージェントは、過去の試行錯誤(どのコードが失敗し、どの修正を試みたか)をメモリに記録し、それを参照します。これにより、同じ間違いを繰り返すことを防ぎ、最短経路での解決を可能にします。
自律的な改善: 人間の介入なしに、システム自身が物理的な収束基準(無次元残差が$${10^{-4}}$$未満など)を満たすまでループを回し続けます。
3. エキスパート模倣の成果
この「計画・実行・省察・修正」のループを実装した「MCP-SIM」は、以下のような成果を上げています。
高い成功率: 従来の単発的なコード生成手法では解決が困難だった複雑な物理問題(熱電供給、圧電変形、破壊力学など)を含む12のベンチマークタスクすべてを解決しました。
収束の効率性: 多くのタスクにおいて、**5回以内のループで成功(収束)**に到達しています。
透明性と説明責任: 単に結果を出すだけでなく、「Mechanical Insight Agent」がプロセスの物理的論理を多言語でレポート化し、なぜそのモデルを選択したのかをユーザーに教育的に説明します。
2-2. 入力の明確化と正準化
MCP-SIMフレームワークにおいて、入力明確化エージェント(Input Clarifier Agent) は、ユーザーからの曖昧な指示を、シミュレーション可能な厳密な仕様へと変換する重要な役割を担っています。
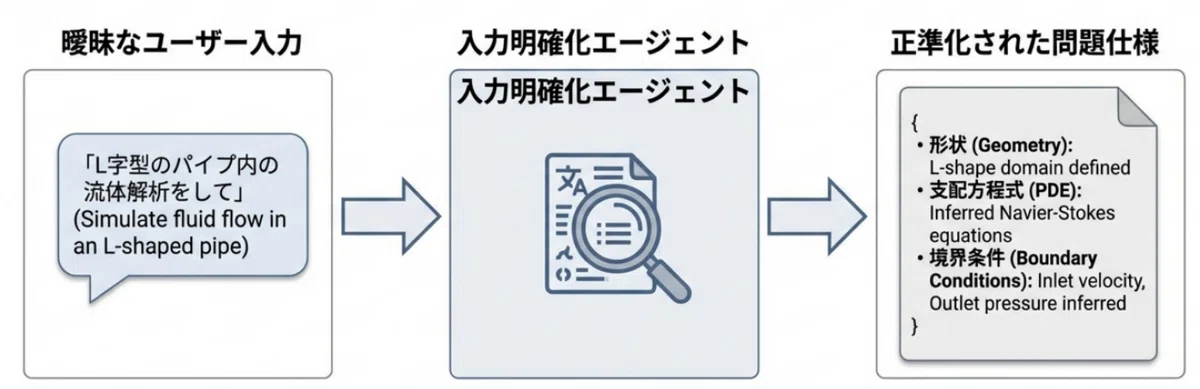
1. 入力の明確化 (Clarification)
ユーザーが自然言語で入力するプロンプトは、多くの場合、物理的な詳細が不足しています。入力明確化エージェントは、ドメイン知識と言語理解能力を用いて、以下の不足情報を推論・補完します。
支配方程式の特定: 例えば「L字型のパイプ内の流体の流れ」という指示から、ナビエ・ストークス方程式などの適切な偏微分方程式(PDE)を推論します。
境界条件の推論: 入口速度、出口圧力、壁面の条件など、シミュレーションの実行に必要な境界条件を特定します,。
材料特性とパラメーター: 熱伝導率や弾性係数など、ユーザーが明示していない物理定数を推論します,。
計算領域の形状: 指示された形状(例:円孔のある正方形領域)に基づいて、幾何学的な詳細を定義します,。
2. 入力の正準化 (Canonicalization)
推論された情報は、後続のプロセスで利用しやすいように正準化(標準的な形式への構造化) されます。エージェントは以下の2つの形式でデータを出力します,。
正準パラグラフ (Canonical Paragraph): ユーザーの曖昧なプロンプトを、物理的に厳密で完全な自然言語の記述に書き換えたものです。これは、システムがどのように問題を解釈したかを明確にするための「標準的な問題仕様」として機能します。
構造化JSONオブジェクト (Structured JSON): 内部のパース(解析)モジュールを通じて、コード生成エージェントが直接読み取れる形式に出力を変換します,。このJSONには、PDEの種類、変数の定義、境界条件の数値設定などが含まれます。
3. システム内での役割と記憶への蓄積
正準化された仕様は、永続的な共有メモリ(Persistent Shared Memory) に「正準問題仕様」として保存されます。
後続エージェントへの橋渡し: 構造化されたJSONデータは、コード作成エージェント(Code Builder Agent)に渡され、FEniCSなどのソルバー用Pythonコードに変換されます,。
反復的な修正: もし実行段階でエラーが発生し、その原因が初期の仕様の曖昧さにあると判断された場合、入力書き換えエージェント(Input Rewriter Agent)がヒントを出して、この入力明確化のステップからやり直すことで、精度を高めていきます,。
このように、入力明確化エージェントは、人間の直感的な言葉と、コンピューターの厳密な計算コードの間の「翻訳者」および「推論者」 として機能し、専門家のような推論プロセスを実現しています。
2-3. 物理法則を考慮したコード生成
MCP-SIMフレームワークにおけるコード構築エージェント(Code Builder Agent) は、明確化された物理問題の仕様を、実際に実行可能なシミュレーションコード(Python)へと変換する役割を担います。
このエージェントが、どのように物理法則や数値計算の専門知識を考慮してコードを生成するのか、その主要なメカニズムについて説明します。
1. 物理法則を反映したプロンプトテンプレート
コード構築エージェントは、単にコードを書くのではなく、物理法則を考慮したヒューリスティクス(経験則)を組み込んだプロンプトテンプレートを使用します。これには以下の役割があります。
モデリングの意思決定: 物理的・数値的なコンテキストに基づいて、メッシュの細分化、ソルバーの設定、安定性の制御などの判断を下します。
物理的整合性の維持: 支配方程式、境界条件、材料特性など、入力明確化エージェントから渡された「正準問題仕様(JSON形式)」を、正確な数学的表現(弱形式など)に変換します。
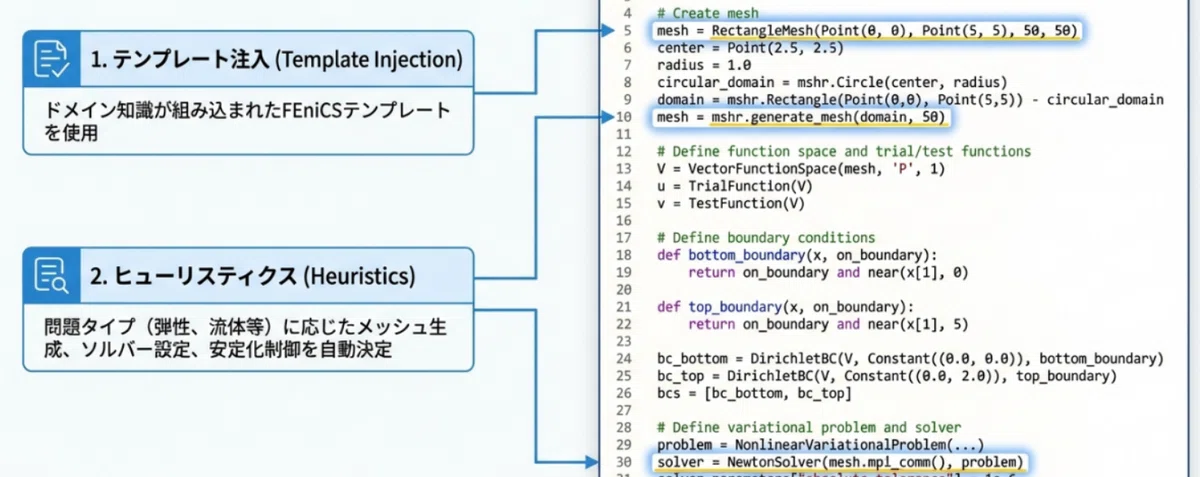
2. 数値シミュレーションライブラリ(FEniCS)の活用
生成されるコードは、有限要素法(FEM)を用いて偏微分方程式(PDE)を解くためのオープンソースプラットフォームであるFEniCSに基づいています,。コード生成時には以下の要素が具体的に構築されます。
メッシュ生成: 幾何学的形状に適したメッシュを作成します。
関数空間の定義: 物理量(変位、温度、圧力など)を計算するための適切な関数空間を設定します。
弱形式の組み立て: 物理的な支配方程式を、有限要素法で解くための「弱形式(Variational form)」として記述します。
非線形ソルバーの実行: 複雑なマルチフィジックスや非線形問題に対しても、適切なソルバーを構成します。
3. 反復的な修正と学習(自律的なループ)
コード構築エージェントは単発の生成で終わらず、「計画・実行・省察・修正」のループの中で動作します。
エラー診断との連携: もし実行エージェントが「解の非収束」や「物理的な矛盾」を検知した場合、エラー診断エージェントがその原因を物理的な言葉(例:メッシュ解像度の不足、ソルバーの不一致)で解釈します。
履歴に基づく改善: コード構築エージェントは、共有メモリに記録された過去の試行錯誤(失敗したコードや診断ヒント)を参照し、同じ間違いを避けながら、より物理的に妥当なコードへと修正を行います。
このように、コード構築エージェントは、物理学のドメイン知識をテンプレートとして持ち、実行結果から学習・修正するプロセスを通じて、専門家レベルのシミュレーションコード作成を実現しています。
2-4. エラー診断と自己修正
MCP-SIMフレームワークにおいて、エラー診断エージェント (Error Diagnosis Agent) と 入力書き換えエージェント (Input Rewriter Agent) は、システムの「省察 (Reflect)」と「修正 (Revise)」のフェーズを担い、人間が介入することなく自律的にシミュレーションを成功へ導く鍵となります。
1. エラー診断エージェントによる「物理的・数値的診断」
シミュレーションの実行中にエラー(構文エラー、ソルバーの非収束、物理的な矛盾など)が発生すると、エラー診断エージェントが起動します。このエージェントの最大の特徴は、失敗を単なるプログラムのバグとしてではなく、「物理的な意味」を持つ問題として解釈する点にあります。
異常の検知: 実行エージェントが監視している物理的指標(保存則の違反、残差の発散、不自然な振動など)に基づき、モデリングや離散化の問題を特定します。
物理的な解釈: 失敗の原因を「メッシュ解像度の不足」や「ソルバーの設定ミス」といった専門的な観点から分析します。
解決策の提示: メッシュ密度の調整、タイムステップの削減、ソルバーパラメーターの変更など、物理的知識に基づいた具体的な修正案(ヒント) を構造化された形式で生成し、他のエージェントに伝達します。
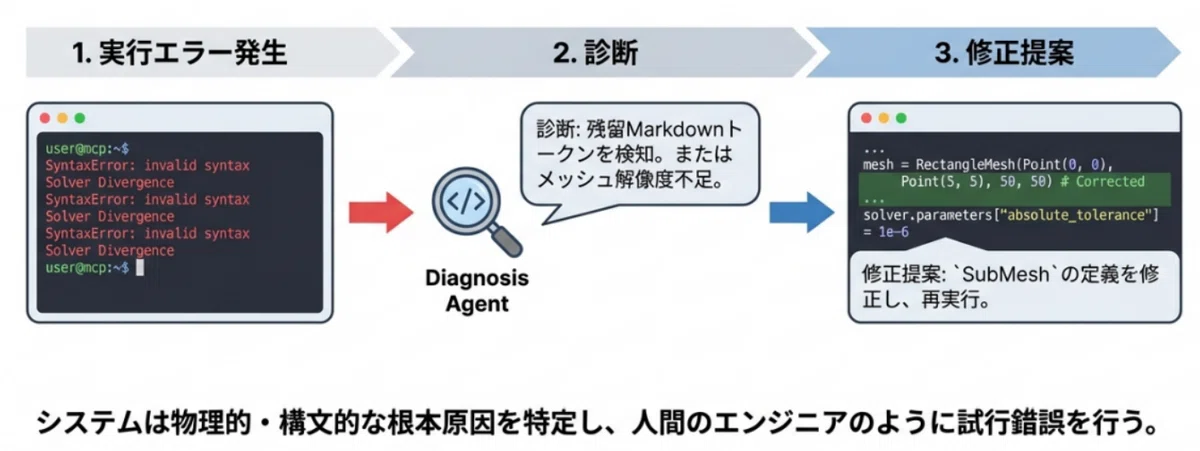
2. 入力書き換えエージェントによる「意味的修正」
エラー診断エージェントが「問題の根本がユーザープロンプトの曖昧さにある」と判断した場合、入力書き換えエージェントが機能します。
プロンプトの再構成: 診断結果や過去の実行履歴に基づき、元の指示を意味的に書き換えます,。例えば、「メッシュ解像度 = 64」といった具体的な数値条件を命令に付加することで、曖昧さを排除します。
ループの再スタート: 修正された指示は、再び最初の「計画(入力明確化)」フェーズへと送られ、より精度の高いシミュレーションの再構築が試みられます。
3. 自己修正を支える「共有メモリ」と「反復プロセス」
これら2つのエージェントによる自己修正が効果的に機能する理由は、「永続的な共有メモリ (Persistent Shared Memory)」 にあります,。
履歴の活用: メモリには、過去のプロンプト履歴、問題の明確化、コードのバージョン、実行ログ、適用された修正内容がすべて記録されています,。診断エージェントと書き換えエージェントは、この履歴を参照することで、同じ間違いを繰り返すことを避け、複数の修正案を統合して1ステップで適用することができます,。
自律的な収束: この「計画→実行→省察→修正」のループを繰り返すことで、MCP-SIMは複雑な非線形破壊力学のような難易度の高いタスク(Level 12)においても、10回程度の修正サイクルを経てABAQUSなどの専門ツールに匹敵する正確な結果を導き出すことに成功しています,。
このように、単にコードを書き直すだけでなく、エラーを物理的に診断し、必要に応じて問題の設定そのものを書き換えるという推論プロセスが、このフレームワークの自律性を支えています。
2-5. なぜマルチエージェントシステムが必要だったのか
物理シミュレーションにおいて、なぜ単一のLLMではなくマルチエージェントシステム(MCP-SIM)が必要だったのか、3つの切り口から簡潔に説明します。
結論として、これら複数の役割を分担し、記憶を共有しながら協調動作させることで初めて、AIは人間のエキスパートのように「不完全な指示からでも正解に辿り着く」自律性を獲得しています。
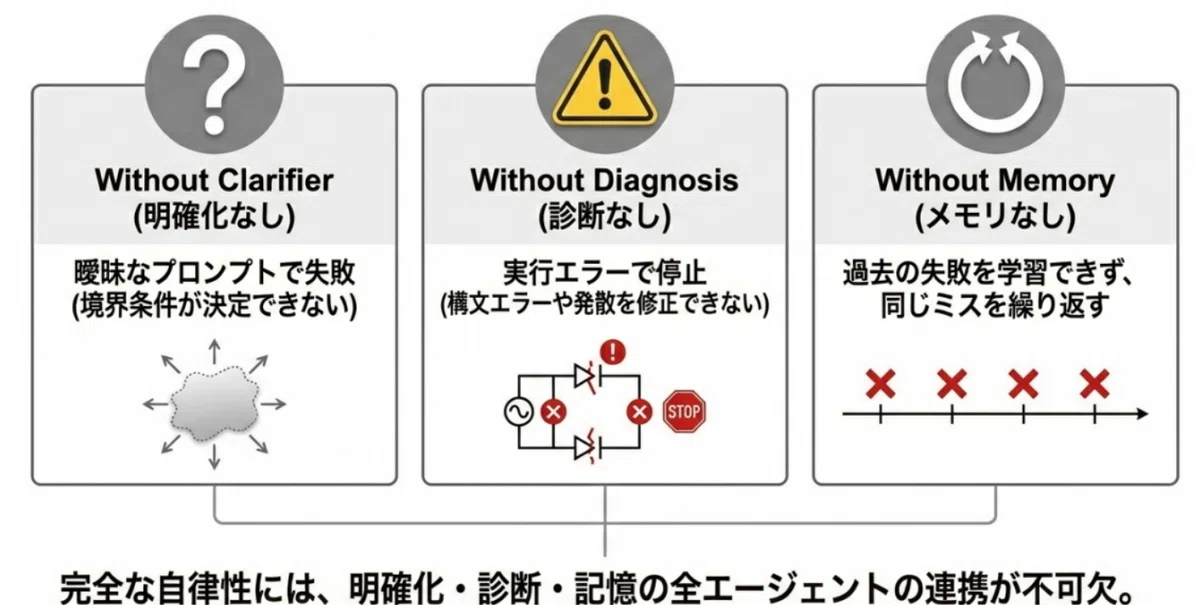
1. 明確化プロセスがない場合
ユーザーの入力は多くの場合、支配方程式、境界条件、材料特性といったシミュレーションに必要な仕様が曖昧または不完全です。
問題点: 明確化プロセスがない「単発(One-shot)」の生成では、不足している情報を推論できず、実行不可能なコードや物理的に誤った設定が生成され、多くのタスクで失敗します,。
必要性: 専門エージェントが物理的知見に基づき、足りないパラメーターを補完・正準化することで、初めて厳密な計算が可能な状態になります。
2. 診断プロセスがない場合
シミュレーションの実行には、コードの文法エラーだけでなく、数値的な非収束や物理的な矛盾といった特有の失敗が伴います。
問題点: 診断プロセスがないと、失敗を単なるエラーとしてしか認識できず、「メッシュ解像度の不足」や「ソルバーの不一致」といった物理的な原因を特定できません。その結果、有効な修正案を導き出せず、解決に至りません。
必要性: 診断エージェントが物理的観点からエラーを解釈し、具体的な修正のヒントを生成することで、自律的な自己修正が可能になります。
3. 永続的な共有メモリがない場合
複雑な問題の解決には、試行錯誤のプロセス(計画・実行・省察・修正)の繰り返しが不可欠です,。
問題点: 共有メモリがない場合、各エージェントは「過去にどのコードで失敗し、どう修正を試みたか」という履歴を活用できません。これにより、同じ間違いを繰り返す(退行) や、冗長な計算が発生し、効率的な収束が困難になります。
必要性: 共有メモリにすべての履歴を蓄積することで、エージェント間で一貫した意思決定を行い、多くのタスクで5回以内のループという高い効率で成功(収束)に導くことができます。
--------------------------------------------------------------------------------
3. ベンチマーク評価
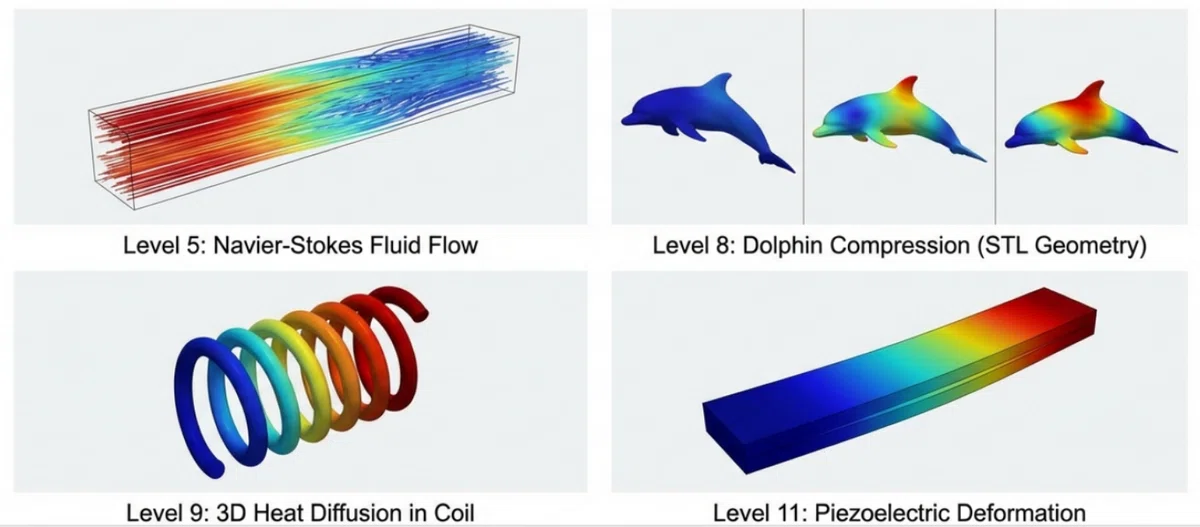
システムを評価するため、単純な線形弾性から複雑なマルチフィジックスまで、12段階の難易度(Level 1〜12)にわたるタスクが設定された。
主な物理領域:
パフォーマンス比較
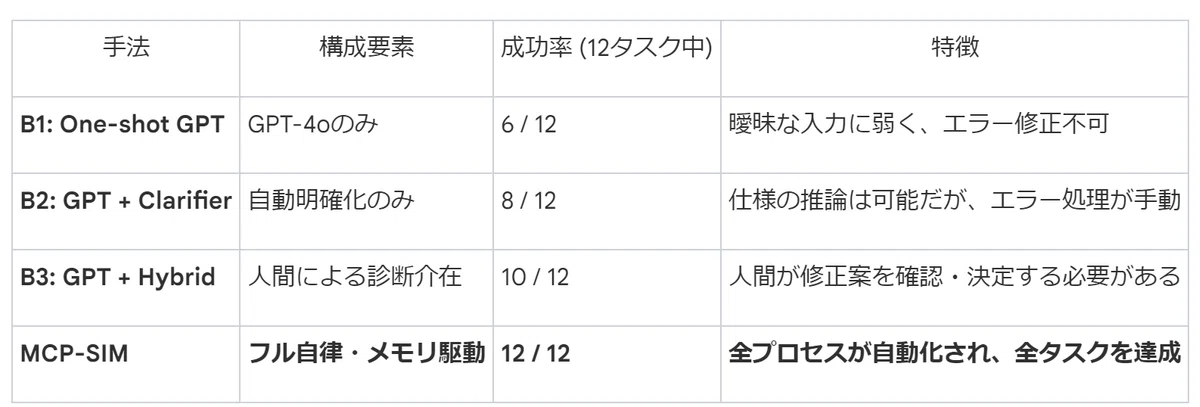
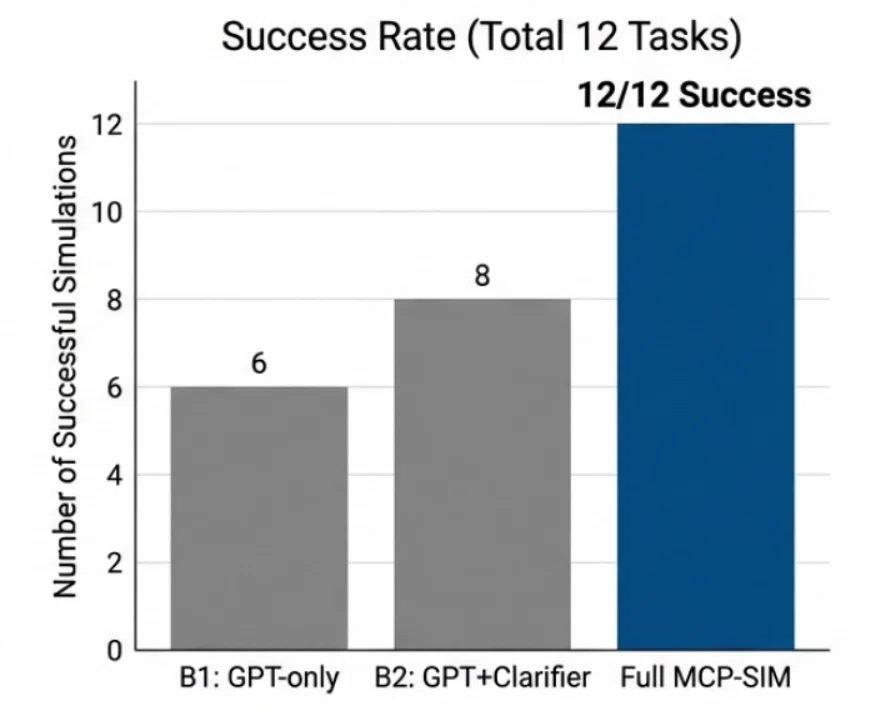
収束効率と数値的精度
反復回数: 大半のタスクで5回以内の反復(Plan→Act→Reflect→Revise)で成功。
数値的収束: すべてのシミュレーションにおいて、無次元残差が10^{-4}以下という厳格な収束基準を達成し、物理的に妥当な場(Field)の分布を確認した。
--------------------------------------------------------------------------------
4. 高度な応用事例:フェーズフィールド破壊シミュレーション(Level 12)
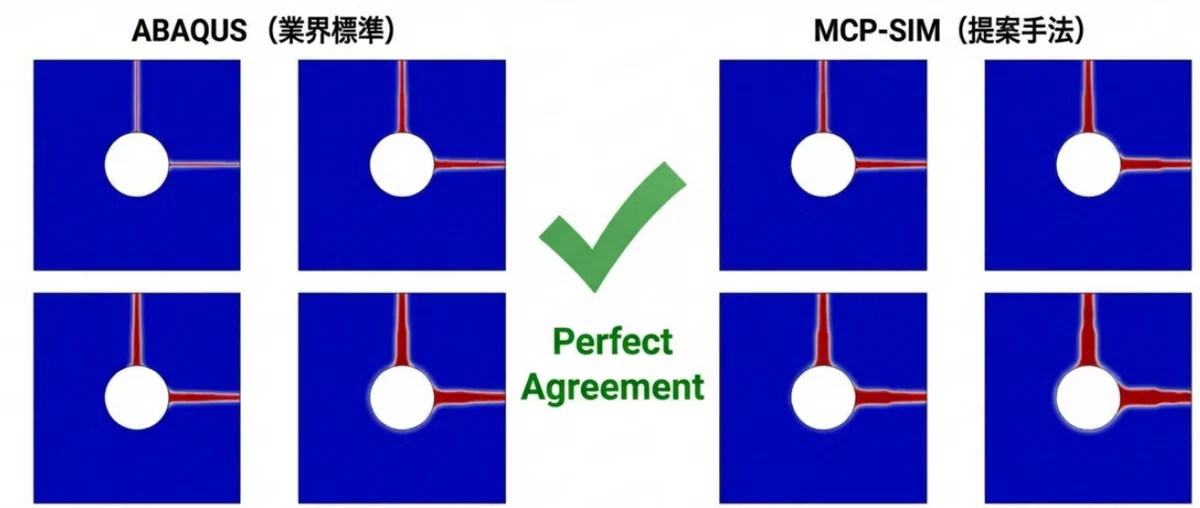
ベンチマークで最も困難なLevel 12では、「中央に円形の穴がある正方形領域での亀裂進展をシミュレートせよ」という、数値、方程式、境界条件を一切含まない一文のプロンプトから開始された。
推論プロセス: MCP-SIMは、この課題に「フェーズフィールド破壊モデル」が適していると自律的に判断。材料定数、ソルバーパラメータ、境界条件(底部固定、上部5%変位)を独自に設定した。
検証結果: 10回の自己修正サイクルの後、生成されたシミュレーション結果は、専門的な商用ソルバーであるABAQUSの結果と、亀裂の発生場所および成長方向において極めて高い一致を示した。
--------------------------------------------------------------------------------
5. 教育・工学的価値
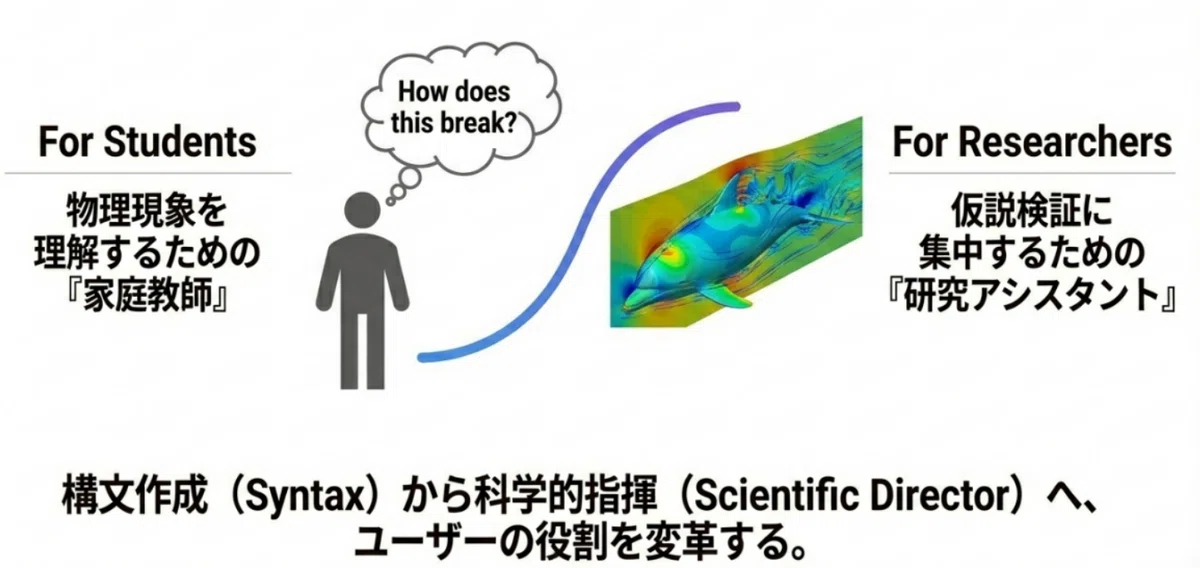
MCP-SIMは単なる計算機ではなく、「自律的な科学助手」として設計されている。
解釈可能性の提供: ブラックボックス的な出力ではなく、なぜその境界条件が選ばれたのか、使用されたPDE(支配方程式)の意味は何かを、学生向けに分かりやすく解説する。
多言語サポート: 日本語を含む多言語でのレポート生成機能により、言語の壁を超えてシミュレーション学習を支援する。
透明性と再現性: すべての推論ステップと中間成果物がメモリに記録されており、プロセスの追跡が可能である。
--------------------------------------------------------------------------------
6. 結論と将来の展望
MCP-SIMは、LLMを単なる「コード生成器」から、思考し、学習し、教えることができる「能動的な物理モデリングの参加者」へと進化させた。
現在の制限事項
汎用LLM(GPT-4o)に依存しているため、極めて稀な材料モデルや高度なマルチフィジックス結合において性能が低下する可能性がある。
特殊な状況では、ファインチューニングが必要になることもある。
反復プロセスにより、ワンショット生成よりも計算レイテンシが発生する。
バックエンドプロセス(ソルバー)が、現状はFEniCSに限定されている。
今後の方向性
ドメイン特化型の基盤モデルの統合や、シンボリック物理エンジンの導入、高性能計算(HPC)環境への最適化
リアルタイム処理への最適化
他のソルバーへの拡張
リアルな実験データとの照合/検証機能の統合
これにより、MCP-SIMは将来的に、AIと人間が共同でモデルを設計し、科学的発見を加速させるプラットフォームの基盤となることが期待される。科学的発見における人間の役割も変わってくるかもしれない。
#PhysicsSimulation : Could be more naturally expressed as #物理シミュレーション
#NaturalLanguageProcessing : Should be #自然言語処理
#MachineLearning : Could be #機械学習
#DeepLearning : Could be #深層学習
#ArtificialIntelligence : Should be #人工知能
#Education : Could be #教育
#Engineering : Could be #工学
#CodeGeneration : Consider #コード生成
#ReportGeneration : Could be #レポート作成
#SelfCorrecting : A more natural term might be #自己修正 or #自動修正 , depending on the nuance.
#AIAssistant : Could be #AIアシスタント
