【塩漬け放出】重み更新なしで学習するAI? ICRLが変えたアプリ開発の常識(2025年12月振り返り)
【塩漬け放出】重み更新なしで学習するAI? ICRLが変えたアプリ開発の常識(2025年12月振り返り)
こんにちは、makokonです。
年末恒例の「塩漬け記事放出」シリーズです。今回は、今年の初め(2025年1月)に公開され、その後のAIエージェント開発の流れを決定づけた論文 "RL + Transformer = A General-Purpose Problem Solver" についての解説記事を、書きかけのまま放置していたので、現在の視点で大幅にリライトして公開します。
当時は「トランスフォーマーが強化学習アルゴリズムそのものになる」という衝撃的な内容でしたが、今振り返ると、これが現在の 「適応型AIエージェント」 の基礎石だったことがよく分かります。
論文の概要:RL + Transformer
論文: RL + Transformer = A General-Purpose Problem Solver (arXiv:2501.14176)
この論文の主張を一言で言えば、「トランスフォーマーモデルは、追加の学習(重み更新)なしで、プロンプト内の履歴だけを見て強化学習を行える」 というものです。
これを ICRL (In-Context Reinforcement Learning) と呼びます。
アプリケーション開発者にとっての意味
我々開発者にとって、従来のAI開発は以下のようなフローでした。
データを集める
モデルを学習(Fine-tuning)させる
アプリに組み込む
しかし、この論文が示したのは、「推論時のコンテキスト(履歴)さえあれば、AIはその場で賢くなる」 という可能性です。ユーザーごとの好みに合わせたり、刻々と変わる環境に対応するために、いちいち再学習サーバーを回す必要がないのです。
仕組みをイメージで理解する
従来の強化学習(DQNなど)と、ICRLの違いを直感的な図にしてみました。
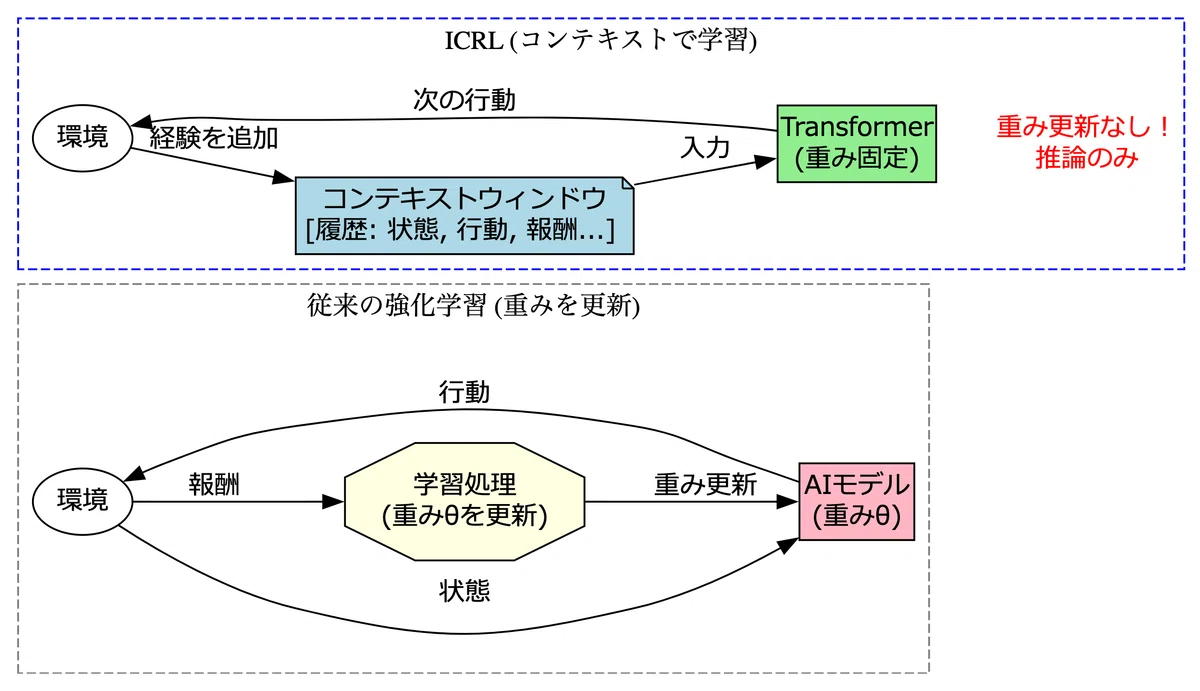
ICRLでは、AIモデルの脳みそ(重み)は固定されたままです。その代わり、「短期記憶(コンテキストウィンドウ)」 に成功や失敗の体験談がどんどん書き込まれていきます。トランスフォーマーは、このメモ帳を見て「あ、さっきこのパターンで失敗したから、次はこっちに行こう」と判断します。
これが 「モデルが強化学習アルゴリズムそのものをシミュレートしている」 状態です。
Python風擬似コードで見る実装イメージ
開発者向けに、コードのロジックで表現してみましょう。
class ICRL_Agent:
    def __init__(self, model):
        self.model = model  # Llama 3.1 8Bなど(重みは固定!)
        self.context_buffer = [] # 履歴を保持するリスト

    def decide_action(self, current_state):
        # 今までの履歴と現在の状態をプロンプトとして構築
        prompt = self.create_prompt(self.context_buffer, current_state)

        # モデルは履歴全体を見て、次に取るべき最適な行動を予測
        # ここで「過去の失敗」や「成功パターン」が参照される
        action = self.model.predict(prompt)
        return action

    def learn_from_experience(self, state, action, reward, next_state):
        # 重み更新(backpropagation)は行わない!
        # 単にコンテキストに経験を追記するだけ
        experience = {
            "state": state,
            "action": action,
            "reward": reward
        }
        self.context_buffer.append(experience)

        # コンテキストがいっぱいになったら古いものから捨てるなどの管理が必要
        self.manage_context_window()

# メインループ
agent = ICRL_Agent(pretrained_transformer)
env = GameEnvironment("FrozenLake")

for episode in range(100):
    state = env.reset()
    done = False
    while not done:
        action = agent.decide_action(state)
        next_state, reward, done = env.step(action)

        # 重み学習ではなく「体験の記録」こそが学習
        agent.learn_from_experience(state, action, reward, next_state)
        state = next_state
このコードのポイントは、`learn_from_experience` メソッド内で `optimizer.step()` のような重み更新処理が一切ないことです。履歴リスト(`context_buffer`)への `append` が、実質的な学習になっています。
論文が示した3つのすごい能力
論文中の実験(Frozen Lakeゲーム)から、特筆すべき3つの能力を紹介します。
1. 未知の環境への汎化能力
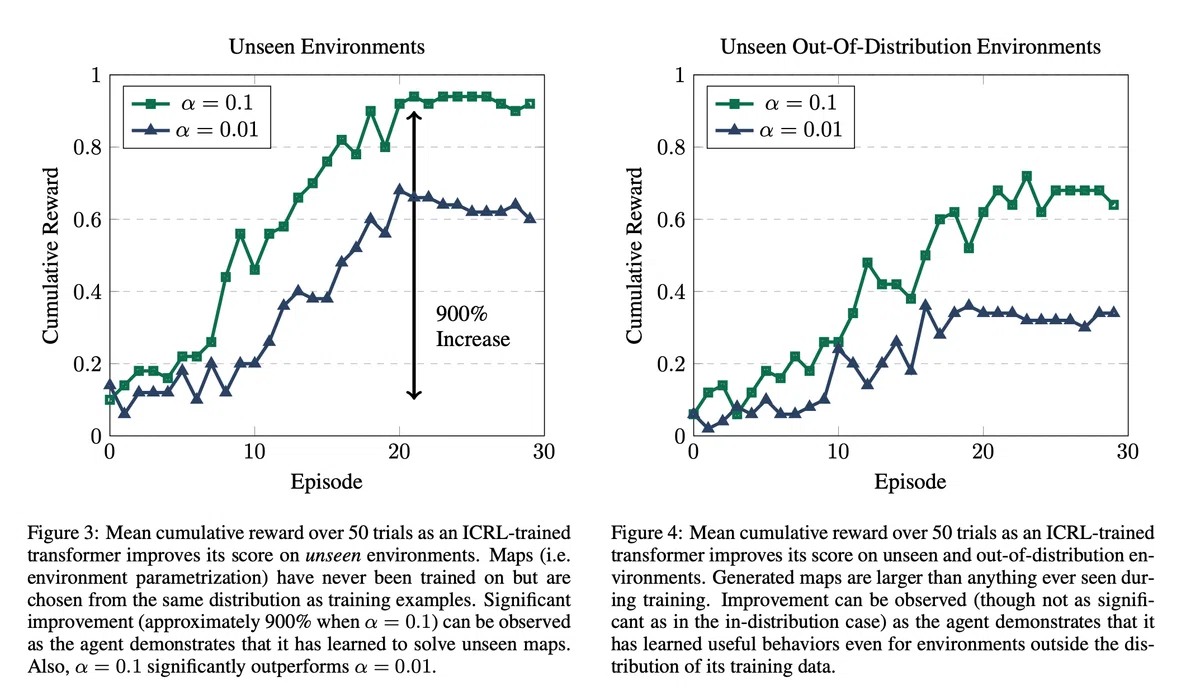
訓練データにはない新しいマップ(迷路)に放り込まれても、最初は失敗しますが、エピソードを重ねるごとにコンテキストに情報が蓄積され、急速に正解ルートを見つけ出します。
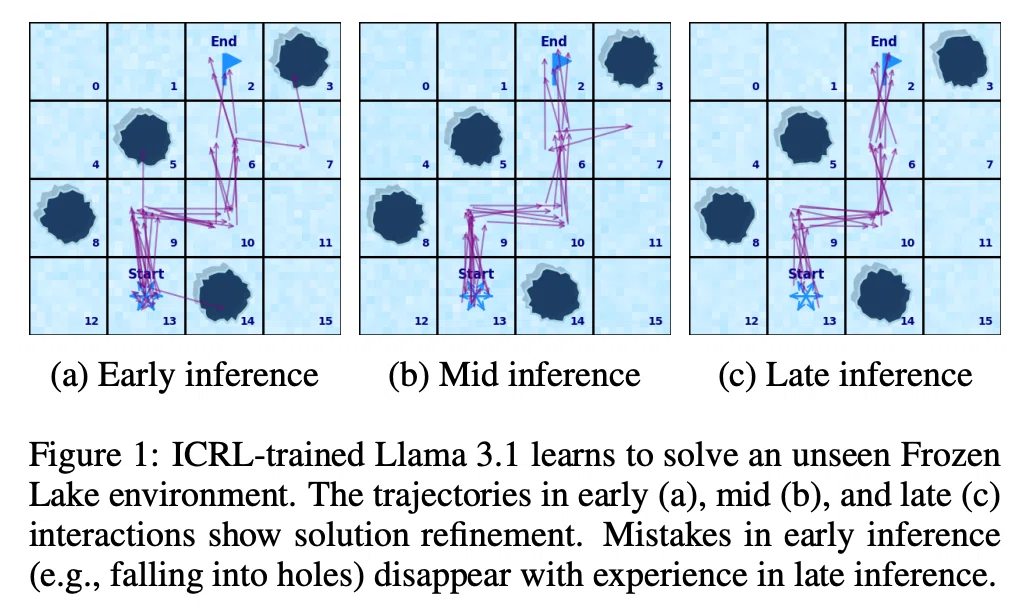
論文の図表では、初期(Early Inference) には穴に落ちてばかりいたエージェントが、後期(Late Inference) にはスイスイとゴールする様子が示されています。
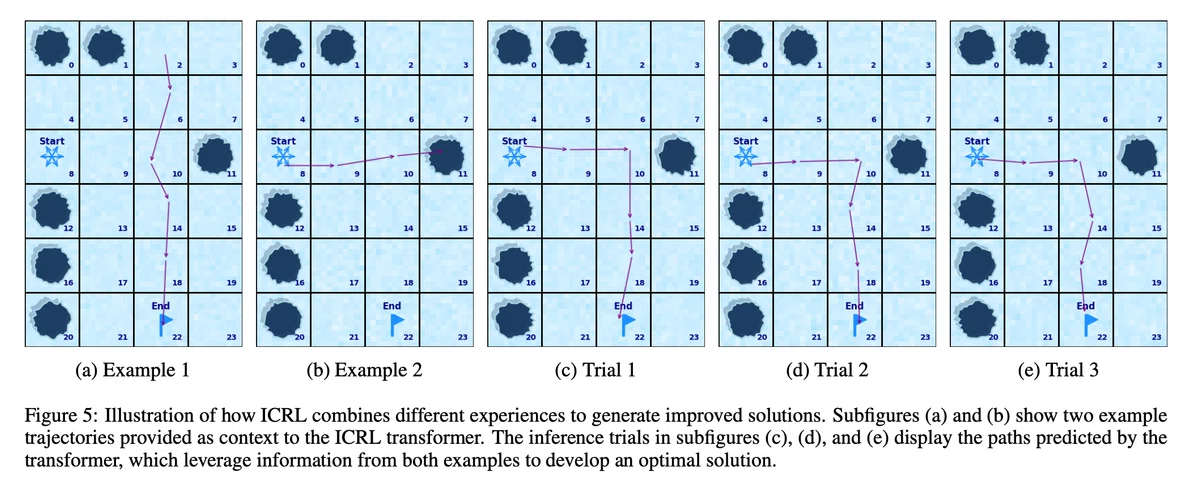
2. Behavior Stitching(行動のつぎはぎ)
これが最も面白い点です。
体験A:「ここを通ったら穴に落ちた」
体験B:「あっちの道は行き止まりだった」
体験C:「この角までは安全に行けた」
これらバラバラの失敗体験(サブオプティマルなデータ)をコンテキストに入れるだけで、トランスフォーマーはそれらを脳内で結合(Stitch)し、「一度も通ったことのない正解ルート」 を導き出しました。
これは動的計画法のような推論を内部で行っていることを示唆しています。
3. 質の悪いデータでも大丈夫
「名人」のプレイデータばかりを見せる必要はありません。下手なプレイ、失敗ばかりのプレイの履歴を見せても、モデルは「何をしたらダメか」を学習し、適切な行動を選択できました。これにより、データ収集のコストが大幅に下がります。
2025年12月の視点からの再評価
さて、論文公開から約1年が経った現在(2025年12月)、この技術はどのように評価されているでしょうか?
「再学習」から「ロングコンテキスト活用」へのシフト
2025年のトレンドは、まさにこの論文が予見した通りに進みました。
以前は、特定のタスクに特化させるためにLoRAなどの軽量ファインチューニングが必須と思われていました。しかし、コンテキストウィンドウが数百万トークンに拡大した現在、「マニュアルや過去の成功事例を全部プロンプトに入れる」 だけで、モデルがその場のタスクに適応するスタイルが定着しました。
エージェント開発の標準実装へ
現在の自律型AIエージェントフレームワークでは、このICRLの考え方が標準実装されています。
短期記憶: そのセッション内での試行錯誤(ICRL的な適応)
長期記憶: 成功したパターンのデータベース化(RAG)
この2つを組み合わせることで、ユーザーが「設定」をいじらなくても、使えば使うほど手に馴染むツールが実現されています。
結論:アプリ開発者が今すべきこと
トランスフォーマーモデルを単なる「チャットボット」や「文章生成機」として見るのはもう古いです。
この論文が示したように、トランスフォーマーは 「履歴というデータセットを与えれば、即座に最適解を導き出す汎用ソルバー」 です。
アプリケーションを設計する際は、以下の点を意識してみてください。
モデルを育てるな、履歴を育てろ: モデルの再学習にコストをかけるより、良質な「文脈(ログ)」をどうモデルに食わせるかに注力する。
失敗もまた糧: エラーログやユーザーの離脱履歴も、AIにとっては「何を避けるべきか」の重要な教師データになります。隠さずにコンテキストに含めましょう。
1年前の「塩漬け」論文ですが、今読み直しても、いや今だからこそ、その本質的な価値が輝いて見えます。AIアプリ開発のヒントになれば幸いです。
ハッシュタグ
#ArtificialIntelligence #MachineLearning #ReinforcementLearning #Transformer #InContextLearning #AIModel #AIApplication #TechTrends2025 #AIエージェント #開発者向け
付録1:パラメトリックゲーム「Frozen Lake」と実験用プロンプト
論文で実験台として使われた「Frozen Lake(凍った湖)」ゲームは、AIの強化学習のベンチマークとして非常に有名なパズルです。
読者の皆様がお手持ちのLLM(ChatGPTやClaudeなど)で、「履歴から学習して行動を変える」様子を擬似的に試せるプロンプトを用意しました。
ゲームのルール
プレイヤーは、氷の張った湖(グリッドマップ)の上をスタートからゴールまで歩きます。
S (Start): 出発点。
G (Goal): 目標地点。ここに到達すると報酬 1.0 を獲得してゲームクリア。
F (Frozen): 凍った地面。安全に歩けます。
H (Hole): 穴。落ちるとゲームオーバー(報酬 0.0)。
アクション: 上(Up)、下(Down)、左(Left)、右(Right) の4方向。
特徴: マップの形や穴の位置は毎回変わります(パラメトリック)。プレイヤーはマップの全体像を知らされず、「今いる場所の番号」 だけを頼りに、手探りで地図を頭の中に描いていく必要があります。
【コピペで試せる】ICRL体験プロンプト
LLMに、「過去の失敗経験」をコンテキストとして与え、そこから学習して正解ルートを導き出せるかテストするプロンプトです。
以下のテキストをそのままチャットAIに入力してみてください。
プロンプトのポイント:
前半で「穴に落ちた失敗ルート」を提示しています。
AIはそれを読んで、「タイル5とタイル7は危険だ」と学習し、別のルート(タイル4→8...)を選択できるかが試されます。
あなたは強化学習を行うAIエージェントです。
以下の「Frozen Lake」ゲームのログを分析し、最適な次の行動を決定してください。

## ゲーム環境の定義
- 状態(State): 0から15までのタイル番号で現在地が示されます。
- 行動(Action): Up, Down, Left, Right のいずれか。
- 報酬(Reward): ゴール到達=1.0、それ以外=0.0(穴に落ちたら終了)。
- マップ構造(あなたには見えていませんが、以下のようになっています):
  [ 0,  1,  2,  3]
  [ 4,  5(H),  6,  7(H)]
  [ 8,  9, 10, 11]
  [12, 13, 14, 15(G)]
  ※(H)は穴、(G)はゴール。0がスタート。

## 過去の経験(コンテキスト)
以下は、あなたがこのマップで試行錯誤した履歴です。

[エピソード1: 失敗]
State: 0 -> Action: Right -> Reward: 0.0 -> Next State: 1
State: 1 -> Action: Right -> Reward: 0.0 -> Next State: 2
State: 2 -> Action: Down -> Reward: 0.0 -> Next State: 6
State: 6 -> Action: Left -> Reward: 0.0 -> Next State: 5 (穴に落下!GAME OVER)

[エピソード2: 失敗]
State: 0 -> Action: Down -> Reward: 0.0 -> Next State: 4
State: 4 -> Action: Right -> Reward: 0.0 -> Next State: 5 (穴に落下!GAME OVER)

[エピソード3: 失敗]
State: 0 -> Action: Right -> Reward: 0.0 -> Next State: 1
State: 1 -> Action: Down -> Reward: 0.0 -> Next State: 5 (穴に落下!GAME OVER)

[エピソード4: 失敗]
State: 0 -> Action: Right -> Reward: 0.0 -> Next State: 1
State: 1 -> Action: Right -> Reward: 0.0 -> Next State: 2
State: 2 -> Action: Right -> Reward: 0.0 -> Next State: 3
State: 3 -> Action: Down -> Reward: 0.0 -> Next State: 7 (穴に落下!GAME OVER)

---

## 現在の状況(エピソード5)
あなたは今、スタート地点(State 0)から移動して、以下の場所にいます。
現在の状態: State 4

## 質問
これまでの失敗経験(特にエピソード2での State 4 での失敗)を踏まえると、次に取るべき最適な行動は "Up", "Down", "Left", "Right" のうちどれですか?
理由とともに回答してください。
期待される回答
エピソード2で「State 4 から Right に移動して State 5(穴)に落ちた」という記録があるため、賢いモデルなら 「Right(右)」を避けます。
State 4(左端)なので、Leftは壁です。Upはスタートに戻ります。
したがって、未知の領域である 「Down(下)」 を探索しようとするのが、強化学習エージェントとして筋の良い判断となります。
図表:
論文中には、Frozen Lakeの具体的なマップの例は示されていませんが、図1に、ICRLで訓練されたLlama 3.1モデルが、未知のFrozen Lake環境を解決する様子が示されています。この図は、初期の推論(a)、中間の推論(b)、そして後半の推論(c)のそれぞれの段階におけるエージェントの軌跡を示しており、経験を重ねるごとにエージェントが解決策を洗練させていく様子を表しています。
また、図3と図4は、ICRLで訓練されたトランスフォーマーが、未知の環境(訓練データと同じ分布と異なる分布)でどのように報酬を改善していくかを示しています。
これらの図から、エージェントが学習と適応を通じて、未経験の環境でもより高い報酬を得られるようになることがわかります。
図5は、ICRLが、異なる経験から得られた行動を組み合わせて、より良い解決策を生み出す様子を表しています。
まとめると、Frozen Lakeは、シンプルなルールでありながら、強化学習アルゴリズムの性能を評価するための効果的な環境です。この論文では、この環境を利用して、ICRLで訓練されたトランスフォーマーモデルが、さまざまな環境に適応し、問題を解決する能力を検証しています。