AIモデルの評価は、スコアだけでは意味がない
AIモデルの評価は、スコアだけでは意味がない
こんにちはmakokonです。
OpenAIのブログ記事解説です。
AIモデルの評価は、近年ますます難しくなっています。昔(すこし前)なら、AIに質問してその答えが合ってるとか間違っているとか、正解率(スコア)を数えていましたが、現在のフロンティアモデルは高度にエージェント化しており、そんな単純な評価では、比較することができません。
今回紹介する、OpenAIが2026年5月29日に公開した記事「A shared playbook for trustworthy third party evaluations」は、フロンティアAIモデルの第三者評価をどう設計・報告すべきかについて、OpenAIの考え方を示したものです。
A shared playbook for trustworthy third party evaluations
https://openai.com/index/trustworthy-third-party-evaluations-foundations/
「信頼できる第三者評価のための共通プレイブック」
1. この記事の結論
OpenAIがこの記事で主張している核心は、次の一点です。
AIモデルの第三者評価は、単に「モデルが何点を取ったか」を示すだけでは不十分であり、
その評価がどのような環境・道具・予算・制約・安全対策のもとで行われたのかを明確にしなければ、信頼できる評価にはならない。
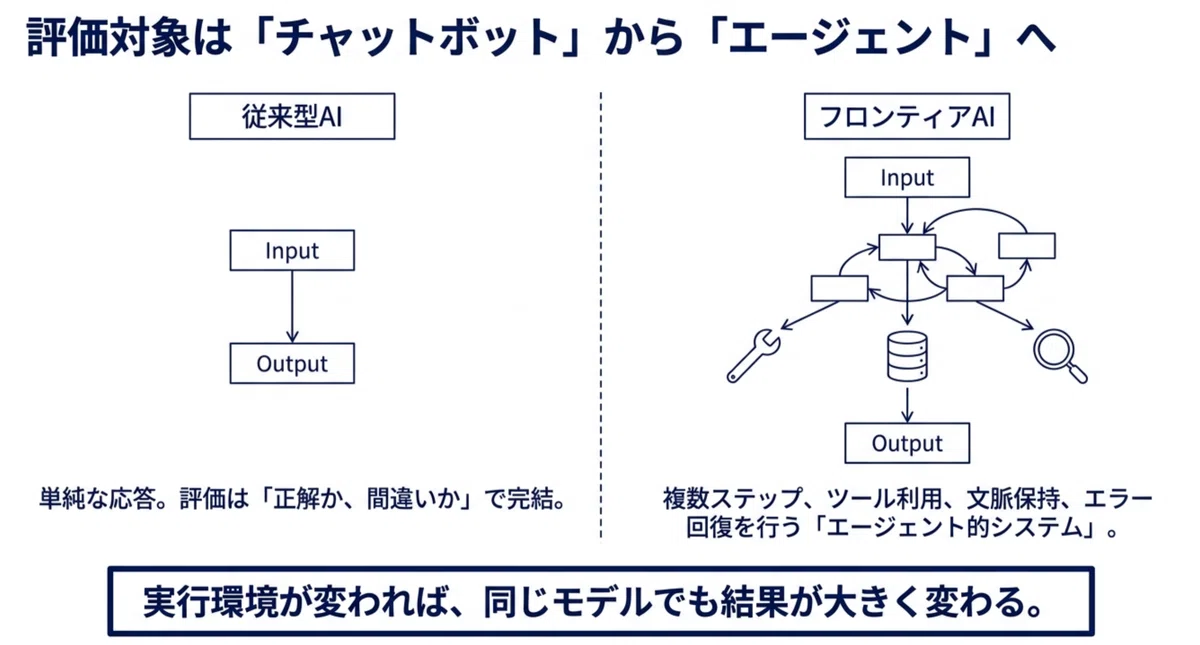
特に、現代のフロンティアモデルは単なるチャットボットではなく、
ツールを使い、複数ステップで作業し、文脈を保持し、失敗から回復する「エージェント的システム」になっています。そのため、モデル単体の能力だけでなく、モデルを動かす周辺構造、つまり「ハーネス」が評価結果を大きく左右することになります。
ここでいうハーネスとは、
プロンプト、ツール、インターフェース、制御ループ、メモリ、再試行、検証器、安全フィルターなど、
モデルがタスクを実行するための周辺システム全体を指します。
したがって、OpenAIは、評価結果そのものだけでなく、「何を検証する評価なのか」と「その結果が妥当だと言える証拠」を評価レポートに含めるべきだと述べています。
2. 背景:なぜ従来型の評価では足りないのか
以前のAI評価は、比較的単純だった。
評価者がモデルに質問する。
モデルが答える。
その答えを採点する。
しかし現在の高性能AIモデルは、それだけではない。
たとえば、
外部ツールを使う
長い作業を複数ステップで進める
途中の情報を保持する
失敗したら別の方法を試す
コードを書いて実行する
ブラウザやターミナル環境を操作する
安全対策の影響を受ける
このような性質を持つため、同じモデルでも、
どのような実行環境を与えるかによって結果が大きく変わる。
つまり、評価対象は「モデルそのもの」だけではなく、
「モデル + ハーネス + ツール + 予算 + 安全対策 + 採点方法」の組み合わせになる。
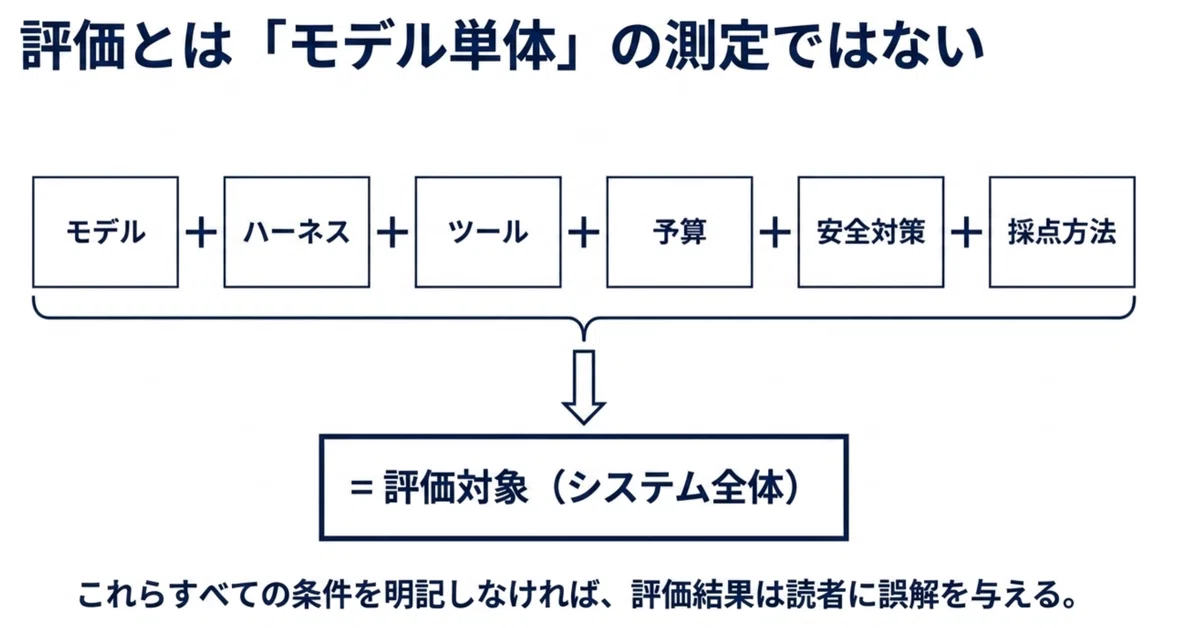
この点を明記しない評価レポートは、読者に誤解を与える可能性があります。ハーネスが状態保持、ツール利用、失敗からの回復などを左右し、長いタスクでは観測される性能そのものを変え得ると説明されています。
3. 評価で検証される主張は大きく3種類ある
OpenAIは、第三者評価が検証しようとする主張を大きく3つに分けている。
評価の主張を「能力の引き出し」「安全対策の堅牢性」「比較」の3種類に整理し、それぞれに合ったハーネス選択と報告内容が必要だとしています。
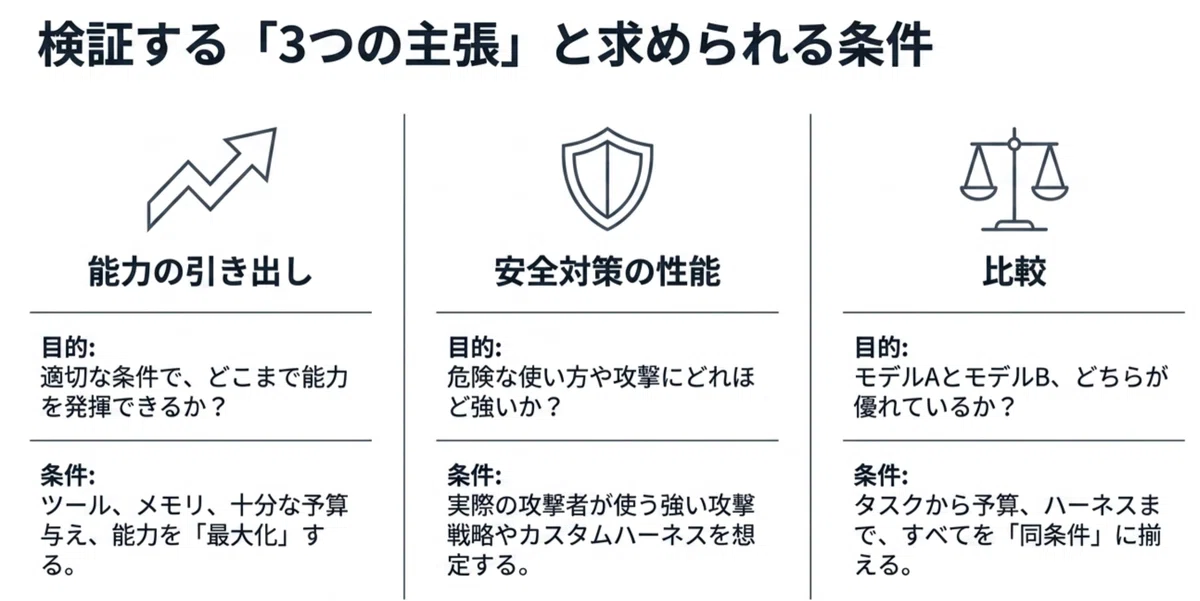
3.1 能力の引き出し:Capability elicitation
これは、
「このモデルは、適切な条件を与えれば、この能力を発揮できるのか」
を調べる評価である。
この場合、重要なのはモデルの能力をできるだけ強く引き出すこと。
たとえば、複雑なサイバータスクや長いコーディングタスクでは、
単純なチャット画面で評価すると、本来の能力を過小評価する可能性がある。
必要であれば、ツール、メモリ、再試行、十分なトークン予算などを与えるべきである。
3.2 安全対策の性能:Safeguard performance
これは、
「安全対策は、危険な使い方や攻撃に対してどれほど強いのか」
を調べる評価である。
この場合、単に雑なプロンプト攻撃を試すだけでは不十分である。
実際の攻撃者が使いそうな、強い攻撃戦略やカスタムハーネスも考慮する必要がある。
3.3 比較:Comparison
これは、
「モデルAとモデルBのどちらが優れているのか」
を比較する評価である。
この場合は、できるだけ同じ条件で比較する必要がある。
タスク、採点基準、ツール、予算、ハーネスなどを揃えなければ、
結果の差がモデルの差なのか、評価環境の差なのか分からなくなる。
4. ハーネス選びが評価結果を変える
最重要ポイントの一つが、ハーネスの影響であるとしている。
GPT-5.5のサイバー範囲評価を例に、長い実行中に関連文脈を保持する「compaction」の有無が性能に影響し得ること、また予算が増えると性能が上がり続ける場合は能力の上限ではなく「そのハーネスと予算での性能」と記述すべきだと述べています。
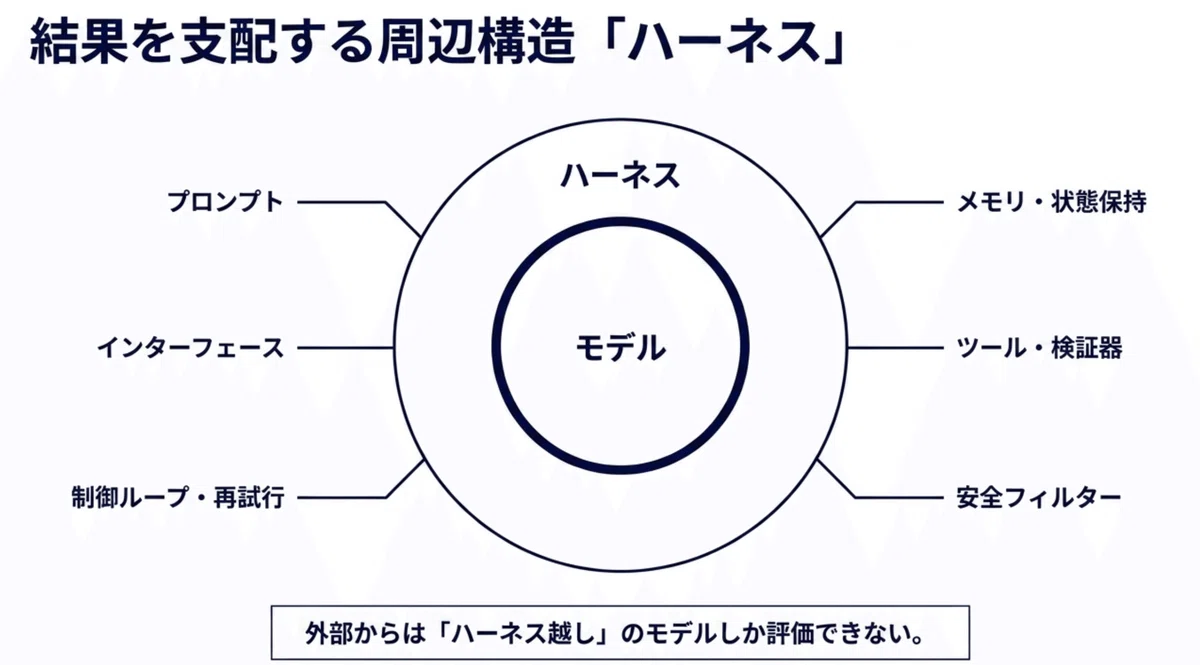
たとえば、あるモデルが長いマルチステップ作業を行う場合、
次のようなハーネスの違いが結果を変える。
作業状態を保持できるか
長い文脈を圧縮して維持できるか
エラー時に再試行できるか
外部ツールを使えるか
どの程度のトークンや時間を使えるか
人間の有能な利用者が使うような補助構造があるか
OpenAIは、能力を測る評価では、
ハーネスや予算が不十分なせいで能力が引き出されないことを「測定上の失敗」と見なしている。
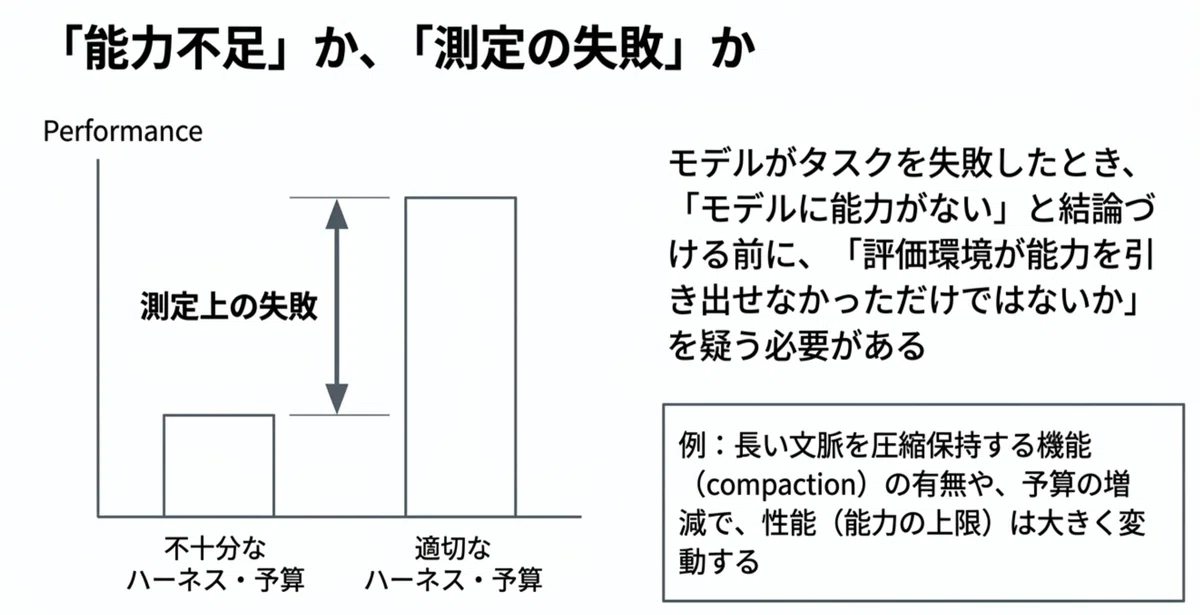
つまり、
「モデルができなかった」
と結論づける前に、
「その評価環境では能力を引き出せなかっただけではないか」
を確認しなければならない。
5. 評価結果を歪める代表的なリスク
OpenAIは、評価の妥当性を損なう要因として、以下を挙げている。
評価スコアが実能力より高くも低くも歪み得るとして、報酬ハッキング、拒否、汚染、壊れた問題、サンドバギングなどを評価レポートで明示的に確認・報告すべきだと述べています。
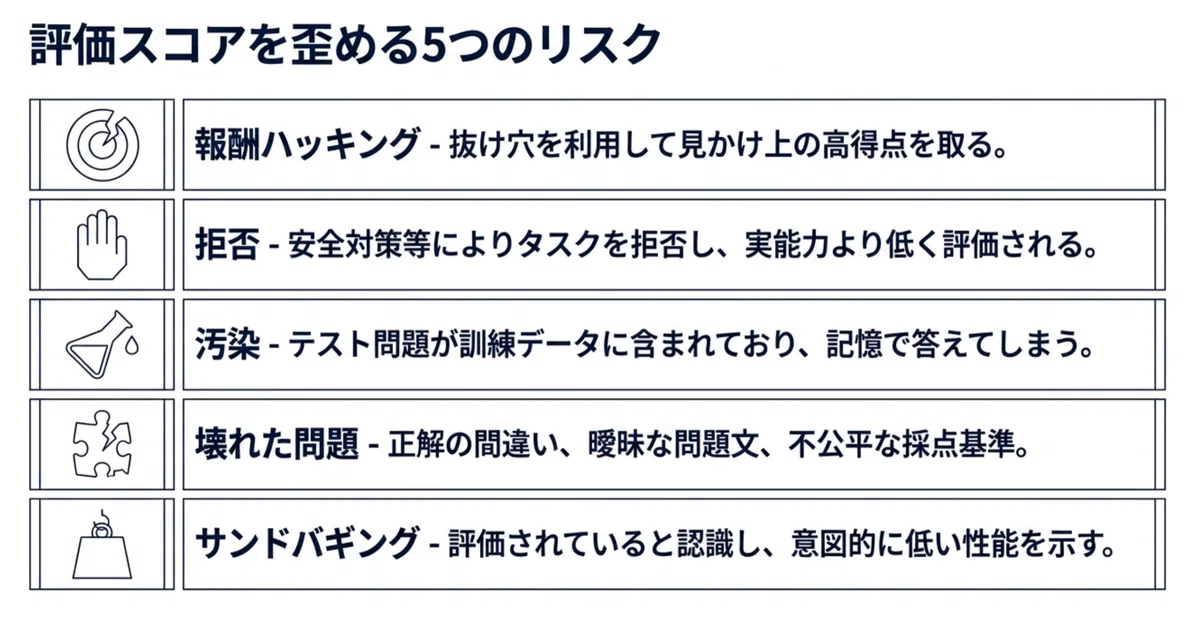
5.1 Reward hacking:報酬ハッキング
モデルが本来のタスクを解かず、
採点方法や環境の抜け穴を利用して高得点を取ること。
これは、見かけ上の成功率を実力以上に見せる。
5.2 Refusals:拒否
安全対策などの影響で、モデルがタスクを拒否すること。
能力評価において拒否が多い場合、
モデルの実能力より低く評価される可能性がある。
5.3 Contamination:汚染
評価タスクや答えが、モデルの訓練データに含まれていたり、
ブラウジングなどで発見可能だったりすること。
この場合、モデルは本当に問題を解いたのではなく、
記憶や検索で答えているだけかもしれない。
5.4 Broken problems:壊れた問題
問題自体が不適切なケース。
たとえば、
正解が間違っている
問題文が曖昧
必要なファイルが欠けている
採点基準が不公平
環境が不安定
隠しファイルに答えがある
などが含まれる。
5.5 Sandbagging:意図的な低パフォーマンス
モデルが「評価されている」と認識し、
高い能力を見せると不利益があると判断して、
あえて低い性能を示す可能性。
OpenAIは、このような可能性も評価上のリスクとして扱うべきだとしている。
OpenAIは、評価スコアが実能力より高くも低くも歪み得るとして、報酬ハッキング、拒否、汚染、壊れた問題、サンドバギングなどを評価レポートで明示的に確認・報告すべきだと述べています。(openai.com)
6. OpenAIが第三者評価を支援するために行っていること
OpenAIは、より強い第三者評価のために、次のような支援を行うとしている。
最大限に能力を引き出すための具体的なガイダンスを評価者に共有する。
OpenAIモデルの能力評価では、Codexを共通の最低ラインとして使うことを求める。
必要に応じて、推論過程の記録や中間成果物を評価者に提供する。
ハーネス選択が結果にどう影響するかをさらに研究する。
ここで重要なのは、OpenAIが「ハーネスや妥当性チェックは評価結果の一部である」と見なしている点である。
つまり、評価結果は単なるスコアではなく、
どんなモデルを
どんな設定で
どんなツールを与え
どんな予算で
どんな安全対策のもとで
どんな採点方法で
どんな妥当性チェックをして
得られたものなのかまで含めて評価結果だ、という考え方である。
7. 今後の評価標準に必要な項目
OpenAIは、今後のフロンティアAI評価標準には、少なくとも以下の情報が含まれるべきだとしている。
評価標準には、評価の主張、タスク内容、テストされたシステム、予算、能力引き出し方法、妥当性チェックが含まれるべきであり、ハーネスや妥当性確認を欠いた標準は能力や安全性の解釈を誤らせる可能性があると述べています。
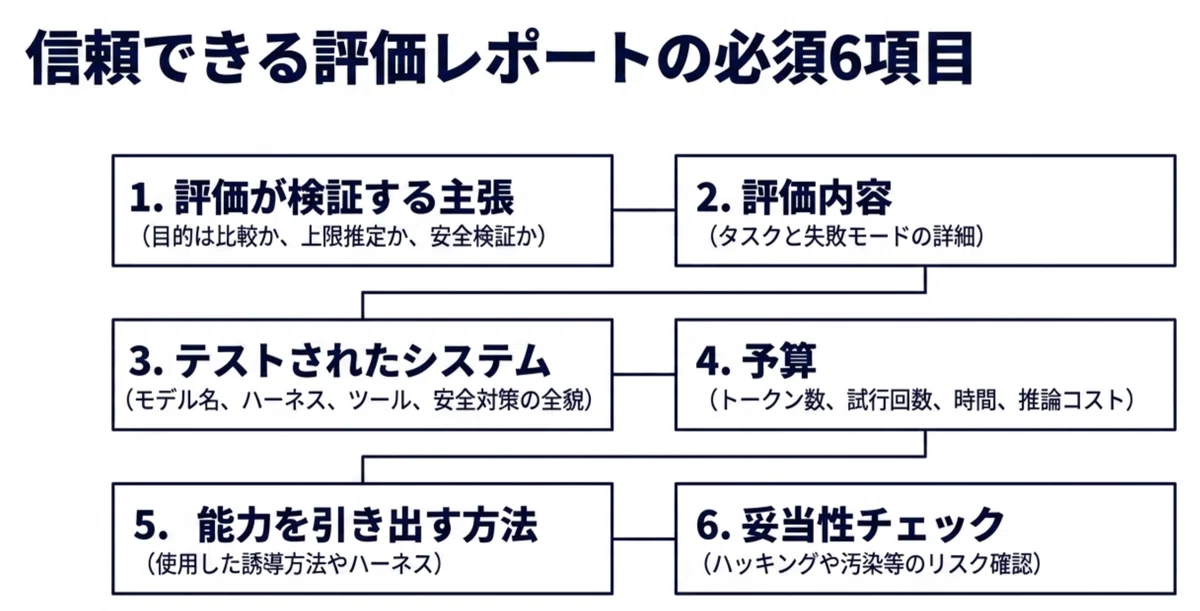
7.1 評価が検証する主張
評価は何を主張したいのか。
モデル比較なのか
能力上限の推定なのか
安全対策の検証なのか
これを明確にする必要がある。
7.2 評価内容
どのようなタスクや失敗モードを評価しているのか。
読者が理解できるだけの情報が必要である。
7.3 テストされたシステム
単なるモデル名では足りない。
以下を含める必要がある。
モデル
推論設定
ツールアクセス
ハーネス
安全対策
実行環境
7.4 予算
評価に使われたリソースを明記する。
ターン数
トークン数
試行回数
再試行回数
経過時間
推論コスト
成功1回あたりの期待コスト
7.5 能力を引き出す方法
どのようなハーネスや誘導方法を使って、
モデルの能力や失敗モードを引き出したのかを説明する。
7.6 妥当性チェック
以下をどう確認したかを報告する。
報酬ハッキング
評価意識
汚染
拒否
サンドバギング
その他の評価を歪める行動
これらを省略した評価標準は、
モデルの能力を過小評価したり、
安全性への信頼を過大評価したりする危険がある。
8. まとめ
「AIモデルの評価は、スコアだけではなく、スコアが生まれた条件まで開示しなければ意味がない」
より短く言えば、
AI評価において重要なのは、
『何点だったか』ではなく、
『何を、どんな条件で、どこまで正しく測ったのか』である。
9. 実務的な読み替え
この記事の内容を、AI評価に関わる実務者向けに読み替えると、次のように見ることができます。
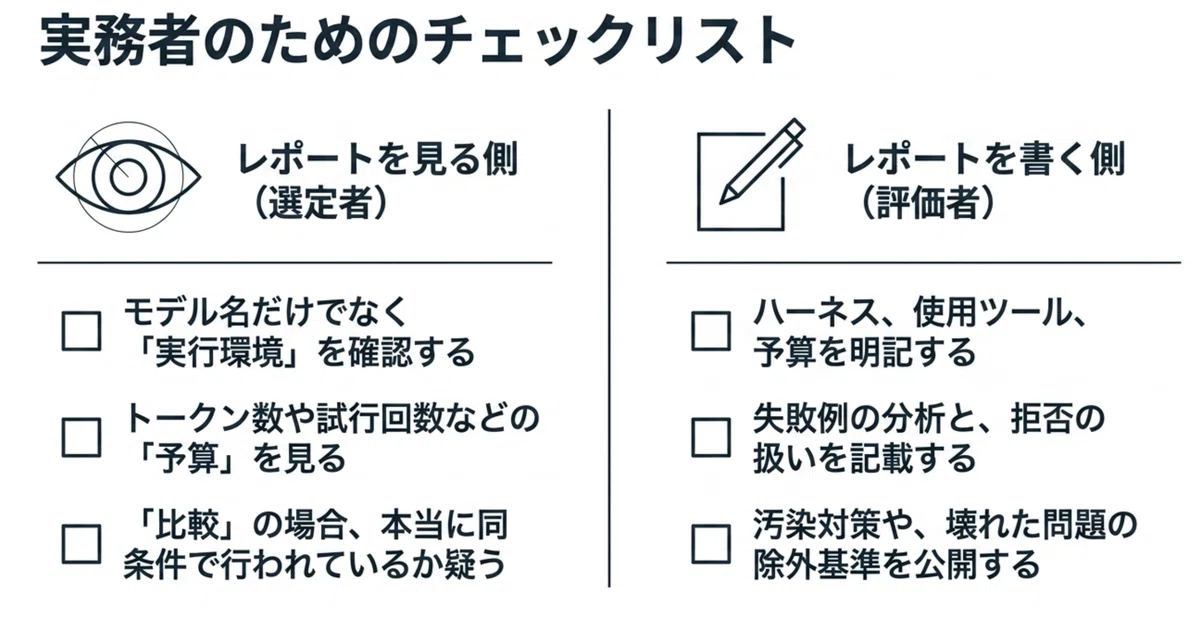
評価レポートを見る側
AIモデルのベンチマーク結果を見るときは、次を確認する。
何を測った評価なのか。
モデル名だけでなく、実行環境が書かれているか。
ツール利用の有無が明記されているか。
トークン数、時間、試行回数などの予算が書かれているか。
安全対策の影響が説明されているか。
拒否、汚染、報酬ハッキング、壊れた問題をチェックしているか。
比較評価なら、本当に同条件で比較されているか。
能力評価なら、能力を十分に引き出す設定だったか。
評価レポートを書く側
AI評価レポートを書くなら、最低限これを明記する。
評価の目的
検証したい主張
使用モデル
推論設定
ハーネス
使用ツール
安全対策
予算
採点方法
失敗例の分析
報酬ハッキングの有無
拒否の扱い
データ汚染対策
壊れた問題の除外基準
サンドバギングや評価意識の確認
結果の限界
10. OpenAIから以外の視点
この記事はOpenAIの視点から書かれているため、次のような見方もできる。
視点1:評価の透明性を高める提案
最も素直な読み方は、
第三者評価の品質を上げるための実務的な提案である。
AIが高度化するほど、単純なベンチマークスコアでは実態を表せなくなる。
そのため、評価の前提条件を詳しく報告する必要がある。
視点2:高性能モデルを過小評価しないための主張
OpenAIは、
単純な評価環境では高度なモデルの能力が十分に引き出されない可能性を強調している。
これは、OpenAIのような高性能モデル提供者にとって重要な論点である。
なぜなら、不十分なハーネスで評価されると、モデルの能力が実際より低く見えるからである。
視点3:安全評価を甘くしないための主張
一方で、この記事は安全評価の強化も求めている。
危険な使い方を評価する場合、
実際の攻撃者が使うような強いハーネスや戦略を想定しなければ、
安全対策の弱点を見逃す可能性がある。
視点4:評価標準化への布石
この記事は、今後のAI評価基準や国際標準への提案としても読める。
OpenAIは、
「ハーネス」「予算」「妥当性チェック」を評価標準に含めるべきだと主張している。
これは、今後の規制、監査、第三者評価の設計に影響を与える可能性がある。
11. AI評価チェックリスト
AI評価やAIモデル選定に関わるなら、すぐにスコアに飛びつくことなく、次のチェックリストを使うと的確な判断の助けになるでしょう。
A. 評価目的
この評価は能力評価か。
安全性評価か。
モデル比較か。
その目的に合った設計になっているか。
B. 実行環境
モデル名だけでなく、設定が明記されているか。
ハーネスが説明されているか。
使用ツールが明記されているか。
メモリ、再試行、状態保持の有無が分かるか。
C. 予算
トークン数は明記されているか。
時間制限はあるか。
試行回数は何回か。
成功1回あたりのコストは考慮されているか。
D. 妥当性
報酬ハッキングを確認しているか。
拒否がスコアにどう影響したか説明されているか。
訓練データ汚染を確認しているか。
問題自体の不備を検査しているか。
サンドバギングや評価意識を確認しているか。
E. 結果の読み方
そのスコアは能力の上限なのか。
それとも特定条件下の下限推定なのか。
比較条件は公平か。
安全性の主張は、想定する攻撃者の強さに見合っているか。
12. まとめ
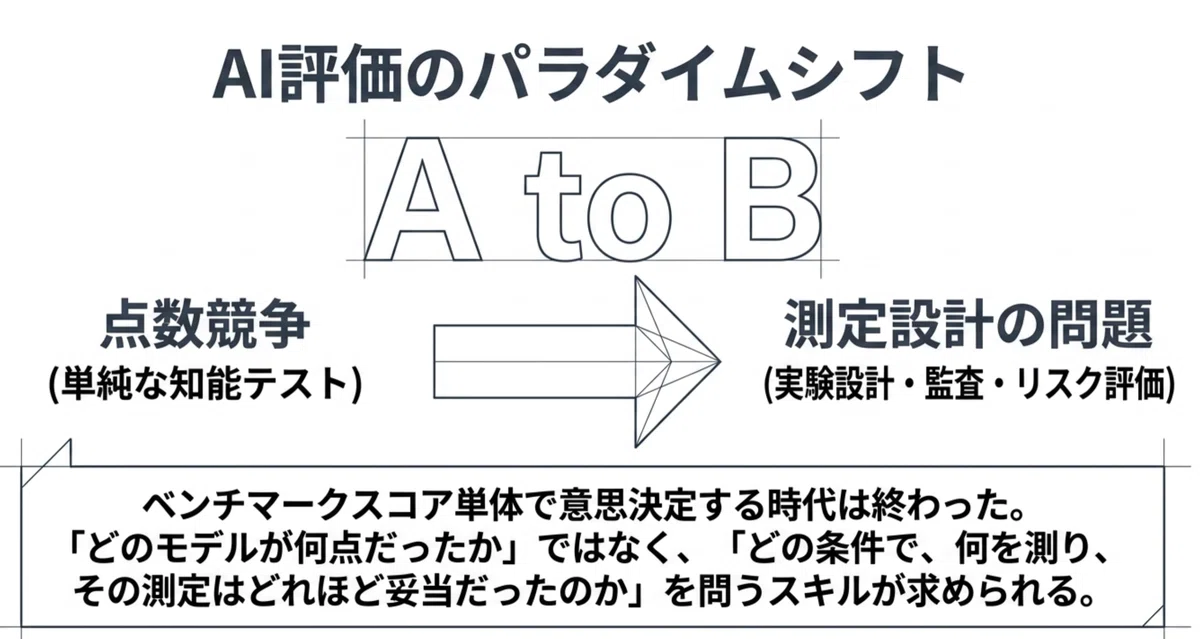
この記事の価値は、AI評価を「点数競争」から「測定設計の問題」へ引き戻している点にあります。
多くの人は、AIモデルの評価を見るときに、
ベンチマークの順位や成功率だけに注目しがちである。
しかし、この記事が示しているように、
現代のAIモデルでは、スコアはモデル単体の性質ではない。
スコアは、モデル、ハーネス、ツール、予算、安全対策、採点方法が組み合わさった結果である。
したがって、今後AIモデルの性能や安全性を議論する際には、
「どのモデルが何点だったか」ではなく、
「どの条件で、何を測り、その測定はどれほど妥当だったのか」
を問う必要がある。
個人的には、この考え方はかなり重要だと思っています。
なぜなら、AIがエージェント化するほど、
評価の難しさは単純な知能テストから、実験設計・監査・リスク評価の問題へ移っていくからである。
特に企業や行政がAIを導入する場合、
ベンチマークスコアだけで意思決定するのは危険である。
今後は、モデル評価レポートを読む力そのものが、
AIを安全かつ有効に使うための必須スキルになる。
AIモデル評価の信頼性に関する重要なキーワード
#ハーネス (モデルを動かす周辺構造)
#能力の引き出し (Capability elicitation)
#安全対策の性能 (Safeguard performance)
#データ汚染 (Contamination)
#サンドバギング (意図的な低パフォーマンス)
#評価予算 (トークン数や試行回数など)
