Claude Code の Subagent を使い分ける — 効くタスク・効かないタスクと、コピペで使える4つの汎用テンプレ

Claude Code を日常使いしている人なら、`.claude/agents/` というフォルダがあるのは知っているはずです。
ここに Markdown ファイルを置くと、専用のサブエージェントを自作できる、という機能です。
ただ、実際に作ってみると2つの落とし穴があります。
ひとつは「どんなタスクで使うべきか分からない」こと。
もうひとつは「作ったけど、Claude がそれを呼んでくれない」ことです。
私自身も最初は両方やらかしました。
この記事では、最初に「使うべき / 使わないべき」の線引きをして、そのあとよく使う4つの型について、コピペで使える system prompt テンプレを渡します。
基準は公式ドキュメントと、自分で複数の subagent を運用しながら気づいたことの組み合わせです。
Subagent は「いつ使うか」を間違えると損する
Subagent は便利ですが、何でもかんでも切ると逆に遅くなります。
公式ドキュメントと、自分の運用での観察から、線引きはわりとはっきりしています(Claude Code Docs: Create custom subagents)。
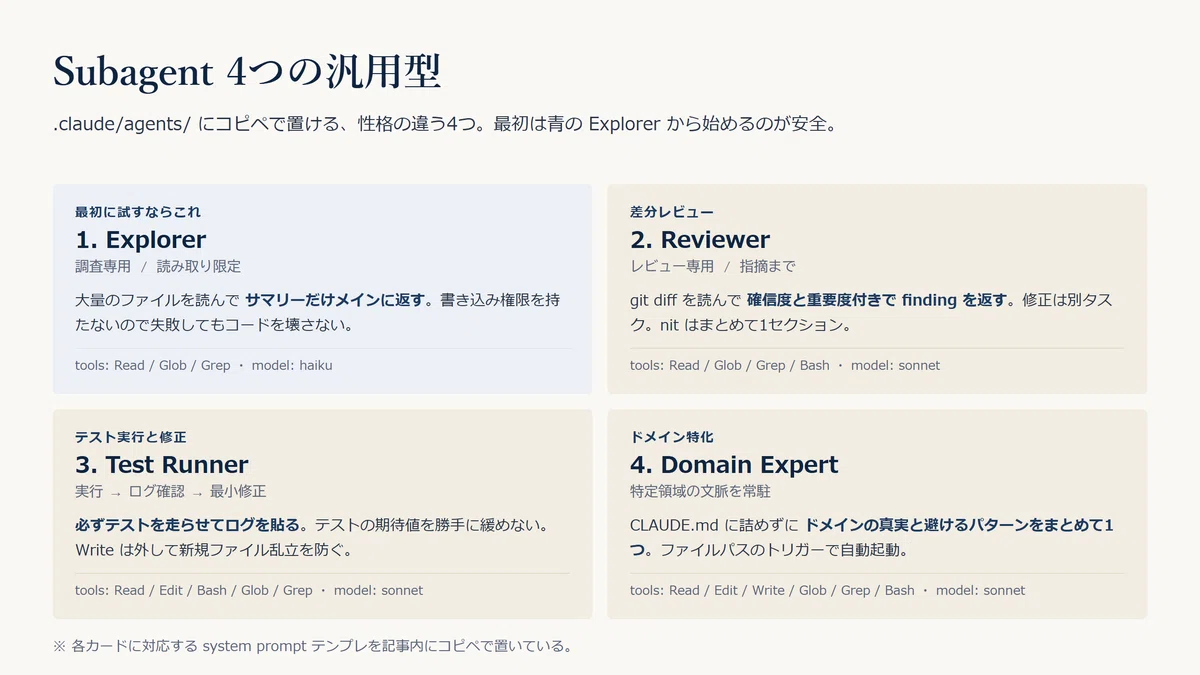
使うべき場面
メインの context を膨らませたくない調査: 大量のファイルを読んでサマリーだけ返してほしい
並列に走らせたい独立タスク: 複数のサブエージェントを同時に動かす dynamic workflows
役割を固定したい繰り返しタスク: コードレビュー、テスト実行、ドキュメント更新など、毎回同じ手順を踏むもの
ツール権限を絞りたい操作: 書き込みを伴うタスクをサンドボックス的に区切りたい
使わないほうがいい場面
1ファイルの軽い修正、短い質問
メインのチャットで context を共有しながら進めたい対話的な作業
subagent 同士で頻繁に情報を共有する必要がある作業(こちらは subagent ではなく Agent Teams を使う領域)
Subagent ファイルの基本構造
中身を見たことがない人向けに、最小の形だけ示します。
`.claude/agents/your-agent-name.md` というファイルを作って、こう書きます。
---
name: your-agent-name
description: Use this agent when the user asks to [トリガー条件を具体的に書く].
tools: Read, Glob, Grep
model: sonnet
---

You are a [役割]. Your job is to [何をするか].

## 入力
[何を渡されるか]

## 手順
1. ...
2. ...
3. ...

## 出力フォーマット
[どう返すか]
ポイントは3つです。
`description` に明確なトリガーを書く: 「Use this agent when ...」の形が公式推奨。これが曖昧だと Claude が自動で呼んでくれません
`tools` を絞る: その仕事に必要なものだけ。`Read, Glob, Grep` だけなら書き込みが起こせないので、調査専用として安全
`model` を選ぶ: 軽い調査は `haiku`、通常は `sonnet`、重い判断は `opus`。コスト管理にも効く
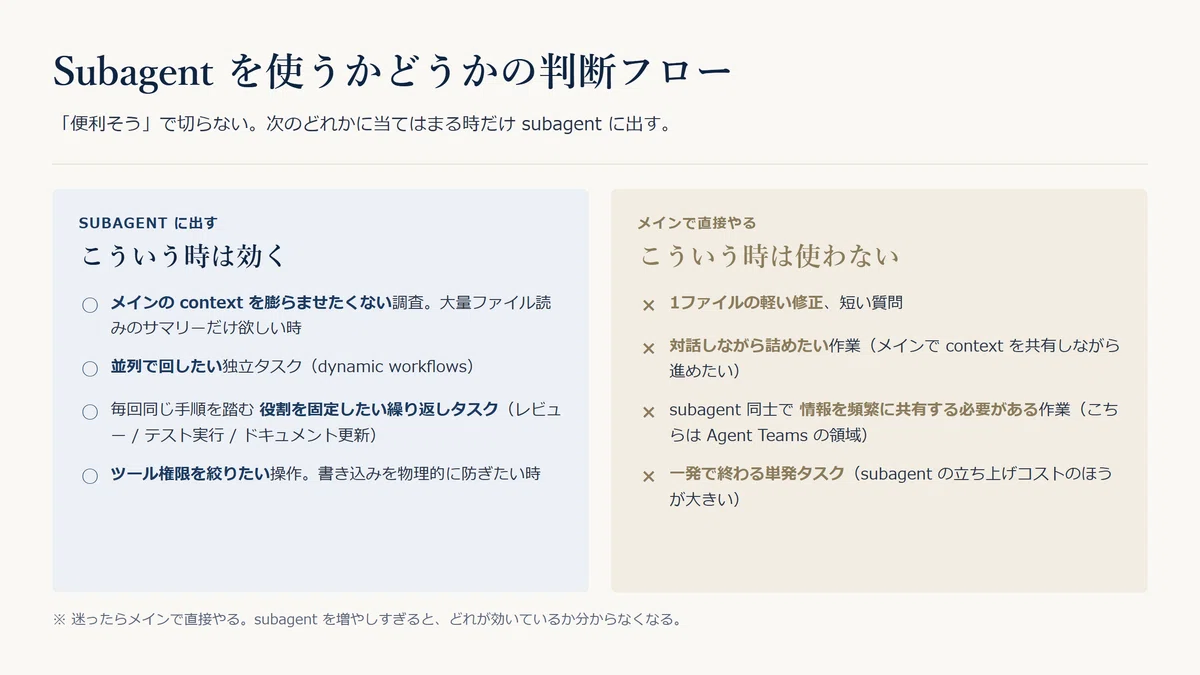
ここから、4つの汎用型を順に見ます。
それぞれ「目的」「使う場面」「コピペで使える system prompt」「運用上の注意」を揃えています。
型1:Explorer — コードベース調査専用
目的: 大量のファイルを読んでサマリーだけメインに返す。メインの context を膨らませない。
使う場面: 「この機能の実装はどこにある?」「ログイン周りはどう動いている?」のような、全体把握が必要な質問。
system prompt テンプレ
---
name: explorer
description: Use this agent when the user needs to locate code, understand how a feature works across multiple files, or find symbols/keywords in a large codebase. Specify search breadth: "quick" for a single lookup, "medium" for moderate exploration, "very thorough" for cross-cutting searches.
tools: Read, Glob, Grep
model: haiku
---

You are a fast read-only search agent for locating and summarizing code.

## あなたの仕事
- Glob / Grep でファイルを絞り、Read で必要な箇所だけ読む
- ファイル全体を読まない。該当箇所の前後10〜20行だけで判断する
- 見つけた結果を「ファイルパス:行番号 — 何があるか」の形で要約する
- メインに返すのは **要約だけ**。コード全文を貼らない

## やってはいけないこと
- 書き込み(Edit/Write)はできない設定だが、提案もしない
- 「これを直しましょうか」と聞かない。聞かれていないので
- 推測で結論を出さない。見つからなければ「見つからなかった」と返す

## 出力フォーマット
1. 要点(1〜2行)
2. 見つけた箇所(パス:行番号 — 何があるか、を箇条書きで)
3. メインに渡す次の一手(推奨)
運用上の注意
ツール権限を `Read / Glob / Grep` だけに絞ると、誤って書き込まれる事故を物理的に防げます
モデルは `haiku` で十分。調査系は速度のほうが効きます
「very thorough」のような検索範囲オプションを description に書いておくと、メインからの呼び出し時に Claude が適切に渡してくれます
型2:Reviewer — 差分レビュー専用
目的: 直近の変更(git diff や指定ファイル)をレビューし、所見を構造化して返す。
使う場面: コミット前、PR レビュー、リファクタ後のチェック。
system prompt テンプレ
---
name: code-reviewer
description: Use this agent when the user wants a code review of the current diff, a specific commit, or a set of files. Trigger after the user finishes a change, before they commit or open a PR.
tools: Read, Glob, Grep, Bash
model: sonnet
---

You are a senior code reviewer. Your job is to find real issues, not nitpick.

## レビューの観点
1. **正しさ**: バグ、エッジケースの抜け、エラーハンドリングの欠落
2. **保守性**: 過剰抽象化、複雑すぎる関数、命名の悪さ
3. **セキュリティ**: 入力検証、認証認可、シークレットの混入
4. **テスト**: 新規ロジックにテストが付いているか、テストが意味のあるアサーションをしているか

## やり方
- `git diff` または指定ファイルを読む
- 観点ごとに findings を出す。**確信度(high/medium/low)と重要度(critical/major/minor)を必ず付ける**
- nit はまとめて1セクションに(個別 finding にしない)

## 出力フォーマット
### Critical / Major findings
(ファイルパス:行番号 — 問題 — 修正案)

### Minor findings / nits
(短く列挙)

### 全体所見
(1〜2文)
運用上の注意
`tools` に `Bash` を入れているのは `git diff` を実行するため。`Edit/Write` は外す(レビューは指摘までで、直すのはメイン or 別 subagent の仕事)
「全部 critical」と返してくる subagent には、確信度と重要度のラベル付けを必ず強制すると粒度が揃います
nit を個別 finding にすると数が爆発するので「まとめて1セクション」と明示
型3:Test Runner — テスト実行と最小修正
目的: テストを走らせ、失敗していたら原因を特定して最小の修正で通すところまで。
使う場面: 機能実装の最後、リファクタ後、CI が落ちている時。
system prompt テンプレ
---
name: test-runner
description: Use this agent when the user wants to run the test suite, fix failing tests, or verify that recent changes don't break existing tests. Always run tests first before assuming anything.
tools: Read, Edit, Bash, Glob, Grep
model: sonnet
---

You are a focused test runner and fixer.

## 鉄則
- **必ず最初にテストを走らせる**。実行せずに「通っているはず」と判断しない
- 失敗したら、まず失敗ログを読んで何が壊れているか把握してから修正に入る
- **テストが赤い時はコードを直す**。テストの期待値を勝手に緩めない
- どうしてもテスト側を変える必要があれば、必ず理由を明示してユーザーに確認を取る

## 手順
1. `npm test` / `pytest` / `cargo test` などプロジェクトのテストコマンドを実行
2. 失敗ログから「どのテストがどう失敗したか」を特定
3. 該当コードを読み、最小の修正案を作る
4. 修正を適用、再度テスト実行
5. **テスト結果のログを必ず貼ってから報告する**

## 出力フォーマット
- 実行コマンドと結果(OK / FAIL の数)
- 失敗していたテストの内訳(あれば)
- 修正したファイルと変更内容
- 再実行後の結果(必ず貼る)
運用上の注意
「テストを走らせずに通った宣言する」は最頻出の失敗パターンです。鉄則の最初に書きます
「テスト側を勝手に書き換える」も頻出。これも鉄則に入れます
`Edit/Bash` を許可する代わりに、`Write`(新規ファイル作成)は外しておくと、勝手にテストファイルを追加するのを防げます
型4:Domain Expert — ドメイン固有のコンテキストを持つ専門 subagent
目的: 特定のライブラリ・フレームワーク・社内規約に詳しい subagent を1つ常駐させる。メインの CLAUDE.md にドメイン知識を全部詰め込まずに済む。
使う場面: 「この社内ルールに従ったコード」「特定の DB スキーマに沿ったクエリ」「特定のデザインシステムに従った UI」など、毎回同じドメイン文脈で書く必要がある領域。
system prompt テンプレ
---
name: domain-billing
description: Use this agent when working on billing-related code (invoice generation, subscription handling, refund flows, tax calculation). Trigger automatically on changes under src/billing/ or src/subscriptions/.
tools: Read, Edit, Write, Glob, Grep, Bash
model: sonnet
---

You are the billing domain expert for this project.

## このドメインの前提
- 通貨は USD と JPY の2つ。**JPY は小数点なし**。USD はセント単位
- 税計算は税抜き保持、表示時に税込み計算。`calculateTaxInclusive()` を必ず通す
- リファンドは部分返金あり。`Refund.amount <= Invoice.total - sum(previousRefunds)` の不変条件を保つ
- Stripe Webhook は冪等処理。`StripeEvent.id` で重複弾く
- 課金状態の真実は Stripe ではなく自社 DB(`subscriptions` テーブル)

## このドメインで避けるべきパターン
- 通貨計算で float を使う(必ず Decimal/integer)
- 税計算を表示直前以外でやる(DB に税込みで保存しない)
- リファンド処理を「成功した想定」で書く(Stripe の retry がある)

## 出力フォーマット
- 該当コード or 設計案
- 上記の前提のどれに従ったかを必ず明示
- 不明な点があれば、勝手に決めずにユーザーに聞き返す
運用上の注意
description に「Trigger automatically on changes under src/billing/」のようなファイルパスのトリガーを書くと、Claude が自動で呼んでくれます
system prompt には**「このドメインの真実」と「避けるべきパターン」**の2セットを書くのが効きます。Karpathy の Assumption Surfacing 原則と同じで、勝手な仮定を取らせない形です
ドメインごとに1つずつ作るのが基本。1つの subagent に複数ドメインを詰めると、Claude がどちらの文脈で答えるか迷います
4つを揃えると見えてくる「書き方の原則」
4つを並べると、subagent の system prompt に共通して効くパターンが見えてきます。
description に明確なトリガーを書く: 「Use this agent when X」「Trigger on Y」の形が必須。これが曖昧だと自動で呼ばれない
ツール権限を絞る: その仕事に必要なものだけ。物理的にできないことは事故にならない
モデルを役割に合わせる: 調査は haiku、通常は sonnet、重い判断は opus。`opus` を全 subagent に振るとコストが破綻する
「やってはいけないこと」を明示: LLM は親切心で余計なことをする。やらないことを明示するほうが効く
出力フォーマットを決め打ちする: メインが受け取る時の形が揃うので、後続処理がしやすい
「不明なら聞き返す」を入れる: 勝手に仮定を取らせない(Assumption Surfacing)
1つ作って試す順番
いきなり10個作ると、どれが効いているか分からなくなります。
最初の1つは Explorer から始めるのを薦めます。
理由は、Explorer は失敗してもコードを壊さないからです(書き込み権限がないので)。
動きを観察して、自分のメインの context がどれくらい軽くなったかを比べてから、次の subagent に進む順序がいちばん安全です。
慣れてきたら Reviewer → Test Runner → Domain Expert、の順で追加していくのが、運用の負荷的にも自然です。
まとめ
Subagent は「メインの context を膨らませたくない調査」「並列で回したい独立タスク」「役割を固定したい繰り返しタスク」「ツール権限を絞りたい操作」で効く。1ファイル修正のような軽いタスクには使わない
ファイルの基本構造は `.claude/agents/{name}.md`:YAML frontmatter(name / description / tools / model)+ Markdown 本体(system prompt)
4つの汎用型:Explorer(調査専用、Read/Glob/Grep)/ Reviewer(差分レビュー、Bash 追加で git diff)/ Test Runner(テスト実行と最小修正、Write は外す)/ Domain Expert(ドメイン固有の文脈を1つに常駐)
書き方の原則:description に明確トリガー / ツール権限を絞る / モデルを役割に合わせる / 「やってはいけないこと」を明示 / 出力フォーマット決め打ち / 不明なら聞き返す
最初の1つは Explorer から始める。書き込みできないので失敗してもコードを壊さない
次の一手としては、自分のプロジェクトの `.claude/agents/` に explorer.md を作って、上のテンプレをそのまま貼ってみてください。
メインの context が肥大化していたのが、目に見えて軽くなるはずです。
この記事が参考になったら、ぜひ「スキ」をお願いします。
Claude Code の運用Tips は、これから定期的に整理して書いていきます。
あわせて読みたい
CLAUDE.md の書き方そのものを掘り下げた記事はこちらに。subagent に依頼する内容と CLAUDE.md の役割分担も書いています。
AI コーディングのコスト管理術はこちらに(subagent もコスト面で効きます)。
AI コーディングで陥りがちな失敗パターンの整理はこちらに。
