Azure × Databricks Regionと可用性の考え方

📚 関連書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は
書籍の中でまとめているので、気になる方はそちらもどうぞ。
『ゼロから触ってわかった!Azure × Databricksでつくる次世代データ基盤 非公式ガイド ―』
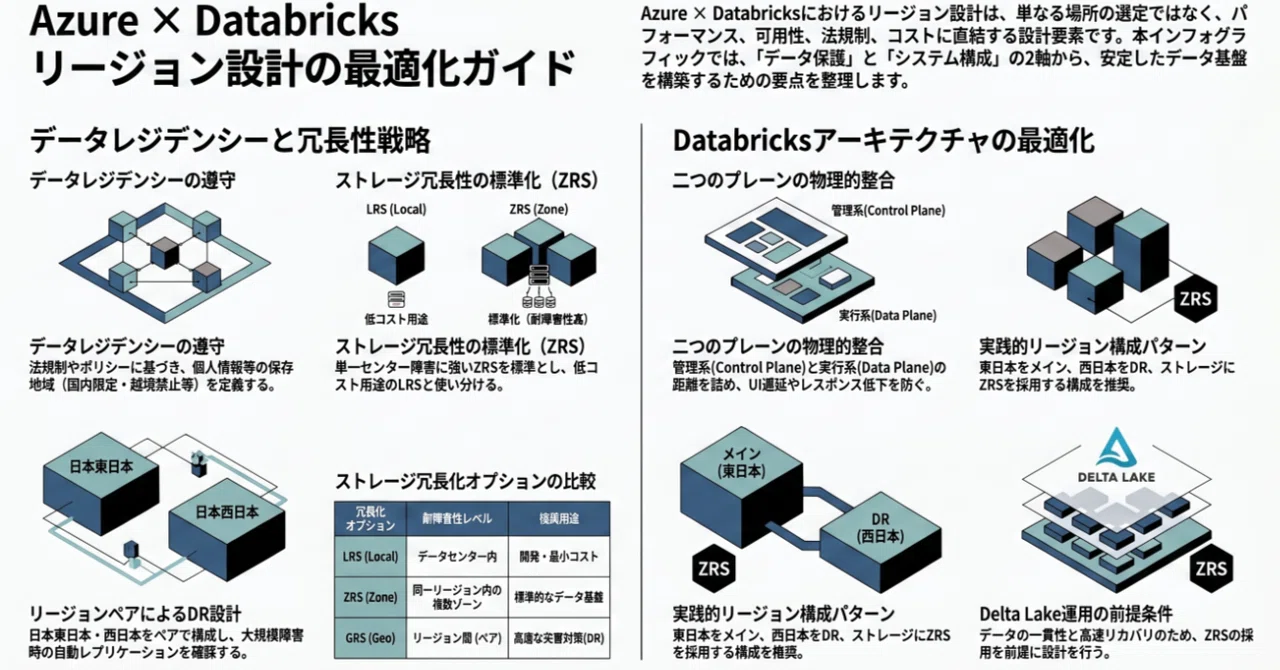
Azure × Databricks Regionと可用性の考え方
データレジデンシーと冗長性をどう設計するか
Azure × Databricks において、
リージョン選択は単なる「場所決め」ではありません。
実は、次のすべてに直結します。
パフォーマンス
可用性
法規制
コスト
よくある見落としとして、
ユーザーに近い場所だけで決める
冗長性を後付けにする
データ保管場所を意識していない
といったケースがあります。
リージョン設計とは、
どこに置くかと同時に、どう守るかを決める作業
です。
データレジデンシー
データを「どこに置けるか」
データレジデンシーとは、
データをどの国・地域に保管するか
という考え方です。
これは単なる技術ではなく、
法規制
セキュリティポリシー
監査要件
に直結します。
例えば次のような制約があります。
個人情報は国内リージョン限定
特定国へのデータ移送禁止
保存場所の明示義務
そのため、最初に整理すべきポイントがあります。
データ種別(PII / 機密情報)
保存可能地域
越境可否
日本企業では一般的に、
Japan East
Japan West
のいずれか、または両方を利用します。
リージョンペア
DR前提で考える
Azure には
Region Pair(リージョンペア)
という考え方があります。
これは災害対策(DR)を前提としたリージョン構成です。
日本では次がペアです。
Japan East
Japan West
これらは十分に離れた場所に存在し、
片方が停止してももう一方が継続できる設計です。
重要なのは、
単体リージョンではなく“ペア”で考えること
です。
ストレージ冗長化
GRS / RA-GRSの考え方
Azure Storage には地理冗長機能があります。
代表例は次の通りです。
GRS(Geo-Redundant Storage)
RA-GRS(Read Access Geo-Redundant Storage)
これらはリージョンペア間で自動レプリケーションを行います。
つまり、
East → West
West → East
へデータが冗長化されます。
そのためDR設計では、
どのリージョンか
どのペアか
の両方を考える必要があります。
Availability ZoneとZRS
リージョン内の冗長性
リージョン内部には、さらに
Availability Zone(可用性ゾーン)
があります。
これは同一リージョン内の独立データセンター群です。
この考え方を使った冗長構成が
ZRS(Zone-Redundant Storage)
です。
特徴は次の通りです。
複数ゾーンへ同期保存
単一DC障害では停止しない
高可用性と整合性を両立
一方、LRS は単一データセンター内冗長です。
そのため現在のデータ基盤では、
LRS:低コスト用途
ZRS:標準構成
と考えるのが現実的です。
特に Delta Lake 運用では、
一貫性
同時アクセス
高速リカバリ
が重要なため、ZRS が基本になります。
Databricksの内部構造
Control PlaneとData Plane
Databricks は内部的に2層構造です。
Control Plane(管理系)
Data Plane(実行系)
Control Plane
Databricks側管理領域
主な役割:
Workspace管理
Notebook UI
Job管理
Data Plane
ユーザーAzure環境
主な役割:
Spark実行
データ処理
ストレージアクセス
重要なのは、
Data Plane はユーザーAzure環境にある
という点です。
一方、Control Plane は Databricks 側にあります。
この距離が離れすぎると、
UI レイテンシ増加
Job応答遅延
が発生します。
そのため、Workspace作成時は、
選択リージョン
Control Plane 配置
の整合性確認が重要です。
実践的なリージョン設計
日本企業の典型パターン
実務では次の構成が一般的です。
メイン:Japan East
DR:Japan West
Storage:ZRS(必要に応じてGRS)
この構成により、
通常時は低レイテンシ
障害時はリージョン単位フェイルオーバー
が可能になります。
さらに高度な設計では、
読み取り専用DR
リージョン間同期制御
なども検討されます。
よくある失敗
初期設計ミスが後で効く
代表的な失敗例は次の通りです。
単一リージョン構成
Region Pair未考慮
LRS選択
Control Plane / Data Plane 距離未考慮
これらは結果として、
障害停止
復旧長期化
性能低下
につながります。
この節のまとめ
配置ではなく可用性設計
リージョン設計は、単なる配置ではありません。
可用性と制約を同時に設計する作業
です。
データレジデンシーを整理する
Region Pair前提でDR設計する
Storage は ZRS を基本にする
Control Plane と Data Plane を意識する
この考え方を押さえることで、
止まりにくく、運用しやすいデータ基盤
の土台が整います。
📚 関連書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は
書籍の中でまとめているので、気になる方はそちらもどうぞ。
Databricks/n8n/Salesforce/AI基盤 を体系的に学べる「ゼロから触ってわかった!」シリーズをまとめました。
『Databricks──ゼロから触ってわかった!Databricks非公式ガイド(2026年更新版)』
クラウド時代の分析基盤を “体験的” に学べるベストセラー入門書。
Databricksの操作、SQL/DataFrame、Delta Lakeの基本、ノートブック操作、SDP(宣言型パイプライン)
Serverless、Genieなどを初心者でも迷わず進められる構成で解説しています。
https://amzn.to/3Ob4eqD
『ゼロから触ってわかった! Snowflake × Databricks次世代データ基盤PoC実践 非公式ガイド』
『ゼロから触ってわかった! Snowflake × Databricksでつくる次世代データ基盤 - 比較・共存・連携 非公式ガイド』
SnowflakeとDatabricks――二つのクラウドデータ基盤は、これまで「どちらを選ぶか」で語られることが多くありました。本書は、両プラットフォームをゼロから触り、構築・運用してきた実体験をもとに、比較・共存・連携のリアルを丁寧に解説する“非公式ガイド”です。
👉 https://amzn.to/4bZeCvo
Snowflake
ゼロから触ってわかった!Snowflake非公式ガイド ― 基礎から理解するアーキテクチャとCortexによる次世代AI基盤
「結局、DatabricksとSnowflakeは何が違うの?」
初めてSnowflakeに触れる方には「最初の一冊」として。
なんとなく使っているけれどモヤモヤしている方には「頭の中を整理する一冊」として。
AI時代のエンジニアを目指すための、確かな燃料となる一冊です。
「ゼロから触ってわかった!Codex - AIエージェント時代のソフトウェア設計」
本書は、AIエージェントと共に開発する時代において、
エンジニアが思考停止せず、主体的に価値を発揮し続けるための指針を提示します。ツールの使い方ではなく、
これからの開発の本質を理解したいすべてのエンジニアへ。
「ゼロから触ってわかった! Claude Code × ChatGPT × Gemini AI共生戦略 -“対立”ではなく“共生”する時代へ」
Claude Code × ChatGPT × Geminiという共生モデルを解説します。
👉 https://amzn.to/4diheF9
『ゼロから触ってわかった!スペック駆動開発入門 ― SaaS is dead?AI時代のソフトウェア設計論』
前半では思想や背景を丁寧に整理し、後半ではスペック・実装・実行の三層モデルをサンプルコードとともに具体化します。
👉 https://amzn.to/4slxDxv
データメッシュ
『ゼロから触ってわかった データメッシュ入門 ― 思想・型・組織構造から考えるデータメッシュ』
「Data Mesh を導入すべきかどうか」を断言する本ではありません。
また、「この形が正解だ」と教える本でもありません。
自分たちにとって、どこまで分散し、何を共有し、どこに責任を置くのか。
その判断をするための思考の土台を整理する一冊です。
データクリーンルーム
ゼロから触ってわかった データクリーンルーム実践入門 ~ Lakehouse時代のクリーンルームを、思想・設計・マネタイズで読み解く ~
データはあるのに、渡せない。
それでも一緒に分析したい——そんな現場の悩みから、本書は始まります。
データクリーンルームを「難しい技術」ではなく、現実の業務でどう使い、どう続けるかという視点で整理しました。
非ITのビジネスパーソンにも読める、実践的な一冊です。
Databricks
『ゼロから触ってわかった!Azure × Databricksでつくる次世代データ基盤 非公式ガイド ―』
クラウドでデータ基盤を作ろうとすると、Azure・Storage・ネットワーク・権限・セキュリティ…そこに Databricks が加わった瞬間、一気に難易度が跳ね上がります。
「結局どこから理解すればいいの?」
「Private Link むずかしすぎない?」
「Unity Catalog って実務ではどう扱うの?」
——そんな “最初のつまづき” を丁寧にほどいていくのが本書です。
👉 https://amzn.to/4tAOVHP
「ゼロから触ってわかった!Databricks × Airbyte」
クラウド時代のデータ基盤を“なぜ難しいのか”から丁寧にほどくガイドが完成しました。
Ingestion / LakeFlow / DLT / CDC をやさしく体系化し、
Airbyte × Databricks の真価を引き出す設計思想まで詰め込んだ一冊です。
『Databricks──ゼロから触ってわかった!DatabricksとConfluent(Kafka)連携!非公式ガイド』
Kafkaによるストリーム処理とDatabricksを統合し、リアルタイム分析基盤を構築するハンズオン形式の一冊。
イベント駆動アーキテクチャ、リアルタイムETL、Delta Live Tables連携など、
モダンなデータ基盤の必須スキルがまとめられています。
『Databricks──ゼロから触ってわかった!AI・機械学習エンジニア基礎 非公式ガイド』
Databricksでの プロンプト設計・RAG構築・モデル管理・ガバナンス を扱うAIエンジニアの入門決定版。
生成AIとデータエンジニアリングの橋渡しに必要な“実務の型”を体系化しています。
資格本ではなく、実務基盤としてAIを運用する力 を育てる内容です。
『Databricks認定データエンジニアプロフェッショナル 試験レベル ― 1日3分!気になったところから読めるデータブリックス!魂の100本ノック!』
Databricksを業務で触っている。なのに——サンプル問題を解いた瞬間、手が止まる。
「使ってはいるけど、設計の“理由”までは腹落ちしていない」…その違和感から、この本は生まれました。
本書は、Databricks認定データエンジニア・プロフェッショナル相当の論点を、100個のユースケースに分解し、**“2択の検討”→“解説コラム”→“結論”**でテンポよく叩き込む「魂の100本ノック」です。
暗記ではなく、現場で遭遇する判断ポイント(取り込み・変換・品質・共有・監視・性能/コスト・セキュリティ・ガバナンス・デプロイ・モデリング)を、短い読書時間で反復できるように整えました。
👉 https://amzn.to/4aTP9lR
👉 https://amzn.to/4qEzVWq
🧠 Advancedシリーズ(上/中/下)
Databricksを “設計・運用する” ための完全版実践書
「ゼロから触ってわかった!Databricks非公式ガイド」の続編として誕生した Advancedシリーズ は、
Databricksを触って慣れた“その先”――本格運用・チーム開発・資格対策・再現性ある設計 に踏み込む構成です。
Databricks Certified Data Engineer Professional(2025年9月改訂版)のカリキュラムをベースに、
設計思考・ガバナンス・コスト最適化・トラブルシュートなど、実務で必須の力を養えます。
📘 [上]開発・デプロイ・品質保証編
📘 [中]取込・変換・監視・コスト最適化編
📘 [下]セキュリティ・ガバナンス・トラブルシュート・最適化戦略編
n8n
『n8n──ゼロから触ってわかった!AIワークフロー自動化!非公式ガイド』
オープンソースの自動化ツール n8n を “ゼロから手を動かして” 学べる実践ガイド。
プログラミングが苦手な方でも取り組めるよう、画面操作中心のステップ構成で、
業務自動化・AI連携・API統合の基礎がしっかり身につきます。
Salesforce
『ゼロから触ってわかった!Salesforce AgentForce + Data Cloud 非公式ガイド』
Salesforceの最新AI基盤 AgentForce と Data Cloud を、実際の操作を通じて理解できる解説書。
エージェント設計、トピック/アクション構築、プロンプトビルダー、RAG(検索拡張生成)など、
2025年以降のAI×CRMのハンズオン知識をまとめた一冊です。
👉 https://amzn.to/40fI7BK
👉 https://amzn.to/3OuN07o
要件定義(上流工程/モダンデータスタック)
『モダンデータスタック時代の シン・要件定義 クラウド構築大全 ― DWHからCDP、そしてMA / AI連携へ』
クラウド時代の「要件定義」って、どうやって考えればいい?
Databricks・Snowflake・Salesforce・n8nなど、主要サービスを横断しながら“構築の全体像”をやさしく解説!
DWHからCDP、そしてMA/AI連携まで──現場で使える知識をこの一冊で。
MCP
『ゼロから触ってわかった!MCPビギナーズガイド』 ― AIエージェント時代の次世代プロトコル入門 アーキテクチャ・ガバナンス・実装―
MCPというプロトコルは、単なる技術トレンドではなく
「AIとシステムの関係性」そのものを変える可能性を秘めています。
SaaS、AIエージェント、ガバナンス、アーキテクチャ。
その交差点を一度、立ち止まって整理した一冊です。
👉 https://amzn.to/3LcAjgg
💡 まとめ:このラインナップで“構築者の視点”が身につく
これらの書籍を通じて、
クラウド基盤の理解 → 要件定義 → 分析基盤構築 → 自動化 → AI統合 → 運用最適化
までのモダンデータスタック時代のソリューションアーキテクトとしての全体像を
「体系的」かつ「実践的」に身につけることができます。
PoC要件整理
データ基盤の要件定義
チーム開発/ガバナンス
AIワークフロー構築
トラブルシュート
など、現場で直面しがちな課題を解決する知識としても活用できます。
