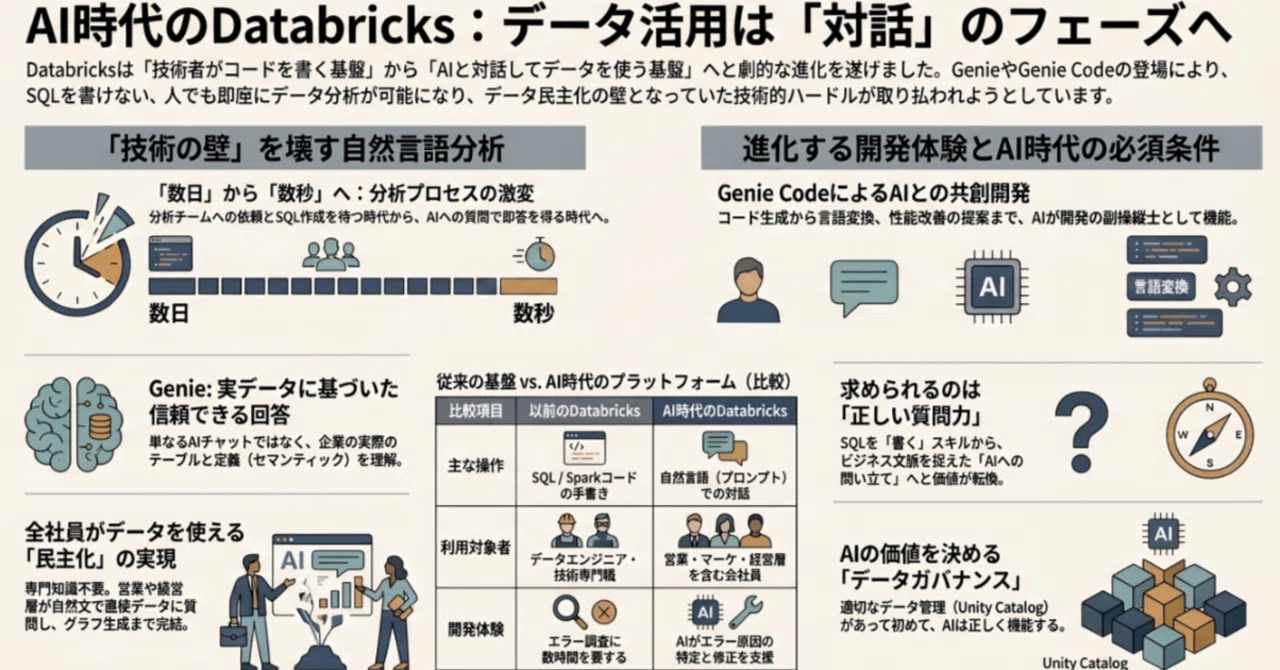
AI時代のDatabricks ― Genie・Genie Code・自然言語分析の現在地 ―

📚 関連書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は書籍の中でまとめているので、気になる方はそちらもどうぞ。
AI時代のDatabricks
― Genie・Genie Code・自然言語分析の現在地 ―
以前のDatabricksを知っている人ほど、現在の変化に驚くかもしれません。
かつてのDatabricksは、どちらかと言えば
データエンジニアが使う技術者向け基盤
という印象が強くありました。
NotebookでSparkコードを書き、ETLを実装し、クラスターを調整する。
そのような世界観です。
しかし現在のDatabricksは、大きく方向性を変えつつあります。
一言で表現するなら、
人がSQLを書く世界から、AIと対話しながらデータを使う世界へ進化している
と言えます。
この変化を支えているのが、
Genie
Genie Code
自然言語分析
Unity Catalog
データガバナンス
といった機能群です。
以前は、データ分析の入口には高い技術的ハードルがありました。
SQLを書ける人、BIツールを使える人、データモデルを理解している人だけが、自由にデータへアクセスできる世界でした。
しかし現在は、
SQLを書けない人でもデータに質問できる
コードを書き慣れていない人でもAIと一緒に開発できる
業務部門が自然言語で分析できる
方向へ急速に進化しています。
本節では、AI時代のDatabricksが何を目指しているのかを整理しながら、Genie・Genie Code・自然言語分析の現在地を見ていきます。
なぜ自然言語分析が重要なのか
まず前提として、企業のデータ活用には長年の課題がありました。
それは、
データを使える人が少ない
という問題です。
企業には大量のデータがあります。
しかし、それを自由に扱える人は限られていました。
例えば、次のようなスキルが必要でした。
SQLを書ける
BIツールを操作できる
データモデルを理解している
分析基盤の構造を知っている
権限やテーブル定義を把握している
そのため現場では、次のような流れがよく発生していました。
「売上分析を見たい」
↓
分析チームへ依頼する
↓
SQLを作成する
↓
数日後に結果が返る
この流れでは、データ活用のスピードが上がりません。
業務部門が知りたいタイミングと、分析結果が返ってくるタイミングにズレが生まれるからです。
生成AIの登場によって、この構造が変わり始めています。
自然言語で質問し、AIがデータを解釈し、結果を返す。
この世界が現実的になってきました。
つまり、
SQLを書けないから分析できない
という制約が崩れ始めているのです。
Genieとは何か
現在のDatabricks AI機能を語るうえで、最も象徴的なのがGenieです。
Genieを簡単に言えば、
企業データに対して自然言語で質問できるAIインターフェース
です。
利用者はSQLを書く必要がありません。
例えば、次のように質問できます。
今月の売上トップ10を教えて
利益率が悪化している商品は?
地域別売上をグラフで見たい
前年同月比で伸びているカテゴリは?
直近3か月で解約率が上がった顧客セグメントは?
これらを自然文で入力すると、Genieが内部でデータ構造を解釈し、必要なクエリを生成しながら回答を返します。
これは非常に大きな変化です。
以前であれば、
SQLを書く
BIダッシュボードを探す
分析チームへ依頼する
データエンジニアに確認する
必要がありました。
Genieは、このハードルを下げます。
質問するだけで分析できる世界
に近づいているのです。
業務部門にとっての価値
Genieの価値は、データエンジニアだけのものではありません。
むしろ、大きなインパクトを受けるのは業務部門です。
たとえば、
営業
マーケティング
経営企画
財務
カスタマーサクセス
といった部門では、日々さまざまなデータ確認が発生します。
しかし、すべての担当者がSQLを書けるわけではありません。
そのため従来は、分析チームに依頼する必要がありました。
Genieによって、業務部門のユーザー自身がデータへ質問できるようになると、意思決定のスピードが大きく変わります。
これは単なる便利機能ではありません。
データ活用の入口を広げる仕組み
と言えます。
Genieは単なるAIチャットではない
ここで誤解しやすいポイントがあります。
それは、
Genieは単なるAIチャットではない
という点です。
一般的な生成AIチャットでは、Hallucination、つまり誤情報の生成が課題になります。
例えば、
「今月の売上を教えて」
と聞いたときに、AIが存在しない数字をもっともらしく作ってしまえば、ビジネスでは使えません。
企業データ分析では、回答の自然さよりも、
実データに基づいていること
が重要です。
Genieは、Databricks上の実際のテーブルやメタデータを参照しながら回答する方向で設計されています。
ここが、一般的なAIチャットとの大きな違いです。
つまりGenieは、
データ基盤に接続されたAI分析インターフェース
と考えるべきです。
Semantic理解が重要になる
自然言語分析で難しいのは、単語の意味が企業ごとに異なることです。
たとえば、
「売上」
という言葉一つを取っても、企業によって意味は違います。
受注ベースの売上
請求ベースの売上
入金ベースの売上
返品控除後の売上
税抜売上
税込売上
どれを意味するのかが曖昧なままでは、AIは正しく回答できません。
そのため、自然言語分析ではSemantic理解が非常に重要になります。
Genieが目指しているのは、単にテーブルに対してSQLを生成することではありません。
企業独自の定義やビジネス文脈を理解しながら回答することです。
つまりDatabricksが目指しているのは、
データを理解したAI
なのです。
Genie Codeが変える開発体験
AI時代のDatabricksでは、分析だけでなく開発体験も変わっています。
ここで重要になるのがGenie Codeです。
以前のDatabricks開発では、Notebookを開き、自分でSQLやPySparkコードを書き、エラーを読み解きながら開発する必要がありました。
これは柔軟で強力な一方、初学者にはハードルが高い世界でした。
Genie Codeによって、この体験が変わり始めています。
例えば、次のような支援が可能になります。
SQLを書いてもらう
PySparkコードを生成してもらう
SQLからPythonへ変換する
エラー原因を調査する
クエリ改善案を提案してもらう
Notebookの処理内容を説明してもらう
これは単なるコード補完ではありません。
Databricksの文脈を踏まえたうえで、
なぜエラーになったのか
どこを直すべきか
どう改善すべきか
まで支援する方向へ進んでいます。
初学者にとっての価値
Genie Codeは、特に初学者にとって大きな価値があります。
DatabricksやSparkを学び始めたばかりの人にとって、エラーの原因を読み解くのは簡単ではありません。
例えば、
スキーマ不一致
型変換エラー
権限エラー
パス指定ミス
クラスター設定ミス
ライブラリ依存関係の問題
などは、慣れていないと原因特定に時間がかかります。
Genie Codeがエラーの意味を説明し、修正方針を提示してくれることで、学習コストは大きく下がります。
これにより、Databricksは専門家だけのツールから、より多くの人が学びやすいプラットフォームへ近づいています。
SQLを書く時代は終わるのか
ここで多くの人が気になる疑問があります。
「もうSQLを学ばなくてもよいのか?」
という点です。
結論から言えば、SQLは依然として重要です。
ただし、
全部を手書きする時代ではなくなり始めている
と考えるのが自然です。
以前は、SQLを書ける人が圧倒的に有利でした。
もちろん今後もSQLの理解は重要です。
しかし現在は、それに加えて、
AIへ正しく質問できる人
の価値が高まっています。
例えば、次の2つの質問を比べてみます。
悪い質問:
「売上を教えて」
良い質問:
「今月の売上をカテゴリ別に集計し、前年同月比と差分率を出してください」
この2つでは、AIが生成する結果の精度が大きく変わります。
今後は、
SQLスキル
データ理解
業務理解
AIへの指示力
を組み合わせることが重要になります。
自然言語分析には限界もある
一方で、自然言語分析に過度な期待をするのは危険です。
現在の自然言語分析にも限界があります。
例えば、次のようなケースです。
業務ロジックが非常に複雑
集計定義が曖昧
データ品質が低い
テーブル名やカラム名が分かりにくい
権限設計が整理されていない
同じ指標に複数の定義が存在する
このような状態では、AIも正しく回答できません。
AIは魔法ではありません。
むしろ、
良いデータガバナンスがあって初めてAIが活きる
と考えた方が正確です。
その意味で、Unity CatalogやData Lineageの重要性は、AI時代にむしろ高まっています。
ガバナンスとAIはセットで考える
AI時代のDatabricksを理解するうえで重要なのは、GenieやGenie Codeだけを見るのではなく、ガバナンスとセットで捉えることです。
企業データをAIに扱わせる場合、次のような問いが必ず発生します。
誰がどのデータを見られるのか
個人情報は保護されているのか
回答の根拠を追跡できるのか
どの定義に基づいて回答しているのか
誤回答が起きたときに原因を確認できるのか
これらに答えられなければ、企業利用は難しくなります。
Databricksでは、Unity CatalogやLineage、権限管理といった仕組みを通じて、AI活用とガバナンスを同じ基盤上で扱おうとしています。
つまり、
自由にAIへ質問できること
と、
安全にAIを使えること
の両立が重要なのです。
AI時代のDatabricksは何を目指しているのか
ここまでを整理すると、現在のDatabricksは単なる分析基盤を超えようとしています。
以前のDatabricksは、
ETLを作る
Sparkを動かす
SQLで分析する
Notebookで開発する
世界でした。
しかし現在は、
自然言語で分析する
AIがSQLを補助する
AIがコード生成を支援する
企業知識を理解する
業務部門でもデータを使えるようにする
方向へ進んでいます。
つまりDatabricksは、
データ専門家だけの世界から、全社員がデータを使う世界
を目指しているのです。
ただし、その前提には次の要素が必要です。
整ったデータ
正しい権限管理
明確な指標定義
データ品質管理
メタデータ管理
ガバナンス設計
だからこそ現在のDatabricksでは、Genie・Genie Code・Unity Catalog・ガバナンスが一つの流れとして語られるようになっています。
まとめると
AI時代のDatabricksは、
人がSQLを書く世界から、AIと対話しながらデータを使う世界
へ進化しています。
要点を整理すると、次の通りです。
Genieは自然言語で企業データに質問できるAIインターフェース
Genieは単なるAIチャットではなく実データに基づく分析支援
Semantic理解により企業独自の定義を扱う方向へ進んでいる
Genie CodeはDatabricks開発体験をAIで支援する
SQLは不要になるのではなく、AI活用と組み合わせる時代になる
自然言語分析には限界があり、データ品質と定義整理が重要
Unity CatalogやLineageによるガバナンスの重要性はさらに高まる
Databricksが目指しているのは、単なるコード生成や自然言語検索ではありません。
誰もが安全に企業データを活用できるAI Data Platform
です。
次章からは、こうした現在のDatabricksを支える全体アーキテクチャについて整理していきます。
📚 関連書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は書籍の中でまとめているので、気になる方はそちらもどうぞ。
Databricks/Snowflake/n8n/Salesforce/AI基盤e/POC/要件定義の進め方 を体系的に学べる
「ゼロから触ってわかった!」シリーズをまとめました。
『ゼロから触ってわかった! Databricks 本番導入完全ガイド(非公式) ― Serverless・Lakeflow・AI時代のデータ基盤実践 ― 』
『Databricks──ゼロから触ってわかった!Databricks非公式ガイド(2026年更新版)』
クラウド時代の分析基盤を “体験的” に学べるベストセラー入門書。
Databricksの操作、SQL/DataFrame、Delta Lakeの基本、ノートブック操作、SDP(宣言型パイプライン)
Serverless、Genieなどを初心者でも迷わず進められる構成で解説しています。
https://amzn.to/4uIqEj4
『ゼロから触ってわかった! Snowflake × Databricks次世代データ基盤PoC実践 非公式ガイド』
本書を読み終えたとき、「POCって何から始めればよいのか」が明確になり、「自分たちにもできる」という確信を持てることを目指しています。
https://amzn.to/43qI0oR
『ゼロから触ってわかった! Snowflake × Databricksでつくる次世代データ基盤 - 比較・共存・連携 非公式ガイド』
SnowflakeとDatabricks――二つのクラウドデータ基盤は、これまで「どちらを選ぶか」で語られることが多くありました。本書は、両プラットフォームをゼロから触り、構築・運用してきた実体験をもとに、比較・共存・連携のリアルを丁寧に解説する“非公式ガイド”です。
https://amzn.to/4efDkIk
Snowflake
ゼロから触ってわかった!Snowflake非公式ガイド ― 基礎から理解するアーキテクチャとCortexによる次世代AI基盤
初めてSnowflakeに触れる方には「最初の一冊」として。
なんとなく使っているけれどモヤモヤしている方には「頭の中を整理する一冊」として。
AI時代のエンジニアを目指すための、確かな燃料となる一冊です。
https://amzn.to/4x1VvZm
「ゼロから触ってわかった!Codex - AIエージェント時代のソフトウェア設計」
本書は、AIエージェントと共に開発する時代において、エンジニアが思考停止せず、主体的に価値を発揮し続けるための指針を提示します。
ツールの使い方ではなく、これからの開発の本質を理解したいすべてのエンジニアへ。
https://amzn.to/4o0repH
「ゼロから触ってわかった! Claude Code × ChatGPT × Gemini AI共生戦略 -“対立”ではなく“共生”する時代へ」
Claude Code × ChatGPT × Geminiという共生モデルを解説します。
https://amzn.to/4a2dJjC
『ゼロから触ってわかった!スペック駆動開発入門 ― SaaS is dead?AI時代のソフトウェア設計論』
前半では思想や背景を丁寧に整理し、後半ではスペック・実装・実行の三層モデルをサンプルコードとともに具体化します。
https://amzn.to/3RFEZya
Databricks
『ゼロから触ってわかった!Azure × Databricksでつくる次世代データ基盤 非公式ガイド ―』
クラウドでデータ基盤を作ろうとすると、Azure・Storage・ネットワーク・権限・セキュリティ…
そこに Databricks が加わった瞬間、一気に難易度が跳ね上がります。 “最初のつまづき” を丁寧にほどいていくのが本書です。
https://amzn.to/3QaOzbW
『Databricks──ゼロから触ってわかった!AI・機械学習エンジニア基礎 非公式ガイド』
Databricksでの プロンプト設計・RAG構築・モデル管理・ガバナンス を扱うAIエンジニアの入門決定版。
生成AIとデータエンジニアリングの橋渡しに必要な“実務の型”を体系化しています。
資格本ではなく、実務基盤としてAIを運用する力 を育てる内容です。
https://amzn.to/3PYK4ku
『Databricks認定データエンジニアプロフェッショナル 試験レベル ― 1日3分!気になったところから読めるデータブリックス!魂の100本ノック!』
本書は、Databricks認定データエンジニア・プロフェッショナル相当の論点を、
100個のユースケースに分解し、**“2択の検討”→“解説コラム”→“結論”**でテンポよく叩き込む「魂の100本ノック」です。
暗記ではなく、現場で遭遇する判断ポイント(取り込み・変換・品質・共有・監視・性能/コスト・セキュリティ・ガバナンス・デプロイ・モデリング)を、短い読書時間で反復できるように整えました。
https://amzn.to/4vkLm8K
https://amzn.to/4fhNBF5
Databricks Advancedシリーズ(上/中/下)
Databricksを “設計・運用する” ための完全版実践書
「ゼロから触ってわかった!Databricks非公式ガイド」の続編として誕生した Advancedシリーズ は、
Databricksを触って慣れた“その先”――本格運用・チーム開発・資格対策・再現性ある設計 に踏み込む構成です。
📘 [上]開発・デプロイ・品質保証編
https://amzn.to/4dGQoGv
📘 [中]取込・変換・監視・コスト最適化編
https://amzn.to/49zbPHb
📘 [下]セキュリティ・ガバナンス・トラブルシュート・最適化戦略編
https://amzn.to/4efDkIk
「ゼロから触ってわかった!Databricks × Airbyte」
クラウド時代のデータ基盤を“なぜ難しいのか”から丁寧にほどくガイドが完成しました。
Ingestion / LakeFlow / DLT / CDC をやさしく体系化し、
Airbyte × Databricks の真価を引き出す設計思想まで詰め込んだ一冊です。
https://amzn.to/3XOlV0t
『Databricks──ゼロから触ってわかった!DatabricksとConfluent(Kafka)連携!非公式ガイド』
Kafkaによるストリーム処理とDatabricksを統合し、リアルタイム分析基盤を構築するハンズオン形式の一冊。
イベント駆動アーキテクチャ、リアルタイムETL、Delta Live Tables連携など、
モダンなデータ基盤の必須スキルがまとめられています。
https://amzn.to/42HdmqZ
Salesforce
『ゼロから触ってわかった!Salesforce AgentForce + Data360(Data 非公式ガイド』
Salesforceの最新AI基盤 AgentForce と Data360(Data Cloud) を、実際の操作を通じて理解できる解説書。
https://amzn.to/4u4PyZ2
要件定義(上流工程/モダンデータスタック)
『モダンデータスタック時代の シン・要件定義 クラウド構築大全 ― DWHからCDP、そしてMA / AI連携へ』
クラウド時代の「要件定義」って、どうやって考えればいい?
Databricks・Snowflake・Salesforce・n8nなど、主要サービスを横断しながら“構築の全体像”をやさしく解説!
DWHからCDP、そしてMA/AI連携まで──現場で使える知識をこの一冊で。
https://amzn.to/4nZm0ux
データメッシュ
####『ゼロから触ってわかった データメッシュ入門 ― 思想・型・組織構造から考えるデータメッシュ』
「Data Mesh を導入すべきかどうか」を断言する本ではありません。
自分たちにとって、どこまで分散し、何を共有し、どこに責任を置くのか。
その判断をするための思考の土台を整理する一冊です。
https://amzn.to/3REkyBS
データクリーンルーム
ゼロから触ってわかった データクリーンルーム実践入門 ~ Lakehouse時代のクリーンルームを、思想・設計・マネタイズで読み解く ~
データはあるのに、渡せない。それでも一緒に分析したい——そんな現場の悩みから、本書は始まります。
データクリーンルームを「難しい技術」ではなく、現実の業務でどう使い、どう続けるかという視点で整理しました。
非ITのビジネスパーソンにも読める、実践的な一冊です。
https://amzn.to/4fiG6O2
MCP
『ゼロから触ってわかった!MCPビギナーズガイド』 ― AIエージェント時代の次世代プロトコル入門 アーキテクチャ・ガバナンス・実装―
MCPというプロトコルは、単なる技術トレンドではなく
「AIとシステムの関係性」そのものを変える可能性を秘めています。
SaaS、AIエージェント、ガバナンス、アーキテクチャ、その交差点を一度、立ち止まって整理した一冊です。
https://amzn.to/4nZm0ux
n8n
『n8n──ゼロから触ってわかった!AIワークフロー自動化!非公式ガイド』
オープンソースの自動化ツール n8n を “ゼロから手を動かして” 学べる実践ガイド。
プログラミングが苦手な方でも取り組めるよう、画面操作中心のステップ構成で、
業務自動化・AI連携・API統合の基礎がしっかり身につきます。
👉 https://amzn.to/48Blxca
💡 まとめ:このラインナップで“構築者の視点”が身につく
これらの書籍を通じて、
クラウド基盤の理解 → 要件定義 → 分析基盤構築 → 自動化 → AI統合 → 運用最適化
までのモダンデータスタック時代のソリューションアーキテクトとしての全体像を
「体系的」かつ「実践的」に身につけることができます。
PoC要件整理
データ基盤の要件定義
チーム開発/ガバナンス
AIワークフロー構築
トラブルシュート
など、現場で直面しがちな課題を解決する知識としても活用できます。
