【2025年末版】音声AIの選び方。「対話力」と「表現力」で読み解く最新地図

毎日新しいAIツールが登場して、タイムラインを追うだけでも一苦労。そんな状況になってないかな? 🚀
特に「音声AI」の進化は凄まじくて、YouTubeやSNSで流れてくるナレーションを聞いても、「あれ? これ本当にAIなの?」と耳を疑うことが増えたよね。
一昔前の「ロボットボイス」なんて言葉は、もう死語になりつつある。
正直なところ、僕も最近のデモを聞いて「これ、人間が喋ってるんじゃないの?」って疑っちゃうことが何度もあるんだ。
でも、ここまで品質が上がると逆に困るのが、「結局、どれを使えばいいの?」という贅沢な悩みだ。
「人間並み」はもう当たり前。
いま起きているのは、単なる品質競争じゃなくて、もっと根本的な「役割の分化」なんだ。
今日は、2025年12月期の最新技術レポートを読み解きながら、カオスに見える音声AIの世界を「構造」で整理してみようと思う。
特定のサービスをおすすめするだけの記事じゃないよ。
最新の「Flow Matching」という技術革新から、話題の「OpenAI Realtime API」と「ElevenLabs」の違い、そしてスマホで動く驚異のモデル「Kokoro-82M」まで。
これを読めば、無数にあるツールの中から、あなたのプロジェクトに最適な「声」を選ぶための最新の地図が手に入るはずだ。
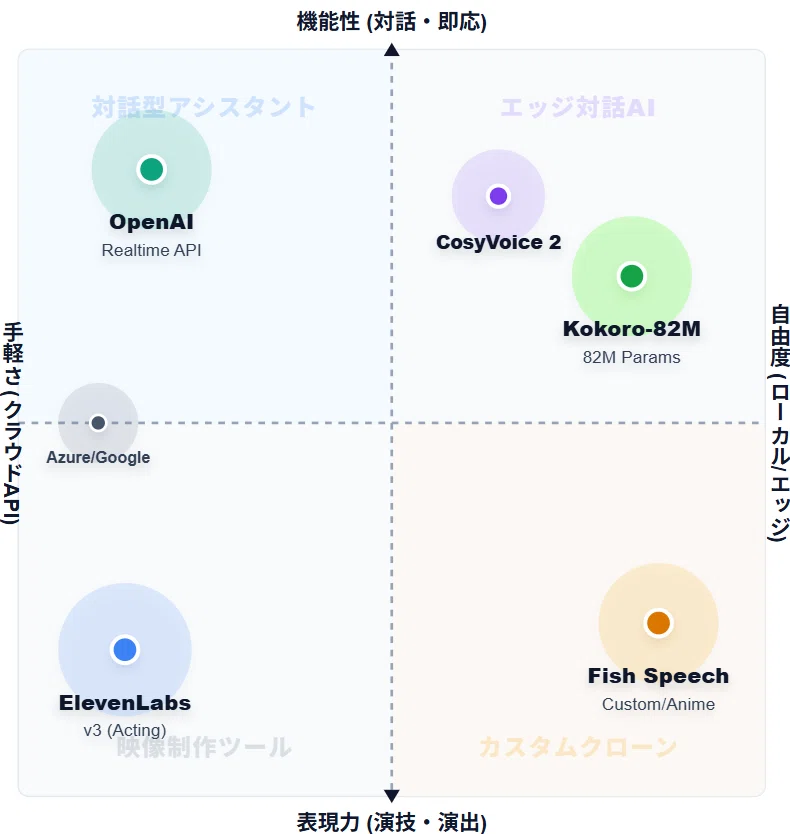
結論から言うと、これからの選び方の鍵は、「対話力(即応性)」と「表現力(演技)」のどちらを優先するか、というトレードオフにあるんだ。
さあ、新しい声の地図を広げてみようか。 ✨
技術の進化論:なぜAIは「間」を操れるようになったのか
まず、少しだけ時計の針を戻して、技術の裏側にある「仕組み」の話をしよう。
なぜ、ここ数年で急にAIの声が自然になったのか。その理由を知ると、ツールの選び方がぐっと面白くなるんだ。
🍳 「読む機械」から「意味を理解するパートナー」へ
これまでの音声合成(Text-to-Speech)は、テキストをルール通りに音声波形に変換する「読み上げ機」だった。
イントネーションは正しいけれど、どこか冷たい。そんな印象を持っていた人も多いと思う。
でも最新のモデルは、言葉の裏にある「文脈」や「感情」を理解しようとしている。
「ここは悲しい場面だから、声を震わせよう」とか「ここは急いで伝えなきゃ」といった判断を、AIが自律的に行っているんだ。
ここで重要なキーワードが2つある。「Flow Matching(フローマッチング)」と「DualAR(デュアル・オートリグレッシブ)」だ。
ちょっと難しそうな名前だよね。料理で例えてみようか。
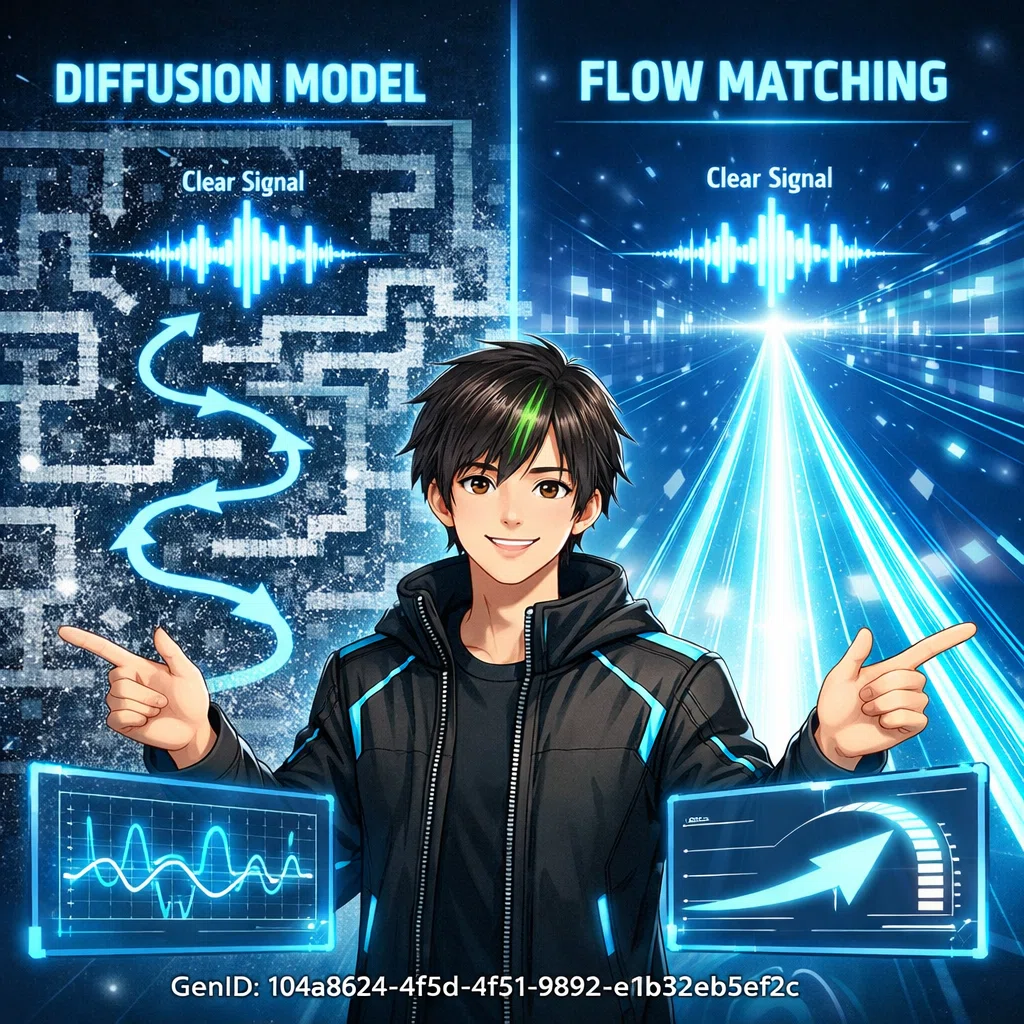
🏎️ 「Flow Matching」は、手際の良いシェフ
以前の主流だった「拡散モデル(Diffusion Model)」は、ノイズ(雑音)だらけの状態から、何度も何度も味見をして(推論ステップを重ねて)、少しずつ美味しいスープ(音声)に近づけていく手法だった。
味(品質)は最高なんだけど、とにかく調理に時間がかかるのが難点だったんだ。
リアルタイムで会話しようとすると、どうしても「待ち時間」が発生してしまう。
対して、2025年のトレンドである「Flow Matching」は、最初から「完成形の味」への最短ルートを知っているシェフみたいなものだ。
迷いなく一直線に調理するから、計算量が劇的に減って、提供スピード(生成速度)が爆速になった。
最新のレポートによると、F5-TTSやCosyVoice 2といったモデルは、この技術のおかげで、人間と変わらない速度(遅延150ms〜200ms程度)での会話を実現している。
これは人間が「遅い」と感じる限界(約300ms)を下回る数字だ。
だからこそ、今のAIは「考えながら喋っている」ように感じるほどスムーズなんだよ。
🎭 「DualAR」は、脚本家と役者の分業
もう一つの「DualAR」は、Fish Speechなどが採用している手法で、作業を「意味の理解(Semantic)」と「声の生成(Acoustic)」の2段階に分けている。
脚本家(Semantic): まずテキストを読んで、「ここは悲しそうに」「ここは強調して」という演技プラン(意味トークン)を練る。
役者(Acoustic): そのプランを受け取って、実際の声色や抑揚(音響トークン)を乗せる。
この「分業」のおかげで、長文を読ませても感情が平坦にならず、文脈に沿った自然な演技ができるようになった。
「End-to-End」と呼ばれる従来の手法で起きがちな、「読み上げのっぺり問題」を見事に解決したアーキテクチャなんだ。
市場の二極化:「即応する知能」vs「演じる表現者」
技術の仕組みがわかったところで、市場の地図を見てみよう。
いま、商用サービスは大きく2つの方向に進化している。これが今回の記事のメインテーマだ。
⚡️ 【タイプA】会話のキャッチボールを極める「対話力」
一つ目は、OpenAIのRealtime APIに代表される「対話特化型」だ。
彼らが目指しているのは、「思考する音声インターフェース」。
これまでのAI対話は、「音声認識(耳)」→「テキスト生成(脳)」→「音声合成(口)」というバケツリレーをしていた。
でも最新のモデルは、「Audio-to-Audio」。
つまり、音声を直接AIが聞いて、直接音声で返す。テキストという中間管理職を省いたんだ。
これの何が凄いかって、「笑い声」や「言い淀み(えーっと、など)」、そして相槌のタイミングまで含めて、会話の「間(フロー)」を支配している点だ。
遅延も人間が違和感を感じないレベル(数百ミリ秒)まで削ぎ落とされている。
CosyVoice 2などのオープンソースモデルもこの領域に参入していて、ストリーミング生成での遅延を極限まで減らしている。
英会話の練習相手や、カスタマーサポートの自動応答など、「テンポ」が命の現場では、このタイプAが最強の選択肢になる。
向いている用途: 英会話アプリ、電話応対ボット、リアルタイム通訳、車載アシスタント。
コスト感: OpenAIの場合、入力音声100万トークンあたり約0.60ドル、出力は約2.40ドル。安くはないけど、体験価値は圧倒的だ。
https://openai.com/index/introducing-the-realtime-api/
🎬 【タイプB】監督の指示通りに泣く「表現力」
二つ目は、ElevenLabsやFish Speechのような「メディア生成特化型」だ。
彼らは、コンテンツ制作のための「ディレクターズ・ツール」としての道を突き進んでいる。
例えば、小説の朗読で「悲しげに、でも少し希望を持って」なんて指示、普通のAIには無理だよね。
でもElevenLabs v3なら、テキストの中に [sighs](ため息)や [whispers](ささやき)といったト書きを入れることで、声色を自在に操れる。
これはもはや「読み上げ」じゃなくて「演技」だ。
Fish Speechも負けていない。
特に日本のアニメやゲームのデータを大量に学習しているから、「ツンデレ」や「絶叫」といった、感情の振れ幅が大きい演技が得意なんだ。
ナレーションやゲームのキャラボイスを作るなら、間違いなくこっちの領域だね。
向いている用途: YouTube動画のナレーション、オーディオブック、ゲームのNPCボイス、映画の吹き替え。
コスト感: ElevenLabsのBusinessプランで1000文字あたり約0.06〜0.10ドル相当。高品質な分、コストは高めになる傾向がある。
[疑わしいリンクは削除されました]
実行環境のシフト:巨大クラウドから、手のひらのエッジへ
もう一つ、2025年の面白い変化として、「場所」の移動がある。
これまでは「高品質なAI音声=巨大なGPUサーバーが必要」というのが常識だった。
でも、その常識をぶち壊す存在が現れたんだ。それが「Kokoro-82M」だ。 🚀
📱 スマホに住める天才AI「Kokoro-82M」
名前の通り、パラメータ数がわずか82M(8200万)。
最近のLLMが数億、数十億パラメータであることを考えると、驚異的な小ささだ。
「StyleTTS 2」というアーキテクチャをベースに徹底的に軽量化(蒸留)されていて、なんとVRAM 1GB未満でも動作する。
これの意味するところ、わかるかな?
そう、一般的なノートPCやスマホの上で、オフラインで動くってことだ。
しかも、音質は商用モデルと比べても遜色ない。
「安かろう悪かろう」ではなく、「軽くて速くて上手い」という、とんでもない新人が現れたわけだ。
ライセンスもApache 2.0で商用利用や改変が自由というのも、開発者にとっては涙が出るほど嬉しいポイントだね。
🔒 プライバシーとコストの革命
クラウドを使わないメリットは計り知れない。
まず、通信環境がない場所でも喋れる。
そして、プライバシーに関わる会話も外部に漏れない。
スマート家電や、子供向けのおもちゃ、あるいは機密情報を扱う社内システムなど、「外に出したくない」データには最適解になる。
それに、API利用料がかからないから、どれだけ喋らせてもタダ(電気代のみ)だ。
「クラウド破産」を恐れずに、思う存分AIとお喋りできる未来が、もう手元にあるんだよ。
もしあなたがエンジニアで、「コストを抑えたい」「オフラインで動かしたい」と考えているなら、間違いなくKokoro-82Mはチェックすべき選択肢だね。
日本語環境における「壁」と、それを超えるアプローチ
最後に、僕たち日本のユーザーがどうしても直面する「壁」について話しておこう。
そう、「ピッチアクセント」と「アニメ文化」だ。
🥢 「箸」と「橋」の違い、AIはどう乗り越えた?
日本語は、音の高さ(ピッチ)で意味が変わる面倒な言語だ。
「箸(はし)」と「橋(はし)」と「端(はし)」。文字だけ見ても、どう読むべきかは文脈次第だよね。
海外製のモデルだと、ここがどうしても不安定になりがちだった。
商用API(Azure, Google):
さすがの巨人たち。膨大な辞書データとルールベースの処理が強力で、ニュース読みのような正確さは依然として最強クラスだ。絶対に読み間違えられないビジネス文書なら、彼らが頼りになる。
オープンソース(Kokoro, Fish Speech):
ここも進化している。Kokoroは、misakiという日本語処理ライブラリを使って、アクセントを正確に教え込むアプローチをとっている。
一方、Fish Speechは、大量のアニメやゲームのデータを学習させることで、「統計的」に自然なイントネーションを習得している。
📢 アニメ的表現への渇望と「演技」の壁
日本には「キャラボイス」への強いこだわりがあるよね。
「ツンデレ」や「叫び声」、「萌え声」みたいな極端な感情表現は、一般的なナレーションモデルでは難しい。
Azureの綺麗な声で「あんたなんか大っ嫌い!」と言われても、ちょっと違うな…ってなるでしょ?
ここで輝くのが、やはりFish Speechのようなモデルだ。
日本のサブカルチャーデータを大量に学習しているから、「演技がかりすぎた声」を出すのが得意なんだ。
ユーザーは [angry] や [sneering](冷笑)といったタグを使って、声色をコントロールできる。
ただ、注意点もある。
一般的な企業の電話応対やマニュアル読み上げにこれらのモデルを使用する場合、デフォルト設定では「感情過多」になりがちだ。
TPOに合わせて、モデルやプロンプトを使い分けるセンスが問われるね。
言葉の裏側にある「身体性」という情報
今回の記事を書きながら考えたのは、AIが「身体性」を獲得しつつあるんじゃないか、ということ。
ここからは少し、僕の個人的な考察(深掘りコラム)にお付き合いしてほしい。
😮💨 言葉じゃない「ため息」や「間」が伝えるもの
これまでのAI音声は、あくまで「情報の伝達手段」だった。
テキストに書かれた情報を、音声波形に変換して届ける。それ以上でもそれ以下でもなかった。
でも、OpenAIのRealtime APIが実装した「言い淀み」や「笑い」、ElevenLabsが表現する「ため息」は、情報量としてはゼロ(ノイズ)だ。
テキストに書き起こせば「(笑)」や「...」でしかない。
けれど、コミュニケーションにおいては、このノイズこそが「相手への共感」や「思考のプロセス」を伝えているんだよね。
僕たち人間も、言葉だけで会話してるわけじゃない。
ため息一つで「あ、疲れてるな」と察したり、笑い声で「敵意はないよ」と伝えたり、0.5秒の沈黙で「言いにくいことがあるんだな」と感じ取ったりする。
🤝 Audio-to-Audioが変えるコミュニケーションの質
AIがこの「非言語領域」に踏み込んできたことは、実は言葉を流暢に喋れるようになったこと以上に、大きなブレイクスルーなんじゃないかな。
「Audio-to-Audio」モデルの登場によって、AIはテキストを介さずに、声のトーンから直接感情を読み取り、声のトーンで直接感情を返すことができるようになった。
これは、AIが単なる「検索エンジン」や「道具」から、「気配を感じられるパートナー」へと進化したことを意味している。
これからは、AIの「知能」だけでなく、その「振る舞い」や「声の表情」をどうデザインするかが、クリエイターの腕の見せ所になりそうだね。
まとめ
今回の旅、どうだったかな?
最後に、2025年の音声AI選びの「羅針盤」をまとめておくね。
「会話」を作りたいなら 👉 OpenAI Realtime API や CosyVoice 2。
遅延を極限まで削って、テンポの良いキャッチボールを目指そう。英会話やカスタマーサポートに最適だ。
「作品」を作りたいなら 👉 ElevenLabs や Fish Speech。
監督として細かい演技指導を行い、最高の表現を引き出そう。ナレーションやゲーム制作にはこちら。
「コスト」と「プライバシー」を重視するなら 👉 Kokoro-82M。
エッジAIの可能性は無限大だ。通信なしで動くアプリを作るなら、これ一択と言ってもいい。
技術はあくまでツールだ。
大切なのは、その声を使って、あなたが「誰と、どんな時間を過ごしたいか」という設計図にある。
さあ、あなたのプロジェクトには、どの座標の声が必要かな?
もし「こんな用途にはどれがいい?」なんて迷ったら、コメントで教えてよ。一緒に最適な声を探しに行こう! 🤝
Miccell - 次はあなたのPCが喋り出す番かもね。
