計画はGPT-5.6、実行はClaude——2026夏の使い分け術
こんにちは、キャプテンJ.T.です。
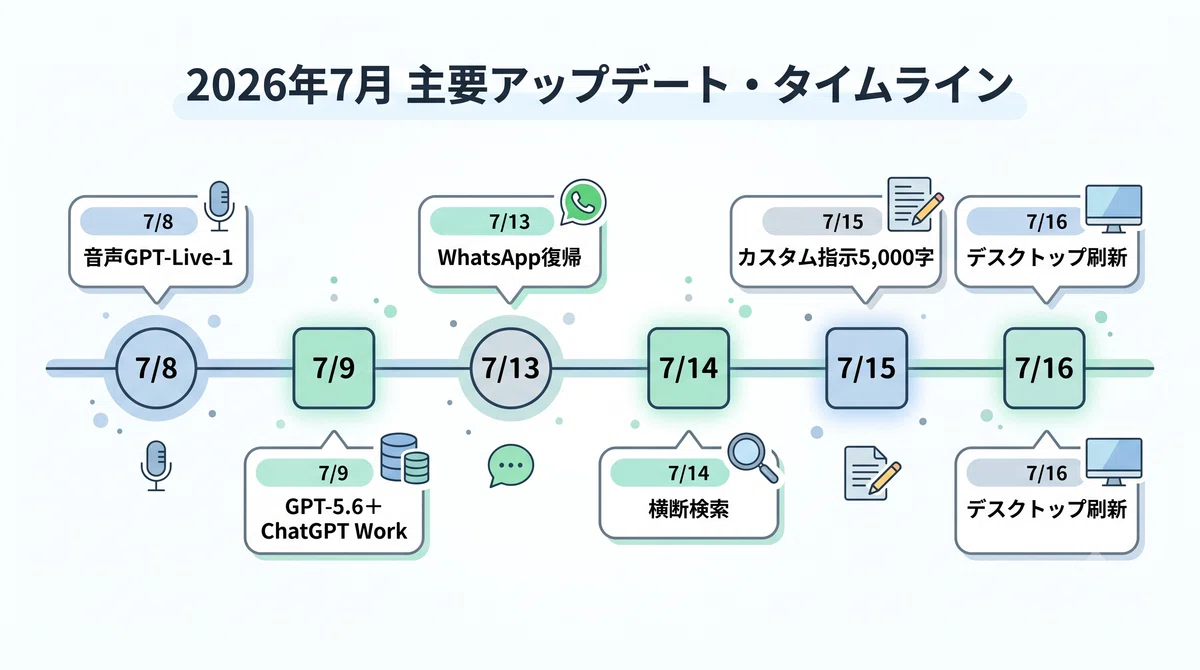
2026年の夏、ChatGPTが立て続けに“化けた”。7月8日にリアルタイム音声「GPT‑Live‑1」、翌9日には新モデル群「GPT‑5.6(Sol/Terra/Luna)」と、仕事を丸ごと任せるエージェント「ChatGPT Work」。ほんの数日で、道具の姿が変わった。
僕は普段、Claude(Claude Code/Cowork)を主戦力にしている。だから今回も「どこまでやれるのか、お手並み拝見」くらいの気持ちだった。
でも触って実感が変わった。ChatGPTは5.5の頃から性能は認めていたが、5.6は5.5より体感で明らかに速い。そして検証・検収(出したものの正しさチェック)が正確だ。
この記事は、Claude使いの僕がGPT‑5.6を実務で試した正直レビュー。「どこが本当に効くのか」「どう使い分けると強いのか」を、数字と一次ソースで確かめていく。
🧭 まず“GPT-5.6”の全体像を押さえる
新モデルは1つじゃない。用途で選べる3階層になったのが今回の設計思想だ。
Sol:最上位のフラッグシップ。コーディングと難タスク担当の“主戦力”
Terra:バランス型。より安いコストで実力を回せる中間モデル
Luna:とにかく安く軽く、数をこなす低コスト用途向け
3つとも同じ「GPT-5.6」ファミリーで、2026年7月9日に一般公開(OpenAI公式)
当初は米政府がサイバーセキュリティ上の懸念で公開を制限していたが、7月上旬に解除された経緯もある(TechCrunch)。
「全部入りの1個」ではなく、「重機とバイクと自転車を使い分ける」イメージ。仕事の重さでモデルを選べるようになった、と考えると分かりやすい。
🧠 その1:速い。そして“検証”が正確
僕がGPT-5.6で一番効くと感じたのは、スピードと“検証・検収の正確さ”だ。 出したものをもう一度チェックさせる使い方が、実務でとにかく効く。
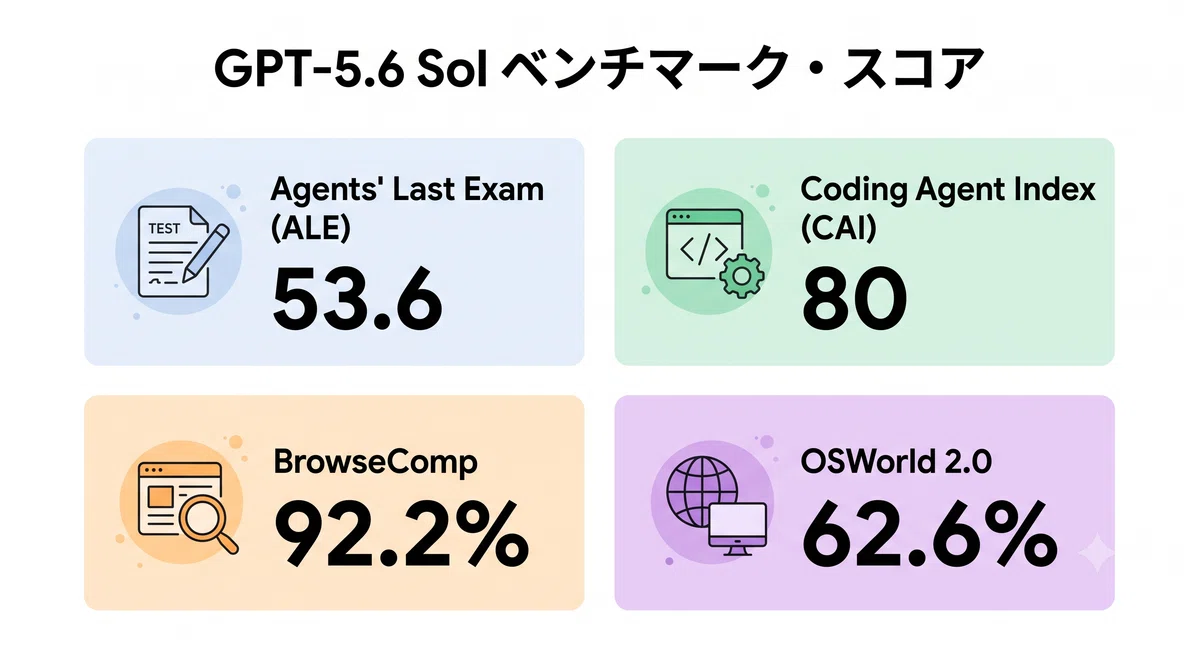
数字の裏づけもある。長時間の実務ワークフローを55分野で測る「Agents' Last Exam」でSolは53.6点。競合のClaude Fable 5を13.1点引き離した(OpenAI公式)。
コーディングのCoding Agent Indexで80点、Web調査のBrowseCompで92.2%と、知識作業でも上位(出典同上)。一方、PC操作エージェントの指標「OSWorld 2.0」は62.6%で、ここはまだ発展途上だ。
効いてくるのはコストだ。中程度の推論でClaude Fable 5に並ぶ性能を約1/4のコストで、TerraやLunaは約1/16のコストで上回るという(同・OpenAI公式/ALE基準)。
「賢いAIは高い」という前提が崩れた。 外部の後押しもあり、Microsoft 365 CopilotはGPT-5.6を推奨モデルに採用している(7月9日、OpenAI)。
ベンチマークは“模試の偏差値”みたいなもので、実務の相性とはまた別。そこは差し引いて読んでほしい。
🎙️ その2:“手足”はついた。実例とクセ
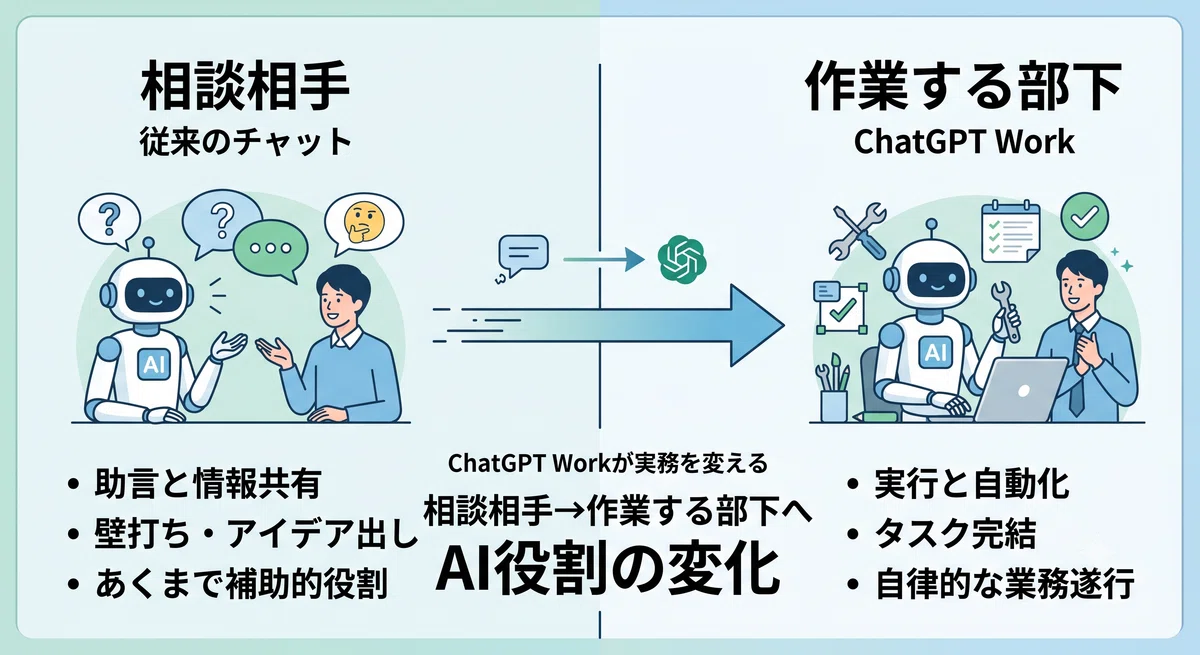
2026年のChatGPTは、答えるだけでなく「話す」「作業する」側に踏み込んだ。
音声の「GPT‑Live‑1」は、聞きながら同時に話せるフルデュプレックス方式(OpenAI)。そして「ChatGPT Work」は、1,400以上のアプリ連携や資料・スライド作成、定期タスクまでこなすエージェントだ(OpenAI)。
実際に効いた場面がある。バックオフィスの定例業務を棚卸しして、非効率な手作業を洗い出し、自動化案を優先度つきの表にしてもらった。叩き台が出るまで、あっという間だった。
投げた依頼はシンプルだ。「◯◯部門の月次業務を工程ごとに分解して、手作業で非効率な箇所を特定し、自動化案を効果×手間の優先度つきの表にして」——この段取りを一息で返してくる。
体感では、これまで10分ほどかけていた棚卸しが、3分ほどで形になった。精度も上がり、後の手戻りも減った。
ただし手放しではない。ChatGPT Workは、正直まだ使い方が分かりづらいところがある。 高機能なぶん、どこから何を渡せばいいか迷う場面があった。
🧵 その3:昨日の続きから話せる“記憶”
単発の便利さより、「覚えていること」の方が実務ではずっと効く。
2026年に入って、ChatGPTのメモリ(会話の文脈・好み・プロジェクト情報の保持)が強化された。あわせて、チャットやドキュメントの横断検索、デスクトップ刷新とクロスデバイス同期も入った(OpenAI公式リリースノート)。
実務で地味に効くのがカスタム指示だ。上限が1,500字から5,000字へ拡張された(Plus/Pro等の有料プラン向け。無料は据え置き)。
毎回イチから説明し直す時間が、まるごと消える。 自分の役割・前提・書式ルールを積んでおけば、要件を渡すだけで文体まで揃った成果物が返ってくる。AI活用のボトルネックは、たいてい「毎回の前提共有」だからだ。
🔭 結論:「計画はGPT、実行はClaude」
僕の実運用での結論はこうだ。2026年のAI活用は“どれが最強か”より“どう組み合わせるか”。 実際の振り分けを表にする。
計画・段取り・要件整理 → GPT-5.6(速く検証が正確/数値と最新性は自分で確認)
人・チームへの説明資料 → GPT-5.6(説明が的確で分かりやすい/固有名詞と事実を確認)
ファイル・フォルダ操作/実行 → Claude(Sonnet 5・Opus 4.8)(ローカル操作に強い/実行結果を目視)
コード実装・重い処理 → Claude(Opus 4.8)(玄人の実行力/最終テストは人)
この分担には理由がある。僕のPCはUNIXではなくWindowsで、フォルダを直接触らせるとChatGPTは詰まる場面があった。
PC操作の指標OSWorld 2.0が62.6%とまだ発展途上なのは、この体感とも重なる。だから実行は今もClaudeに任せている。
逆に意外だったのが説明の分かりやすさ。人への説明は、Claudeより GPT-5.6の方が的確だと感じた。 ここは素直に一本取られた。
たとえば、会社への作業報告。Claudeはファイル名や処理名が多く、業務報告としては全体像が掴みにくい場面があった。GPT-5.6は、人にも分かる文章と単語選びで書いてくれた。
どのAIを使っても、随時チェックは自分でやると決めている。今はClaude Coworkの出番が多いが、Skillのエージェント化やローカルのリポジトリ操作を通じて、「ChatGPTだけでどこまでできるか」も試していくつもりだ。
✅ まとめ:2026夏、私の使い分け
GPT-5.6は速くて検証が正確。計画・段取り・人への説明に強い
Voice/Workで“作業する”側へ。実務プランニングの叩き台は一息で出た。ただしWork UXにはクセ
ファイル操作やOSまわりは、まだClaudeに一日の長。適材適所で組む
どのAIも、随時チェックは人がやる前提で任せるのが結局いちばん速い
まず試すなら、いま抱えている定例業務を1つ、GPT-5.6に「工程を分解して自動化案を優先度つきの表に」と投げてみてほしい。5分で“叩き台”の速さが分かる。
あなたは、計画と実行をどう振り分けている? よければコメントで教えてほしい。
🛠️ 製作ノート
この記事は、元にしたレポートをそのまま載せず、数字を一次ソースで検算してから書いた。実際、あるベンチマークの値(OSWorldの数字)が元資料と公式で食い違っていたので、公式値に直している。この“検算”こそ、AIを仕事で使うときに人がやるべき仕事だ。
AI活用・自動化の実践知を、これからも「再現できる形」で発信していく。役に立ったら、スキとフォローで教えてもらえると励みになる。
ではまた、次回、新たな発見と共にお会いしましょう!
