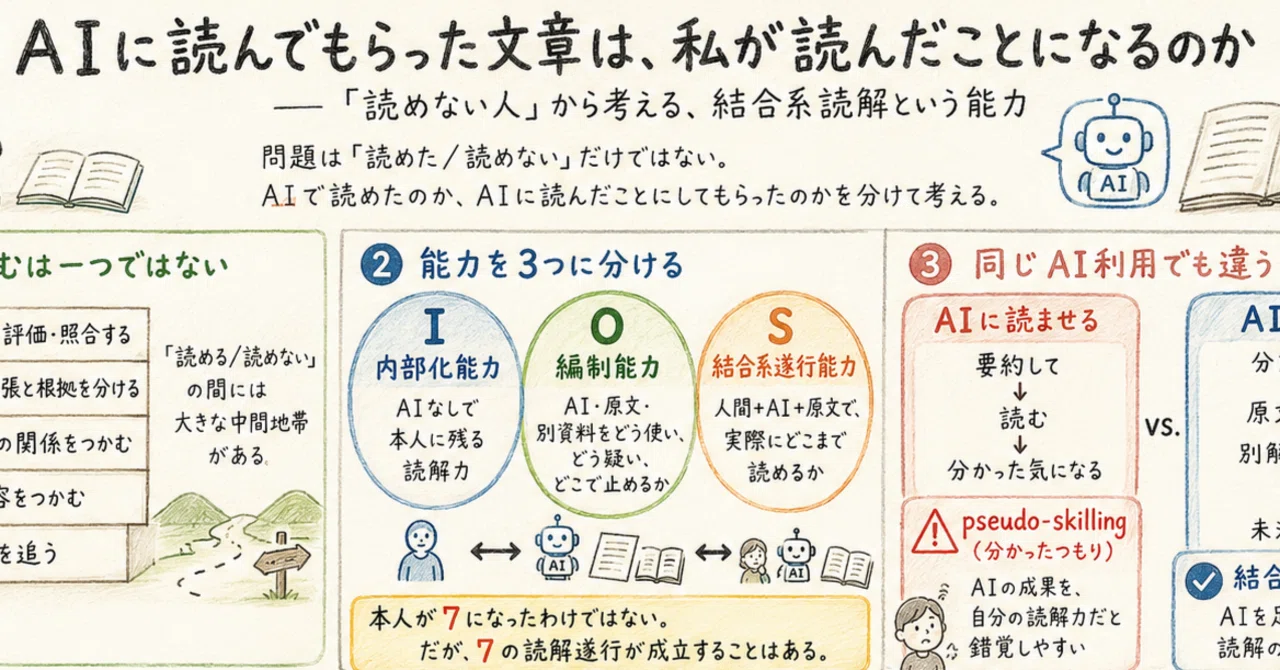
AIに読んでもらった文章は、私が読んだことになるのか――「読めない人」から考える、結合系読解という能力

AIに読んでもらった文章は、私が読んだことになるのか
――「読めない人」から考える、結合系読解という能力
文章を読む。
簡単そうに見える。
文字を見る。
意味を取る。
分かる。
終わり。
本当にそうだろうか。
たとえば、
生きることと死ぬことは同じことである。
という文章があったとする。
文字は読める。
「生きる」も分かる。
「死ぬ」も分かる。
「同じ」も分かる。
では、
この文章を読めたのか。
ここから急に怪しくなる。
何が同じなのか。
生物学的な生と死が同一だと言っているのか。
「古い自分が死に、新しい自分が生まれる」という比喩なのか。
宗教的な表現なのか。
作者自身の経験なのか。
人間一般についての主張なのか。
さらに、
これは事実主張なのか。
解釈なのか。
評価なのか。
比喩なのか。
文字列は読めても、ここまでは自動的には決まらない。
どうも私たちは、
文字が読める
と、
文章が読める
を、ずいぶん簡単に一緒にしてきたらしい。
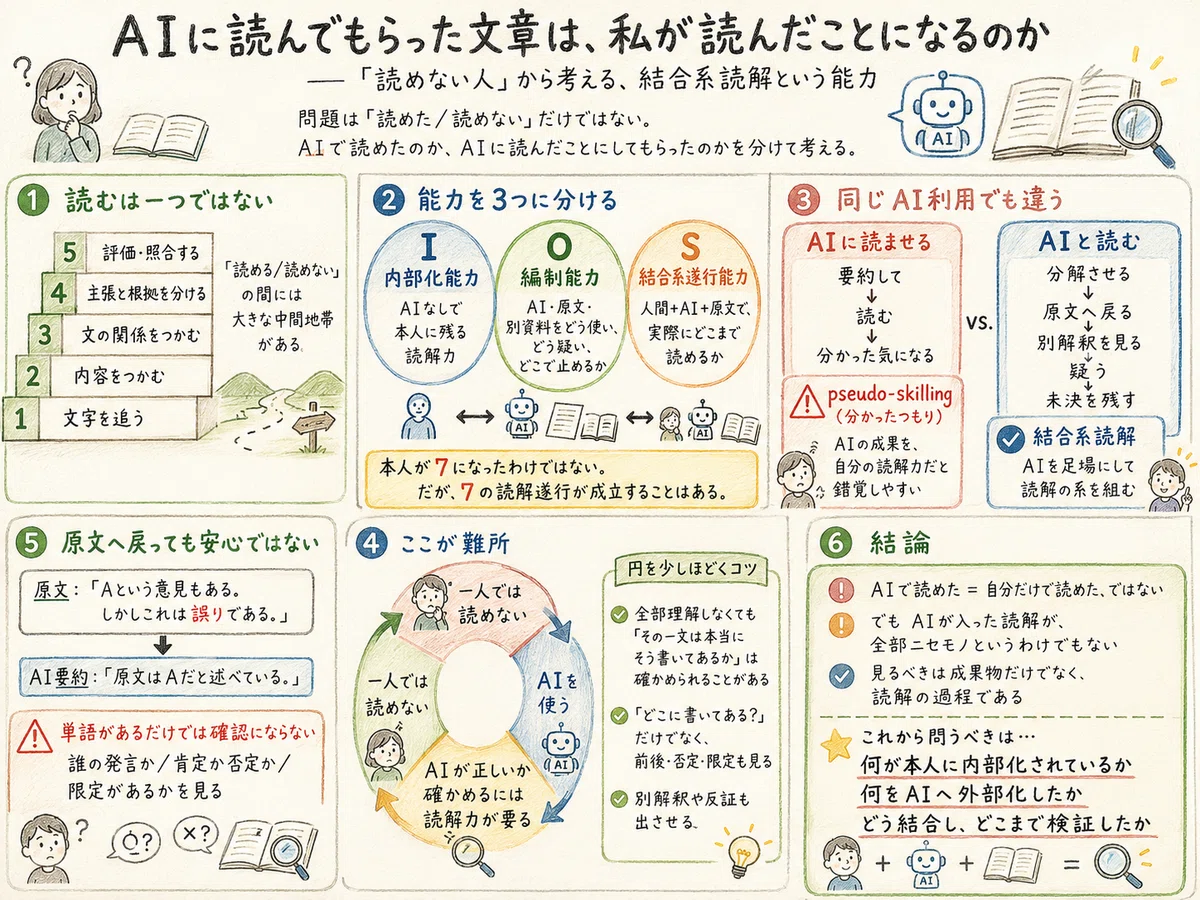
この文章でいう「読む」は、文字を音にすることだけではない
最初に範囲を決めておこう。
ここで扱う「読む」は、文字を認識することだけではない。
少なくとも、
書いてある情報を取る。
文と文の関係をつかむ。
文章全体へ統合する。
主張と根拠を分ける。
必要なら、その主張を評価する。
さらに必要なら、原典や別資料と照合する。
ところまで含む。
もちろん、これらは同じ能力ではない。
仮に分けるなら、
文字列を追う。
↓
明示された内容を取る。
↓
複数の文を結びつける。
↓
主張や論証を評価する。
↓
外の資料と照合する。
という段階がある。
これは私の作業上の分け方であって、既存の読解研究の正式な尺度ではない。
ただし、「読む」が一枚岩ではないという点そのものは、成人技能調査でもはっきりしている。
OECDの成人技能調査PIAACでは、識字能力を段階的に測っている。
日本は参加国の中でもかなり高い。
それでも、16~65歳の成人のうちLevel 1以下が約10%いる。一方で、数ページにわたる密度の高い文章を理解・評価し、隠れた意味まで扱えるLevel 4~5は約23%である。残りの大部分は、その間にいる。
ここで大事なのは、
日本人の何割が「読めない」
とラベルを貼ることではない。
PIAACのLevel 1以下を、そのまま「機能的非識字」と呼ぶことでもない。
そうではなく、
「読める/読めない」の間には、大きな中間地帯がある
ということである。
「読めない」も一種類ではない
さらに困ったことに、
「読めない」
の原因も違う。
十ページ読むと、最初を忘れる。
これは長さや認知負荷の問題かもしれない。
一文ずつは分かるのに、
これは作者の主張なのか。
他人の説を紹介しているのか。
反論しているのか。
が分からない。
これは談話構造の問題かもしれない。
文章の構造は追える。
しかし、
統計。
物理学。
哲学史。
法律。
専門用語が分からない。
これは領域知識の問題である。
そもそも英語やドイツ語で書いてある。
これは言語の問題である。
全部を、
読解力がない
でまとめると粗すぎる。
そして、この違いはAIを使うと重要になる。
なぜなら、
AIが補える場所も、それぞれ違うからである。
そこへAIが来た
長い文章をAIに渡す。
そして聞く。
一段落ずつ説明してください。
できる。
作者自身の主張と、紹介している他人の説を分けてください。
できる。
難しい概念だけ説明してください。文章全体を書き換えないでください。
これもできる。
「だから」「したがって」と書かれているところを抜き出して、本当にその前から結論が出ているか調べてください。
できる。
この要約の根拠になった原文を示してください。
できる。
すると、さっきまで一枚の壁だった文章が、
主張。
根拠。
例。
引用。
比喩。
評価。
推測。
限定。
反論。
という部品に分かれてくる。
ここで変なことが起きる。
一人では読めなかった人が、読めている。
では、
本人の読解能力が上がったのだろうか。
本人が7になったわけではない。しかし7の読解が存在しないわけでもない
前の文章で、私は能力を三つに分けた。
I:内部化能力。
AIを外しても本人に残っている能力。
O:編制能力。
AI、検索、原文、別資料、他の評価者を、
どう選び、
どう疑い、
どう組み、
どこへ戻り、
どこで止めるかという能力。
S:結合系遂行能力。
人間+AI+資料という系全体として、どこまで課題を遂行できるか。
この区別には先行研究がある。
Salomon、Perkins、Globersonは1991年、知的技術について、
effects with technology
と、
effects of technology
を分けた。
前者は機械と一緒に仕事をしている最中に成立する遂行。
後者は機械を外したあと、人間側へ残る認知的変化である。
しかも彼らは、
能力や知能は個人の属性なのか、それとも人間と機械からなるjoint systemの属性なのか。
という問題まで立てていた。
大まかに言えば、
Sはeffects withに近い。
Iの変化はeffects ofに近い。
私がOと呼んでいるのは、
その結合をどう編制し、監視するかを別に取り出したものである。
これを読解へ持っていく。
ある人の単独読解能力が、
仮に、
I=3
だったとする。
数字は説明のためだけのものだ。
長い文章は苦しい。
複数の論点を統合するのも苦しい。
しかしAIに分解させる。
難語を調べる。
該当原文へ戻る。
別の説明を出させる。
反論させる。
すると、
人間+AI+原文という系全体では、
S=7
くらいの仕事ができるかもしれない。
ここで重要なのは、
本人が7になったわけではない。
しかし同時に、
7相当の読解遂行が成立していないわけでもない。
この二つを分ける必要がある。
AIは、誰にでも同じ効果を出すわけではない
これは単なる思いつきでもない。
2025年、Etkinらは195人の大学年齢参加者を対象に、
AI要約。
AIアウトライン。
質問応答型チャット。
ソクラテス式対話チャット。
を使った読解実験を行った。
結果は一方向ではなかった。
もともとの読解成績が低い群ではAI支援によって理解が改善した。
一方、高い群では悪化する場合があった。
特に低成績群にはソクラテス式チャットが有利で、高成績群には要約が悪影響を与えた。
つまり、
AIは読解力を上げるか。
という質問では粗すぎる。
必要なのは、
誰が。
どんな文章を。
どのAI支援で。
どう使ったとき。
である。
同じAIでも結果が違う。
「AIに読ませる」と「AIと読む」は同じではない
一人目。
文章をAIへ渡す。
要約して。
要約を読む。
終わり。
二人目。
まず作者の主張だけ抜いて。
次に、
根拠はどこ?
さらに、
これは事実なのか、作者の解釈なのか分けて。
そして、
あなたは「AがBを引き起こした」と要約した。しかし原文は本当に因果まで言っている?
と戻る。
同じ「AIを使った」でも、
やっていることが違う。
ただし、
この二人を完全な二種類に分ける必要もない。
実際には、
全部任せる。
↓
分からないところだけ聞く。
↓
構造を分けさせる。
↓
原文と往復する。
↓
別資料まで使って検証する。
という連続がある。
重要なのは、
AIを使ったかどうかではなく、どう結合したか
である。
「読めた」と思った。しかし実際には読めていなかった
ここでpseudo-skillingが出てくる。
2015年、Fisher、Goddu、Keilは、インターネット検索をした人が、
外部から得た知識へのアクセスを、
自分自身の内部知識と混同しやすいことを9つの実験で示した。
AIでも同じことが起こり得る。
AIが立派な要約を作る。
本人は、
分かった。
と思う。
しかしAIを外すと説明できない。
あるいは、もっと困ったことに、
AIの要約そのものが間違っている。
2026年には、英国の14~15歳405人を対象にした事前登録RCTも報告された。
LLMだけを使った条件より、
自分でノートを取った条件、
あるいはノートとLLMを組み合わせた条件の方が、
3日後の理解と保持が良かった。
ところが、生徒の多くはLLMを好み、より役に立ったと感じていた。
ここには、
感じた有用性
と、
実際に残った理解
のずれがある。
AIを使ったから悪いのではない。
しかし、
「楽に分かった感じ」と「読解が成立したこと」は同じではない。
そして、円を描いてしまう
ここが一番嫌なところである。
一人では十分読めない。
だからAIを使う。
しかし、
AIが正しく読んだか確かめるには、読解能力が必要である。
読めないからAIを使う。
↓
AIを検証するには読めなければならない。
円を描いてしまった。
では、
結合系読解など最初から無理なのか。
そうとも限らない。
ここで、
文章全体を理解する能力
と、
限定された箇所を照合する能力
を分ける必要がある。
「全部読める」と「ここだけ確かめられる」は違う
たとえばAIが、
この研究は、AがBを引き起こすことを証明した。
と言ったとする。
原文全体を理解するのは難しい。
しかしAIに、
その根拠になった原文を一文だけ出して。
と要求することはできる。
そして実際の原文を見る。
そこに、
This study cannot establish causality.
と書いてあれば、
少なくとも、
AIの要約がおかしいことはかなり見つけやすい。
つまり、
高度な統合理解をAIに補助させ、その一部を、より低い負荷の局所的照合で監査する
という非対称があり得る。
これが、結合系読解が成立する一つの理由である。
完全な円ではなかった。
ただし、
これで問題が全部解けるわけではない。
原文に同じ単語があるだけでは、確認にならない
ここにはもう一つ罠がある。
原文に、
「Aであるという意見もある。しかし、この解釈は誤っている。」
と書いてあったとする。
AIが、
原文はAであると述べている。
と要約する。
本人が原文へ行く。
確かに、
「Aである」
という文字がある。
あった。確認できた。
となる。
しかし実際には、
作者はその説を否定している。
これを、
表層的照合トラップ
と呼んでもよいだろう。
だから、
どこに書いてある?
だけでも足りない。
確認するなら、
その前後を見る。
誰の発言なのかを見る。
肯定か否定かを見る。
「必ず」「可能性がある」「証明できない」のような限定を見る。
そして可能なら、
この要約と矛盾する原文を探して。
ともAIに聞く。
一つの読みだけを出させず、
別の読み方は成立する?
と聞く。
つまりOの仕事は、
難しい問いを、比較的確認しやすい小さな問いへ変換すること
でもある。
ただし、何でも小さな問いにはできない
たとえば、
この比喩は宗教的なのか、心理的なのか。
これは、
原文に同じ単語があるか探しても決まらない。
作者は本当に皮肉で書いているのか。
これも難しい。
この論文の統計モデルは妥当なのか。
専門知識がなければ、一文だけ見ても判断できない。
つまり、
照合できる問い
と、
照合だけでは決まらない問い
がある。
だからOが高ければ、Iが不要になるわけではない。
むしろ、
Oの有効性そのものが、部分的にはIへ依存する。
単純に、
S=I+O+AI
ではない。
より正確には、
Sは、I、O、AIの性能、原資料、課題、検証方法などが組み合わさって決まる。
しかも、それぞれが相互に依存する。
「自分が分からない場所なら分かる」とも限らない
ここも重要である。
よく、
分からないことを分かっていれば大丈夫。
と言う。
しかし、
それが一番難しい場合がある。
本人が誤解していて、
しかも誤解していることに気づいていない。
未知の未知である。
だから、
自分が判定できない場所を全部自覚すればよい。
とは言えない。
そんな保証はない。
できるのは、
判定不能かもしれない場所を外化すること。
AIに、
この説明で、専門知識がない読者には検証できない箇所を挙げて。
と聞く。
別AIに、
前のAIが見落としていそうな前提を挙げて。
と聞く。
原文以外の資料へ行く。
必要なら専門家へ渡す。
それでも見落とす。
だから、
結合系読解は完全検証システムではない。
誤りを発見する回路を増やす仕組みである。
原文へのリンクも、まだ証拠ではない
さらに細かいが重要なことがある。
AIが、
原文のここに書いてあります。
と言った。
それで確認終了ではない。
AIが存在しないページや引用を作ることもある。
したがって、
引用箇所へのポインタは証拠ではない。
本当にその文書を開く。
その文章が実在するか確かめる。
前後を見る。
そこまで行って、ようやく原文照合になる。
これは面倒である。
しかし、
「AIが出典を出した」
と、
「出典を確認した」
は違う。
それでも、AIは読めない人を助けられる
ここまで危険ばかり書くと、
ではAIを使わない方がいい。
となりそうだ。
しかし実証研究は、そう単純でもない。
先ほどのEtkinらの研究では、もともとの読解成績が低い参加者にはAI支援が有利だった。
2024年のAsthanaらの研究でも、専門領域の文章について、
文章全体を簡単にするより、
分からない専門概念を文脈の中で説明する
という支援が検討されている。
彼らの人間評価では、難しい概念をただ易しい単語へ置き換えるより、概念自体を説明する方が好まれた。
つまり、
全文を簡単にして。
しか方法がないわけではない。
分からないところだけ足場を組む
こともできる。
ただし、足場には二種類ある
ここで教育学と少し話がずれる。
Wood、Bruner、Rossが1976年に扱ったscaffolding――足場かけ――は、
まだ一人ではできない課題を、支援者が一時的に助ける教育的な考え方につながった。
普通、教育で足場と言えば、
最終的には足場を外して、
本人だけでもできるようになることが期待される。
つまり、
Iを育てるためのAI
である。
しかし今回の話には、
もう一つある。
AIを外さない。
眼鏡のように使い続ける。
翻訳。
要約。
概念説明。
原文検索。
それらを恒常的に使う。
これは、
Iを育てる足場
というより、
Sを成立させる常設の認知的補助装置
に近い。
どちらが正しいという話ではない。
目的が違う。
学生が基礎読解を学ぶなら、
AIを外しても読めるようになることに意味がある。
一方、市民が難しい行政文書へアクセスしたいなら、
一生かけて法律家並みの読解能力を内部化する必要はない。
AIを常設してもよい。
つまり、
OはIを育てるためにも使える。
Iを代替・補完する恒常的な系を作るためにも使える。
どちらを求めるかは、
場面と目的の問題である。
「簡単にする」には別の危険がある
AIに文章を簡単にしてもらう。
これは実際に理解を助ける場合がある。
Guidrozらは2025年、4563人、31種類の文章を使ったランダム化研究で、LLMによって情報損失を抑えながら簡略化した文章を読んだ参加者は、原文を読んだ参加者より理解テストの正答率が平均3.9ポイント高かった。
PubMed由来の文章では14.6ポイントの差があった。
かなり大きい。
しかし、この研究が示したのは、
簡略化が理解を助け得る
ということである。
すべての意味が完全に保存される。
と証明したわけではない。
実際、NLP研究では、
読みやすさ
と、
意味保存
は別の評価軸として扱われている。
2025年のTSAR共有課題でも、目標とする読みやすさと意味の類似性を別々に評価している。
「簡単になった」
と、
「同じことを言っている」
は同義ではない。
部品を全部理解しても、全体を読んだことにはならない
もう一つ問題がある。
AIは文章を分解するのが得意である。
主張。
根拠。
例。
反論。
と分ける。
これは便利だ。
しかし、
文章全体は、部品の足し算だけではない。
最初はある意味で使われていた言葉が、
途中から少し変わる。
作者が意図的に断定を避けている。
前半では強く言い、
後半では撤回する。
皮肉が全体を通じて効いている。
何度も同じ比喩を変形して使う。
こういうものは、
文章を細切れにすると消える。
局所的には全部分かった。
しかし、
全体として何をやった文章なのか分からない。
ということが起きる。
だから結合系読解には、
分解だけでなく、
再統合
も必要になる。
最後にもう一度、
この文章全体で、問いはどう変化した?
最初と最後で同じ言葉の意味は変わった?
部分ごとの要約では落ちたものは何?
と戻る。
部分へ降りる。
全体へ戻る。
また部分へ降りる。
この往復がいる。
「読める人」が安全とも限らない
逆も考えてみよう。
文章は流暢に読める。
専門用語も知っている。
一人で長文を処理できる。
つまりIは高い。
しかし、
自分に都合のいい証拠だけを拾う。
評価を事実として読む。
相関を因果と読む。
権威ある人物の発言を証拠として扱う。
反対資料を探さない。
この人を、
単純に、
読める人
と呼んでよいのだろうか。
むしろ、
流暢に誤読することもできる。
そしてAIは、
その流暢な誤読を高速化することもできる。
だから、
Iが高い=Oも高い
ではない。
AI時代に問題になるのは、
「読解力の低い人がAIに騙される」
だけではない。
高い内部能力を持つ人が、低い検証編制のまま大量の文章を高速処理する
こともある。
こちらも十分危ない。
だから「読めたか」を一問で試すのもやめた方がいい
従来なら、
この文章を読めますか。
と聞いた。
しかしAIが常用されるなら、
少なくとも三つに分けた方がよい。
AIなしで何ができるか。
Iを見る。
AIを使って何ができるか。
Sを見る。
そのAI利用をどう編制したか。
Oを見る。
たとえば、
原文へ何回戻ったか。
AIの回答を一度でも棄却したか。
別の仮説を要求したか。
未確認部分を残したか。
重要箇所を外部資料で確かめたか。
もちろん、これも完璧な測定ではない。
しかし、
成果物だけを見るよりは情報が多い。
立派な要約が一枚出てきても、
本人が読んだのか。
AIに全部やらせたのか。
その中間なのか。
成果物だけでは分からないからである。
PIAACのような従来型の読解尺度は重要である。
ただし、少なくとも、
人間+生成AIという結合系の遂行や、その編制過程を測る尺度ではない。
AI時代には、別の測定対象が増えたことになる。
「読解の民主化」と簡単には言いたくない
AIによって、
難しい文章へ近づける人は増えるかもしれない。
外国語。
論文。
行政文書。
専門書。
長い解説。
以前なら入口で閉じていた文章へ、
AIを足場にして入れる。
これは大きい。
しかし、
読解の民主化
と呼んで終わるには話がきれいすぎる。
高性能モデルを使えるか。
有料サービスを使えるか。
自分の言語に十分対応しているか。
原典にアクセスできるか。
Oをある程度持っているか。
専門家へ問い合わせられるか。
新しい格差も生じる。
だから今のところ、
もっと地味に、
文章への接続条件が変わっている
くらいにしておきたい。
「誰が読んだのか」という問いまで壊れる
私が文章を読む。
AIに説明させる。
原文へ戻る。
別のAIに反論させる。
辞書を引く。
引用元へ行く。
最後に、
私はある解釈を採用する。
これは、
誰が読んだのだろう。
私か。
AIか。
私とAIか。
たぶん、
「誰が読んだか」
という一問にまとめるからおかしくなる。
分けた方がよい。
誰が文字列を処理したのか。
誰が要約したのか。
誰が原文と照合したのか。
誰が解釈を選んだのか。
誰がその解釈を使って発言したのか。
これらは違う。
そして最後のところには、
責任の非対称が残る。
AIが要約した。
AIが候補解釈を出した。
しかし、
私はこの文章をこう理解した。
と外へ発言するなら、
少なくとも、その解釈を採用したのは私である。
系が遂行したからといって、
すべての認識上のコミットメントまで、
AIと私の共同責任です。
と曖昧にできるわけではない。
遂行が分散すること
と、
採用判断まで消えること
は別である。
では、AIに読んでもらった文章は、私が読んだことになるのか
ここまで来ると、
「はい」
でも、
「いいえ」
でもなくなる。
AIが作った要約だけを受け取り、
原文も見ず、
分かったと思った。
これは、
AIに読んだことにしてもらった
にかなり近い。
一方、
AIに分解させ、
原文へ戻り、
限定を確認し、
別解釈を出させ、
分からない場所を残した。
その場合、
本人一人だけの読解ではない。
しかし、
読解が成立していないとも言えない。
だから私は今のところ、
こう考える。
自分で原文へ戻って確認した部分は、私も読んだ。
AIの変換に依存して処理した部分は、系として読んだ。
自分にも系にも十分検証できなかった部分は、まだ「読めた」ことにしない。
このくらいが一番正確ではないだろうか。
私が読めるようになったのではない
私は今でも、
一人では読めない文章が大量にある。
専門外の論文。
知らない言語。
知らない思想史。
高度な統計。
しかしAIを使うと、
以前なら入口で終わった文章へ入れる。
そこでは、
分かりません。
の次に、
何が分からないのか。
が来る。
言葉か。
構造か。
背景知識か。
統計か。
比喩か。
翻訳か。
文章そのものの問題か。
そして、
調べる。
分ける。
戻る。
また分からなくなる。
これは、
私の読解Iが突然高くなった、
という話ではない。
以前より高い読解遂行Sを持つ系を、以前より編制できるようになった。
という方が近い。
もちろん、
その系をうまく作れていると自分で思い込んでいるだけかもしれない。
だから原文がいる。
データがいる。
反論がいる。
外側がいる。
「読む」という言葉も、少し壊れ始めている
AIによって、
人間の読解能力が落ちることはあるかもしれない。
AIに頼りすぎて、
本来形成されるはずだった能力が育たなくなることもあるだろう。
読めたと錯覚することもある。
しかし、
それだけではない。
同時に、
それまで一人では読めなかった人が、AIとの結合によって文章へ部分的に入れるようになる。
こちらも実際に起き始めている。
だから、
AIは読解力を奪うか。
だけでは足りない。
AIは読解力を高めるか。
だけでも足りない。
問うべきなのは、
何が本人に内部化されているのか。
何をAIへ外部化したのか。
その間をどう編制しているのか。
系全体では何ができるのか。
どこまで検証したのか。
どこから先は未決なのか。
である。
「読める人」と「読めない人」。
この二つに人間を分けるより、
こちらの方が、
たぶん現実に近い。
AIによって、
読むことが消えるのではない。
読むという仕事の分担線が、動き始めている。
その結果、
昨日まで読めなかった人が、
今日、文章の中へ入ってくる。
それがどれほど大きな社会変化になるのかは、
まだ分からない。
しかし少なくとも、
デスキリングだけを見ていると、
この変化を丸ごと見落とす。
参考文献
OECD. Do Adults Have the Skills They Need to Thrive in a Changing World? Survey of Adult Skills 2023. 2024.
Salomon, G., Perkins, D. N. & Globerson, T. “Partners in Cognition: Extending Human Intelligence with Intelligent Technologies.” Educational Researcher, 20(3), 2–9, 1991. DOI: 10.3102/0013189X020003002.
Fisher, M., Goddu, M. K. & Keil, F. C. “Searching for Explanations: How the Internet Inflates Estimates of Internal Knowledge.” Journal of Experimental Psychology: General, 144(3), 674–687, 2015. DOI: 10.1037/xge0000070.
Etkin, H. K., Etkin, K. J., Carter, R. J. & Rolle, C. E. “Differential Effects of GPT-Based Tools on Comprehension of Standardized Passages.” Frontiers in Education, 10, 1506752, 2025. DOI: 10.3389/feduc.2025.1506752.
Asthana, S., Rashkin, H., Clark, E., Huot, F. & Lapata, M. “Evaluating LLMs for Targeted Concept Simplification for Domain-Specific Texts.” Proceedings of EMNLP 2024, 6208–6226, 2024. DOI: 10.18653/v1/2024.emnlp-main.357.
Guidroz, T. et al. “LLM-based Lossless Text Simplification and its Effect on User Comprehension and Cognitive Load.” arXiv, 2025.
Alva-Manchego, F. et al. “Findings of the TSAR 2025 Shared Task on Readability-Controlled Text Simplification.” Proceedings of TSAR 2025, 116–130, 2025. DOI: 10.18653/v1/2025.tsar-1.8.
Kreijkes, P. et al. “Effects of LLM Use and Note-Taking on Reading Comprehension and Memory: A Randomised Experiment in Secondary Schools.” Computers & Education, 243, 105514, 2026. DOI: 10.1016/j.compedu.2025.105514.
Dai, Y. “Metacognitive Strategy Use in GenAI-Supported Academic Reading: A Qualitative Study of Postgraduate Students in UK Higher Education.” Frontiers in Psychology, 17, 1787647, 2026. DOI: 10.3389/fpsyg.2026.1787647.
Wood, D., Bruner, J. S. & Ross, G. “The Role of Tutoring in Problem Solving.” Journal of Child Psychology and Psychiatry, 17(2), 89–100, 1976. DOI: 10.1111/j.1469-7610.1976.tb00381.x.
石部統久・ChatGPT5.6Sol
査読:ChatGPT5.6Sol・Claude Opus5・Grok・Gemini3.7(Parcae Protocol)
