GPT-5.6、安いLunaは本当に得?AI費用の損益分岐を30分で出す実務シート
「一番安いLunaに替えれば、AI費用も大きく下がる」
そう考えたくなりますが、実務ではそれだけで決めると危険です。安いモデルに替えた結果、人の修正が1件あたり十数秒増えただけで、API料金の節約分が消えることがあるからです。
GPT-5.6では、旗艦モデルのSol、費用と性能のバランスを取るTerra、大量処理向けのLunaという3つのモデルが用意されました。選択肢が増えた一方で、「結局、自社はどれを使えば得なのか」という判断は、公式価格表だけではできません。
この記事では、AIの料金だけでなく、再実行と人の確認時間まで含めた「本当の月額費用」を計算します。有料部分には、そのまま表計算ソフトへ移せる業務振り分けシート、損益分岐の計算式、14日間の検証手順、社内説明用の結論テンプレートを収録しました。
先に結論:モデル単価より「人が直す時間」が重要
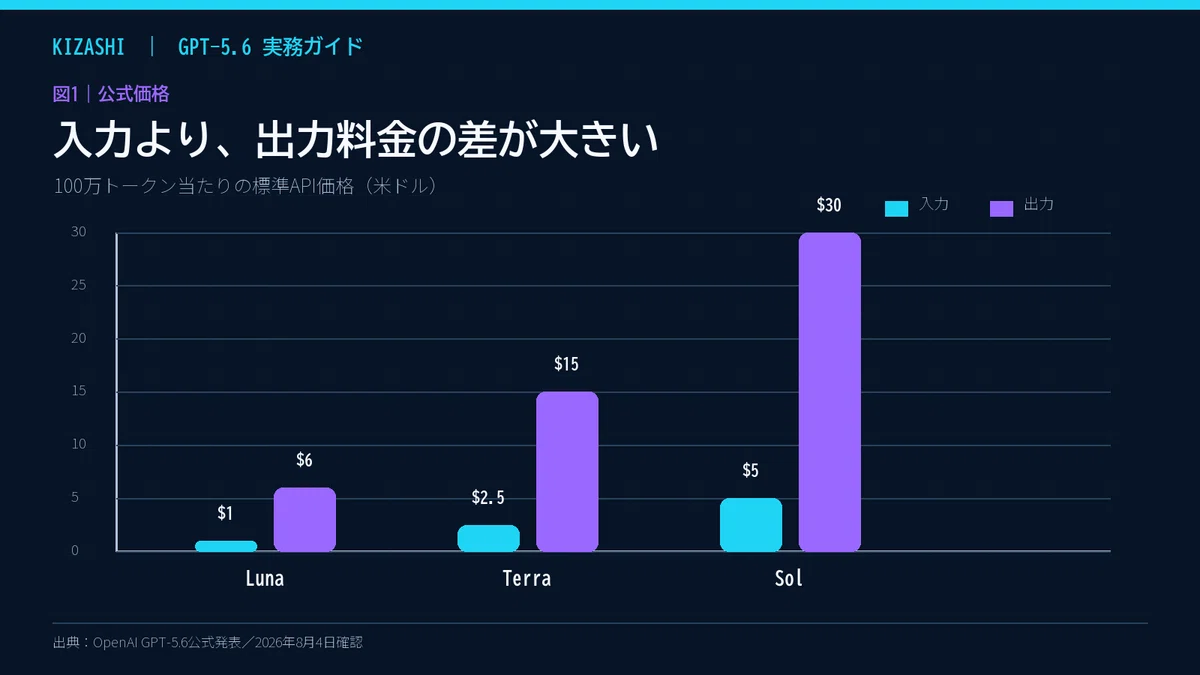
OpenAIが公表したGPT-5.6の標準API価格は、100万トークンあたり次の通りです。
Luna
入力:1ドル
キャッシュ済み入力:0.10ドル
出力:6ドル
公式の位置づけ:高速・低価格・大量処理向け
Terra
入力:2.50ドル
キャッシュ済み入力:0.25ドル
出力:15ドル
公式の位置づけ:性能と費用のバランス
Sol
入力:5ドル
キャッシュ済み入力:0.50ドル
出力:30ドル
公式の位置づけ:複雑で重要な仕事向け
図1:GPT-5.6の標準API価格比較。出力料金の差が大きいことが分かります。
同じ量を処理するなら、Lunaの標準単価はSolの5分の1です。しかし、請求書に出るAPI費用だけを比べても、会社にとって本当に安いモデルは分かりません。
見るべき数字は次の3つです。
APIへ直接支払う費用
間違いや不足で再実行する費用
人が確認・修正する時間の費用
本当の月額費用=API費用+再実行費用+人の確認・修正費用
「1件16秒」で安さが逆転する例
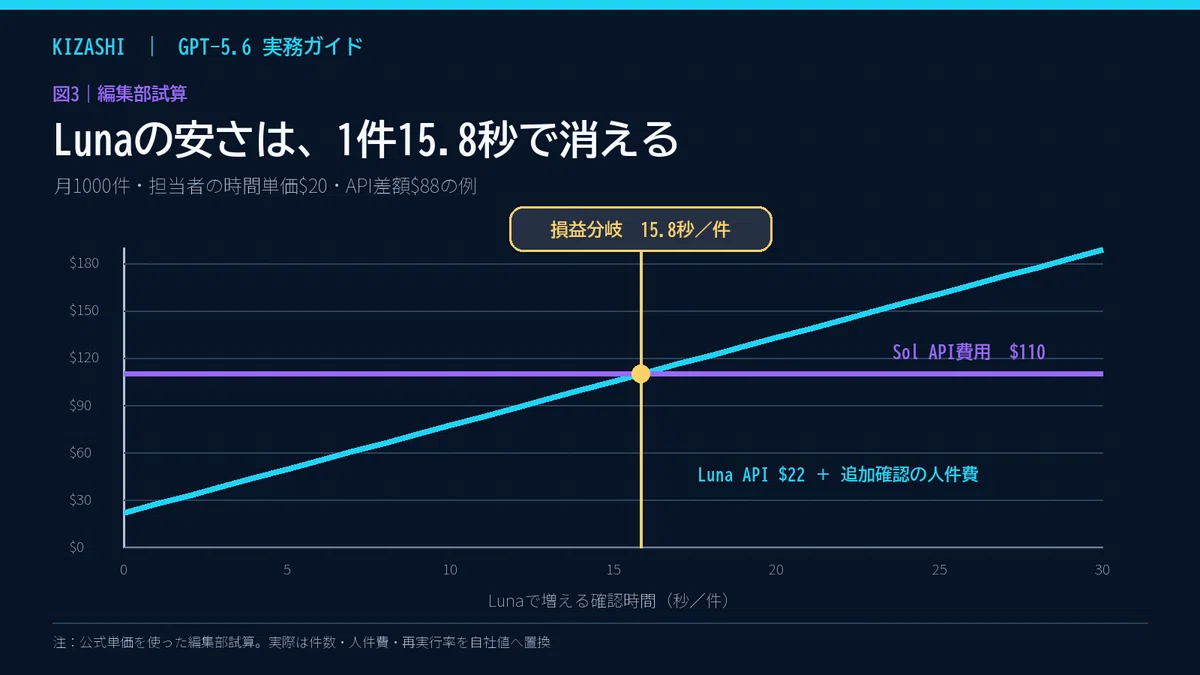
月に入力1000万トークン、出力200万トークンを使うとします。標準価格による単純計算はLunaが22ドル、Solが110ドルで、差は88ドルです。
月1000件を処理し、担当者の時間単価を20ドルとすると、88ドルで買える作業時間は4.4時間です。1件あたりに直すと約16秒。つまり、Lunaを使うことでSolより確認・修正が1件16秒以上増えるなら、88ドルのAPI節約は人件費で消えます。
もちろん、これは条件を置いた編集部試算です。ただし「安いモデルへ替えても、数十秒の手直しで逆転し得る」という見方は、多くの業務で使えます。
無料の価格比較では分からないこと
一般的なモデル比較は、性能や100万トークン単価を並べて終わります。実際の導入判断には、少なくとも次の数字が必要です。
月の処理件数
1件あたりの入力・出力トークン
合格率と再実行率
人が確認する平均時間
間違えたときの損失
同じ指示や資料を再利用できる割合
この6項目を測らずに「Lunaが最安」「重要だから全部Sol」と決めるのは、どちらも危険です。
ここから先では、業務を3モデルへ振り分ける採点表と、月額費用の計算方法を順番に使います。読み終わるころには、「どの業務を、どのモデルで、何件だけ試し、何を超えたら中止するか」まで決められる状態を目指します。
実務キット1:30分で作る「業務振り分けシート」
最初に、AIへ任せている仕事を1行ずつ書き出します。表計算ソフトへ次の10列を作ってください。
A
入れる内容:業務名
B
入れる内容:月間件数
C
入れる内容:間違いを人がすぐ発見できるか
D
入れる内容:間違えた場合の影響
E
入れる内容:正解の形式を明確に示せるか
F
入れる内容:1件あたり確認時間
G
入れる内容:再実行率
H
入れる内容:入力トークン
I
入れる内容:出力トークン
J
入れる内容:現在のモデル
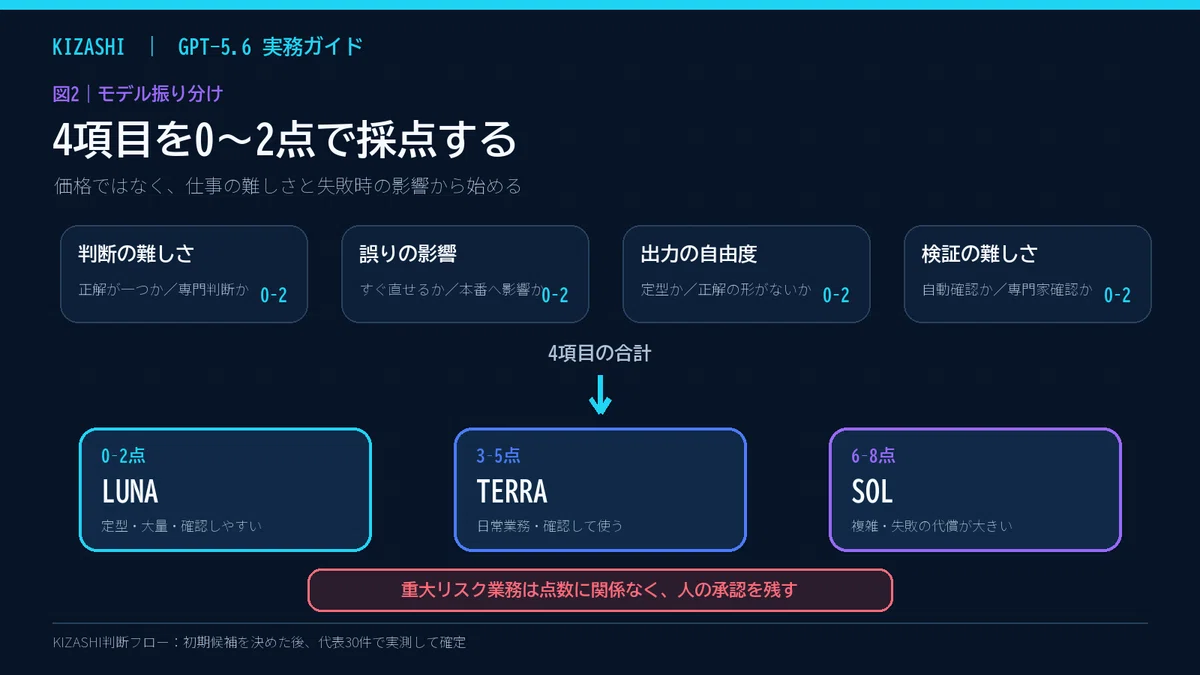
迷わないための0〜2点採点
各業務を、次の4項目で採点します。
判断の難しさ
0点:正解がほぼ一つ
1点:文脈で変わる
2点:複数の専門判断が必要
誤りの影響
0点:すぐ直せる
1点:手戻りが出る
2点:顧客・契約・本番へ影響
出力の自由度
0点:定型
1点:半定型
2点:正解の形が決まらない
検証の難しさ
0点:自動または一目で確認
1点:人の確認が必要
2点:専門家の確認が必要
合計点の最初の振り分けは、次のようにします。
0〜2点:Lunaから試す
3〜5点:Terraから試す
6〜8点:Solから試す
図2:モデル選定は価格ではなく、4項目の合計点と重大リスクの有無で始めます。
これは最終決定ではなく、検証を始める場所です。契約、医療、法務、送金、個人情報、本番環境など、失敗時の影響が大きい業務は、点数にかかわらず人の承認を残します。
3つの業務を採点してみる
問い合わせの分類は、正解が定型で間違いも発見しやすいため、合計1〜2点になりやすい仕事です。Lunaを最初の候補にします。
顧客向けメールの下書きは、文脈と表現の確認が必要ですが、人が送信前に直せます。3〜5点になりやすく、Terraから試すのが自然です。
重要なシステム変更の設計は、複数条件が絡み、誤りが本番へ影響します。6点以上になりやすいため、Solを候補にし、人のレビューを必須にします。
実務キット2:「本当の月額費用」を計算する
手順1:APIの直接費用
標準のテキスト料金だけを使う場合、月額API費用は次の式です。
API費用=月間入力トークン÷100万×入力単価+月間出力トークン÷100万×出力単価
キャッシュ、長い入力、ツール利用、Proなどを使う場合は条件が加わるため、実際の利用明細で分けてください。
手順2:再実行費用
簡易計算では、次の式を使えます。
再実行費用=API費用×再実行率
厳密に見る場合は、再実行したリクエストだけの入力・出力トークンを記録します。最初の比較では簡易式で十分ですが、本番導入前には実測へ切り替えます。
手順3:人の確認・修正費用
人の費用=月間件数×1件あたり確認分数÷60×担当者の時間単価
ここで重要なのは、担当者の給与ではなく、会社が比較に使う時間単価をそろえることです。社会保険、設備、管理費を含めるかは社内基準に合わせます。
手順4:合計する
本当の月額費用=API費用+再実行費用+人の費用
APIの請求額が下がっても、人の費用が増えれば失敗です。逆に、Solの単価が高くても、確認とやり直しが大きく減るなら全体では安くなる可能性があります。
実務キット3:損益分岐を「1件あたり何秒」で出す
安いモデルAと高いモデルBを比べるとき、Aに許される追加確認時間は次の式で求めます。
許容追加秒数=(BのAPI費用-AのAPI費用)÷月間件数÷時間単価×3600
先ほどの例では、LunaとSolのAPI差額88ドル、月1000件、時間単価20ドルなので、許容追加時間は1件約15.8秒です。
図3:Lunaの追加確認時間が1件15.8秒を超えると、この条件ではAPI差額88ドルが消えます。
この数字を出すと、現場への質問が変わります。
「どちらのモデルが賢いと思いますか」ではなく、「Lunaに替えると、Solより1件16秒以上手直しが増えますか」と聞けるからです。
感想ではなく、時間を測って決められるようになります。
損益分岐の判断例
Lunaで確認が1件10秒増えた:API節約が残る可能性が高い
Lunaで確認が1件25秒増えた:この条件ではSolより割高になり得る
Terraで確認がほぼ増えない:Terraが費用と品質の妥協点になる可能性がある
失敗の損失が大きい:月額差よりリスクを優先し、Solと人の承認を残す
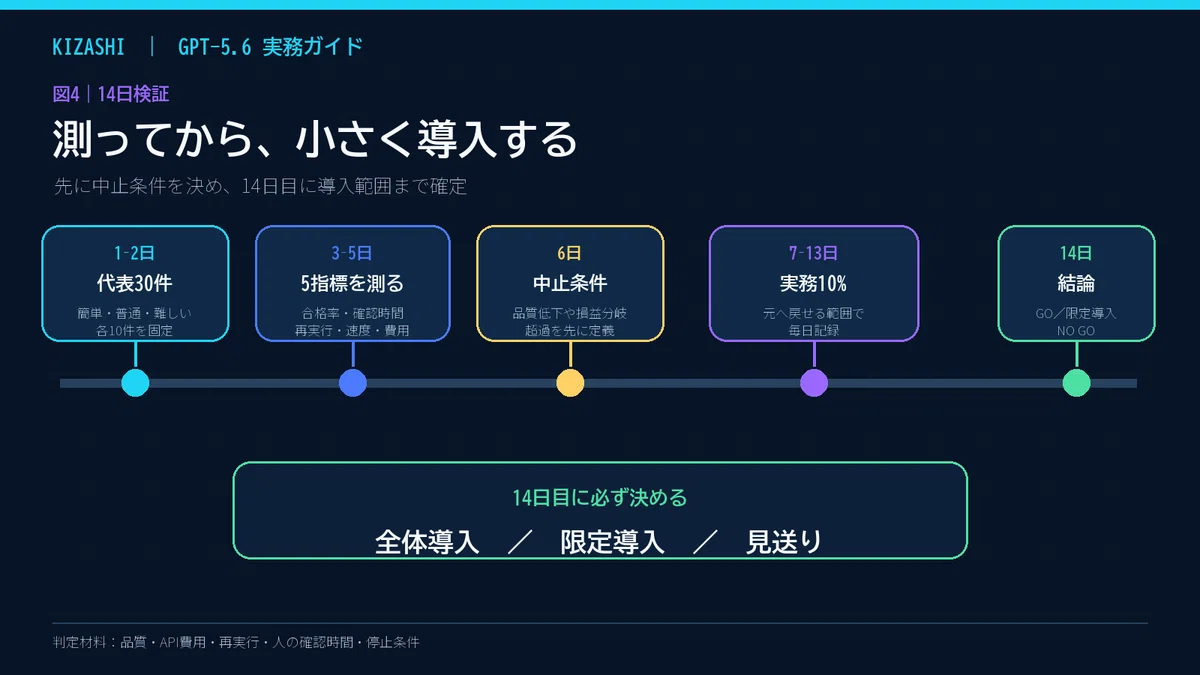
実務キット4:14日で結論を出す比較テスト
図4:先に中止条件を決め、14日目に導入範囲まで確定します。
1〜2日目:代表30件を固定する
簡単・普通・難しい案件を10件ずつ選びます。成功しやすい案件だけでなく、過去に修正が多かった案件も入れてください。3モデルへ同じ入力と同じ出力条件を渡します。
3〜5日目:5項目を測る
合格率
記録方法:必須条件を満たした件数÷全件数
確認時間
記録方法:完成状態までの実測分数
再実行率
記録方法:やり直した件数÷全件数
処理時間
記録方法:依頼から結果取得までの秒数
API費用
記録方法:入力・出力・キャッシュを分けて記録
評価者は、できればモデル名を見ずに成果物を採点します。「高いモデルだから良いはず」という思い込みを減らすためです。
6日目:中止条件を先に決める
おすすめの初期条件は次の通りです。業務の重要度に応じて厳しくしてください。
必須条件の見落としが1件でも重大事故につながる:自動化せず、人の承認を必須にする
合格率が現行モデルより5ポイント以上低い:候補から外す
確認時間が損益分岐を超える:安いモデルへの変更を見送る
再実行率が現行の2倍を超える:原因を直すまで本番へ進めない
出典や数字を確認できない回答が出る:公開・送信工程から外す
7〜13日目:実務の10%だけで試す
合格したモデルを、対象業務の10%だけで使います。元のモデルへすぐ戻せる状態を保ち、費用・確認時間・失敗件数を毎日記録します。
14日目:GO・LIMITED GO・NO GOを決める
GO:品質基準を満たし、本当の月額費用も下がった
LIMITED GO:限定した定型業務だけで効果が出た
NO GO:確認時間、再実行、リスクを含めると改善しなかった
「とりあえず継続」は避けます。継続する範囲と、やめる範囲を同時に決めます。
実務キット5:社内説明に使える結論テンプレート
次の文章の角括弧を埋めれば、検証結果を1分で説明できます。
対象業務は[業務名]、月間[件数]件です。[モデル名]を14日間テストした結果、合格率は[数値]%、再実行率は[数値]%、確認時間は1件[数値]分でした。API費用だけでは月[金額]の削減ですが、人の確認費用を含む総費用は月[金額]の[削減/増加]です。そのため、[全体導入/限定導入/見送り]とします。人の承認は[工程名]に残し、[条件]を超えた場合は元のモデルへ戻します。
このテンプレートのポイントは、「性能が良かった」ではなく、品質、費用、停止条件を一緒に報告することです。
キャッシュは「使ったか」ではなく再利用回数で判断する
GPT-5.6では、キャッシュ読み出しは通常入力より割安ですが、キャッシュ書き込みは通常入力の1.25倍です。毎回変わる文章までキャッシュ対象にすると、書き込みだけ増えて得にならない場合があります。
見るべき数字は次の3つです。
キャッシュへ書き込んだトークン
キャッシュから読み出したトークン
同じ内容を再利用できた回数
長い共通指示や毎回同じ資料は候補になります。案件ごとに内容が変わる入力は、実測してから判断します。
最終チェックリスト
□ 業務を1行ずつ一覧にした
□ 難しさ・誤りの影響・自由度・検証難度を採点した
□ 月間件数とトークン量を記録した
□ 再実行率を測った
□ 人の確認時間をストップウォッチで測った
□ 1件あたりの損益分岐秒数を出した
□ 同じ30件で候補モデルを比較した
□ 中止条件を本番前に決めた
□ 人が承認する工程を残した
□ 価格と仕様を導入日に再確認した
まとめ:最安モデルではなく、最安の工程を選ぶ
GPT-5.6で費用を下げる方法は、すべてをLunaへ替えることではありません。
定型で確認しやすい仕事はLuna、日常的な判断を含む仕事はTerra、失敗の代償が大きい仕事はSolを出発点にします。そのうえで、API費用、再実行、人の確認時間を同じ表に入れて比べます。
まず一つの業務だけ選び、月間件数と担当者の時間単価を入れて、1件あたりの損益分岐秒数を出してください。モデル選びが「印象」から「自社の数字」に変わります。
情報元
OpenAI「GPT-5.6: Frontier intelligence that scales with your ambition」
https://openai.com/index/gpt-5-6/
OpenAI API「Model guidance」
https://developers.openai.com/api/docs/guides/latest-model
OpenAI API「Compare models」
https://developers.openai.com/api/docs/models/compare
OpenAI API「GPT-5.6 Terra Model」
https://developers.openai.com/api/docs/models/gpt-5.6-terra
※価格・仕様は2026年8月4日時点の公式情報を基にしています。費用例と損益分岐は計算方法を示す編集部試算であり、実際の請求額や削減効果を保証するものではありません。為替、人件費、長文入力、ツール利用、キャッシュ条件などは各社の実測値へ置き換えてください。
図解まとめ
本文で使った判断基準を、あとから見返しやすい4枚にまとめました。