
KiroについにOpenAIモデルが来た。業務ツール勢はどれを選ぶ?

こんにちは、たつぼんです。
このマガジンでは、Kiroで社内のExcel業務ツールをゼロから作った記録を#1〜#20で書いてきました。今回はその番外編というか、見逃せないニュースが飛び込んできたので取り上げます。
KiroにOpenAIのモデルが初めて載りました。 2026年7月14日付の公式Changelogで、GPT-5.6の3モデル(Sol・Terra・Luna)が使えるようになったと発表されています。
Kiroといえばこれまで Claude 系+オープンウェイト系という構成だったので、これはけっこう大きな転換点です。ただ、モデルが増えると今度は「で、どれを使えばいいの?」問題が出てくる。この記事では、公式ドキュメントを読み込んで、業務ツールを作る人の目線で整理してみます。
何が起きたのか
公式Changelog(2026年7月14日)によると、GPT-5.6 Sol・Terra・Luna の3モデルが IDE・CLI・Web で使えるようになりました。対象は Pro / Pro+ / Pro Max / Power の有料プランで、us-east-1 と eu-central-1 でのロールアウト。残念ながら Free プランは対象外です。
3つの違いをざっくり言うと、性能とコストの3段構えです。
Sol:フラッグシップ。spec駆動の実装、大規模リファクタ、複雑なターミナル作業など「一番重い仕事」向け。クレジット倍率は2.4x
Terra:バランス型。日常的なマルチステップ開発向け。倍率1.2x
Luna:最速・最安。同じような作業を高頻度で回すとき向け。倍率0.6x
コンテキストウィンドウは3モデルとも272Kです。
クレジット倍率で見ると景色が変わる
この連載で何度か書いてきた通り、業務ツール開発は「1回のすごい生成」より「細かい修正の積み重ね」です。だからモデルの賢さと同じくらい、クレジット消費が効いてきます。
公式の倍率表を並べるとこうなります(Autoを1.0xとした相対値)。
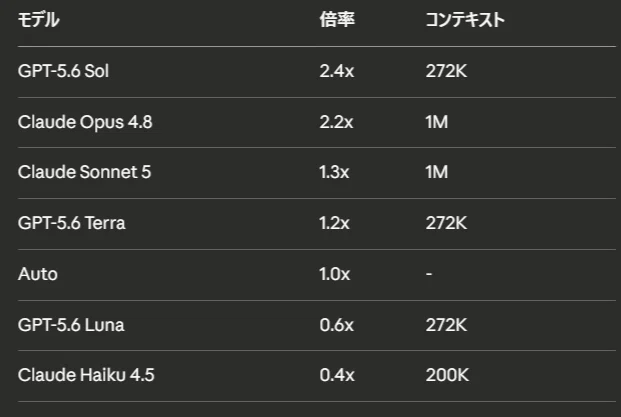
面白いのは、SolがOpus 4.8より高い(2.4x > 2.2x)こと。KiroにおいてSolは「Opusより上」の位置づけで載ってきたわけです。公式ドキュメントには、SolはCoding Agent Indexで80、Terminal-Bench 2.1で88.8%というスコアも載っています。
一方でLunaは0.6x。公式の説明では「速度とスループット重視の高頻度タスク向け」とのことなので、Hooksで回す定型処理や、ちょっとした修正の連打には相性が良さそうです。
業務ツール勢の目線で選ぶなら
公式ドキュメントの使い分け表を、この連載の文脈に引き付けて読むとこうなります。
specの実装フェーズ → Sol が本命候補。 公式が真っ先に挙げているユースケースが「spec-driven implementation」です。#14で書いた通り、実装フェーズは「タスクを順に消化していく長丁場」なので、長時間の自律実行に強いモデルは確かに向いています。ただし2.4xなので、全部Solでやると財布(クレジット)が持たない気がします。
日常の修正・改修 → Terra か Auto。 Terraは1.2xでAutoとほぼ同じ水準。迷ったらAutoに任せるという今までの運用でも良い気はしますが、挙動を固定したい人はTerra指名という選択肢ができました。
Hooksや定型処理 → Luna。 0.6xは魅力です。#16で書いた「保存したら自動でやってほしい」系の処理は、賢さより回転数なので。
ひとつ注意点として、GPT-5.6系は「hidden chain-of-thought」で、内部の思考過程が見えず最終出力だけが返ってくる仕様とのこと。Claudeの思考を眺めて軌道修正するスタイルに慣れていると、ここは使用感が変わるかもしれません。
社内利用なら「Experimental」の扱いに注意
もうひとつ、会社で使う人向けの大事な話。GPT-5.6の3モデルは現時点で Experimental(実験的)ステージ です。公式ドキュメントによると、Experimentalなモデルの推論リクエストは、可用性とパフォーマンスの最適化のために複数のAWSリージョンをまたいで処理されることがあるとのこと(cross-region inference)。
#9で「Kiroのコードはモデル学習に使われる?」を社内稟議用にまとめましたが、データの処理リージョンを気にする会社なら、ここも確認ポイントに追加した方がいいです。公式のデータ保護ドキュメントに該当の記載があるので、稟議に貼るならそこのURLを(末尾の出典に載せておきます)。
私もまだ実際には試せていないので、このあたりは実際に使ってから改めて書くつもりです。
まとめ
KiroにOpenAIモデル(GPT-5.6 Sol / Terra / Luna)が初登場。有料プラン向け
倍率はSol 2.4x / Terra 1.2x / Luna 0.6x。SolはOpus 4.8より高い位置づけ
業務ツール勢的には「実装の山場はSol、日常はTerraかAuto、定型処理はLuna」が公式情報ベースの見立て
ExperimentalステージなのでCross-region inferenceに注意。社内稟議勢は要チェック
モデルの選択肢が増えるのは嬉しい反面、「どれに任せるか」を考えるのも人間の仕事が増えたということでもあります。この連載でずっと書いてきた「AIに全部やらせない」は、モデル選びにも当てはまるのかもしれません。任せる仕事の重さに合わせて、道具を選ぶ。結局そこに戻ってくる気がします。
実際にSolでspecの実装を回したらどうなるかは、近いうちに試して報告します。
それでは、また次の記事で。
