【PR】画像2枚から30秒の物語へ。Pollo AI「Seedance 2.5」でショートアニメを作ってみた

※本記事は、Pollo AI様よりご協力いただき、実際に動画を制作・検証したPR記事です。
皆様、こんにちは!
安達です。
今回は、Pollo AI様の「Seedance 2.5」を使って、ショートアニメ制作に挑戦してみました。
今回のテーマは――
少ない素材で、手間をかけずに、
どこまで「観る物語」を作れるのか?
です。
単純に、「1枚の画像を動かしてみました!」
という検証ではありません。
今回題材にしたのは、普段制作しているTEAM LILITHのショートストーリー、
『真夜中の優雅なおもてなし?』
執事姿のリリスがOYAKATAとValcusに紅茶を振る舞い――
実はその紅茶には秘密があり、最後は3人で真夜中のゴシックメタルセッションが始まる。
そんな短い物語です。
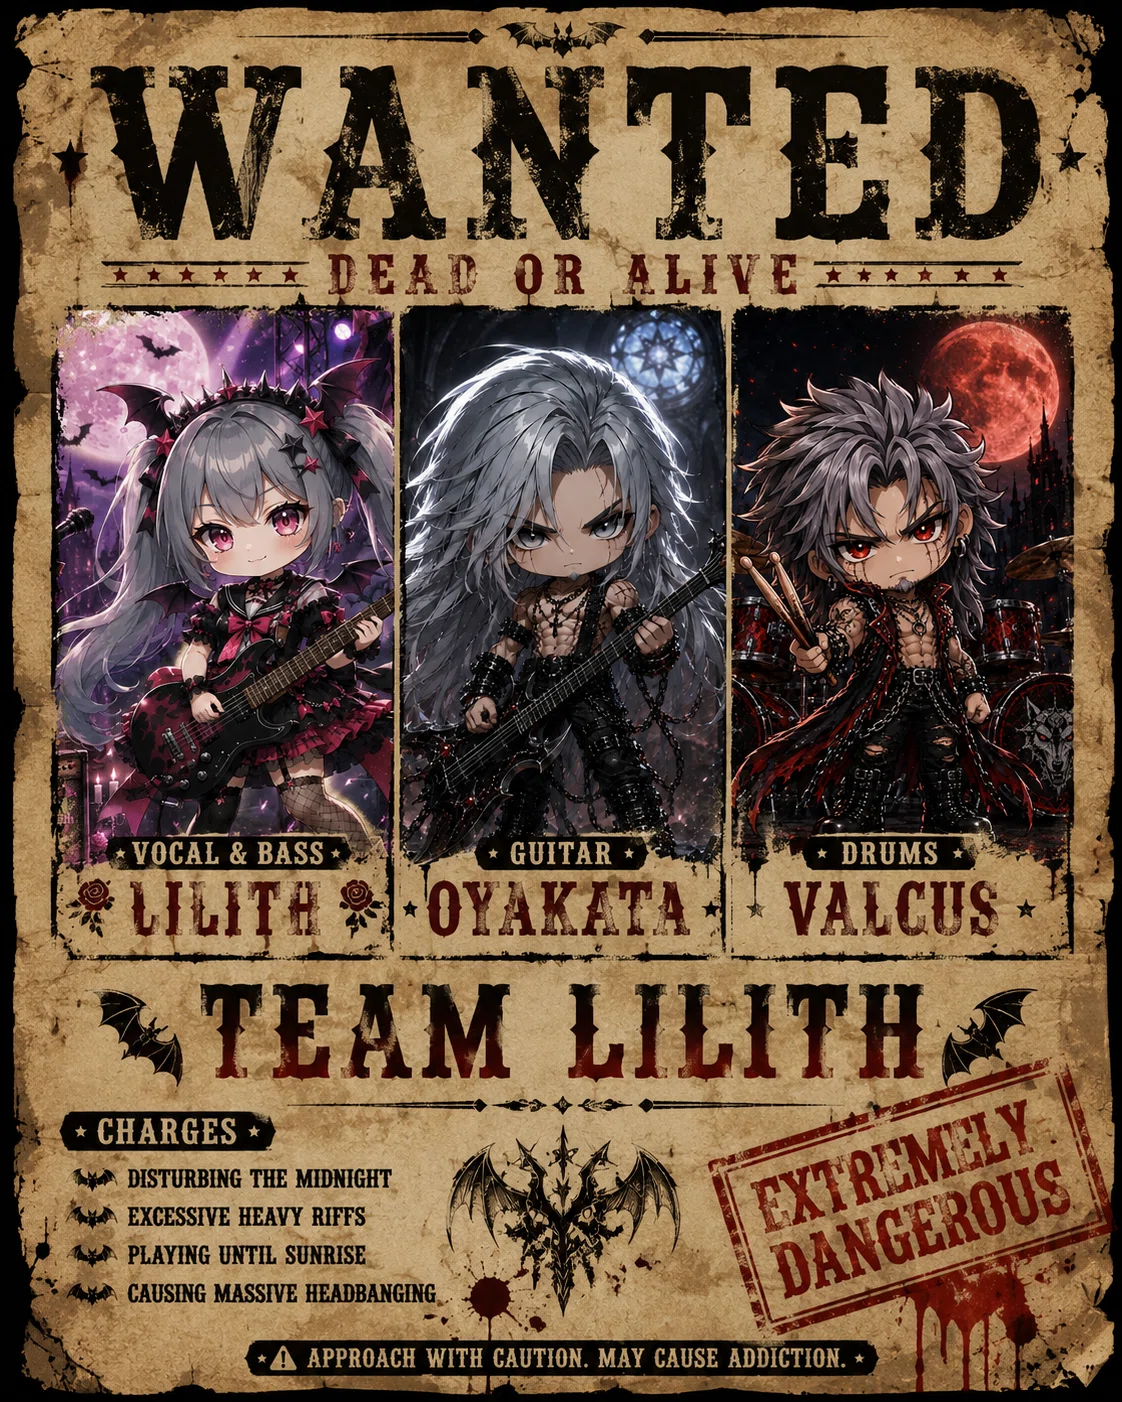
ちなみに、今回の動画に登場するTEAM LILITHは、私が創作したダークメタルバンドです。
ボーカル&ベース:リリス
ギター:OYAKATA
ドラム:Valcus
今回はこの物語を使って、
複数キャラクターによる会話
日本語・英語音声
キャラクターの声の継続
ティーカップの受け渡しや飲む動作
ティータイムからライブへの場面転換
ギター、ベース、ドラムの演奏
などを実際に試しました。
最終的に完成したのは、
日本語版:約60秒
そして、
英語音声+日本語字幕のフルバージョン:約90秒。
今回は、その制作過程を実際の生成結果と一緒に紹介していきます。
今回の制作環境
今回の動画制作は、すべてスマートフォンで行っています。
高性能なPCや特別な制作環境を用意しての検証ではありません。
「AI動画って、しっかりしたPCがないと作れないんじゃない?」
と思っている方にも、一つの制作例として見ていただければと思います。
使用端末:iPhone 12 Pro
動画生成AI:Seedance 2.5(Pollo AI)
動画編集:CapCut
Seedance 2.5で動画を生成し、字幕や動画の結合などの編集はCapCutで行いました。
今回使用したのは「Seedance 2.5」
今回の動画生成には、Pollo AI上で利用できるSeedance 2.5を使用しました。
今回私が使用した「画像から動画」では、動画のサイズを個別に指定するのではなく、元画像のサイズ(画角)に準じた動画が生成されます。
そこで今回は、最初から約2.39:1のウルトラワイド画像を用意。
その画像をそのまま動かすことで、以前から作ってみたかった映画のような横長画面のショートアニメに挑戦しました。
Pollo AI 公式情報でも、Seedance 2.5は最大30秒の単一動画生成に対応し、画像・動画・音声によるマルチモーダル参照にも対応しています。
今回私が生成した動画は、すべて、
30秒・480P です。
そして今回、最初から一つルールを決めていました。
それが、
使用する画像は、できるだけ少なくする。
ということ。
Seedance 2.5は多数の参照素材を扱えるモデルですが…
たくさん使えるから、たくさん使う。
今回は、そうしません。
知りたかったのは、
「素材をたくさん用意すれば何ができるか?」
ではなく、
「少ない素材から、AI自身にどこまで映像を作ってもらえるか?」
だったからです。
まずは「画像から動画」で30秒
最初に使用したのは、「画像から動画」です。
ここで用意したのは、基本的に2枚。
開始側の画像
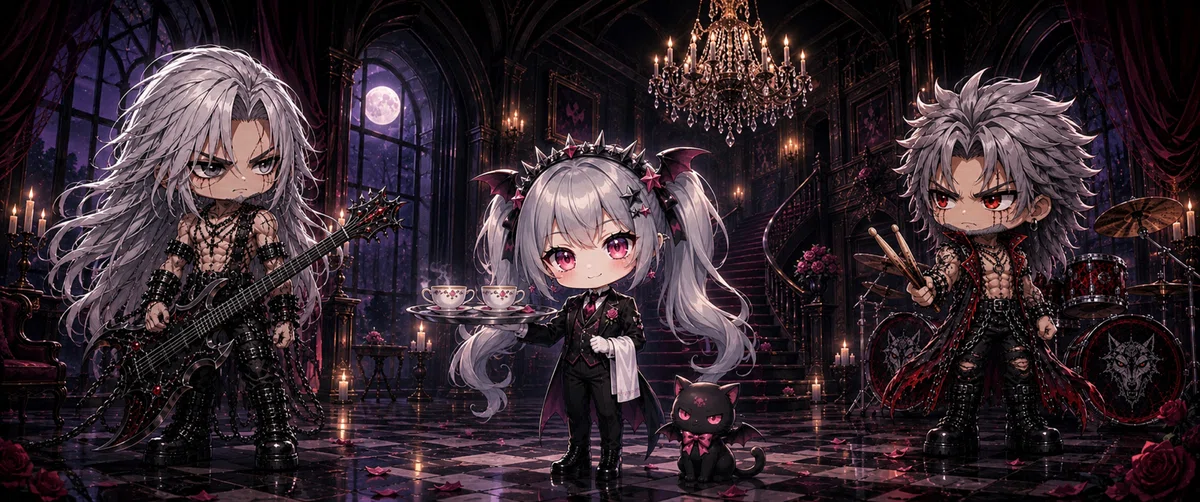
動画①で使用した開始側の画像。
リリスが2人分のローズティーを運んでくる場面。
中央には執事姿のリリス。
銀のトレイには、ローズティーが入ったティーカップが2客。
左右にはOYAKATAとValcus。
足元には、黒猫のくろもち。
そして――
終了側の画像
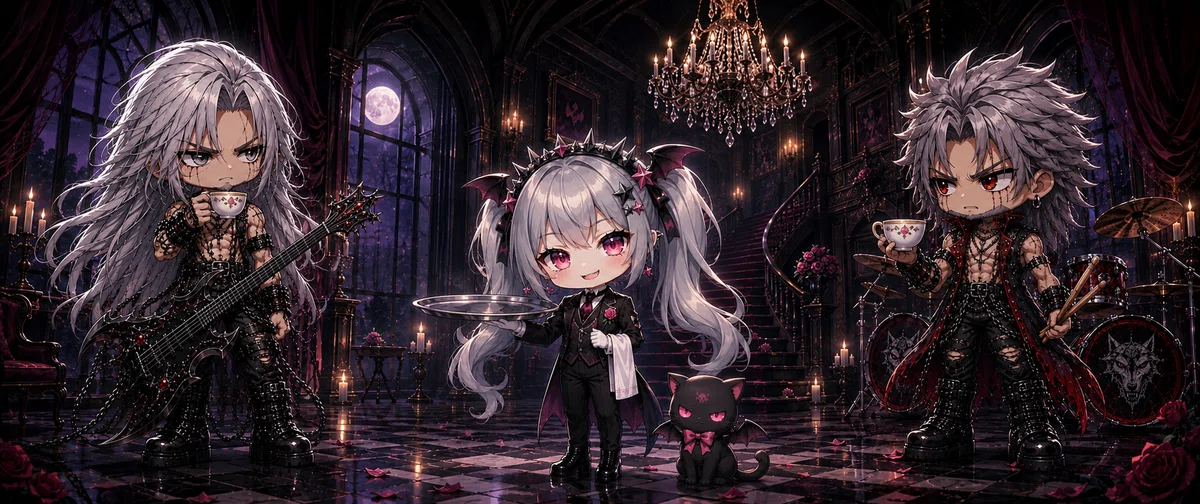
動画①で使用した終了側の画像。
2人が紅茶を受け取り、リリスが意味ありげに笑っている。
こちらでは、OYAKATAとValcusが、
それぞれティーカップを持っている。
リリスのトレイは空。
そしてリリスは――
何やら意味ありげに、
ニヤリ。
つまり、人間側で用意した大きな流れは、
「紅茶を差し出す」
→「2人が飲み、リリスが怪しく笑う」
という始点と到達地点です。
では、その間の30秒をどうするのか?
ここをSeedance 2.5に任せてみました。
2枚の間を、AIはどうつないだ?
実際に生成された映像を見て、
最初に驚いたのがここでした。
私は細かなカメラワークまで完全には指定していません。
ところが実際の動画では、
リリスがカメラへ近づく
「紅茶はいかが?」とアップで話す
OYAKATAとValcusがティーカップを受け取る
カメラが引き、3人の構図へ戻る
2人が紅茶を飲み、「ゴクリ」という音まで入る
リリスが「おいしいでしょ?」と、いたずらっぽく笑う
という、一つの短いシーンになりました。
▼ 実際に生成された
日本語版・動画① ▼
指示していなかった演出が、
むしろ良かった
ここは今回、かなり面白かったところです。
私が当初イメージしていたのは、
OYAKATAとValcusが
リリスへ近づいて紅茶を受け取る
という動きでした。
ところが実際には…
リリス自身がカメラへ近づいてきます。
その結果、リリスの顔が自然に大きくなり、
「紅茶はいかが?」
というセリフをアップで見せる。
その後、左右から手が伸びてティーカップを受け取り、再び引きの構図へ戻る。
実際にアニメーションとして見ると、私が頭の中で想像していた動きより、こちらの方が分かりやすい。
もちろん、リリスがわざわざカメラへ向かって歩いてくる動きは、現実の行動として考えれば少し不自然です。
ただ、アニメとして見ると、その動きによって主役であるリリスの顔が自然にアップになる。
そのため私は、現実的な動きとしては少し不自然でも、映像としてはこちらの方が良かったと感じました。
このあたりは、見る人によって違和感を感じるかもしれません。
ただ、少なくとも私には、単にプロンプトと違う動きをしたというより、
映像として分かりやすくなるよう、AI側が演出を補完した
ように感じました。
こちらが細かく指定していなかった部分を、AIがどうつないでくるのか。
今回の動画生成で、特に面白いと感じた場面の一つです。
AI動画で破綻しやすい日本語、
どこまで話せる?
今回、かなり気になっていた部分です。
動画①では、
「紅茶はいかが?」
「おいしいでしょ?」
という短い日本語のセリフを指定しました。
結果は――
今回の生成では、非常に自然でした。
少なくともこの動画については、発音を理由に作り直したいと思うところはありません。
さらに面白かったのが、指定していない小さな演技です。
最後にリリスが、
「ニシシ」
という感じで、いたずらっぽく笑います。
これがキャラクターにかなり合っていました。
さらに、紅茶を飲むところでは、
「ゴクリ」と喉を鳴らす音まで入っています。
セリフを発音するだけではなく、
その場面でキャラクターがどう演技するか、
どんな音が自然なのか
というところまで補完された点が印象的でした。
ただし、
「Seedance 2.5なら日本語は必ず完璧」
とまでは言えません。
あくまで、今回使用したセリフと制作条件では非常に良い結果が得られたというのが、今回の検証結果です。
次は「リファレンスから動画」で続きを作る
ここから、もう一段階進めます。
前半30秒は、画像から動画。
後半30秒は、リファレンスから動画。
を使用しました。
「リファレンスから動画」では、画像だけでなく、完成した動画そのものを参照素材として添付できます。
そこで今回は、
前半30秒として完成した動画①
+
後半の物語を示す画像2枚
を参照素材として使用しました。
つまり、まったく新しい動画をゼロから作るのではなく、
「この動画の続きを、この2枚の画像を手がかりに作ってください」
というイメージです。
「画像は2枚だけ」で、本当に足りる?
Seedance 2.5自体は、Pollo AI公式情報では最大30枚の画像、10本の動画、10個の音声という大規模な参照にも対応しています。
それでも今回は、追加する画像をあえて2枚だけにしました。
制作前は、
「2枚だけでは少ないのでは?」
と思っていました。
でも、実際に作ってみると考え方が変わりました。
2枚だからこそ、こんな役割分担ができます。
人間が決めること
物語
開始地点
到達地点
AIに任せること
その間の演技
キャラクターの動き
カメラワーク
場面を成立させる「間」
今回使用した2枚にも、それぞれ明確な役割を持たせました。
1枚は、前半から続く物語の状況を伝えるため。
もう1枚は、その先で到達してほしい演奏シーンを伝えるため。
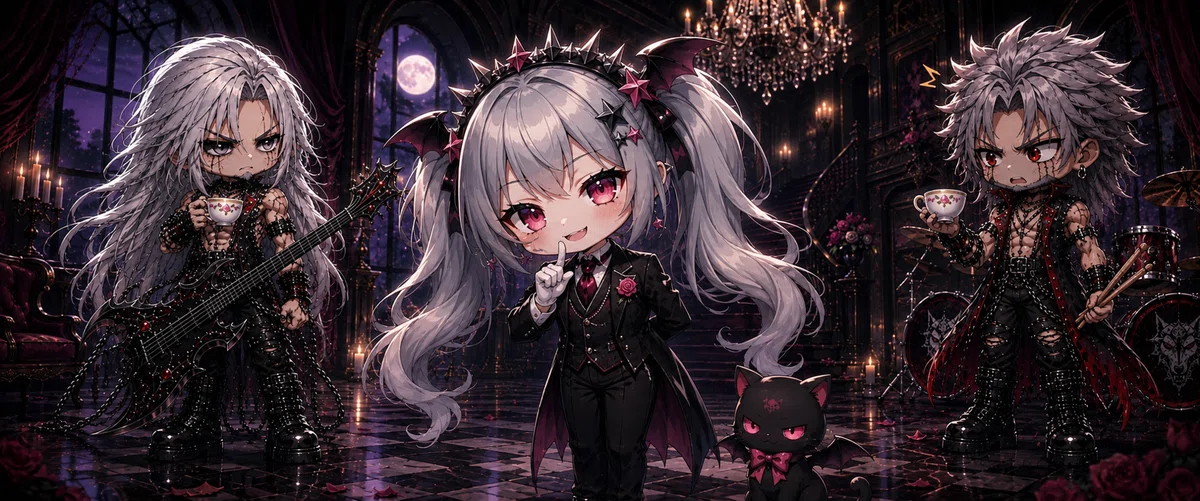
紅茶の秘密に気づき始めた2人と、小悪魔的に笑うリリス。
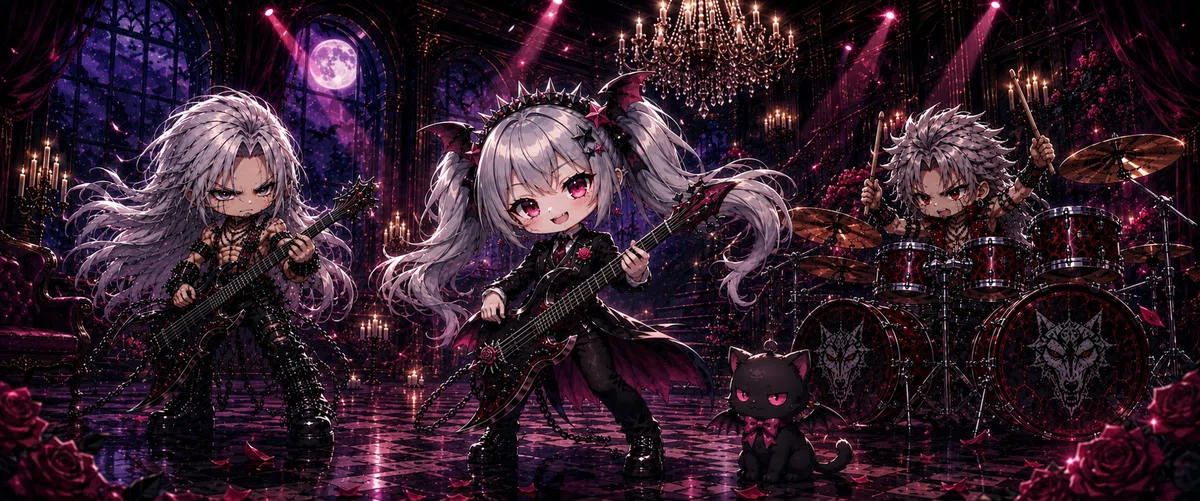
後半の到達地点として用意したゴシックメタルセッション。
動画①で出来上がったキャラクターや雰囲気を参照動画から引き継ぎつつ、
2枚の画像で、
「この先、物語がどこへ向かってほしいのか」
を補足する。
そんな使い方です。
そして今回、
動画①から最も引き継ぎたかったもの。
それは――
リリスの「声」です。
前の動画の「声」を引き継げるか?
動画①で、キャラクターに非常によく合った声が生成されました。
せっかく前半で良い声ができても、後半で突然違う声になってしまったら、
同じキャラクターなのに、別人のように感じてしまいます。
そこで今回確認したかったのが、
動画①を参照させることで、その「声」まで自然に引き継げるのか?
という点です。
結果として――
今回の動画②では、動画①のリリスとかなり自然につながる声になりました。
声質だけではありません。
可愛らしさ。
小悪魔っぽい話し方。
キャラクターとしてのテンション。
これらも含めて、
「さっきのリリスが、そのまま続きを喋っている」と感じられる結果になりました。
今回の制作では、参照動画を、
「次の30秒へ何を持っていきたいのか?」
を伝えるための素材として使っています。
今回なら、最優先したかったのはリリスの声でした。
※今回、参照動画を使用した「リファレンスから動画」は、iPhoneのブラウザからPollo AIのWeb版を使用しています。
参照動画を増やす場合はクレジットに注意
「リファレンスから動画」では、参照動画を添付する数によってクレジット消費も増えるので、この点は注意が必要です。
今回は必要な参照動画だけを使用しました。
一方、画像については、今回確認した範囲では添付枚数を増やしてもクレジット消費は変わりませんでした。
ティータイムから、いきなりメタルへ
動画②では、動画①より大きな場面変化を試しました。
静かなティータイム
紅茶の秘密を明かす
OYAKATAとValcusが反応
リリスが「朝までノンストップでいくよーっ!」
ゴシックメタルセッションへ
ここで、ティーカップを置く→立ち上がる→楽器を取りに行く→演奏位置へ移動するという細かな動作を、すべてAIにやらせるのはやめました。
代わりに、暗転。
画面を一度暗くして――
次の瞬間には演奏シーンです。
映像作品では普通の場面転換ですが、AI動画でもかなり有効でした。
▼ 実際に生成された
日本語版・動画② ▼
特に驚いたのが、演奏シーン。
ベース。
ギター。
そして――
ドラム。
Valcusの腕やスティックの動きも含め、かなり自然です。
単にキャラクターが楽器の前で暴れているのではなく、
「バンドが演奏している」
と感じられる映像になりました。
30秒+30秒。
本当に一本の作品になる?
完成した動画①を次の参照にして動画②を作ることで、
30秒+30秒。
約60秒の作品になりました。
今回の条件では、声も世界観もかなり自然につながっています。
これなら、
「1回30秒=作品全体も30秒まで」
と考える必要はない
と思います。
もちろん、長くなれば一貫性の確認も必要になります。
それでも、今回の60秒版は十分成立しました。
さらに英語版。
今度は90秒に挑戦
日本語版が想像以上にうまくいったので、
もう一段階進めました。
今度は、
英語音声+日本語字幕。
字幕は生成AIには入れさせず、後からCapCutで追加します。
そして今度は、30秒×3本。
合計約90秒です。
必要な画像を少数用意し、前の動画を次の動画の参照にしながら、30秒ずつつないでいきました。
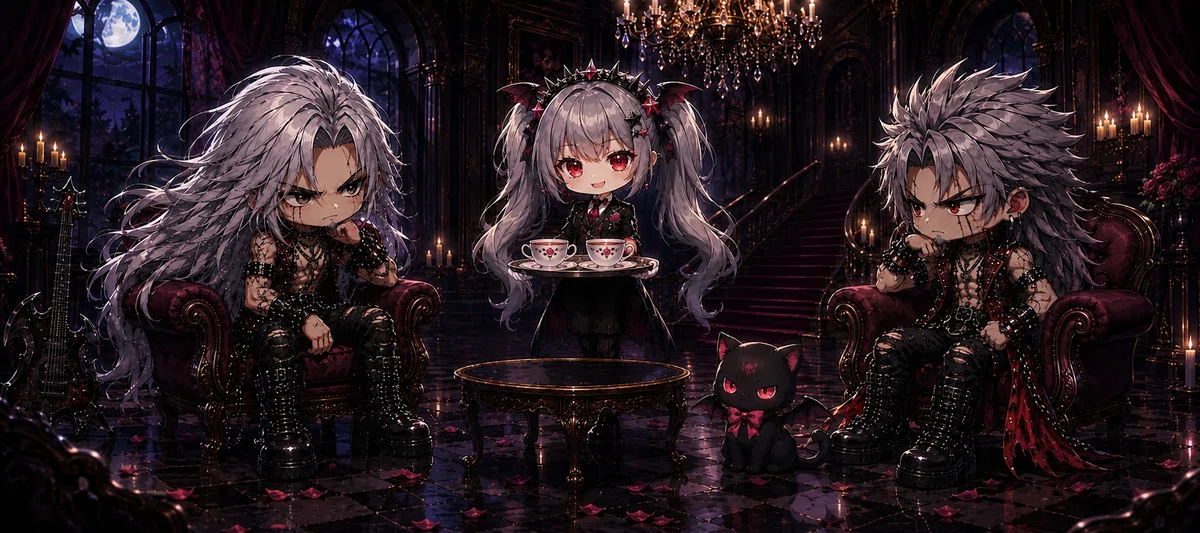
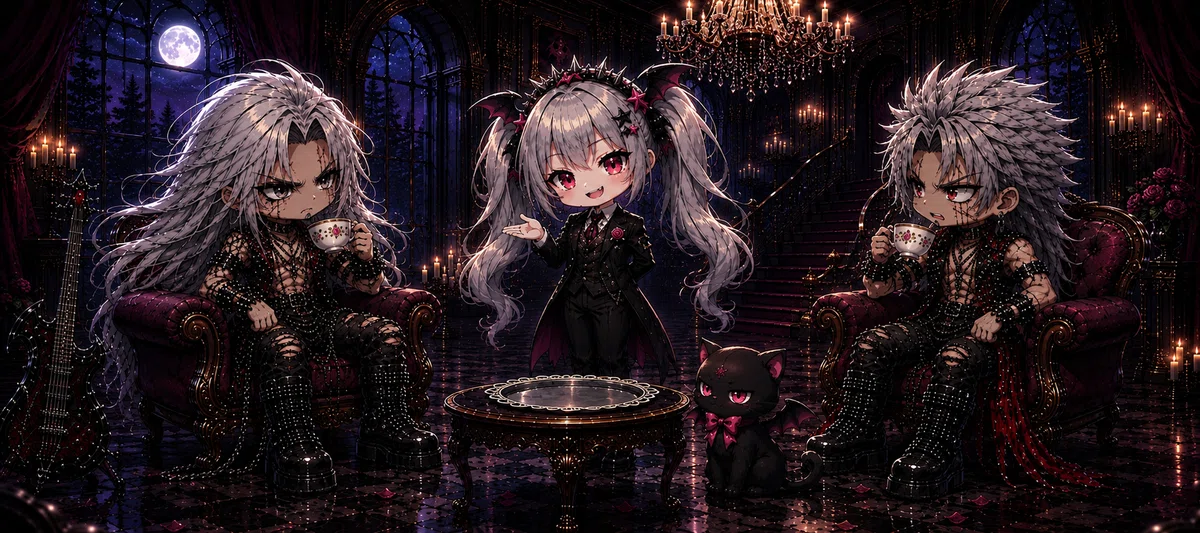
話している人に、カメラを寄せられる?
英語版では、複数キャラクターの会話で、
セリフを話している人物へカメラを寄せる。
という指示も試しました。
リリスが話す → リリスへ寄る
OYAKATAが話す → OYAKATAへ寄る
Valcusが話す → Valcusへ寄る
これができれば、一気に映画やアニメの会話シーンらしくなります。
結果は――
かなり綺麗に成功しました。
単純なデジタルズームというより、
「今、誰が話しているのか」を映像として見せるカメラワーク
になっています。
これは今回、特に印象に残った結果の一つです。
完成した約90秒のフルアニメーション
こうして完成したのが、英語音声+日本語字幕の約90秒版です。
▼ 『真夜中の優雅なおもてなし?』Full Animation ▼
数枚の画像から始まったことを考えると、想像していた以上に「ショートアニメ」として成立しました。
もちろん、全部完璧だったわけではない
ここも、そのまま紹介します。
今回、
「あ、AI動画だな(笑)」
と思った明確な不自然さが2か所ありました。
① Valcus、紅茶をフライング
動画開始5秒あたり、画面右側のValcusに注目してください。
手に持っていた2本のドラムスティックが、いつの間にかティーカップに変化。
そして、そのまま紅茶を飲み始めます(笑)
ただし、この間はリリスが画面へ向かって歩いてくるため、自然とそちらに目が行きます。
そのため――
ValcusのNGには、意外となかなか気づきません。
実際、最初に確認したときは私自身も気づきませんでした。
AI動画では、メインキャラクターだけではなく、
背景で他のキャラクターが何をしているのか
も確認した方が良さそうです。
② リリスの銀のトレイが……消えた
開始直後。
リリスが持っていた銀のトレイが――
ふっと消えます。
どこかへ置いたわけではありません。
消えました(笑)
ただ、消えるのは開始から1秒にも満たない一瞬。
かなり注意して見ないと、ほとんど気づかないと思います。
こちらは典型的な、小物の一貫性の破綻
ですね。
ただし今回、どちらも物語そのものを壊すほどではありませんでした。
そのため、再生成はしていません。
AI動画では、
「ミスがあるか?」だけではなく、「そのミスは視聴体験を壊すほどなのか?」
で再生成を判断するのも大切だと思います。
実際に何クレジット使った?
今回生成した動画は全部で5本。
すべて、
Seedance 2.5・30秒・480P
です。
実際に使用したクレジットはこちら。
日本語版①:225クレジット
日本語版②:253クレジット
英語フル版①:225クレジット
英語フル版②:253クレジット
英語フル版③:253クレジット
合計:1,209クレジット
完成した生成動画は、
日本語版:約60秒 + 英語版:約90秒 = 合計約150秒。
約2分30秒です。
今回は生成結果がかなり安定していたため、大きな作り直しがほとんどありませんでした。
当然ながら、
「1,209クレジットあれば、誰でも必ず同じ量を作れる」
という意味ではありません。
再生成が必要になれば、その分だけ消費量は増えます。
今回使ってみて、一番良かったところ
今回の検証を終えて、個人的に一番面白かったのは、
「AIが綺麗な動画を作ってくれる」
ということだけではありません。
それよりも、
こちらが全部を決めなくても、映像として成立するように間を考えてくれる。
ここでした。
人間側で、物語を考える。
キャラクターを作る。
重要な場面の画像を作る。
セリフを決める。
そして、「ここから、ここまで」をAIへ渡す。
その間の、
歩き方。
視線。
リアクション。
カメラワーク。
効果音。
場面のつなぎ方。
そうした部分をSeedance 2.5に任せる。
今回の制作では、この役割分担がかなりうまく機能しました。
2枚の画像から始めた「観る物語」は、どこまで広げられる?
最初の問いに戻ります。
少ない素材から始めた「観る物語」は、
どこまで広げられるのか?
今回の答えは――
想像していた以上のところまで作れました。
最初の30秒は、開始と終了を示す2枚の画像から。
そして、完成した動画を次の動画のリファレンスとして、
30秒 → 30秒 → 30秒
と物語をつないでいく。
今回の条件では、声やキャラクター性もかなり自然につながりました。
もちろん、小物や細かな行動タイミングにはAIらしいミスもあります。
だから、
「何でも完璧に作ってくれる」
とは思いません。
今回私が感じたSeedance 2.5の面白さを一言で表すなら、
「少ない素材から、映像を一緒に組み立ててくれる。」
これです。
人間が一コマずつ全部決めるのではなく、
かといって、全部をAI任せにするわけでもない。
人間が物語と重要なポイントを決め、
間の演出をAIに任せる。
今回のTEAM LILITHのようなショートストーリーでは、この作り方がかなり相性良く感じました。
Pollo AIでSeedance 2.5を試してみる
今回使用したSeedance 2.5は、Pollo AIから利用できます。
🔗 Seedance 2.5
Pollo AI全体についてはこちら。
🔗 Pollo AI
Pollo AI様からご案内いただいた情報では、現在Seedance 2.5は50%OFFキャンペーンが実施されています。
キャンペーンには期間がありますので、利用する場合は公開時点の最新情報をご確認ください。
また、日本公式Xではキャンペーンやイベント情報なども発信されています。
🔗 Pollo AI 日本公式X
今回制作した物語はこちら
今回の検証に使用したTEAM LILITHの、
『真夜中の優雅なおもてなし?』
本編記事では、
日本語版のショートアニメ、
楽曲、
そして英語音声+日本語字幕の約90秒フルアニメーションを、実際の物語と一緒に公開しています。
少ない画像から始まった、今回の検証。
気がつけばリリスたちは、
紅茶を運び、
喋り、
笑い、
いたずらを仕掛け、
最後には朝までメタルを演奏していました。
そして、たまに――
Valcusがフライングで紅茶を飲み、銀のトレイが消える(笑)
そんなところも含めて、
AIと一緒に映像を作るのは、なかなか面白いです😊
#Seedance25
#PolloAI
#AI動画
#動画生成AI
#生成AI
#AIアニメ
#ショートアニメ
#動画制作
#スマホ制作
#iPhone動画制作
#自主制作
#創作
#AI
#クリエイター
#TEAM_LILITH
