パパ育コミュのデータ活用・AIチャットの研究

リサーチ部門のリーダーを務めてます、ざくです。
リサーチ部門では、オープンリサーチラボとして、日々研究していることをオープンに情報発信していきたいと考えています。
ちなみに、standfmのパパ育コミュチャンネルでは、
「リサーチと~く」と題して、子育てとAIのお話をお届けしております。
ぜひ、よろしくお願いします。
さて、今日はパパ育コミュ内で進めているデータ活用のお話をしましょう。
1. パパたちが語ってきた・考えてきたことの継承
パパ育コミュにjoinする前から、子育ての知識の継承に課題を感じておりました。
お父さんたちから、
「ざくさんは、赤ちゃんの○○、どうしましたか?」と聞かれ、思い出すのに時間がかかって回答することが増えていたのであります。
広くWebで検索したり生成AIに回答させたりする次元とは違う、リアルな体験談(特に失敗談)を聞きたいというのが、子育てパパの世の常ではないでしょうか。
パパ育コミュにjoinした際に、様々なお話がやり取りされているのを見聞きし、データの利活用を実践したいと思ったのであります。
2. 実験的に作ったもの
2025年の5月~9月にかけて、自由研究のようなノリで、お父さんたちの語ってきたこと、考えてきたことをデータとしてかき集め、整理し、検索回答するプロトタイプを作りました。
何人かの方に触っていただきましたが、AIが引っ張り出してきた過去の話に感銘を受けるっていうことは無かったと思います。それは、ベストプラクティスを抽出してしまったからです。
こんなときどうしたらいい?と正解を知りたければ、
今はWeb検索したり、生成AIに回答させたりするでしょう??
こうしようと思ったができなかった、とか、試行錯誤が記録されているのがパパ育コミュのデータです。
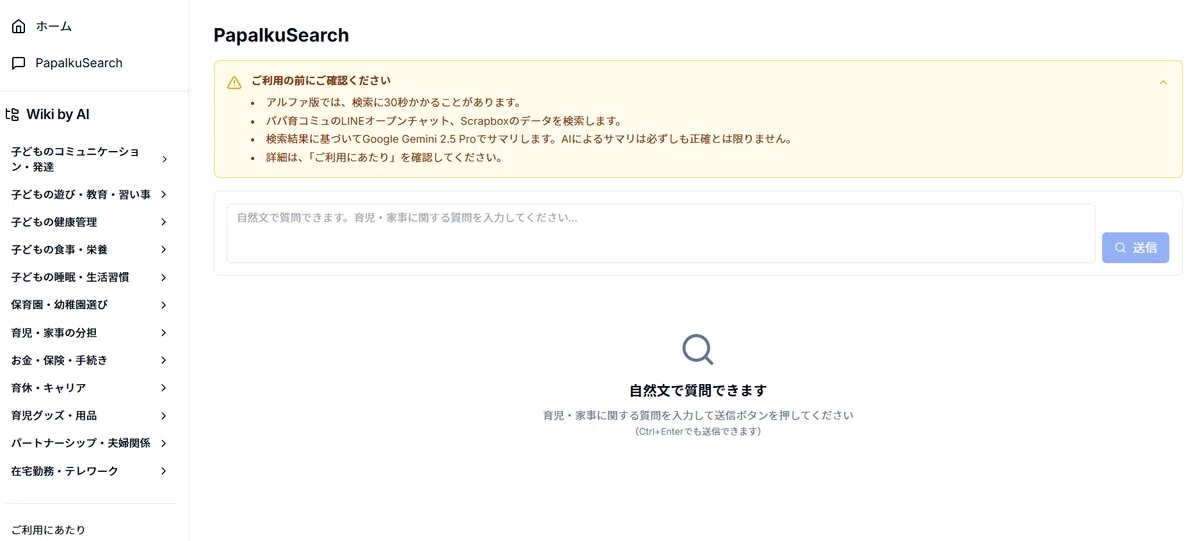
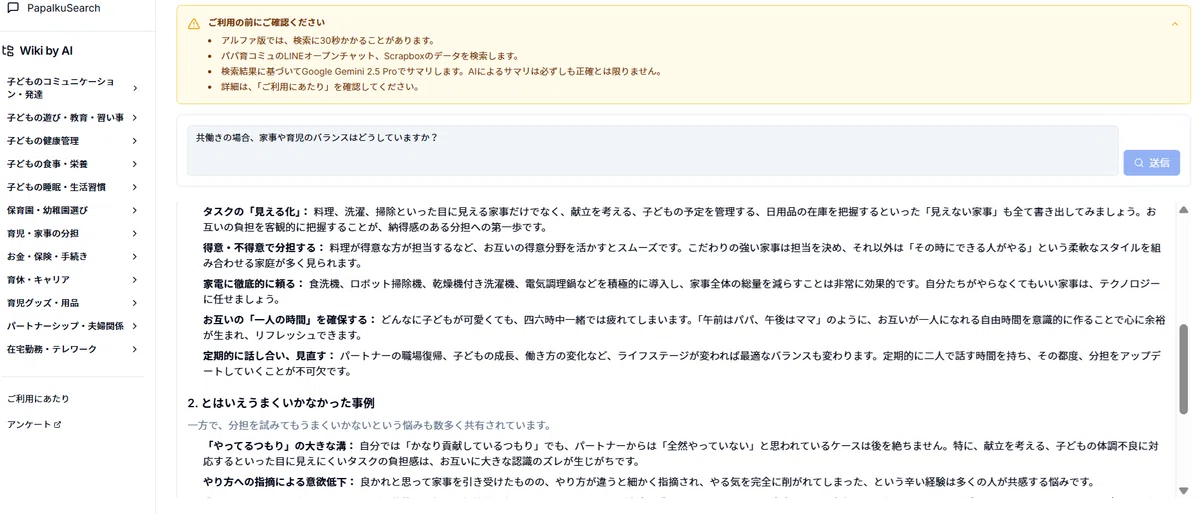
そこで、「とはいえ上手くいかなかった事例」なども見つけたら回答させるようにしました。データが利活用されることの意義を、コミュニティ内で共感してもらえたような気がします。
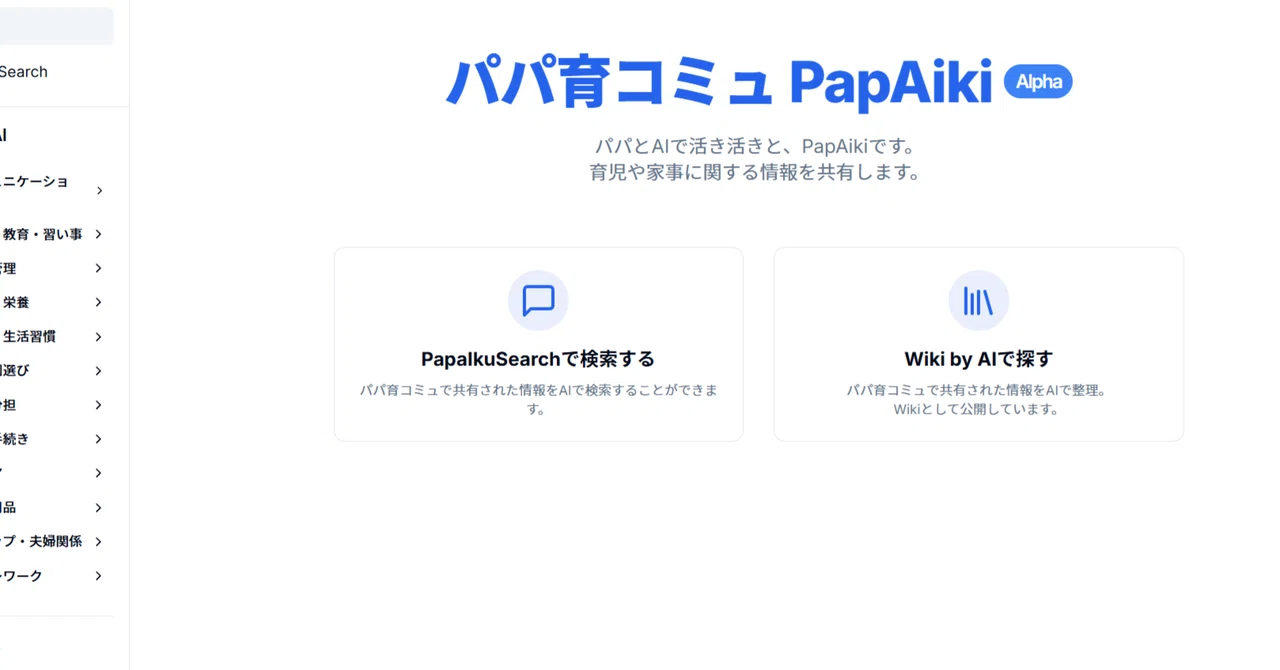
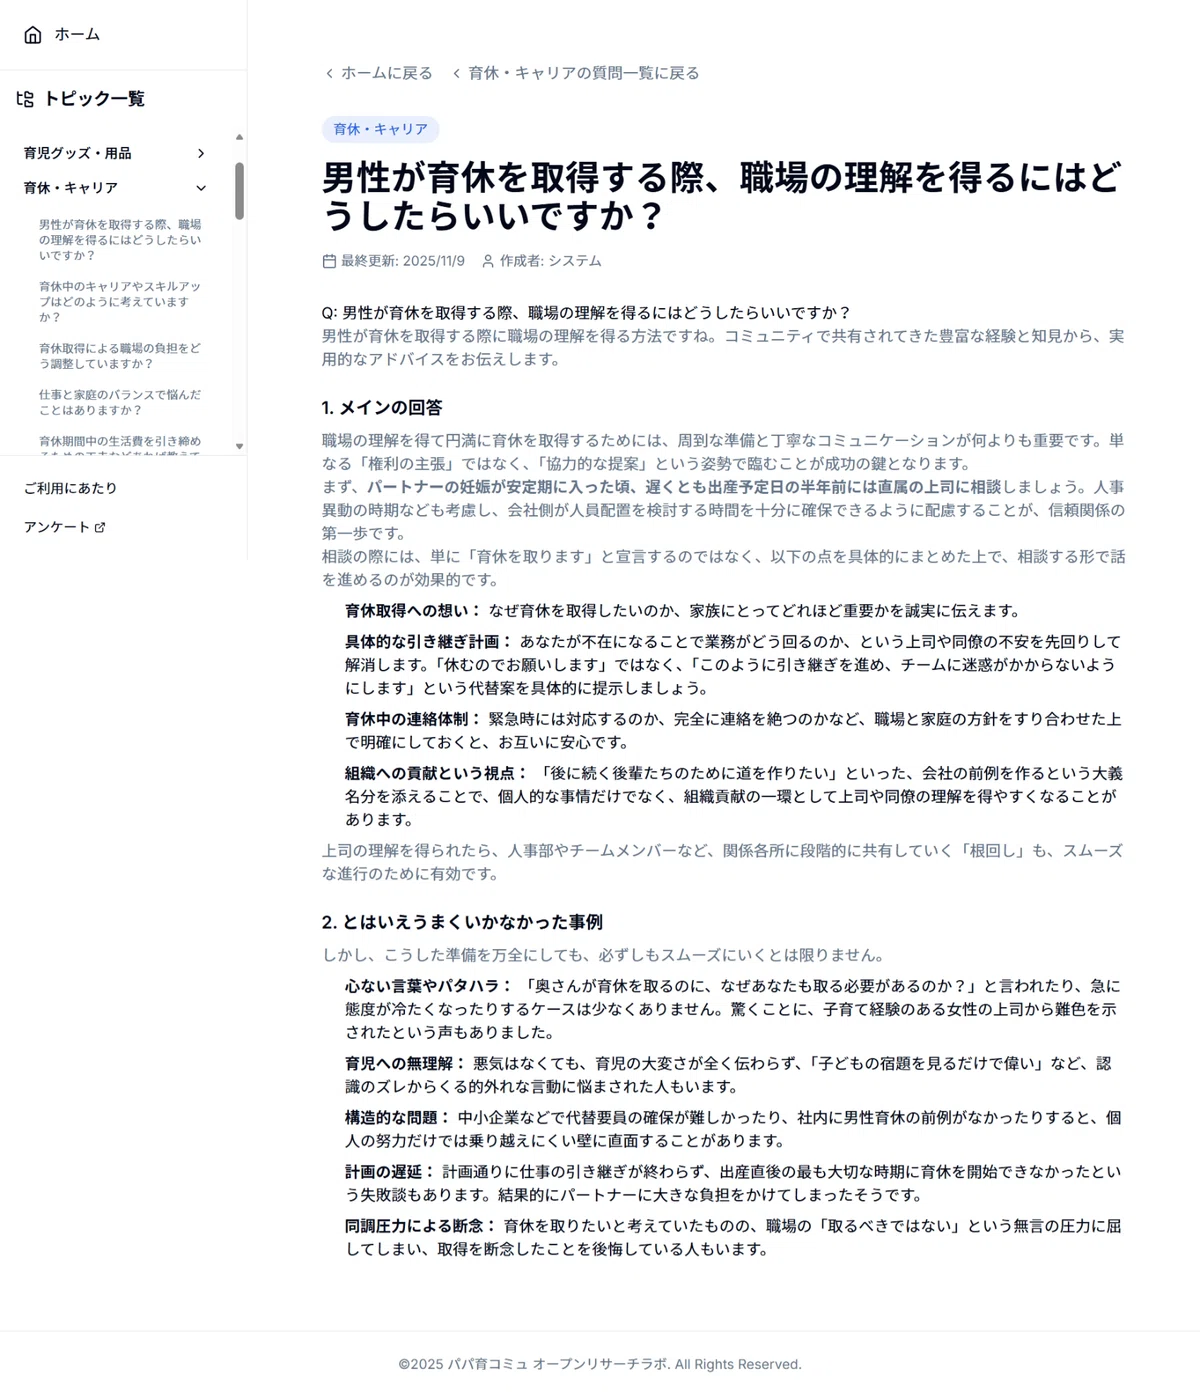
今は、研究を継続しており、データを再整理した結果をQA形式のwikiサイトとして仮設しております。パパとAIと活き活き、という合言葉で、PapAIkiというサイトとして。
3. 地道なデータの抽出・変換
そして、現在、このサイトの質をあげるため、データの前処理と変換にハマっています。好きでハマっています。なんでこんな手間のかかることをやりたいのかが自分でも、ちょっとわからないのです。
ただ、大規模言語モデル(LLM)の学習に使えそうなmarkdown形式のコーパスを作ってみたいとは思っています。LLMのファインチューニングやって当たり前のことに気付いています。「質のいいデータから良いAIが生まれる」。
といったところで、どんなデータの収集、変換をしているかご紹介します。
これは、私が書いたコードをCursorというエディタに投入して、生成AIに処理フローを描かせたものです。すいません、テキトーに仕上げております。
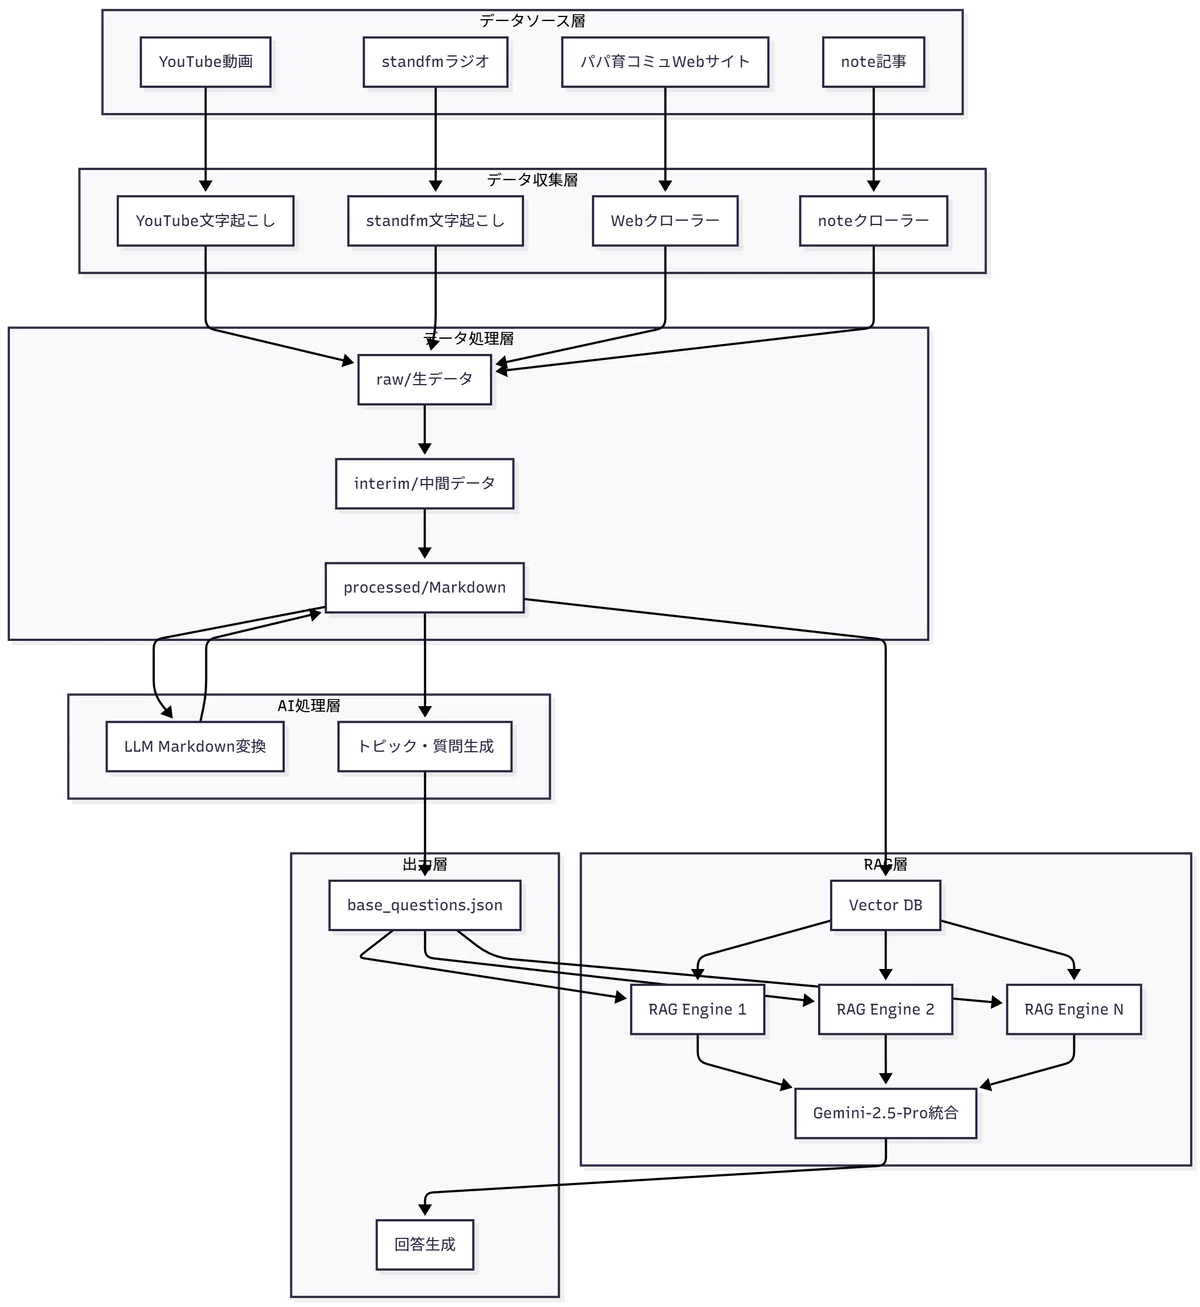
ちなみに、Cursorとは、私が一番好きなAIコードエディタです(ほかのAIコードエディタに比べてどこが好きかといった話は略します)。
それで、パパ育コミュでは公式YouTubeチャンネル、standfmのチャンネル、そしてパパ育コミュのWebサイト、公式noteなど、様々なデータがオープンになっています。もちろん、クローズでやり取りされているデータもたくさんあるわけですが。
音声・動画は、open-whisperというツールを使ってテキスト化しています。Webサイトやnote記事は、クローリングしたり、場合によってはスクショを取って画像から文字起こしもしたりしています(マルチモーダル大規模言語モデルを使ったり)。
テキストはmarkdownのように、整然と整理された情報に書き換えておきます。これもLLMを使って、markdownにするように指示しました。
ここまでできれば、あとは、アプリケーションにしたい人がどんな目的でデータを使いたいかによって、処理してくれという感じ。一応、それぞれのデータがmarkdownにいつ・どうやってなされたかというメタデータも管理しています。厳密なデータのバージョン管理はしていません。DVC(Data Version Control)を入れる必要はないだろう・・・
(補足)PapAIkiの作り方
QAサイトにしたかったので、一連のデータを順々にLLMに突っ込んで、トピックや「この文章が答えになりそうな質問」を列挙してもらいました。Cursorに、markdownを集めたフォルダ突っ込んで、トピックや質問を抽出してもいいでしょう。
その後、大量のmarkdownファイルを材料に、VertexというGoogleのプラットフォーム上でRAGエンジンを作ります。まあ、要は検索エンジンですね。データが大量にあるので、3つくらいに分割してそれぞれRAGエンジンを作るということをしています。
その後、抽出したトピックや質問を、複数のRAGエンジンに投入して、最後Gemini-2.5-proというLLMで回答を統合して生成するという手法をとりました。こうすると、ある質問に対してパパ育コミュのデータを参考にAIが回答を作ってくれるようになります。これでQA集の完成!
まあ、OpenAIのAgent Builderで、MCP/File searchを利用してAIエージェントを作ってみるということもやってみたいですね。
4. パパ育コミュが新しいエコシステムを作る
パパ育コミュは、非常に良いコンテンツが日々生み出されている場所だと思います。そのコンテンツを、皆さんの合意のもとで、再利用可能なものとし、次世代に伝えていくということがしたいと考えています。
再利用可能なデータですから、
これをもとに、自身の子育ての価値観を見返すことだって、
あるいは、芸術を生み出すことだってできるのではないかと思います。
ただ、AIという見せ方をするなら注意したい。
人間がAIのことをどう受け止めているか、いわゆるAI観は、まだ分かっていないところが多いからです。
AIが回答したって聞けば、せっかくの質の高いコンテンツも「へ~~そうですか」程度に終わってしまうかもしれないし、「AIはそういうかもしれないけど、実際そんなうまくいかないですよ」という反発を生むかもしれません。
AIチャット作ってみようといいながら、人間の受け止め方にはものすごく気を遣っています。ある程度受容が進んだりしていけば、パパ育コミュから提供されたデータでアプリ・AIを開発するといったエコシステムができあがるかもしれません。それは1つあり得る姿でしょう。
いいなと思ったら応援しよう!
 よろしければサポートをお願いします!頂いたお金は将来"男性育休"に関する電子書籍を出版する際の費用に当てさせていただきます!🦌🦍🌈
