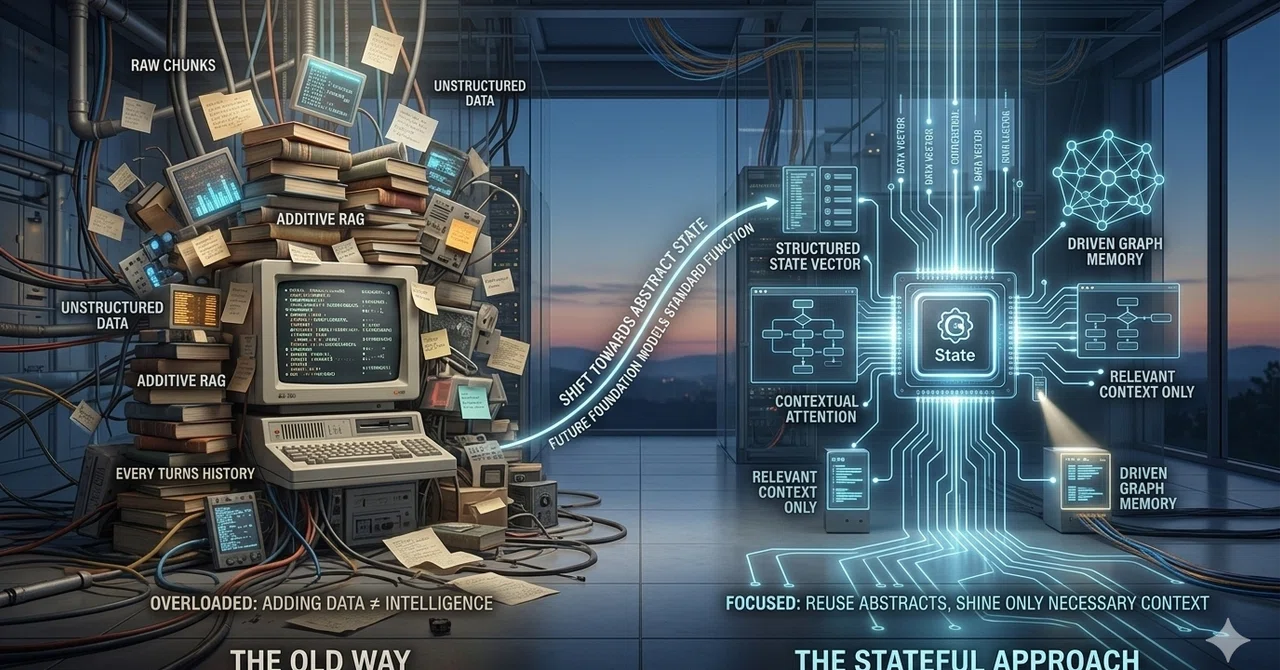
追いかけすぎるな。次に効くのは「新しいツール」ではなく、状態をどう持つかだと思う

AIエージェント界隈を追っていると、どうしても気持ちが焦る。
新しいharness、memory framework、workflow engine、graph memory、planning layer、RAG拡張。毎週のように新しい名前が現れて、「これを入れないともう遅れる」と思わされる。
でも、少し引いて見ると、おそらく今いちばん大事なのはそこじゃない。
むしろ逆で、あまり技術を追いかけ続けないほうがいいと思う。理由は単純で、本当に決定的なものは、最終的にはfoundation model企業の標準機能に吸収されるからだ。Codex CLIやClaude Codeがすでにそうなりつつあるように、memory、skills、sub-agent、conversation compactionといった発明は、「先進ユーザーの変な外付け」から「製品の標準機能」へと、着実に移行していく。
ということは、今個人開発者がやるべきことは流行のパッケージを全部試すことではなく、「どの抽象が将来まで残るか」を見極めることになる。
そしてその候補として、いまかなり有力に見えるのが状態(state)をどう持つかという問いだ。
ツールを増やしても、エージェントは賢くならない
多くの人が「エージェントがうまく動かない理由」をモデルの性能不足やツール不足として考えがちだ。でも実際には、うまくいかない原因のかなりの部分は、情報の持ち方が悪いことにある。
というより必要なツールはすでにある
エージェントは「たくさん覚えている」と強くなるわけじゃない。「今の状態に必要なことだけを、ちゃんと持っている」ときに強くなる。
これは言葉にすると当たり前に聞こえるけど、実際のシステム設計でここを意識できているかどうかは、かなり差がある。RAGを足し算し続けたり、会話ログをそのままpromptに詰め込んだりするアプローチが多いのは、「情報が多いほど賢くなる」という直感に引きずられているからだと思う。
論文が示した、かなり意外な結果
2026年3月に公開された論文「Diagnosing Retrieval vs. Utilization Bottlenecks in LLM Agent Memory」が、この問題に対してかなりシャープな示唆を出している。
この論文は、memory pipelineの性能差がどこから来るかを明らかにするために、書き方(write strategy)と取り出し方(retrieval method)を3×3で組み合わせて評価した研究だ。
書き方は3種類。raw chunk(そのまま保存)、Mem0スタイルのfact extraction(LLMで事実を抽出して保存)、MemGPTスタイルのsummarization(セッションをまとめて保存)。取り出し方も3種類。cosine similarity、BM25、hybrid rerankingだ。
結果は意外だった。
性能差は、書き方よりも取り出し方のほうがずっと大きかった。LoCoMoというベンチマークでは、retrieval methodの違いで精度が20ポイントも変わった(57.1%〜77.2%)のに対して、write strategyの違いは3〜8ポイント程度だった。
さらに驚いたのが、LLM呼び出しがゼロで済むraw chunk保存が、コストをかけて要約・抽出する方法に匹敵、あるいは上回る場面があったことだ。著者らはこれを「現在のmemory pipelineは有用な文脈を捨てている可能性がある」と解釈している。
要するに今の時点では、「賢く要約して保存すれば勝ち」ではない。むしろ「どう取り出すか」のほうがボトルネックになりやすいということだ。
でも、raw chunk を全部抱えるのが正解でもない
ここで誤解しないほうがいいのは、この結果は「RAWのまま全部持てばいい」という結論ではないということだ。
raw chunkが有効なのは、現時点の書き方技術(要約・抽出)がまだ粗くて、情報を捨てすぎているからだ。つまり「書き方が十分に成熟していない段階では、下手に加工しないほうがマシ」という話であって、永続的に正しい戦略ではない。
raw chunkを抱え続ければ、コンテキストはどんどん太っていく。長期的なエージェントでは、それ自体がボトルネックになる。
実際、別の研究では、エラーが記憶に残り続けることで将来の判断を汚染する「error propagation」や、似ているけど微妙に違う記録が逆に邪魔をする「misaligned experience replay」という問題も報告されている。全部持てばいいという話でもないわけだ。
ここで必要になるのが、単なるmemoryではなく、状態の表現という考え方だ。
state vectorは、記憶ではなく「現在地」を持つ仕組みだ
state vectorという言葉を数学的なdense vectorとして理解すると少しズレる。ここで重要なのは「今このシステムがどういう状態にあるか」を、固定スロットで持てることだ。
たとえばこういうものだ。現在の目的、今のフェーズ、直近の失敗パターン、前回試した修正、現在有力な仮説、今回参照すべき文脈キー。これらを長い会話ログの中に埋めるのではなく、取り出しやすい状態として別に持つ。
これが核心で、state vectorは「すべてを覚える仕組み」ではない。むしろ「何を残すべきかを絞る仕組み」だ。
普通のRAGが浅いのは、断片を近さで拾ってくるだけだからだ。状態設計が深いのは、断片から「今再利用すべき抽象」を抜き出すからだ。深さとは情報量ではなく、次の判断に再利用できる抽象度のことだと思う。
graph memoryはその文脈で、かなり強い手段になる
このあたりの話をしていると、graph memoryという方向に自然に流れていく。それは間違っていない。
ただ、graphを作ること自体が本質ではない。本質は、生の履歴をそのまま入れず、状態に圧縮してから必要な文脈だけ再構成することだ。graphはそのための実装手段の一つにすぎない。
GraphRAG的な発想が面白いのは、「関連チャンクを引く」のではなく「知識の関係構造やcommunity summaryを経由して上位の意味構造を取る」ことを狙っているからだ。つまりgraphは単なる距離計算の地図ではなく、関係と要約のための土台として機能している。
実際の構造はこう考えるのが自然だろう。生履歴がある。そこからentity、relation、要約、失敗パターン、進捗のようなものを抽出する。その一部はgraphに載り、その一部はstate vectorに載る。query時には、stateを見て、必要なgraph部分やsummaryだけを再構成してモデルに入れる。graphはmemoryの主役ではなく、state-driven retrievalを支える索引層に近い。
cloud LLM時代の現実問題:状態を作ることにもコストがかかる
ここには少し正直に話しておきたい現実がある。
cloud LLMを使うと、state vectorを作る処理自体にお金がかかる。ingestion(事実・関係・要約を抽出する段階)でもassembly(今回どの文脈を入れるかを組み立てる段階)でも、LLMを回せば当然コストが乗る。
つまりstate-firstの設計は無料ではなく、下手をすると雑なRAGより最初は高く見える。
ただ長期的には、毎ターン無関係な履歴を大量に投入し続けるより、最初にコストを払って状態に圧縮したほうがその後の繰り返しで節約できる。この二面性がある。
決定版ツールはまだない。でも方向はかなり見えている
結論から言うと、今の時点で決定版と呼べるものはまだない。
ただ「何も決まっていない」という意味でもない。勝ち筋の部品はかなり見え始めている。ただそれらが一つの完成形に統合されてはいない。
LangGraphのようなものはstateful workflowの骨格として強い。Claude Codeのskills・memoryは「必要なときだけ関連文脈を呼ぶ」方向に寄っていて、Anthropicのドキュメントでもskillsは「relevant になったときに読み込む」「SKILL.mdを簡潔に保つ」と明記されている。これは「全部を前提にしない」という思想そのものだ。OpenAI側でもCodex CLIはローカルコードベースを読み・編集・実行できるエージェントとして提供されており、Projects・Memoryでの継続的な文脈保持も整備が進んでいる。
方向性ははっきりしている。「状態を持つ」「必要時だけ読む」「文脈は圧縮する」「役割ごとに分ける」という流れだ。
それでも決定版がないのは、各社がまだ最適な粒度を探っているからだと思う。何をrawで持つべきか、何を要約すべきか、何をstateに落とすべきか、検索はbm25かhybridか、利用時にsummaryを返すのかfactを返すのか。この設計空間がまだ固まり切っていない。
長期的には、これも標準化される
ここが重要だと思っている。
本当に効くものがあれば、それは最終的に標準化される。これは過去1年の流れを見ていれば自然な予測だ。かつて「外付けの工夫」だったskills、memory、sub-agents、conversation compactionが、今では製品機能として組み込まれていく。
だからstate vector的な発想が本当に決定的なら、いずれそれも、露骨な名前ではないにせよ、foundation companyの標準機能になるはずだ。
たぶん将来は、ユーザーが「state vector」という言葉を意識しなくても、「今どこで詰まっているか」「何を試して何が失敗したか」「次に何を見るべきか」「どの文脈だけを入れるべきか」が製品側で当たり前のように整理されるようになる。そのとき初めて、多くの人は「エージェントが急に賢くなった」と感じるはずだ。
でも実際に起きていることは、モデルが魔法のように賢くなったことではなく、状態管理がようやくまともになったことだ、と思う。
結局、いま見るべきものは何か
パッケージ名ではなく抽象を見るべきだと思う。
新しいmemory frameworkを全部試す必要はない。全部のgraph DBを触る必要もない。全部のRAG改良案を追う必要もない。
見るべきなのはもっとシンプルだ。この仕組みは生の履歴を増やしているだけか、それとも再利用可能な状態へ圧縮しているか。全部を持たせようとしているか、必要なものだけを注入しようとしているか。現行モデルの弱点を補うだけの小手先か、将来本体に吸収されうる抽象か。
その目で見たとき、次に残るのは「派手なツール」ではなく「stateをどう持つか」という設計のほうだと思う。
RAGを増築し続ける時代から、状態を設計する時代へ。たぶん今はその変化の入口にいる。決定版はまだないけど、方向はかなり見えている。
参考:Boqin Yuan et al. "Diagnosing Retrieval vs. Utilization Bottlenecks in LLM Agent Memory" (arXiv:2603.02473, 2026)
#AIエージェント #LLM #RAG #状態管理 #コンテキストエンジニアリング #AIAgent #MemoryManagement #ContextEngineeling #生成AI #ソフトウェア設計
いいなと思ったら応援しよう!
 あなたの温かい応援が、より良い記事を書く原動力になっています✨ 一緒に価値ある情報を広め、多くの人の成長をサポートしていきませんか?小さなご支援でも、大きな変化を生み出す力になります。心から感謝しています💕
