AIエージェント時代のインフラ設計入門|AgentOpsとは何か

AIエージェントを作る技術は、ここ数年で一気に身近になりました
ChatGPTやClaudeのようなLLMに指示を与えるだけではなく
Webを検索する
APIを呼び出す
データベースを参照する
ファイルを作成する
Slackへ投稿する
メールを送信する
コードを実行する
別のAIエージェントへ仕事を依頼する
といったところまで、AIが自律的に実行できるようになっています
しかしここで、インフラエンジニアとして気になることがあります
そのAIエージェント、本番環境でどうやって運用するのでしょうか
例えばAIが突然APIを1000回呼び出したらどうするのか
間違ったツールを選択したらどうするのか
同じ処理を延々と繰り返したらどうするのか
誰の権限で処理を実行したのか、後から確認できるのか
AIモデルを変更した結果、回答品質が悪化したことをどう検知するのか
トークンを大量消費して、1日で数万円の請求が発生したらどうするのか
こうした問題を考えると
AIエージェントにも運用設計が必要
ということが分かります
そこで重要になってくる考え方が
AgentOps
です
今回は、インフラエンジニアにも分かるようにAgentOpsを解説しながら
AIエージェント時代のインフラはどのように設計すればいいのか
を考えていきます
そもそもAIエージェントとは
まず普通のLLMアプリとAIエージェントの違いを簡単に整理します
通常の生成AIアプリは
ユーザー
↓
プロンプト
↓
LLM
↓
回答
という構成が基本です
一方でAIエージェントになると
ユーザー
↓
AIエージェント
↓
状況を判断
↓
ツールを選択
↓
API / DB / Web / SaaSを操作
↓
結果を確認
↓
次の行動を判断
↓
必要なら再実行
↓
最終結果
となります
つまりAIエージェントでは
AIが判断するだけではなく、実際に行動する
というところが非常に大きな違いです
ここからインフラ設計も変わってきます
従来のシステム運用では足りない
例えば一般的なWebアプリケーションであれば
User
↓
Load Balancer
↓
Application
↓
Database
という構成があり
CloudWatchやDatadog、Prometheusなどを使って
CPU
Memory
Disk
HTTP Status
Response Time
Error Rate
などを監視します
CPU使用率が90%を超えた
HTTP 500が急増した
レスポンスタイムが5秒を超えた
このような異常は比較的分かりやすく検知できます
ところがAIエージェントでは
サーバーが正常でもAIが異常
ということが普通に発生します
例えばこんな障害が起きる
ECサイトに返品処理を行うAIエージェントがいたとします
ユーザーが
商品を返品したい
と問い合わせます
AIは注文情報を確認し、返品可能か判断して、返金APIを呼び出します
ところが何らかの理由で
注文確認
 ↓
返金API
 ↓
結果確認
 ↓
判断ミス
 ↓
返金API
 ↓
結果確認
 ↓
返金API
 ↓
返金API
 ↓
返金API
 ↓
というループに入ってしまったとします
CPU使用率:20%
Memory使用率:30%
HTTP Status:200
サーバー監視上は完全に正常かもしれません
しかし実際には重大障害です
そこで必要になるのが
AIエージェントそのものを監視する仕組み
です
AgentOpsとは
AgentOpsという言葉にはまだ完全に統一された定義があるわけではありません
研究でも、AIエージェントのライフサイクル全体に対して、
監視・ログ・分析・異常検知・原因特定・復旧などを行う運用体系として整理が進んでいます
この記事ではAgentOpsを
AIエージェントを安全・安定・効率的に本番運用し、継続的に改善するための運用設計・監視・評価・ガバナンスの仕組み
と考えます
かなり簡単に言えば
DevOps + Observability + LLMOps + AI Evaluation + Security
+ Governance + Cost Management
をAIエージェント向けにまとめ直したような考え方です
注)なお「AgentOps」という名称のAIエージェント監視サービスも存在しますが、この記事で扱うAgentOpsは特定製品ではなく
AIエージェント運用という考え方そのものを指します
DevOps/MLOps/LLMOps/AIOps/AgentOpsの違い
ここはかなり混同されやすいところです
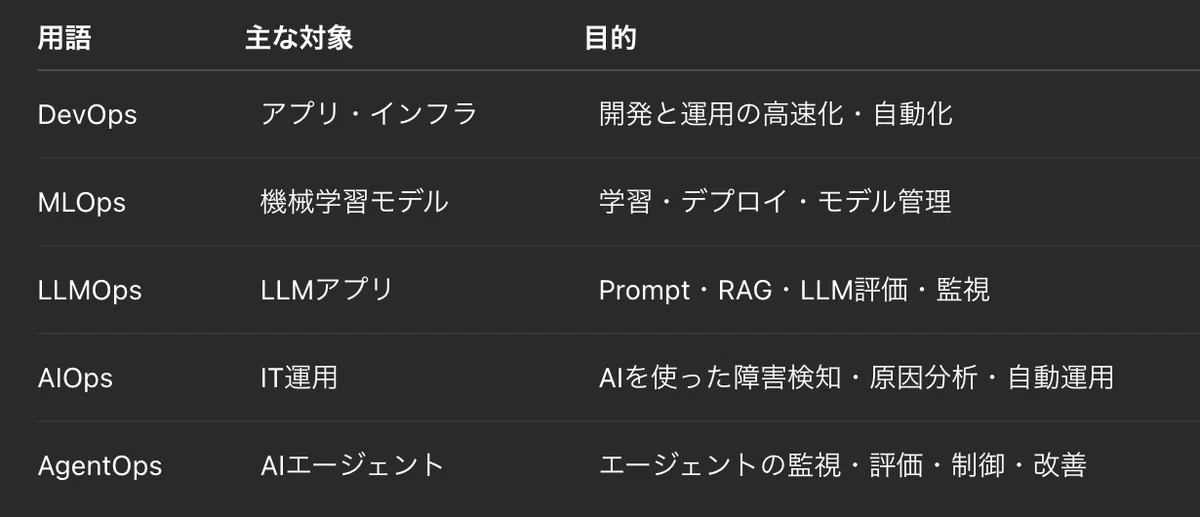
特にAIOpsとAgentOpsは名前が似ていますが
AIOpsはAIを使ってインフラを運用するという意味で使われることが多いのに対して
AgentOpsはAIエージェント自体を運用するという違いがあります
もちろん今後は
AgentOpsで管理されたAIエージェント
↓
インフラをAIOpsする
という世界も増えていくはずです
なぜAgentOpsが必要なのか
AIエージェントには従来のアプリケーションには少なかった特徴があります
それが非決定性です
例えば
def add(a, b):
    return a + b
なら
1 + 1 = 2は何度実行しても同じです
ところがLLMは必ずしもそうではありません
同じ入力でも
使用モデル
Prompt
Context
Memory
Temperature
外部データ
Toolの状態
などによって出力が変わる可能性があります
さらにAIエージェントでは、その結果を使って次の行動を決定します
つまり
LLMの出力
↓
ツール選択
↓
ツール実行結果
↓
次のLLM判断
↓
次のツール
という連鎖になります
1つの小さな判断ミスが、その後の処理全体へ影響する可能性があります
だから
最終回答だけ監視しても足りません
AgentOpsで見るべきなのは「途中経過」
ここが非常に重要です
AIエージェントでは
Input
 ↓
Reasoning
 ↓
Model Call
 ↓
Tool Selection
 ↓
Tool Call
 ↓
Tool Result
 ↓
Model Call
 ↓
Action
 ↓
Output
という処理全体を追跡できるようにする必要があります
この考え方が
Tracing
です
LangSmithはLLM・AIエージェントに対するTracingや本番監視を提供しており、LangfuseもTrace、Session、Observationなどを中心にLLMアプリケーションを可視化できます
さらに現在はOpenTelemetryでもGenAI向けSemantic Conventionsの整備が進んでおり、LLMだけではなくMCPなどを含めたテレメトリ標準化が進められています
つまり将来的には
アプリ監視
コンテナ監視
ネットワーク監視
DB監視
AIエージェント監視
をOpenTelemetryベースで横断的に追跡する構成もかなり重要になってきます
AIエージェント時代のインフラ構成
では実際にどのような構成になるのでしょうか
かなり単純化すると
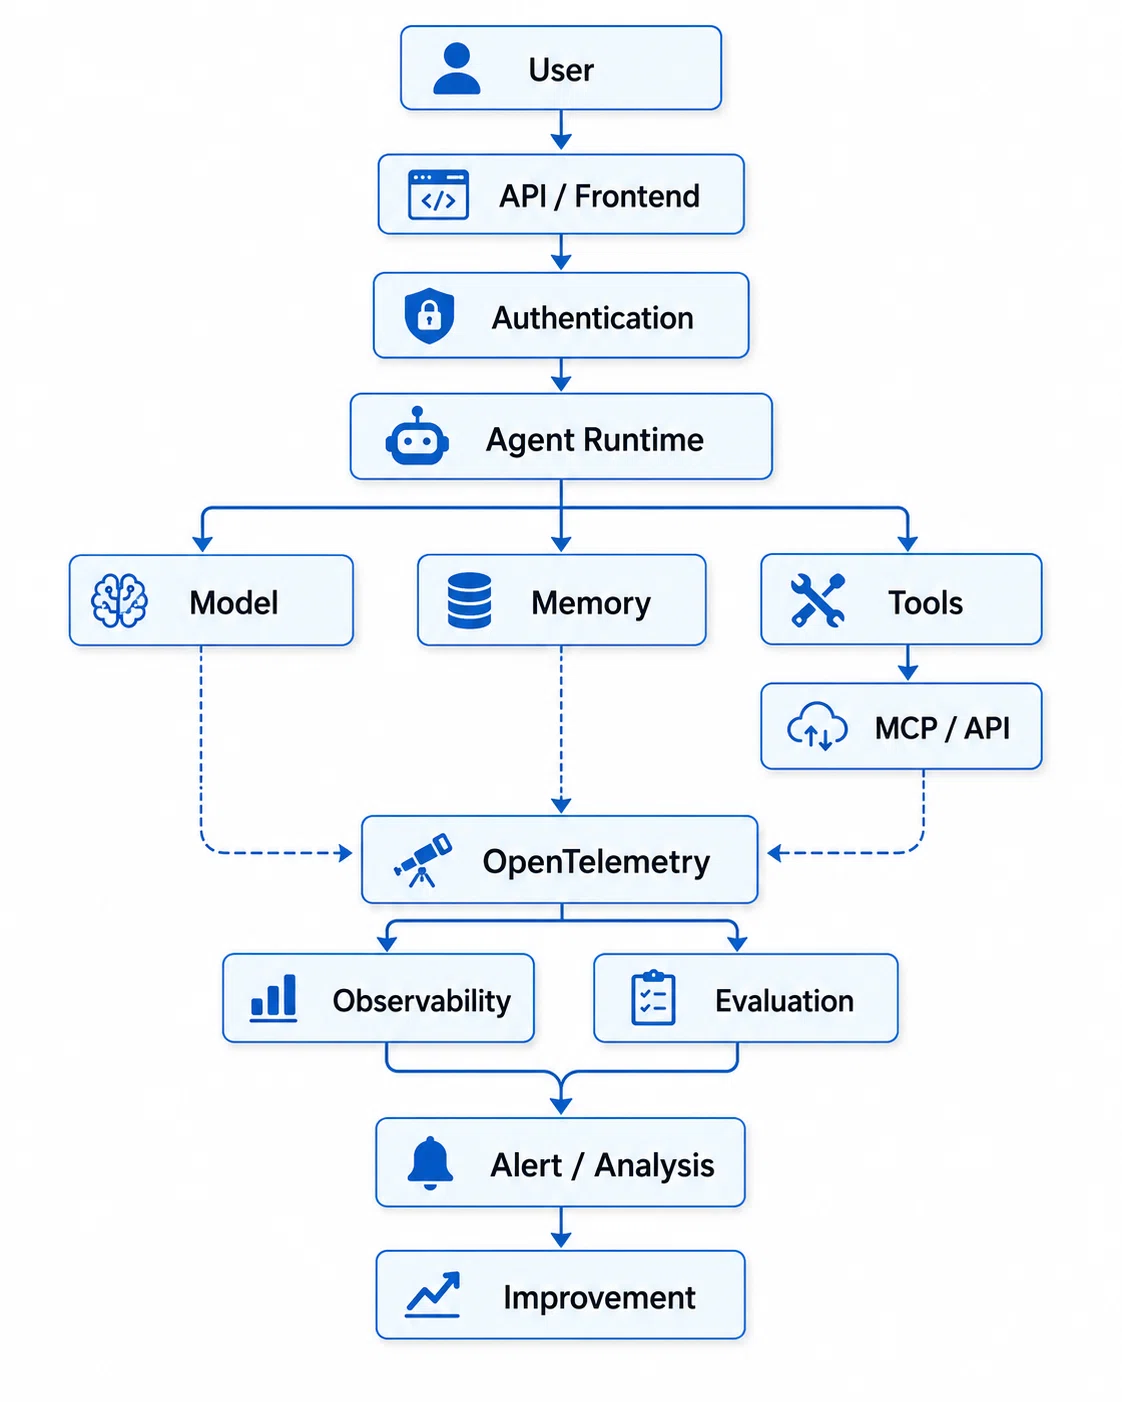
こうなってきます
Webアプリケーションの後ろにLLMを追加しただけではありません
Agent Runtimeを中心として、Identity、Memory、Tool、Observability、Evaluationを設計する
というのがポイントです
AgentOpsで考えるべき8つの設計
ここからがインフラエンジニアにとって重要な部分です
① Agent Runtime
最初に考えるのがAIエージェントをどこで動かすかです
候補としては
コンテナ
Kubernetes
AWS Lambda
ECS
EC2
Amazon Bedrock AgentCore Runtime
その他Agent Runtimeサービス
などがあります
普通のWeb APIと異なり、AIエージェントでは処理が数十秒から数分以上続くケースがあります
さらに
LLM
↓
Tool
↓
LLM
↓
Tool
↓
LLM
と処理時間も予測しにくくなります
そのため
Timeout
Retry
Queue
非同期処理
Session
Isolation
Concurrency
などを意識したRuntime設計が重要になります
Amazon Bedrock AgentCore Runtimeではセッション分離やエージェント向けRuntime機能が提供されており、
LangGraph、CrewAI、OpenAI Agents SDKなど複数のフレームワークにも対応しています
② Identity
個人的に、AIエージェント時代にかなり重要になると思っているのが
Agent Identityです
例えば
人間
↓
AIエージェント
↓
Slack
GitHub
AWS
Google Drive
Salesforce
Database
という環境を考えます
ここで
AIエージェントは誰としてアクセスするのか
という問題が発生します
管理者権限を1つ渡して全AIで共有という設計はかなり危険です
理想的には
人間A
↓
Agent A
↓
Agent A Identity
↓
許可されたToolのみ
という形にします
AIエージェントそのものを
1つのWorkload Identity
として扱う考え方です
Amazon Bedrock AgentCoreでもIdentity機能が提供されており、
Runtimeに対してWorkload Identityを割り当てる仕組みがあります
③ Tool Gateway
AIエージェントへ直接APIキーを大量に渡す構成も避けたいところです
例えば
Agent
 ├ AWS API KEY
 ├ Slack Token
 ├ GitHub Token
 ├ Notion Token
 ├ Salesforce Token
 └ Google Token
となったら管理が大変です
そこで
Agent
 ↓
Tool Gateway
 ├ GitHub
 ├ Slack
 ├ Database
 ├ AWS
 ├ Notion
 └ Salesforce
という構成が考えられます
最近であればMCPを利用して
Agent
↓
MCP Gateway
↓
MCP Servers
↓
各システム
という構成もできます
Amazon Bedrock AgentCore GatewayもAPIやLambdaなどをMCP互換ツールとしてエージェントへ公開する仕組みを提供しています
さらに重要なのは接続できることと、実行していいことは別という点です
④ Policy
例えば経費精算AIが
get_expense
create_expense
approve_expense
delete_expense
という4つのToolを利用できるとします
だからといってAIに全部自由に使わせる必要はありません
例えば
get_expense
→ 常時許可

create_expense
→ 10万円以下のみ許可

approve_expense
→ 人間の承認必須

delete_expense
→ 禁止
といったPolicyを設定します
つまりAIが何をしたいかを考える部分とその行動を本当に許可する部分を分離します
これはかなり重要です
Amazon Bedrock AgentCore PolicyでもGateway経由のTool呼び出しに対してPolicy Engineで許可・拒否を判定する構成が提供されており、
Cedarによる細かな制御が可能です
AIに
この操作をしてはいけません
とPromptで書くだけではなく
インフラ側でも止める
という設計にするわけです
⑤ Memory
AIエージェントにはMemoryも必要になります
例えば
Short-term Memory

現在のConversation
現在のTask
現在のSession
と
Long-term Memory

ユーザー情報
過去の作業
学習した情報
過去の判断
では性質が違います
そのためMemoryも
Session Memory
Long-term Memory
Vector Database
RDB
Object Storage
などへ役割分担する必要があります
ここでもインフラ的な考え方が必要です
保存期間
Encryption
Backup
Retention
個人情報
Tenant分離
Access Control
削除
データ所在地
などです
「AIの記憶」と言うと特殊に聞こえますが
インフラ的に考えれば
新しいState Management
と捉えると分かりやすいと思います
⑥ Observability
AgentOpsの中心と言ってもいい領域です
最低でも
Metrics
Logs
Traces
は取れるようにします
しかし従来監視に加えてAI特有のデータも必要です
例えば
Infrastructure Metrics
CPU
Memory
Network
Container数
Queue Length
Model Metrics
Token Usage
Model Latency
Request Count
Error Rate
Cost
Agent Metrics
Task Success Rate
Tool Call Count
Loop Count
Agent Step Count
Retry Count
Handoff Count
Tool Metrics
Tool Success Rate
Tool Latency
Tool Error Rate
Tool Selection Accuracy
Security Metrics
Denied Tool Calls
Policy Violation
Authentication Failure
異常な権限要求
といったものです
AWSでもAgentCore ObservabilityがCloudWatchと連携し、Session数、Latency、Duration、Token Usage、Error RateなどのメトリクスとTraceを扱えるようになっています
またAgentCoreのTelemetryはOpenTelemetry互換形式で出力できます
⑦ Evaluation
そしてAgentOpsで従来のObservability以上に重要になるのが
Evaluation
です
普通のサーバーなら
正常
異常
を比較的決めやすいですが
AIの場合
回答は返った

でも回答の品質が悪い
ということがあります
HTTP Statusは
200 OKなのにAIとしては失敗という状態です
だからAIではQualityそのものを監視する必要があります
例えば
Task Completion Rate
Correctness
Relevance
Hallucination
Tool Selection Accuracy
Goal Achievement
Policy Compliance
などを評価します
LangfuseでもEvalを継続的な品質チェックやRegression検知に利用する考え方が提供されています
Amazon Bedrock AgentCore Evaluationsでも、
Task Completion、Tool Accuracyなどを評価でき、LLM-as-a-Judgeを利用した評価も提供されています
つまりAIシステムでは
Availability
Latency
Error Rate
だけではなく
Quality
Accuracy
Safety
Goal Achievement
まで監視対象になるということです
⑧ Cost Management
そして忘れてはいけないのがコストです
AIエージェントは通常のAPI以上にコストが暴れやすい特徴があります
例えば
1 Task

LLM Call × 1
なら分かりやすいですが
Agentの場合
LLM Call
↓
Tool
↓
LLM Call
↓
Tool
↓
LLM Call
↓
Retry
↓
LLM Call
↓
別Agent
↓
LLM Call
となる可能性があります
つまり
1リクエスト = 1 API Call
ではありません
そのため
Cost / User
Cost / Session
Cost / Agent
Cost / Task
Cost / Successful Task
まで確認した方がいいでしょう
特に
Cost per Successful Task
は個人的に重要な指標だと思っています
Aというモデルなら
成功率 95%
1タスク 30円
Bというモデルなら
成功率 90%
1タスク 5円
となった場合
単純なToken単価だけでは判断できません
AgentOpsでは品質とコストをセットで評価する必要があります
AIエージェント時代の監視は4階層になる
ここまでを整理すると、今後の監視は大きく4つに分けると分かりやすいと思います
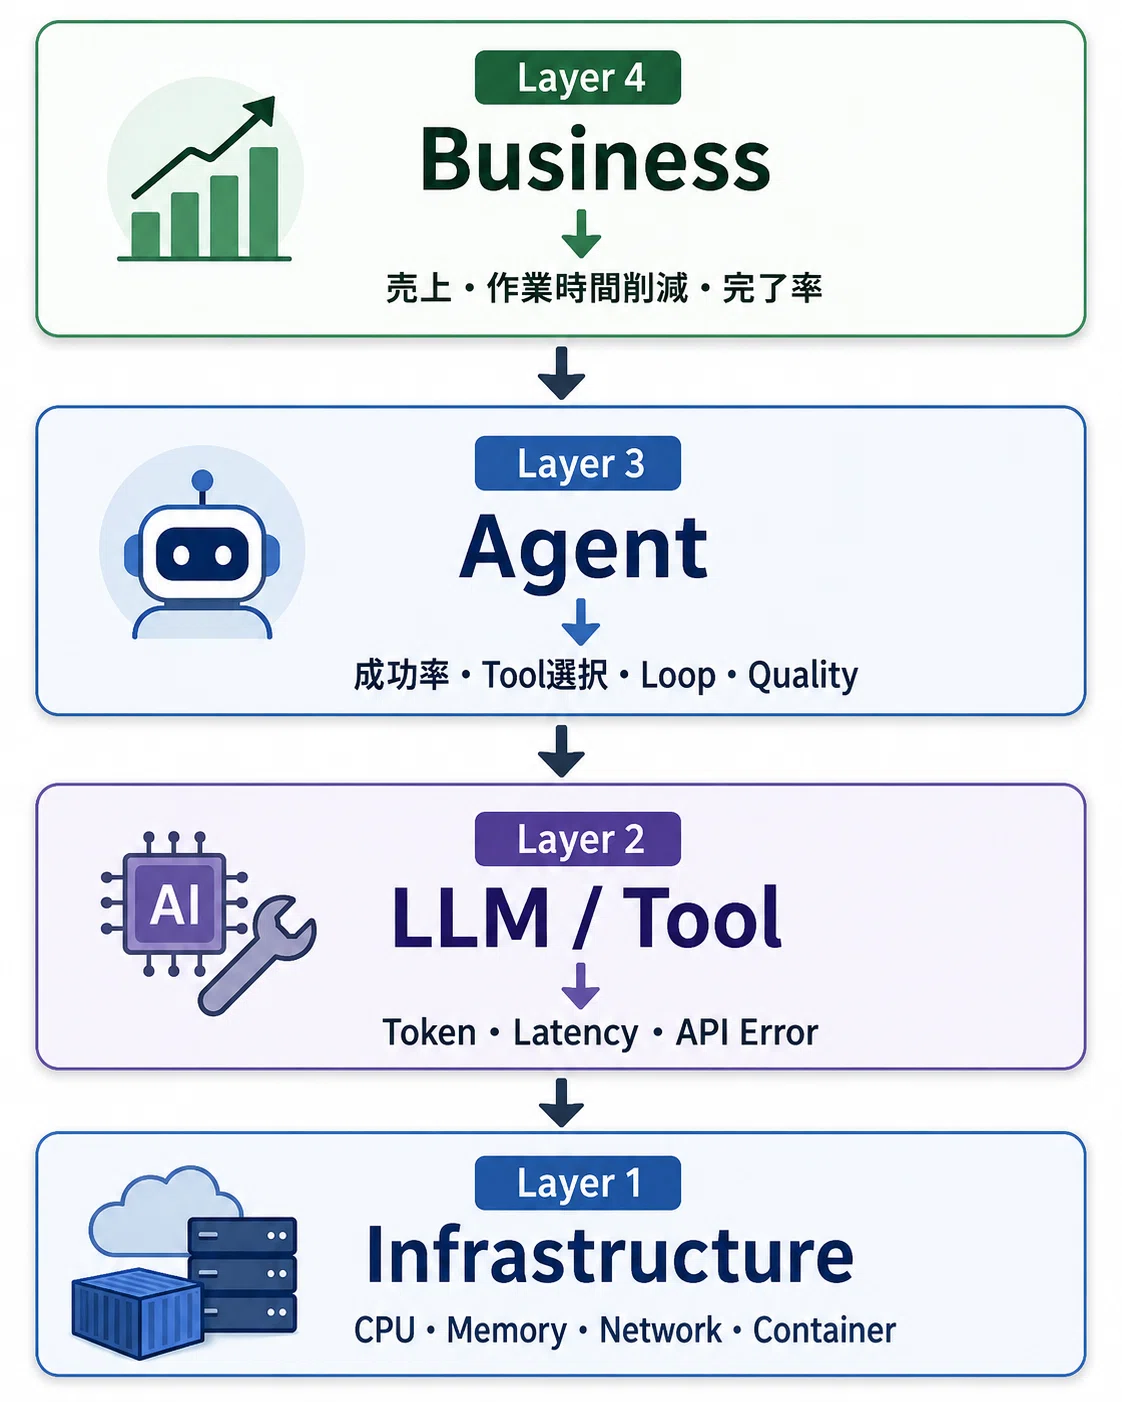
従来インフラ監視は主にLayer 1を見ていました
ObservabilityによってLayer 2までかなり見られるようになりました
AgentOpsではさらに
Layer 3とLayer 4まで見る
ことになります
SLIとSLOも変わる
SREではSLIやSLOを設定します
例えばWebサービスなら
Availability 99.9%
P95 Latency < 500ms
Error Rate < 1%
などです
AIエージェントではこれに
Task Success Rate > 95%

Tool Selection Accuracy > 98%

Policy Violation < 0.1%

Average Agent Steps < 8

Cost per Task < 10円

Human Escalation Rate < 10%
のような指標が加わるイメージです
つまりAgentOpsでは
AIの行動にもSLOを設定する
という考え方になっていきます
AIエージェント版CI/CD
AgentOpsでもCI/CDは重要です
ただし普通の
Code
↓
Build
↓
Test
↓
Deploy
だけでは足りません
例えば
Code
↓
Unit Test
↓
Agent Evaluation
↓
Security Test
↓
Prompt Test
↓
Tool Test
↓
Cost Test
↓
Deploy
↓
Online Evaluation
↓
Monitoring
というパイプラインになります
モデルを
Model A
↓
Model B
へ変更しただけでもAgentの挙動が変わる可能性があります
Promptを変更しても変わります
Toolを追加しても変わります
Memoryを変更しても変わります
だからAIエージェントではコード以外もVersion管理する必要があります
何をGitで管理するのか
例えば
agent/
├── prompts/
├── tools/
├── policies/
├── evals/
├── datasets/
├── workflows/
├── configs/
└── terraform/
という構成です
管理対象は
Agent Code
Prompt
Model Configuration
Tool Definition
MCP Configuration
Policy
Evaluation
Test Dataset
Infrastructure
などです
Terraformなどを使えばInfrastructure側についてもVersion管理できます
AgentOpsをAWSで組むなら
AWSを中心に考えるなら、例えばこんな構成が考えられます
User
 ↓
CloudFront
 ↓
API Gateway
 ↓
Authentication
 ↓
AgentCore Runtime
 ├─ Bedrock / 外部LLM
 ├─ AgentCore Memory
 ├─ AgentCore Gateway
 │     └─ MCP / API / Lambda
 └─ AgentCore Identity
          ↓
       Policy
          ↓
       Tools
Observability側は
AgentCore
↓
OpenTelemetry
↓
CloudWatch
↓
Metrics / Logs / Traces
さらに必要に応じて
Langfuse
LangSmith
Datadog
Grafana
などと組み合わせることもできます
AgentCore ObservabilityはAgentCore外でホストしたAgentのTelemetryをCloudWatchへ取り込む構成にも対応しています
Evaluationは
AgentCore Evaluationsまたは
Langfuse
LangSmith
独自Eval
などを利用できます
Securityでは
IAM
Agent Identity
KMS
Secrets Manager
Tool Gateway
Policy Engine
などを利用します
CI/CDなら
GitHub
↓
GitHub Actions
↓
Terraform
↓
Agent Deploy
↓
Evaluation
↓
Production
という構成も考えられます
ここで重要なのは製品ではない
AgentOpsを学ぶと
Langfuseを使えばいい、LangSmithを使えばいい、AgentCoreを使えばいいと思ってしまうかもしれません
しかし本当に重要なのは製品ではありません
例えば最低限
誰が
↓
どのAgentを
↓
どの権限で実行し
↓
どのModelを使用し
↓
何を考え
↓
どのToolを選択し
↓
何を実行し
↓
何が返ってきて
↓
最終的にどう判断し
↓
いくら掛かり
↓
結果は正しかったのか
を追跡できる設計にする
これが重要です
Human in the Loopもインフラ設計
AIエージェントというと
完全自動化
を目指したくなります
しかし実際には
Read → AIだけで実行
Create → AIだけで実行
Update → 条件付き
Delete → 人間承認
のように
処理の危険度によって自動化レベルを変更した方が安全です
例えば
AI Agent
↓
「本番DBを削除したい」
↓
Policy Engine
↓
High Risk Action
↓
Human Approval
↓
Execute
という構成です
つまりHuman in the Loopも
UIだけの話ではありません
Authorization Workflowとしてインフラに組み込む
ことが重要です
Kill Switchも用意する
さらにAIエージェントには止める仕組みも必要です
例えば
Agent Error Rate > 20%

Cost > 10,000円/hour

Loop Count > 20

Policy Violation > Threshold
になったら
Alert
↓
Agent Disable
とします
自動復旧だけでなく
自動停止
も重要になるということです
AIエージェント版Circuit Breaker
さらに
Slack API
GitHub API
Salesforce API
など外部Toolが障害になったとき
AIが
失敗
↓
Retry
↓
失敗
↓
Retry
↓
失敗
↓
Retry
を続けると危険です
そこで従来の分散システムと同じくCircuit Breakerが利用できます
Tool Failure
     ↓
Failure Count > Threshold
     ↓
Circuit OPEN
     ↓
Tool Call停止
     ↓
Fallback / Human
AI時代だからといって、従来のインフラ設計が不要になるわけではありません
むしろ従来の分散システム設計+AI特有の設計が必要になります
マルチエージェントになるとさらに難しくなる
例えば
Manager Agent
   │
   ├─ Research Agent
   │
   ├─ Coding Agent
   │
   ├─ Review Agent
   │
   └─ Security Agent
という構成になった場合
障害原因が
Managerなのか
Research Agentなのか
Coding Agentなのか
さらに
Agent間の引き継ぎなのか分からなくなります
2026年のAgent System Operationsに関する研究でも、
Agent内部の異常だけでなくAgent間の異常を分けて捉え、
Monitoring、Anomaly Detection、Root Cause Localization、Resolutionという運用プロセスが整理されています
マルチエージェントが増えるほど
Distributed TracingのAI版
が必要になるわけです
AgentOpsはインフラエンジニアと相性がいい
ここまで読んで
何か見覚えがあると思った方もいるかもしれません
AgentOpsで必要になる
Monitoring
Observability
Identity
Access Control
Secrets
Gateway
Queue
Retry
Circuit Breaker
Logging
Tracing
CI/CD
IaC
SLO
Incident Response
Cost Management
これらは
インフラエンジニアが昔からやってきたこと
です
もちろんLLMやEvaluationなどAI特有の知識は必要です
しかしAIエージェントが本番利用されればされるほど
「AIモデルを作れる人」だけではなく
AIを安全に動かし続けられる人
が必要になります
DevOpsの次にAgentOpsを覚える
Webサービスが普及したことで
DevOps
SRE
Observability
Cloud Native
Infrastructure as Code
といった技術が重要になりました
同じようにAIエージェントが普及すれば
Agent Runtime
Agent Identity
Agent Gateway
Agent Observability
Agent Evaluation
Agent Security
Agent Governance
といった領域が重要になります
実際にOpenTelemetryでもGenAI向けTelemetry標準化が進み、
AWSでもAgent Runtime、Memory、Gateway、Identity、Observability、EvaluationsなどをまとめたAgentCoreが提供されています
これは
AIアプリを作るフェーズからAIエージェントを運用するフェーズへ移りつつある
ことを表す流れの1つだと思います
AgentOpsで最終的に作りたいループ
最終的には
Build
 ↓
Test
 ↓
Evaluate
 ↓
Deploy
 ↓
Observe
 ↓
Detect
 ↓
Analyze
 ↓
Improve
 ↓
Evaluate
 ↓
Deploy
というループを作ります
さらにAgent自身を利用して
Agent障害
↓
Observability
↓
Agentによる原因分析
↓
改善案生成
↓
Evaluation
↓
Human Approval
↓
修正
までできるようになる可能性があります
ここまで行くと
AIエージェントをAIエージェントが運用する
という世界です
まとめ
AIエージェント時代には
AIを作る技術だけでは足りません
重要になるのが
AIをどう運用するか
です
AIエージェントは
考える
↓
判断する
↓
Toolを選ぶ
↓
実行する
↓
結果を見る
↓
もう一度判断する
という動きをします
だから従来の
CPU
Memory
Disk
HTTP Error
だけを監視していても正常性を判断できません
これからは
Infrastructure
+
LLM
+
Agent
+
Tool
+
Identity
+
Memory
+
Trace
+
Evaluation
+
Security
+
Cost
まで含めて運用する必要があります
その考え方が
AgentOps
です
AIエージェント時代のインフラ設計では
「サーバーが正常か」から「AIの行動が正常か」へ
監視対象そのものが広がっていきます
そしてこれはAIエンジニアだけの領域ではありません
Observability
IAM
Network
Security
CI/CD
Terraform
SRE
Cloud
これまでインフラエンジニアが積み上げてきた技術が、そのままAIエージェント時代の重要な土台になります
AIによってインフラエンジニアの仕事がなくなるというより
AIという新しいワークロードをどう安全に動かすか
という巨大な運用領域が新しく生まれている
そう考えると
AgentOpsはこれからインフラエンジニアが覚えておいて損のない分野だと思います
いいなと思ったら応援しよう!
 応援をぜひよろしくお願いします🔥
いただいたチップでより素晴らしい記事を発信していけるよう精進してまいります!
