【文章が悪くなったって本当?】Claude Fable 5.1 に記事を書かせて読み比べた答えと、料金・effort・Opus 自動転送の初日まとめ

こんにちは、れん学長です(2026年9月2日時点)。
今朝、Claude Fable 5.1 と Claude Mythos 5.1 が発表されました。
で、公式発表と初日のX投稿3件を画面収録しながら読み込んでみたところ、私が思わず「これはいいですね」と声に出したのは料金の話でした。
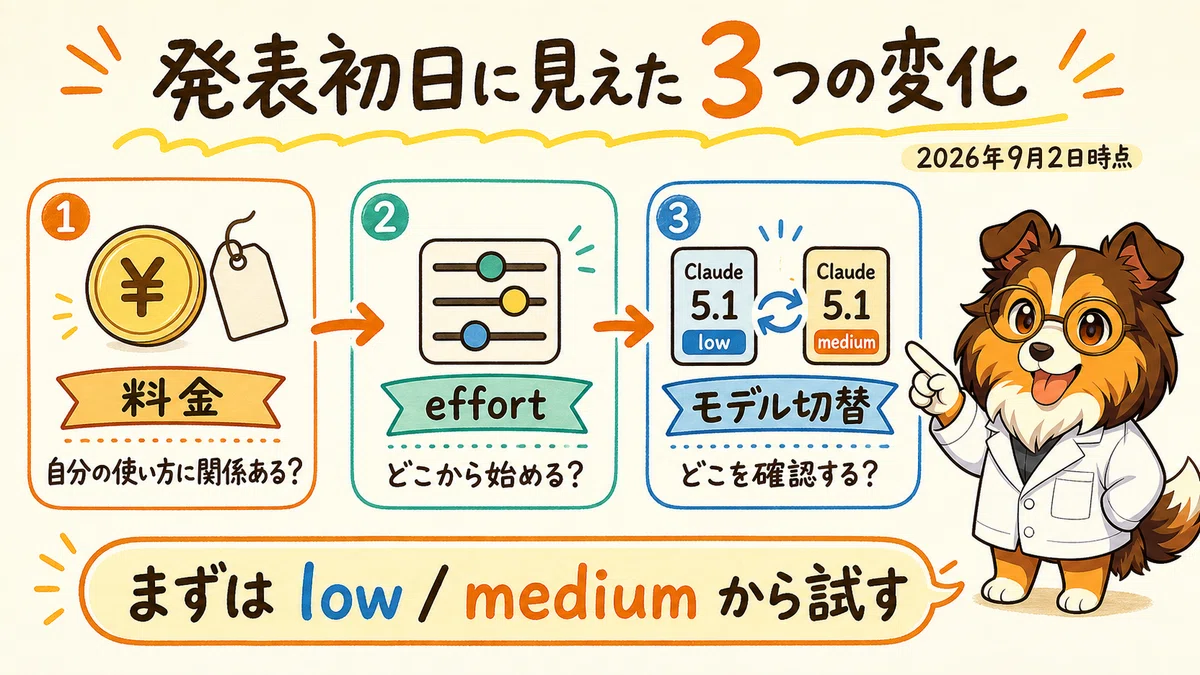
この記事を読み終わる頃には、次の3つが自分で判断できる状態になります。
料金の変化が、あなたの使い方に関係あるかが分かります。
effort という設定を、どこから始めればいいかが分かります。
別のモデルへ勝手に切り替わる仕様で、どう確かめればいいかが分かります。
後半では、Xで出ていた「文章の流れが悪くなった」という指摘が本当かどうか、この記事の素材を Fable 5.1 に何通りかで書かせて読み比べた、初日の感想も書きます。
2026年9月2日、何が出たのか
まず前提からいきます。
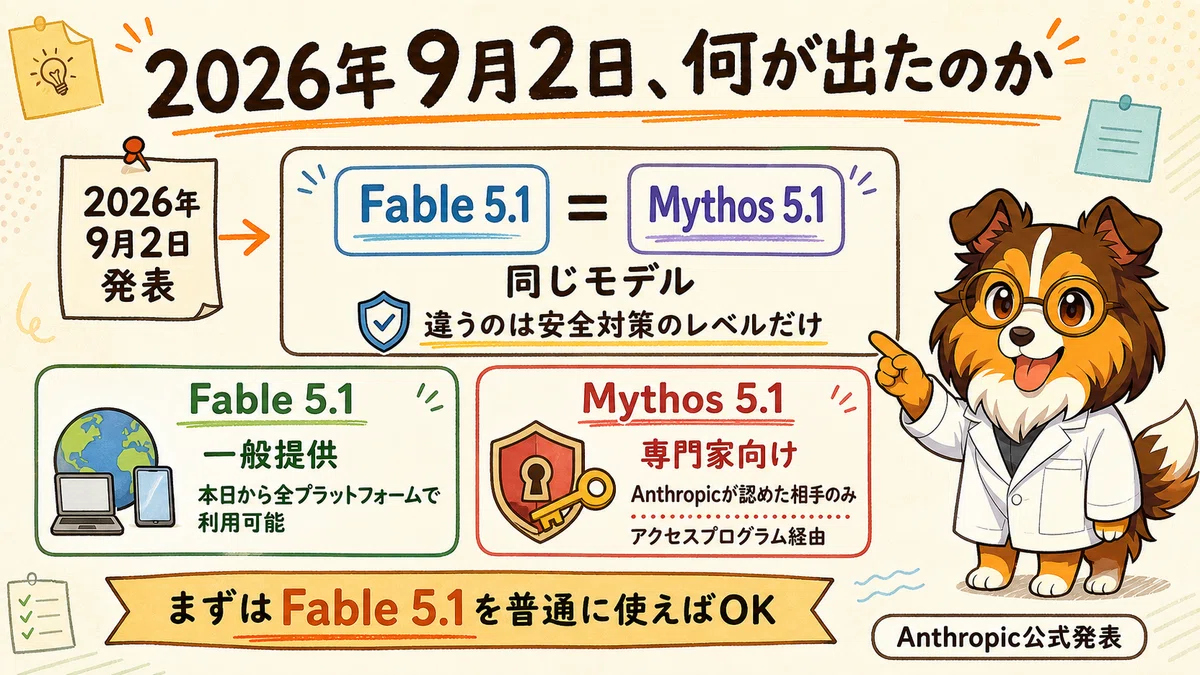
Fable 5.1 と Mythos 5.1 は同じモデルで、違うのは安全対策のレベルだけです。
Fable 5.1 は一般提供で、本日から全プラットフォームで使えます。
Mythos 5.1 は、サイバーセキュリティやライフサイエンスの専門家向けに、Anthropic が認めた相手だけが使えるアクセスプログラム経由のみです。
公式発表はこちらです。 https://www.anthropic.com/claude-fable-and-mythos-5-1
変化1:キャッシュ読みが75%引きで、典型的な使い方で約25%安く
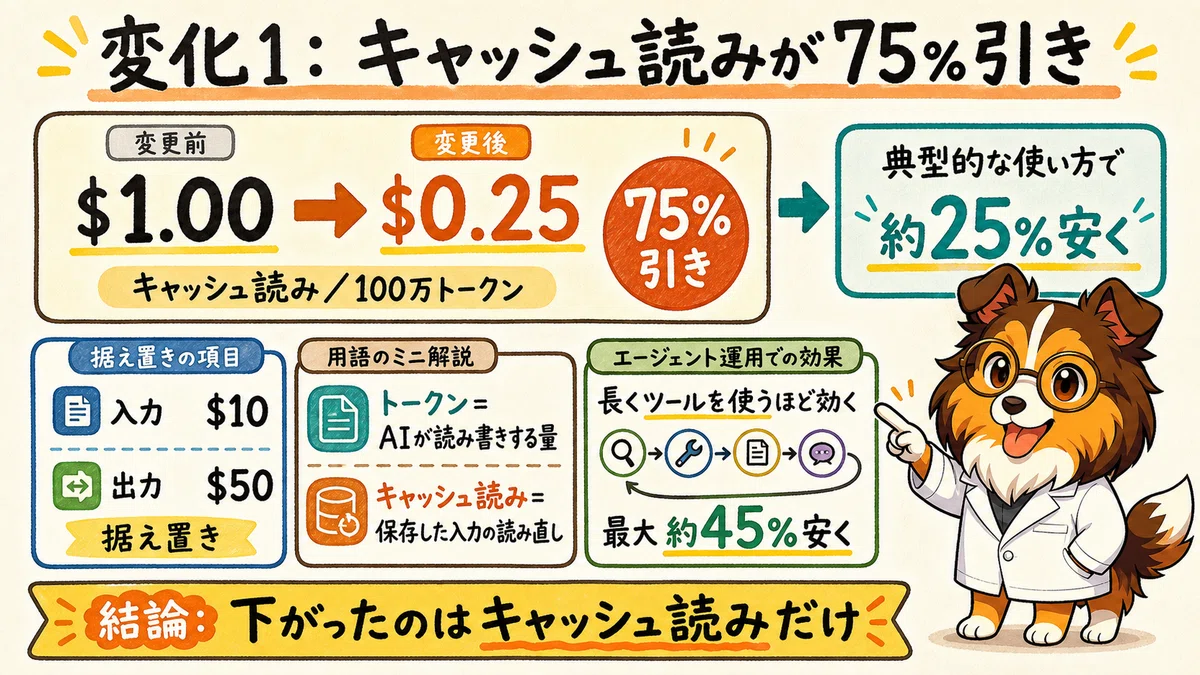
公式によると、トークン課金の場合、典型的な使い方で Fable 5 より推定25%安くなります。
用語を2つだけ押さえておきます。
トークン … AIが文章を読み書きするときの数え方の単位で、文字数のようなものです。プログラムから呼び出す API では、この量で課金されます。
キャッシュ読み … 一度処理して保存しておいた入力を、AIがもう一度読み直すときにかかる料金です。
値下げされたのは、このキャッシュ読みだけです。
キャッシュ読みは75%引きで、百万トークンあたり $0.25 になりました。
入力 $10、出力 $50 は据え置きです。
ツールを何度も使いながら長く動く、エージェント的な作業ほどキャッシュ読みの割合が大きいです。なので公式の実測では、最大約45%安くなるそうです。
じゃあ定額のサブスクで使っている人はどうなるのか。サブスクでもキャッシュ読み自体はされるので消費量は減るんじゃないかと私は推測していて、ここはこれから自分のアカウントで確かめます。
変化2:effortの低い設定でも、Fable 5の最上位設定と同等以上
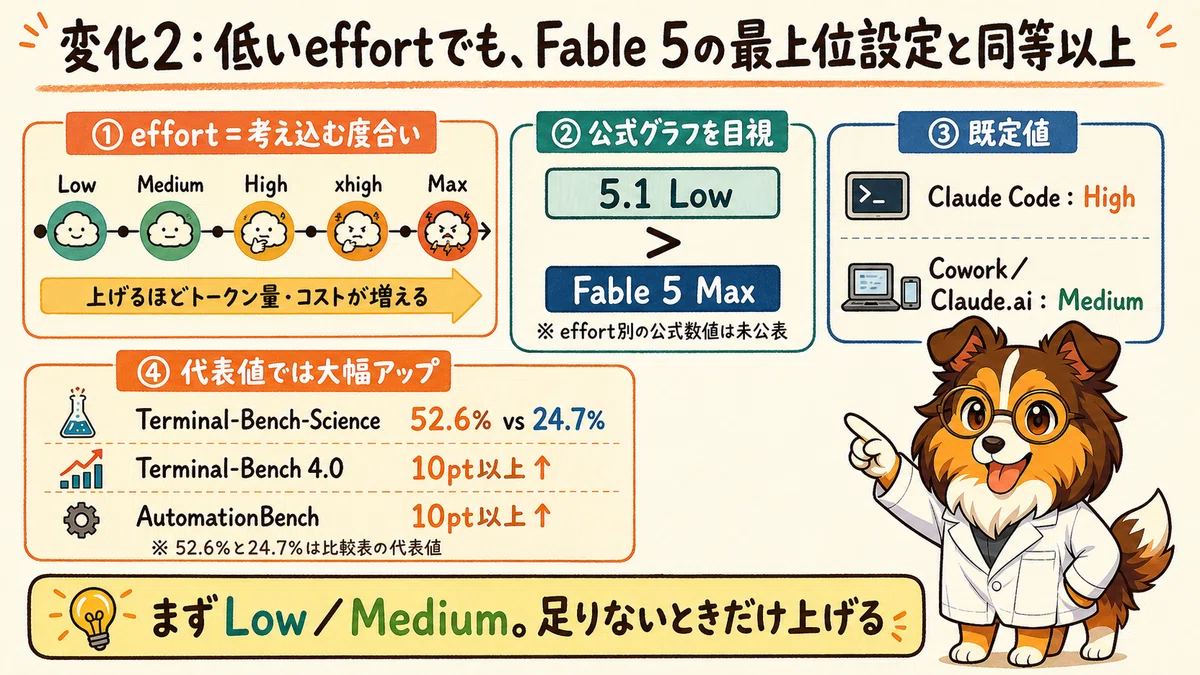
Claude には effort という設定があります。AIがどれだけ考え込むかの度合いで、Low、Medium、High、xhigh、Max の5段階です。
公式の説明はこうです。
Low か Medium にしても、Fable 5 と同等以上の結果をはるかに低いコストで出せます。
既定値は、Claude Code が High です。
業務向けの Claude Cowork と、ブラウザで使う Claude.ai は Medium です。
数字も見ておきます。
収録で公式のグラフを見たとき、科学研究の性能テストである Terminal-Bench-Science では、5.1 の Low が Fable 5 の Max を超えているように見えました。
effort 別の数値は公式に出ていません。比較表の代表値だと Fable 5.1 が 52.6%、Fable 5 が 24.7% で、2倍以上の差です。
エージェント的コーディングの Terminal-Bench 4.0 と、業務ワークフローの AutomationBench も、それぞれ10ポイント以上上がっています。
後で紹介する初日のX投稿の1つ、まさお@AI駆動開発さんの投稿によると、effort を上げるとAIに処理させる量、つまりトークン量とコストが大きく変わるそうです。Low で2.5万トークンのタスクが、xhigh だと20万だったとのことです。
なので「まず Low か Medium、足りないときだけ上げる」という運用が、公式の説明ともまさおさんの実感とも合っていて、私もそうだねと思いました。
変化3:安全対策の誤検知が減った。ただし別モデルへの自動転送に注意
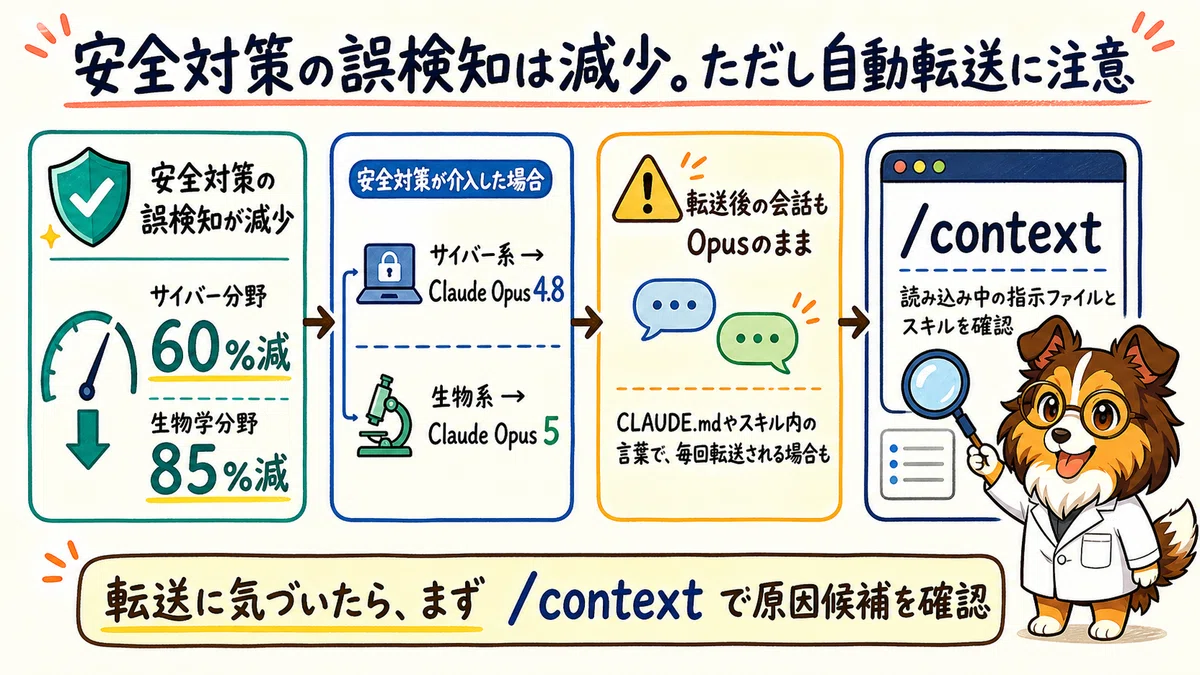
3つ目は安全対策です。無害な内容を危険と判定して止めてしまう誤検知が減りました。
サイバーセキュリティ分野では、誤検知が従来比で60%減っています。
生物学分野では、基礎生物学や医療の無害な質問で安全対策が発動する頻度が、Fable 5 発売時比で85%減っています。
で、ここで注意点があります。
安全対策が介入した場合、サイバー系のタスクは Claude Opus 4.8、生物系のタスクは Claude Opus 5 が処理します。これは公式の注記にあります。
まさおさんによると、転送された後の会話も Opus のままになるそうです。
Claude Code に毎回読み込ませる指示ファイルの CLAUDE.md や、AIに仕事のやり方を覚えさせるスキルに特定の言葉が入っていると、毎回転送されてしまう人もいるとのことです。
対策として同じ投稿で挙がっていたのが /context というコマンドです。いま Claude が読み込んでいる指示ファイルやスキルの一覧を表示するもので、引っかかりそうな言葉がどのファイルに入っているかを探す手がかりになります。
ただ、いま転送されているかどうかまでは、私が使っているデスクトップアプリでは /context を打っても分かりませんでした。モデル名が表示されないからです。
なので、転送されてそうだなと感じたら、AIに「いまどのモデルで動いていますか」と聞いて、Fable 5.1 と答えるかを確かめるほうが手軽だと思います。
初日のX投稿3件から読み取れたこと
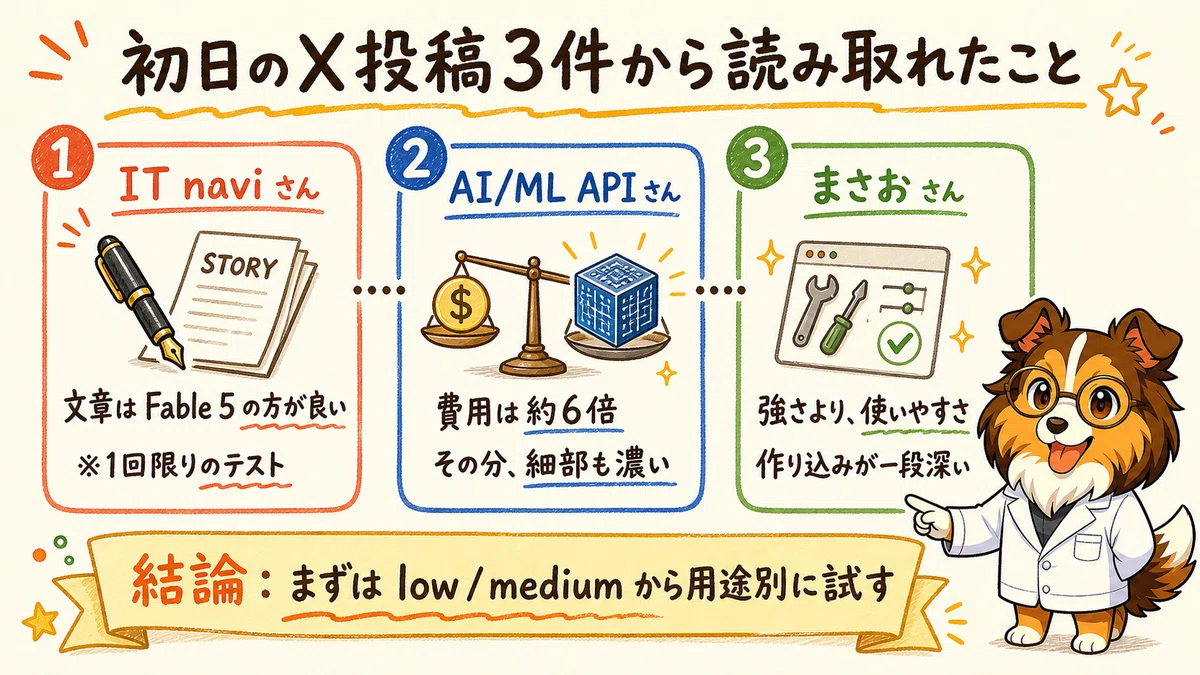
公式発表には出てこない、実際に使った人の感想を3件読みました。投稿ごとに分けて書き、最後に、この3件とは別にXで目についた注意点の投稿も添えます。
IT navi さん:短編小説では Fable 5 の方が良かった
Fable 5.1 に短編小説を書かせて、Fable 5 と比べた投稿です。 https://x.com/itnavi2022/status/2094864506908479990
結果は、ストーリー構成も文章表現も Fable 5 の方が優れていたそうです。
5.1 の文章に、ChatGPT のような短文の連続が多く、流れが悪くなっている点が気になったと書かれています。
ご本人も、1回限りのテストだと断っています。
文章を書かせる用途が多い私には、ここは気になる指摘でした。後半で自分でも確かめています。
AI/ML API さん:6倍の費用で、6倍の細部
同じプロンプトを一発で投げて、ブラウザで3D表示する three.js のシーンを5つ作らせ、OpenAI の GPT-5.6 Sol と比べています。 https://x.com/aimlapi/status/2094879208304685524
費用は Fable 5.1 が $5.69、GPT-5.6 Sol が $0.88 で、約6倍でした。Fable 5 より安くなったとはいえ、他社と比べるとまだ高いですね。
細部は Fable 5.1 の方が濃い一方、プールに水が入っていないなど、一発生成ならではのバグはどちらにもあったそうです。
収録で見比べた限り、Fable 5.1 が作ったものの方がより詳細で、光がチカチカしたりとリアリティがあるなと私は感じました。
まさお@AI駆動開発さん:「強くなった」より「使いやすくなった」
effort と転送の話で先に引用した方です。
リリースから数時間で使い込んだ結論を書いた投稿です。「めちゃくちゃ強くなった」ではなく「めちゃくちゃ使いやすくなった Fable」だと整理していました。 https://x.com/AI_masaou/status/2094918267190280505
ランディングページ、ウェブ用の画像形式である SVG、3Dゲームのデモの全部で、作り込みが一段深いそうです。
出力が冗長になりにくい、という点も挙がっていました。
前者は AI/ML API さんの3Dシーンを見比べた印象と重なって、確かにねと思いました。後者は、普段の作業で使ってから判断します。
初日から出ていた注意点:トークンの消費が速いという声
変化1で、定額プランでも消費は減るんじゃないかと書きました。で、正直、Xで目についたのは逆の声でした。
1件目は、まつにぃさんの投稿です。 https://x.com/yugen_matuni/status/2094917868299464962
effort が High で、ちょっとした1プロンプトで5%くらい消えたそうです。
2件目は、金のニワトリさんの投稿です。 https://x.com/gosrum/status/2094922170531234242
ベンチマーク実行コストが Fable 5 より1.5倍以上高かったらしいです。
元は cheaty さんの投稿で、性能テスト一式を effort Max で回すと $8,523、Fable 5 比56.24%増でした。
3件目は、朱雀さんの投稿です。 https://x.com/Suzacque/status/2094926820131148024
Max20倍プランで、0%からチャットだけを30回ほどやりとりした朝8時の画面です。
週の上限は Fable だけで15%、全モデルで8%でした。
私も同じ20倍のプランで、この記事を書いている時点で週の上限の12%に達していました。ただ記事4本を同時に書かせ、評価やレビューも別の Claude に何本も任せる重い使い方で、朱雀さんとは条件が違います。
公式の「約25%安く」はトークン課金の話です。トークンの量自体が増えていれば、定額プランでは消費の速さに出ている可能性があります。
ただ観測は、Xの3件と私の1件だけで、まだ推測です。ここも次の記事で確かめます。
実際に書かせて読み比べた、初日の感想
ここで、文章の話に戻ります。最初に紹介した IT navi さんは「短文の連続で流れが悪い」と書いていました。
一方で公式発表では、Canva が「Fable 5 との盲検比較で 5.1 の文章を好んだ」という逆向きのコメントを寄せています。
どちらが本当か、自分の目で確かめたくなりました。ここからは、この記事を作りながら私が試したことです。
やったことは次のとおりです。
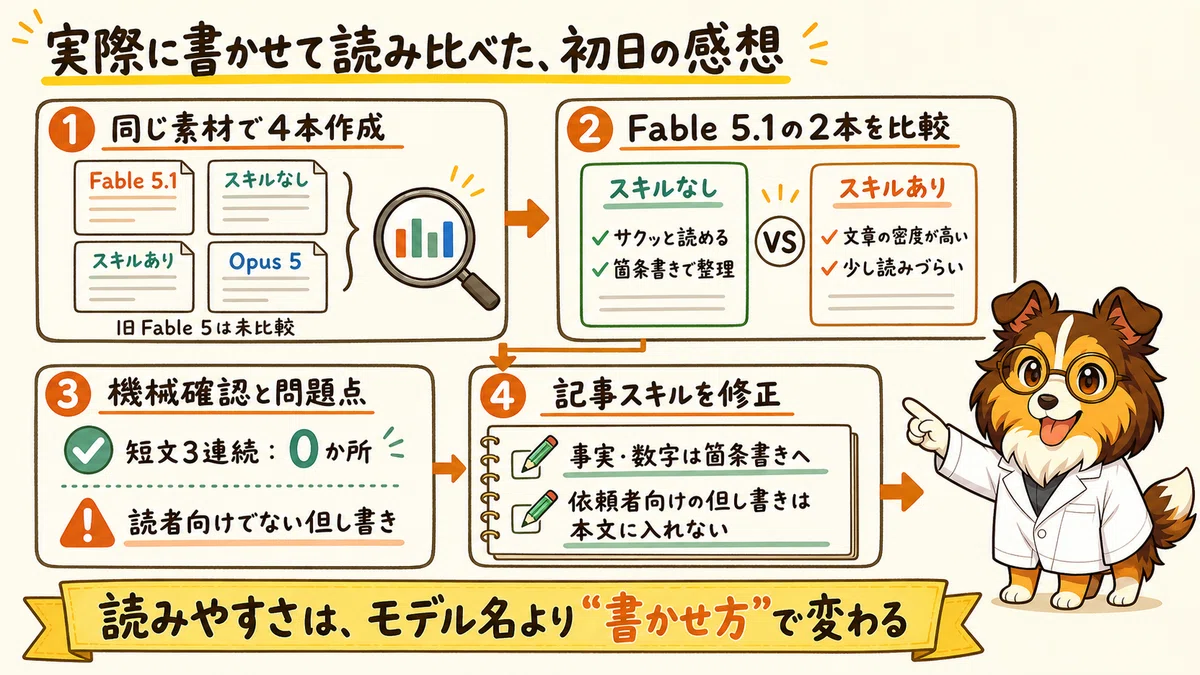
この記事の素材(公式発表とX投稿3件、私の収録メモ)を Fable 5.1 に渡して、note 記事を書かせました。
書かせ方は2通りです。素のプロンプトだけの「スキルなし」と、私の記事の書き方を覚えさせたスキルを使う「スキルあり」です。
比較用に Opus 5 でも同じ2通りを書かせ、合計4本にしました。1つ前の Fable 5 は、初日は呼び出す準備が整わず、今回は比較を見送りました。
4本のうち、まず Fable 5.1 の2本を並べて、自分で読み比べました。
読んだ感想は4つです。
スキルなし版が、サクッと読めて良かったです。私の話し方は入っていないのですが、箇条書き中心で情報が整理されていて、これはこれでありだなと思いました。
逆にスキルあり版は、文章の密度が高くて、ちょっと読みづらかったです。むしろ私の note 記事も、もっと箇条書きを増やして読みやすくしたほうがいいんじゃないか、と思ったくらいです。
短文の連続で流れが悪い、という感じは受けませんでした。機械的に数えても20字以下の短い文が3つ以上続く箇所は2本ともゼロでしたが、比べたのは記事2本だけなので、小説では違うのかもしれません。
いただけなかったのは、スキルなし版に「使用感の断定はしません」のような、私への回答みたいな但し書きが随所に入っていたことです。記事は読者に向けて書くものなので、ここは直す必要があります。
この感想は、そのまま私の記事作成スキルの修正に使います。
事実や数字の説明は、段落ではなく箇条書きを基本にします。
依頼者への回答のような但し書きは、本文に書かないようにします。
実は、この記事自体が「Fable 5.1 のスキルあり版」を土台に、上の2点を反映して直したものです。読みやすさがどう変わったかは、この記事そのものが見本になっています。
私がまだ試していないこと
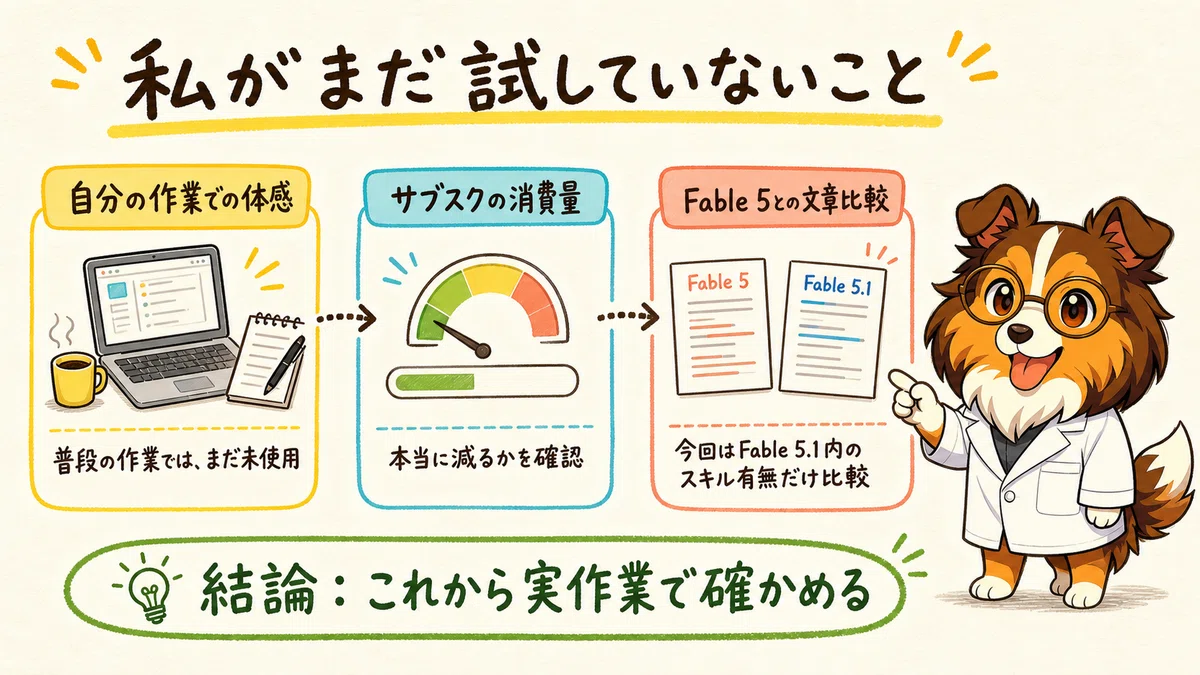
この記事の時点で、私が Fable 5.1 を使ったのは、この記事のための読み比べと、その評価やレビューまでです。普段の作業ではまだ使っていません。
次の4つは、これから確かめることです。
自分の作業で使ったときの体感です。
サブスクで消費量が本当に減るかどうかです。
比較用に書かせた Opus 5 の2本との読み比べです。初日は Fable 5.1 の2本を読むところまでで終わっています。
Fable 5 との文章の比較です。今回は Fable 5.1 の中でのスキル有無の比較にとどまっています。
動画で見たい方へ
記事だけだとイメージしにくい部分、ありますよね。
特に「effort ごとの精度とコストのグラフ」と「three.js で作った3Dシーンの見比べ」は、画面で見た方がわかりやすいです。
動画はこちらです。 https://youtu.be/x5qA5uGl7Ag
まとめ
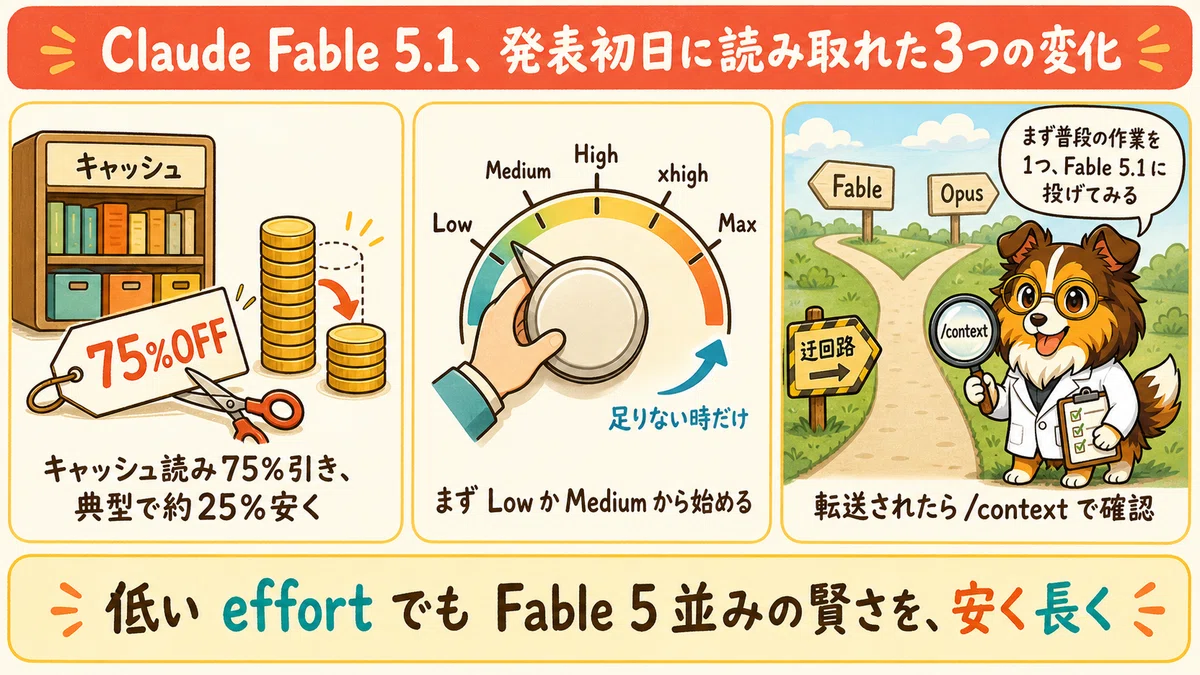
料金はキャッシュ読みが75%引きで、トークン課金なら典型的な使い方で約25%、エージェント的な作業で最大約45%安く(サブスクでの消費量は次回確認)
effort は Low か Medium から始めて、足りないときだけ上げる
安全対策の誤検知は減ったが、Opus へ転送されてそうなら、AIにモデル名を聞いて確かめる
要は、今回の 5.1 は「低い effort でも Fable 5 並みの賢さを、安く長く」という方向のアップデートで、心配していた文章の流れは、初日に記事を読み比べた限りでは問題を感じなかった、ということです。
まずは普段の作業を1つ、Fable 5.1 に投げてみてください。Claude.ai や Claude Cowork なら既定が Medium なのでそのままで試せますし、Claude Code は既定が High なので、一段下げて試すとこの記事の趣旨に合います。
この記事が参考になったら、いいねやフォローで応援してくれると嬉しいです。次回は Fable 5.1 を普段の作業で使った体感、サブスクでの消費量、Opus 5 や Fable 5 との読み比べを書く予定です。
Fable 5.1 をもう触った方は、文章の流れが気になったかどうか、コメントで教えてもらえると次の記事のネタになります。
それではまた、れん学長でした!
📢 れん学長のAIツール実験室
メンバーシップでは、この記事では書ききれなかった実験ログや、AI活用の試行錯誤をもう少し踏み込んで共有しています。
価格や参加条件、どんな内容が読めるかは、入口記事にまとめています。
気になっていた方は、まず内容をのぞいてみてもらえるとうれしいです。
👉 メンバーシップの入口記事をのぞいてみる https://note.com/renkon40/n/nab9c378d2148
📮 【無料】週1回のニュースレターやってます
実際に試したAIツールの「結局、誰が使うべきか」だけを、5分で読める形でメール配信しています。noteの更新を見逃したくない方もどうぞ。
https://renkon40.substack.com/?utm_source=note&utm_medium=article
#AI #Claude #ClaudeFable #Anthropic #ClaudeCode #AIツール #生成AI
いいなと思ったら応援しよう!
 よろしければ応援お願いします!いただいたチップは、新しいAIツールの検証費用に使わせていただきます🧪 これからも実験→発見を共有していきますね!
