
Palantir × Databricks: データ移動なき「双方向統合」の実装と価値

PalantirとDatabricksのパートナーシップは、単なるツール間の接続ではありません。それは、 「データ移動ゼロ(Zero Copy)」 でDatabricksの強力な計算リソースとPalantirの運用アプリケーション構築能力を融合させる、アーキテクチャの革新です。
主要ポイント:
データ移動の排除: 仮想テーブル(Virtual Tables)により、データをコピーせず相互に利用可能。
コンピュートの適材適所: Palantirのパイプライン処理をDatabricksの計算基盤で実行(Compute Pushdown)。
ガバナンスの一元化: Unity Catalogと連携し、権限管理を統合。
AIモデルの運用化: Databricksで学習したモデルをPalantirの運用アプリに即座に組み込み可能。
目次
Chapter 1: なぜ「最強のタッグ」なのか? パートナーシップの核心
Chapter 2: 仕組みの深掘り - マルチモーダルデータプレーンとは
Chapter 3: 実践デモ解説 - 連携の具体的手順と挙動
Chapter 4: AIとワークフローの統合 - モデルを現場へ
Chapter 5: ビジネス価値と今後のロードマップ
Chapter 1: なぜ「最強のタッグ」なのか? パートナーシップの核心
データ活用が進むエンタープライズ環境において、Palantir FoundryとDatabricksはしばしば併用されます。しかし、これまでは両者の間でデータを連携させるために、複雑なETLパイプラインを構築し、データを物理的にコピー・移動させる必要がありました。これは「データのサイロ化」「ガバナンスの分断」「リードタイムの増加」という大きな課題を生んでいました。
2025年3月に正式発表された両社の戦略的パートナーシップは、これらの課題を根本から解決するために設計されました。興味深いことに、この連携は発表前から顧客主導で進んでいました。多くの組織が独自にPalantirとDatabricksを統合しようとしていたのです。
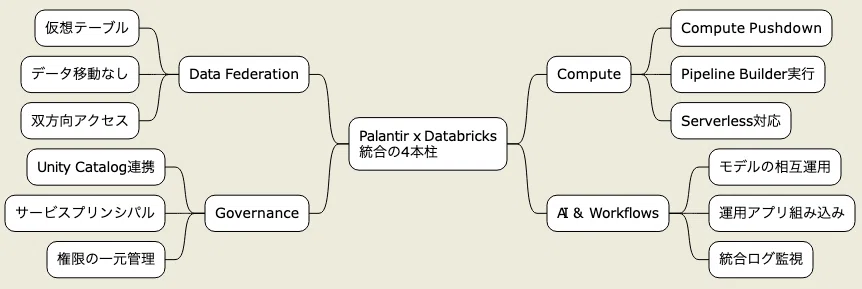
連携を支える4つの柱
このパートナーシップは、以下の4つの技術的柱によって構成されています。
1. Data Federation(データの仮想統合)
データを物理的に移動・コピーすることなく、相手方のプラットフォームにあるデータを直接参照・操作します。
2. Governance Integration(ガバナンスの統合)
DatabricksのUnity CatalogとPalantirの権限管理システムが連携。一方での権限設定が他方にも適用され、二重管理の手間を排除します。
3. Compute Pushdown(計算処理の委譲)
Palantirで定義したデータ変換処理(ロジック)を、Databricksの強力なコンピュートエンジン上で実行します。処理結果はそのままDatabricks上に保存することも可能です。
4. AI & Workflows(AIとワークフローの統合)
Databricksで開発した機械学習モデルをPalantirに登録し、現場のオペレーションアプリ(Ontology)の一部として即座に利用可能にします。
Chapter 2: 仕組みの深掘り - マルチモーダルデータプレーンとは
この連携の根底にあるのが、Palantirが提唱する 「マルチモーダルデータプレーン(Multimodal Data Plane)」 という概念です。これは、「Any Storage, Any Compute, Anywhere(あらゆるストレージ、あらゆるコンピュートを、どこでも)」を実現するアーキテクチャです。
物理的なアナロジーで理解する
従来のデータ連携が「図書館Aから本を借りて、コピー機で複写し、図書館Bの棚に並べる」作業だとすれば、今回の統合は 「図書館Bの利用者が、図書館Aの書庫に直接入る許可証を持ち、その場で本を読む(あるいは書き込む)」 ようなものです。本(データ)自体は移動しません。
技術的な仕組み
具体的には、Palantir FoundryがDatabricksの Unity Catalog と連携し、IcebergやDelta Lake形式のデータに対して直接クエリを発行します。
読み込み: Foundry上に「Virtual Table(仮想テーブル)」を作成。実体はDatabricks(S3/ADLS等)にあり、Foundryからはポインタとして機能します。
書き込み: Foundryで作成したデータや処理結果を、直接Databricks管理下のストレージに書き込みます。
これにより、Databricksを「オープンデータレイクハウス」として活用しつつ、Palantirを「オペレーショナル・インテリジェンス層」として活用する、理想的な役割分担が可能になります。

Chapter 3: 実践デモ解説 - 連携の具体的手順と挙動
では、実際にどのように設定し、動作するのか。動画内のデモをベースに、実務的な手順を解説します。ここでのポイントは、GUIベースのローコードツール(Pipeline Builder)を使いながら、裏側ではDatabricksのコンピュートが動くという点です。
Step 1: 接続設定(Service Principalの活用)
セキュリティは最優先事項です。個人の認証情報ではなく、 Service Principal(サービスプリンシパル) を使用します。これは「システム用のロボットアカウント」のようなものです。
Databricks側でService Principalを作成し、必要なデータ資産へのアクセス権を付与。
Palantir側の「Data Connection」設定で、Databricksコネクタを選択。
Service Principalの情報を登録。
これにより、Workload Identity Federation(ワークロードIDフェデレーション)が機能し、セキュアな認証が確立されます。
Step 2: Virtual Tablesによるデータ参照
DatabricksにあるデータをFoundryに取り込みます(Ingest)が、物理コピーはしません。
Foundryで「Create Virtual Table」を選択。
Databricksのカタログ、スキーマ、テーブルをブラウズ(Unity Catalog経由で一覧が見えます)。
対象テーブル(例: `dbx_customer_clone`)を選択して作成。
結果: 数秒でFoundry上にテーブルが表示されます。中身をプレビューできますが、データの実体はDatabricksにあります。
Step 3: Pipeline Builderでのコンピュートプッシュダウン
ここが最大のハイライトです。FoundryのGUIツール「Pipeline Builder」でデータ変換ロジックを作成し、その計算をDatabricksに「外注」します。
パイプライン作成: Pipeline Builderを開き、先ほどのVirtual Tableを入力として配置。
ロジック定義: フィルタリング(例: `State == 'CA'`)や結合などの処理をGUIで定義。
コンピュート設定: 設定画面で「Batch Compute」の選択肢から 「External (Databricks)」 を選択。
出力設定: 処理結果の書き込み先として、Databricks内の特定のカタログ・スキーマを指定(例: `dbx_demo_output`)。
デプロイ & 実行: 「Deploy」ボタンをクリック。
裏側の挙動:
Foundryは変換ロジックをコンパイルし、Databricksに送信します。
Databricks側でジョブが起動し、Databricksのクラスター(Serverless含む)を使って計算が実行されます。
結果は直接Databricksのストレージ(Delta Lake等)に書き込まれます。
Foundryの画面上では、Databricks側の実行ログや進捗バーがリアルタイムで表示されます。
これにより、Palantirの使いやすいUIで開発しつつ、計算リソースは既存のDatabricks環境をフル活用するという「いいとこ取り」が実現します。
Chapter 4: AIとワークフローの統合 - モデルを現場へ
データだけでなく、AIモデルの連携もシームレスです。データサイエンティストと現場のオペレーターの間の壁を取り払います。
モデルの相互運用
Databricks -> Foundry: Databricks(MLflow)で学習・管理されているモデルを、Foundryに登録できます。これにより、Foundry上のアプリケーション(Ontology)から、そのモデルを関数として呼び出せるようになります。
活用シーン: 例えば、Databricksで構築した「顧客離反予測モデル」を、Palantirのコールセンター用アプリに組み込み、オペレーターが顧客対応中にリアルタイムで離反リスクを確認する、といった運用が即座に可能になります。
統合されたモニタリング
パイプラインやモデルの実行ログは統合されています。Foundryのビルドレポート画面から、Databricks側で起きたエラーの詳細や、処理にかかった時間、消費したリソースなどを確認できます。障害発生時の切り分けが非常に容易になります。
Chapter 5: ビジネス価値と今後のロードマップ
この技術統合がもたらすビジネス上の価値は明確です。
具体的なメリット
コスト削減: データの二重持ち(ストレージコスト)と、データ移動にかかる計算コスト(ETLコスト)を削減。
スピード向上: データコピーの待ち時間がなくなり、分析やアプリ開発への着手が即時化。
ガバナンス強化: 権限管理がUnity Catalogに一元化され、セキュリティリスクを低減。
導入実績
このパートナーシップは既に多くの企業で成果を上げています。
100社以上の顧客: 正式発表前から両技術の統合に取り組んでいた企業を含め、公民両セクターで活用が進んでいます。
業界横断的な採用: 国防総省、財務省、保健福祉省といった政府機関に加え、bp、ユナイテッド航空、R1といった民間企業でも導入されています。
ロードマップ(Future Scope)
動画内で示されたロードマップには、さらなる統合強化が含まれています。
Managed Table Direct-to-Storage: さらなるパフォーマンス向上のための直接アクセス強化。
Delta Sharing: オープンなデータ共有プロトコルへの完全対応。
Compute Pushdown in Contour: Foundryの分析ツール「Contour」からもDatabricksコンピュートを利用可能に(検討中)。
🎯 全体まとめ
PalantirとDatabricksのパートナーシップは、企業のデータ基盤における「分断」を解消する強力なソリューションです。
重要なポイント:
Zero Copy: 仮想テーブルにより、データ移動なしで相互アクセスを実現。
Compute Pushdown: Palantirで定義したロジックをDatabricksの計算力で実行。
Unified Governance: Unity Catalogと連携し、セキュアで一元的な管理を提供。
Operational AI: DatabricksのモデルをPalantirの現場アプリで即座に活用。
このアーキテクチャは、「工場のライン(Palantir)」が、隣接する「巨大な発電所兼倉庫(Databricks)」からベルトコンベアなしで直接エネルギーと部品を取り出し、完成品をまた倉庫に戻すような、極めて効率的な生産システムと考えることができます。このアーキテクチャを理解し提案できることは、エンタープライズアーキテクトとしての大きな武器になります。
