ChatGPT Images 2.5で画像制作はどう変わったのか アニメの着せ替え検証から見えたこと

2026年9月8日、OpenAIはChatGPT Images 2.5を発表しました。
画像生成AIで人物の服だけを変えたつもりが、顔まで別人になってしまった経験がある方には、気になる更新だと思います。
今回の検証で確かめられたのは、人物の顔や背景を保ちながら衣装だけを変える編集が、実用に近いところまで安定してきたことです。
一方で、元画像をピクセル単位で固定する編集ではありません。
髪の線や服のしわなど、小さな描き直しは残ります。
「被写体がブレにくくなった」「着せ替えのような細かい作業ができるようになった」という見方は、今回の観察と重なる部分がありました。
「AIだと気づきにくい自然な画像へ一歩近づいたのではないか」という点は、静止画の連続編集という限られた範囲でのみ支持できる材料です。
実写写真や動画フレームでの検証は行っていません。
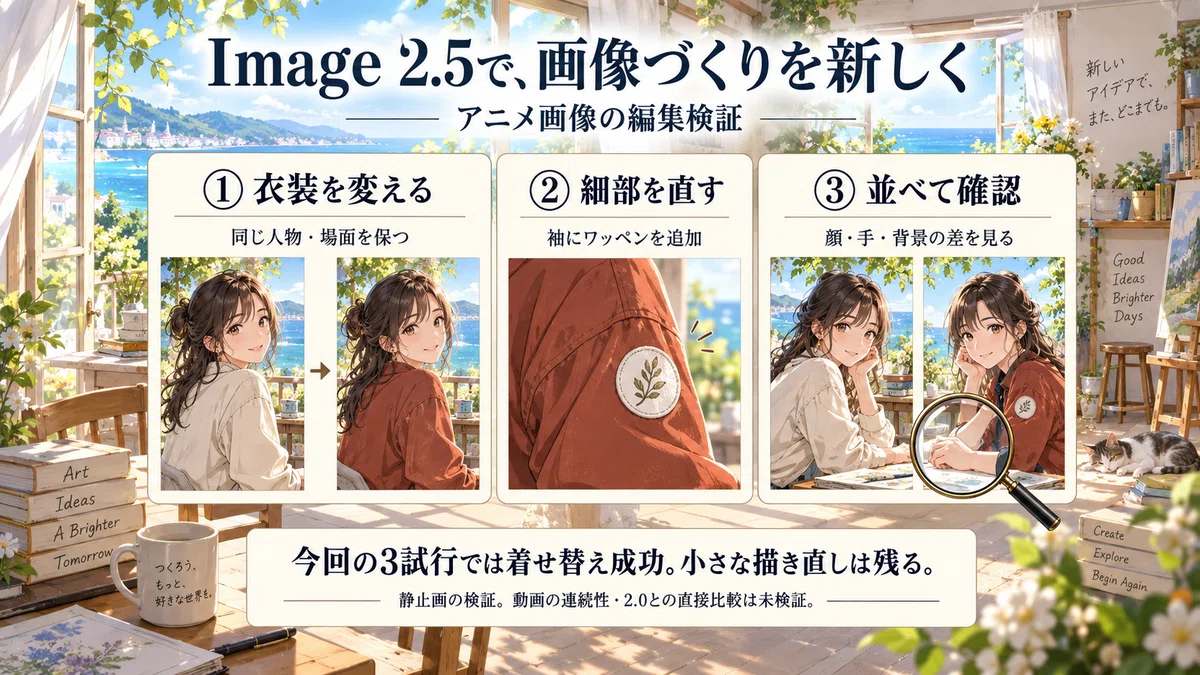
この記事でわかること
この記事は、アニメ画像の着せ替え検証を通じてImages 2.5の編集精度を確かめた記録です。
衣装だけを変える編集を3回試し、顔・髪・背景がどこまで保たれたかを確認します
着せ替え後にワッペンを追加する2回目の編集で、前の変更が保たれるかを見ます
公式発表と第三者評価から、2.5の位置づけと数値の扱い方の注意点を整理します
制作工程で速さより重要になる「手戻りの少なさ」という視点を示します
被写体を崩しにくくする指示文の書き方を提示します
Images 2.5で強化された機能
OpenAIが挙げる主な変更点は、自然な光と質感、参照対象の保持、部分修正、複数回編集の一貫性、そして生成待ち時間の短縮です。
待ち時間はImages 2.0比で最大50%短縮したとされていますが、これは提供者側の主張であり、あらゆる条件で半分になるという意味ではありません。
操作面では、ラフを描いて意図を伝えるSketch、画像上に直接コメントする機能、用途別テンプレート、プロンプトの共有が加わりました。
文章だけで指示を伝える以外の経路が増えたと理解できます。
強化の中心は「一度できれいに描く力」よりも、「気に入った画像を壊さず直す力」に置かれています。
API側では、速度を重視するGPT-Image-2.5 Flareと、精密な編集を優先するGPT-Image-2.5 Sunburstが用意され、ChatGPT・ChatGPT Work・Codexの各プランへ展開されています。
従来世代から続く機能との違い
会話を通して画像を作り直すという発想自体は、2.5で初めて生まれたものではありません。
2025年3月の4o Image Generationの時点で、自然言語による生成・編集は存在していました。
2025年12月のChatGPT Images 1.5世代でも、指示への追従や細部を保った編集、速度の改善はすでにテーマでした。
2026年4月のImages 2.0では、考えてから画像を作るimages with thinkingが導入されています。
つまり2.5は、部分編集や複数回のやり取りを新しく発明したわけではなく、変える部分と残す部分の両立を、これまでの世代よりどれだけ安定させられたかが問われる更新だといえます。
今回の検証も、この一点に絞って行いました。
アニメ映像の着せ替えで検証した条件
検証用に用意したのは、夕方の駅で成人女性が一人立っている、オリジナルのアニメ映像風の1フレームです。
既存作品や実在人物は参照せず、黒いボブ、琥珀色の目、左こめかみの跳ねた髪、バッグを持つ右手を人物の目印にしました。
最初の指示では、薄いベージュのフード付きジャケットだけを、赤茶色の短丈ボンバージャケットへ変更するよう伝えました。
顔、髪、手、バッグ、パンツ、構図、駅の背景、夕方の光は変えないよう明記しています。
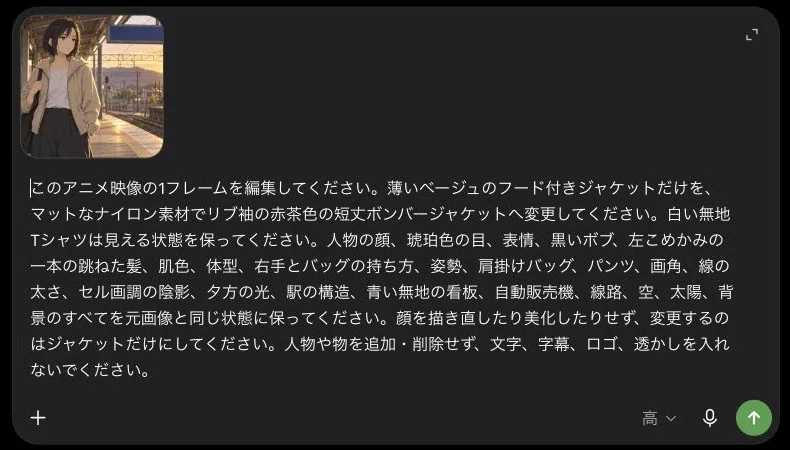
画像:オリジナルのアニメ映像を添付し、変更する衣装と固定する要素を分けて入力した画面です。
生成結果にはばらつきが出るため、同じ元画像・同じ指示で3回試しました。
評価したのは、衣装変更の成否、顔と髪、手とバッグ、構図と背景、アニメ特有の線と陰影という5つの観点です。
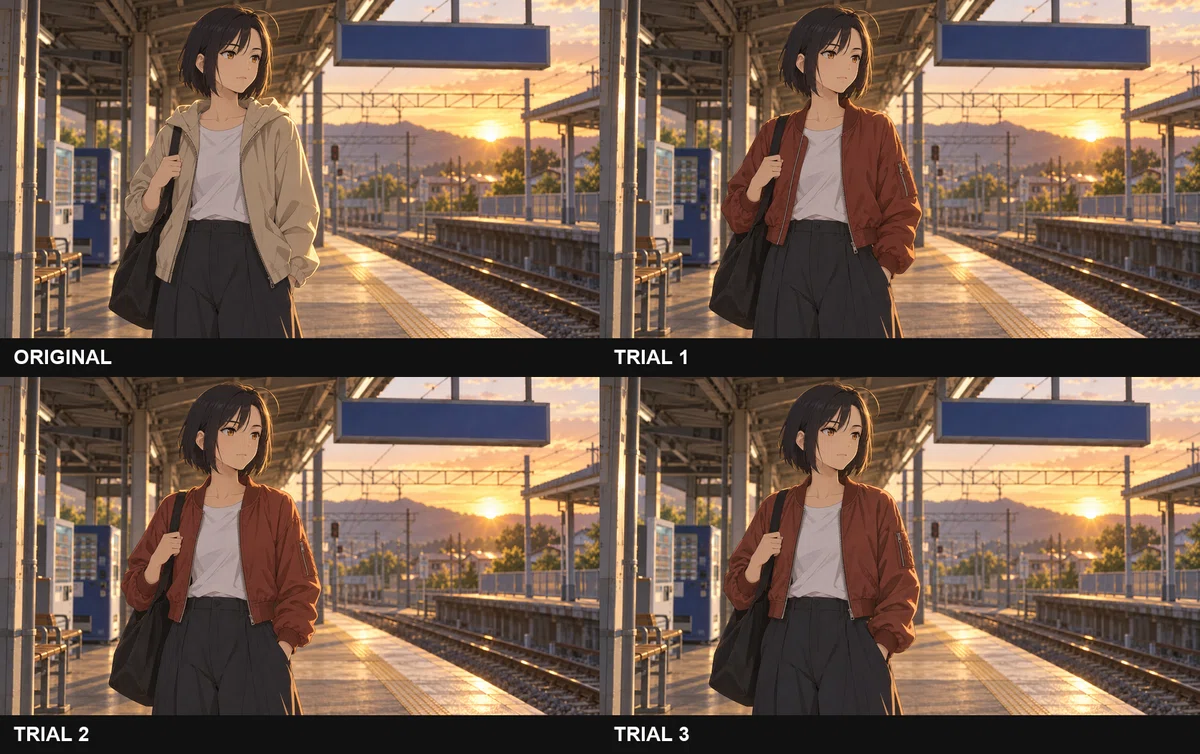
画像:左上が元画像で、残り3枚は同じ元画像へ同じ着せ替え指示を与えた独立試行の結果です。
なお、今回はImages 2.0で同じ課題を実行して直接比較してはいません。
モデル間の変更点は公式発表の記述で確認し、実操作ではImages 2.5の編集結果とばらつきのみを見ています。
3回の独立試行で衣装だけを変えられるか
3回すべてで、ベージュのパーカーは赤茶色のボンバージャケットへ変わりました。
白いTシャツは残り、人物や文字などの余計な要素も追加されていません。
顔の向き、琥珀色の目、黒いボブ、右手でバッグを持つ姿勢は、3枚を並べても同じ人物として見分けられる状態でした。
駅の看板、自動販売機、線路、夕日といった背景要素も大きく崩れていません。
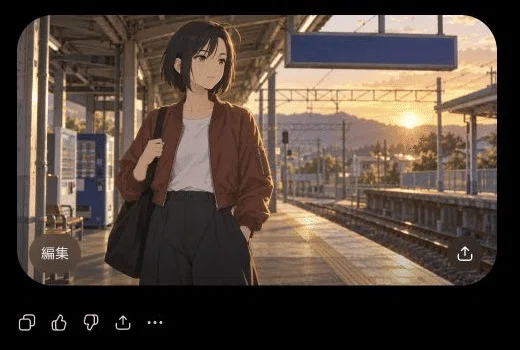
画像:赤茶色のボンバージャケットへ着せ替えた結果です。人物、バッグ、駅の背景が引き継がれています。
ただし、3枚がまったく同一というわけではありません。
ジャケットのしわやファスナーの位置、髪の輪郭線には小さな違いがあり、人物の大きさや位置もわずかに動いていました。
今回の条件では、同じ人物・同じ場面を保った着せ替えは3回とも成功しましたが、衣装以外を一切描き直さない状態には達していません。
この差は、小さくても納品前の確認対象になります。
続く編集でも前の変更は保たれるか
次に、着せ替え後の画像に対して「画面右側の袖に、白い円形ワッペンを1つだけ追加する」と指示しました。
最初の衣装変更を引き継いだまま、さらに狭い範囲を編集できるかを確かめるためです。
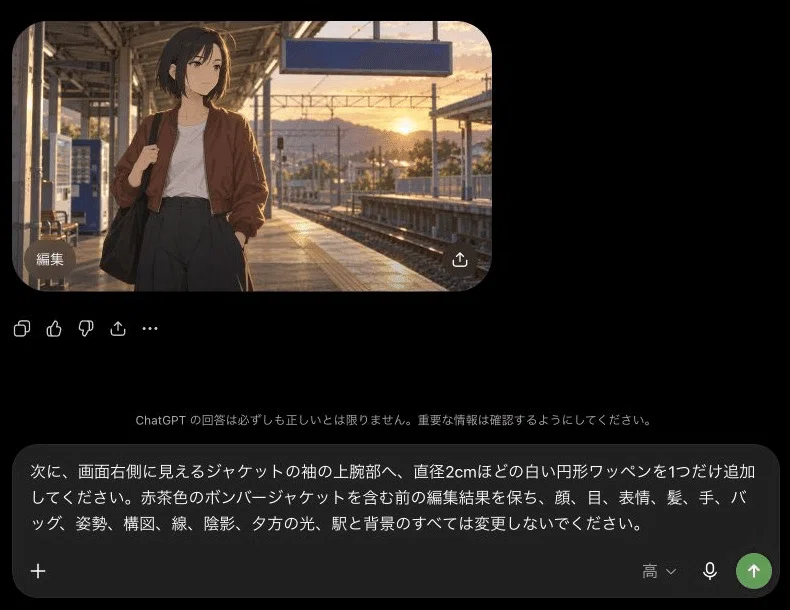
画像:最初の編集結果を残したまま、袖のワッペンだけを追加するよう指示した画面です。
結果では、赤茶色のジャケットが保たれたまま、指定した袖に白い円形ワッペンが追加されました。
顔、手、バッグ、駅の背景も、記事制作に使える程度のつながりを保っています。
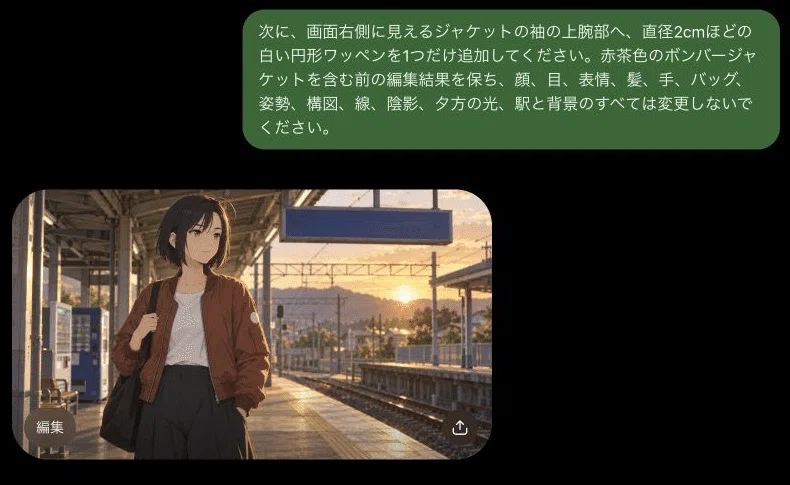
画像:2回目の編集結果です。前の着せ替えを維持しながら、袖に小さな要素が追加されています。
一度採用した画像を土台にして、次の修正を積み重ねられる点が今回はっきり確認できた強みです。
キャラクターの衣装案、広告の色違い、商品写真の一部分修正など、全体を作り直したくない作業と相性がよいと考えられます。
第三者の画像編集評価をどう読むか
今回の3回の試行だけでは、モデル全体の性能を判断できません。
そこで、公開されている画像編集の評価も参考として確認しました。
2026年9月13日に取得したArenaのSingle Image Editでは、Sunburstが1520±9、Flareが1491±9、GPT Image 2のmediumが1461±3という表示でした。
ただしこの数値はPreliminary(暫定)扱いであり、2.5側の投票数は旧モデルより少なく、ページの表示日と追加履歴にも食い違いが見られました。
確定した現時点の順位としては扱えません。
Artificial Analysisの画像編集評価でも、Sunburst・FlareはGPT Image 2のhighを上回る値でしたが、評価方法もスコアの尺度も異なります。
二つの評価を並べて「何%向上した」と言うことはできません。
芸術性を測るカテゴリでは、2.5側の標本数が少なく誤差幅も大きいため、明確な独走とは言えない結果でした。
日本語の長文や固有名詞の正確さを専門に測った評価も、今回確認した範囲では見つかっていません。
外部評価からも編集の強さはうかがえますが、この記事が伝えたいのは順位そのものではなく、変更したい部分と残したい部分を分けて指示しやすくなったという実感です。
制作工程への影響
以前の画像編集は、「服を変えて」と頼んだだけで顔や背景まで描き直され、良い一枚ができてもその先の修正に進めないことがありました。
生成のたびに人物が変わってしまうと、採用までの手戻りが増えます。
今回の検証のように、変更点と保持点を分けて伝えられると、同じキャラクターを別の衣装で使う、完成した構図の一部だけを直す、修正を重ねても前の結果を失わないといった工程が現実的になります。
これは一枚の完成度の勝負ではなく、シリーズや複数ターンでの制作工程の話です。
公式には生成待ち時間を最大50%短縮したとされていますが、これは生成一回あたりの速度についての主張です。
制作全体でかかる時間は、企画・生成・確認・仕上げの合計で決まるため、生成が速くても人物が崩れて作り直しが続けば、採用までの時間は短くなりません。
性能を比べる際は、生成一回の速さよりも、採用できる一枚にたどり着くまでの手戻りの少なさで見る方が、実際の制作に近い判断になります。
被写体を崩しにくくする指示の書き方
今回使った指示は、変更点を一つに絞り、残したい要素を具体的に書くという形にしています。
短くまとめると、次のような形に置き換えられます。
この画像の[変更したい部分]だけを、[変更後の状態]へ変えてください。

[顔、髪、表情、手、姿勢、構図、照明、背景など残したい要素]は、
元画像と同じ状態を保ってください。

変更する部分以外を描き直したり、物や人物を追加・削除したりしないでください。
完成後は、次の順で見比べることを勧めます。
顔の輪郭、目、髪の特徴が残っているか
手や持ち物の形と位置が変わっていないか
背景の建物、家具、光の向きが動いていないか
指定した部分だけが変わっているか
追加した要素が線、影、素材になじんでいるか
同じ人物に見えるというだけで合格にせず、変更していない場所の小さな差まで確認することを終了基準にしています。
今回の検証でわかったことと、わからなかったこと
ChatGPT Images 2.5は、指定した場所だけを編集し、複数回の変更を積み重ねやすくなった更新です。
今回のアニメ画像でも、着せ替えとワッペン追加を通じて人物と場面を保てました。
完全な固定編集ではないため、公開前には顔、手、背景、文字を人の目で見比べる工程は残ります。
それでも、良い画像ができるまで何度も引き直す使い方から、気に入った一枚を残して必要な場所だけを直す使い方へ、少なくとも今回の条件では近づいたと感じています。
実写写真でAIらしさがどこまで消えるか、動画の前後フレームで人物が安定するか、日本語の長文表記が正確に保たれるかは、今回の検証には含まれていません。
これらは別の検証課題として残しておきます。
まずは手元の画像で、一度に一か所だけ変えてみてください。
変更点と固定点を分けて指示し、元画像と並べて確認することが、Images 2.5の違いをいちばん実感しやすい方法だと思います。
