Gemini robotics er2を使ってみた(失敗例)

昨今話題になっているPhysical AIを体験して、スキルを身につけようということで、現在PARC2026のコンペティションに参加しました。
(Track1で落選しました。。。)
また、最近Google DeepMindからGemini Robotics 2が発表されました。
今回は、コンペティションで扱われていたロボット操作タスクを参考に、Gemini Robotics ER 2を利用できないか試してみました。
Gemini Robotics 2とは
Gemini Robotics 2は、画像や言語による指示を理解し、ロボットの動作へつなげるためのモデル群です。
現在、主に次の3つのモデルが発表されています。
Gemini Robotics 2
画像と言語からロボットのmotor actionを生成するVLAモデルGemini Robotics ER 2
周囲の状況を理解し、空間的な推論や複数工程の計画、ロボット機能の呼び出しを行うモデルGemini Robotics On-Device 2
ロボット上で低遅延に動作することを目的とした、軽量なオンデバイスVLAモデル
このうち、一般の開発者がGemini APIを通じて利用できるのは、現在のところGemini Robotics ER 2です。
Gemini Robotics 2とGemini Robotics On-Device 2は、現時点では一部のTrusted Tester向けに提供されており、一般公開はされていません。Gemini Robotics On-Device 2についてはwaitlistへの登録が可能です。
そのため、今回の検証では、一般に利用可能なGemini Robotics ER 2を使用しました。
ただし、Gemini Robotics ER 2は、ロボットの移動量や回転角度などを直接出力するVLAモデルではありません。
Gemini Robotics ER 2は、画像や動画から周囲の状況を理解し、空間的な推論、複数工程の計画、ロボット機能の選択などを行う、より上位のEmbodied Reasoningモデルです。
そのため今回の検証では、Gemini Robotics ER 2にロボットのActionを直接生成させるのではなく、
画像から対象物と配置先を認識する
タスクを複数の工程へ分解する
ロボットが次に行う動作を決める
実行途中の画像から残りの工程を修正する
といった役割を担当させました。
実際のロボットActionへの変換とシミュレーターの操作は、別途作成したプログラムで行っています。
参考リンクには、On-Device 2も追加できます。
参考
今回試したこと
シミュレーターにはMuJoCoとLIBEROを使用しました。
実行したのは、次のようなタスクです。
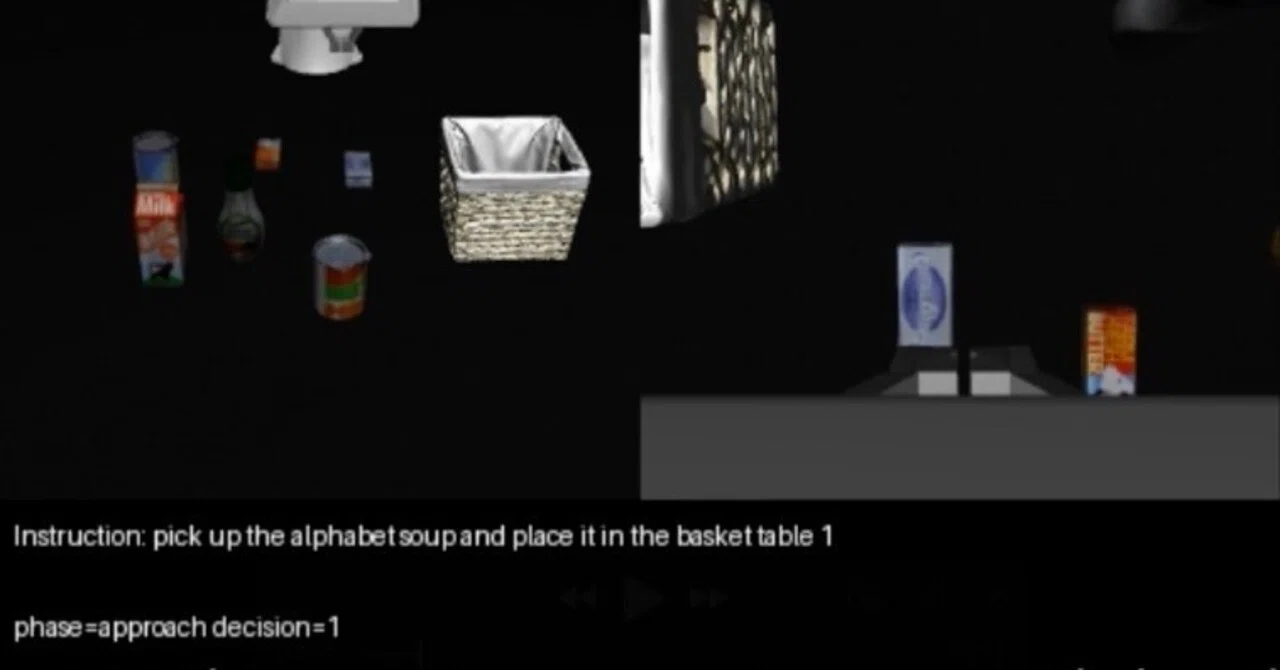
pick up the alphabet soup and place it in the basket table 1
ロボットにalphabet soupの缶を掴ませ、basketへ運ばせるシンプルなpick-and-placeタスクです。
Gemini Robotics ER 2には、ロボット正面のカメラ画像とwrist cameraの画像を渡しました。
そのうえで、次のような一連の動作を生成させました。
対象物へ近づく
gripperを下げる
対象物を掴む
対象物を持ち上げる
basketまで運ぶ
gripperを開いて対象物を置く
生成された工程自体は、pick-and-placeとして自然なものでした。
また、「最後にgripperを開く」とプロンプトへ明示しなくても、Geminiが配置先で対象物を解放する工程を生成していました。
実行結果
残念ながら、今回のタスクには失敗しました。
Gemini Robotics ER 2は対象物へ移動しようとしていましたが、実際にはalphabet soupの缶とは少し異なる位置へgripperを移動させました。
その状態でgripperを閉じたため、対象物を掴めていません。
しかし、その後も対象物を掴めたものとして、
持ち上げる
basketへ移動する
gripperを開く
という工程を続けました。
結果として、空のgripperをbasketまで運んで終了しました。
実際の実行動画は、以下から確認できます。
成功時の動画は以下です。(教師データより)
何がうまくいかなかった
今回の結果を見る限り、タスク全体の工程を考える部分は比較的うまくできていました。
一方で、画像上で認識した対象物の位置を、実際のロボットの正確な移動方向や移動量へ変換する部分には課題がありました。
比較のため、シミュレーター上の正しい対象物座標を使って同じ動作を実行したところ、対象物を掴んでbasketまで運ぶことには成功しています。
そのため、ロボットのAction実行やgripper制御ではなく、画像から定量的な経路を生成する部分が今回の主な失敗原因だと考えています。
Gemini Robotics ER 2の使いどころ
今回の実験では、Gemini Robotics ER 2だけでロボットの細かな経路まで決めるのは難しい結果となりました。
ただし、生成された動作の流れ自体は妥当でした。
そのため、Gemini Robotics ER 2は、
タスク全体の理解
対象物や配置先の認識
複数工程への分解
工程の進捗確認
失敗時の再計画
といった上位の判断に使う方が適していそうです。
細かなロボット操作については、Gemini Robotics 2や軽量VLA、従来のロボット制御を組み合わせる構成が現実的だと思います。
今回のような単純なpick-and-placeでは、上位モデルを追加する効果が分かりにくい面もあります。
今後試すのであれば、複数の操作を順番に行うLIBERO-Longのような長期タスクで、工程分解や失敗時の再計画がどの程度役立つかを確認してみたいと思います。
まとめ
今回は、Gemini Robotics ER 2を使ってLIBEROのロボット操作タスクを試しました。
結果は失敗でしたが、次の点は確認できました。
画像から対象物と配置先を認識できる
instructionから自然な作業工程を生成できる
gripperの開閉を含む一連の動作を計画できる
正確な移動方向や移動量の生成には課題がある
細かな制御よりも、上位の計画や進捗管理に向いている
失敗例ではありますが、Gemini Robotics ER 2が得意な部分と、別の制御方法へ任せるべき部分を確認できました。
検証に使用したNotebookとコードはGitHubで公開します。
実際の動作についてはYouTubeへ公開しています。
次のステップ
次のステップでは、Gemini robotics ERとVLAモデルを利用することで実際に複雑な動作ができるかを検証していきたいと思います。
