
【データのちから 189話】 AIは「なぜ買うのか」を理解できるのか──Amazonの巨大常識知識システムCOSMOが示す、ユーザー行動からの意図抽出

この記事を読むことで得られる知識
大規模言語モデルから「買い物の理由」を抽出する技術的アプローチ: Amazonが数百万件のユーザー行動から3000万件の高品質な常識知識を構築し、実際の検索システムに実装して年間数億ドルの売上増を実現した具体的な方法論
データ活用における「意図の欠如」という根本問題: 既存のeコマース知識グラフが商品属性に偏重し、ユーザーの購買意図という「見えない接続」を見逃してきた構造的課題と、その解決が開く新しいデータ戦略
参考文献
Yu, C., Liu, X., Maia, J., Cao, T., Li, Y., Gao, Y., ... & Li, Z. (2024). COSMO: A Large-Scale E-commerce Common Sense Knowledge Generation and Serving System at Amazon. In Companion of the 2024 International Conference on Management of Data (pp. 1-13). ACM.
なぜ私たちは「妊婦用の滑りにくい靴」を買うのか
データ分析の現場でよく耳にする言葉がある。「データはあるのに、活用のアイデアが出てこない」。
この問題の本質は、実はデータそのものではなく、データが捉えきれていない「ユーザーの意図」にある。例えば、ある女性が「妊婦用の靴」と検索して滑りにくいシューズを購入したとき、そこには「妊娠中は転倒リスクが高いため、滑りにくさが必要」という常識的な推論が隠れている。しかし従来のeコマースシステムは、この「なぜ」を理解できていなかった。
Amazonが開発したCOSMO(Common Sense knowledge system for e-cOMmerce)は、この見えない意図を大規模に抽出し、実用化に成功した世界初のシステムだ。その成果は驚異的である。検索ナビゲーション機能の改善だけで、米国トラフィックの10%に対して0.7%の相対的売上増加──年間換算で数億ドルの増収を実現した。さらにナビゲーションのエンゲージメント率は8%も向上している。
この数字が示唆するのは、データ活用における根本的な転換点だ。商品情報をいくら整備しても、ユーザーが「なぜそれを必要とするのか」という意図のレイヤーが欠けていれば、データの価値は半減する。
従来の知識グラフが見落としていた「意図」という次元
既存のeコマース知識グラフは、主に商品の属性情報に焦点を当ててきた。AliCoCoは16万ノード・81万エッジ、AliCGは500万ノード・1350万エッジという規模を誇るが、そのほとんどは「この商品は何である」という事実的知識だ。例えば「AppleWatchはスマートウォッチの一種である」といった分類情報である。
しかしユーザーの購買行動を説明するには、別の種類の知識が必要だ。「結婚式に出席するために普通の服を買う」「カメラを保護するためにケースと保護ガラスを一緒に買う」──こうした意図的な常識は、商品属性からは直接導き出せない。
先行研究のFolkScopeは、大規模言語モデル(LLM)に「なぜこれらの商品を一緒に買うのか」と問いかけることで、意図知識を抽出する手法を提案した。しかしカバー範囲は2つのカテゴリーの共購買データ数千件に限られ、産業規模での実用には程遠かった。
COSMOは、この限界を3つの次元で突破した。
第一に規模の拡大である。18の主要カテゴリーにわたり、共購買ペア314万件、検索購買ペア187万件という膨大なユーザー行動を対象とした。最終的に生成された知識グラフは630万ノード・2900万エッジに達する。
第二に行動タイプの多様化である。共購買だけでなく、検索-購買行動を追加した意義は大きい。「冬用コート」と検索して「長袖のパファーコート」を購入する行動には、「高い保温性の提供」という意図が隠れている。検索クエリと商品の間の意味的ギャップを埋めることで、ユーザーの曖昧で進化する意図を捉えられるようになった。
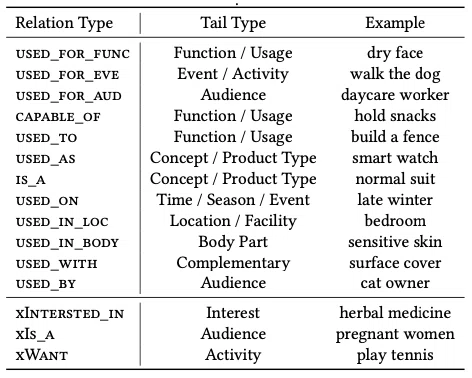
第三に関係タイプの体系化である。FolkScopeが既存の常識知識ベースから関係を借用したのに対し、COSMOはeコマース特有の15種類の関係を実データから発見した(表2参照)。「used_for_func(機能用途)」「used_on(使用時期)」「xIs_a(ユーザー属性)」など、購買文脈に密着した関係体系を構築している。
大規模言語モデルを「人間の好みに合わせる」技術
しかしLLMに「なぜ買うのか」と問いかけるだけでは、実用的な知識は得られない。論文が指摘する重要な問題は、LLMが生成する意図が必ずしも「典型的」ではないことだ。
「顧客が一緒に買ったのは、それらが好きだから」「AppleWatchを買ったのは、それが時計の一種だから」──こうした生成は文法的には正しいが、購買行動の説明としては無意味に近い。求められるのは「なぜこの組み合わせなのか」を典型的に説明できる知識である。
COSMOは、この課題をインストラクションチューニングという手法で解決した。その工程は精緻である。
まず数百万のユーザー行動ペアからLLMで知識候補を生成する。次に粗粒度フィルタリングで明らかな低品質データを除去する。パープレキシティスコアで不完全な文を除外し、検索クエリや商品名とほぼ同じ生成(編集距離が閾値以下)を削除する。さらに一般的すぎる知識(「同じ理由で使用」など)を頻度とエントロピーの組み合わせで特定し排除する。
類似フィルタリングでは、生成された知識の埋め込みと元の検索クエリ・商品の埋め込みのコサイン類似度を計算し、単なる言い換えを除去する。こうして残った候補から3万件を戦略的にサンプリングし、人間が妥当性(plausibility)と典型性(typicality) の2軸で評価する。
この3万件の高品質アノテーションデータが、COSMO-LMの訓練データとなる。LLaMA 7B/13Bをベースに、18ドメイン・15関係タイプ・5種類のタスク(常識生成、妥当性予測、典型性予測、検索関連性予測、共購買予測)を統合的に学習させる。
結果として、COSMO-LMは人間が「典型的」と判断する知識を優先的に生成できるようになった。検索購買データでは35%が典型的と評価され、これらがそのままインストラクションデータとして使用可能になった。
意図知識が変える3つの応用シーン
COSMOの真価は、下流タスクでの性能向上に現れる。
検索関連性の改善
eコマース検索の核心課題は、ユーザーのクエリと商品カタログの間の意味的ギャップである。「冬用の服」という検索には「保温性」への暗黙の期待が含まれるが、商品説明にその言葉がなければマッチングが困難だった。
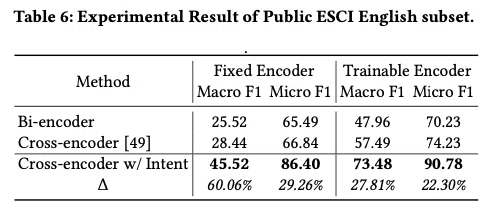
COSMOは検索購買ペア(クエリ、商品)から意図知識を生成し、それを関連性予測モデルの追加特徴として統合した。KDD Cup 2022の公開データセットでの実験では、意図知識を加えたクロスエンコーダーモデルが、ベースラインに対してMacro F1で27.8%、Micro F1で22.3%の改善を達成した(表6)。
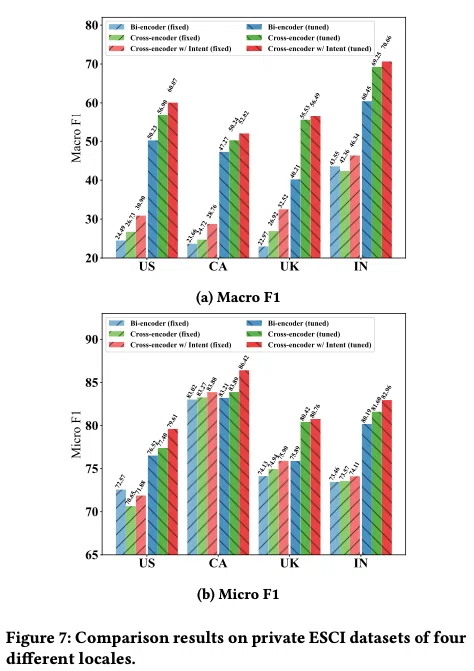
さらに注目すべきは、米国・カナダ・英国・インドという4つの地域の社内データセットでも一貫して性能向上が確認されたことだ(図7)。商品分布や検索言語の習慣が異なる市場でも、意図知識の有効性が実証された。これは単なる性能改善ではなく、意図というレイヤーがクロスマーケットで普遍的な価値を持つことの証明である。
セッションベース推薦の高度化
ユーザーの購買意図は単一の行動では完結せず、セッション内で進化する。例えば「衣類」を検索した後に「エレクトロニクス」カテゴリーで異なる商品を見る行動には、状況の変化が反映されている。
COSMO-GNNは、グラフニューラルネットワーク(GCE-GNN)に検索クエリ関連の意図知識を統合した。各時刻tでユーザーが検索したクエリk_tと相互作用した商品v_tのペアから意図知識を生成し、その埋め込みをGNNのアイテム埋め込みと結合する。
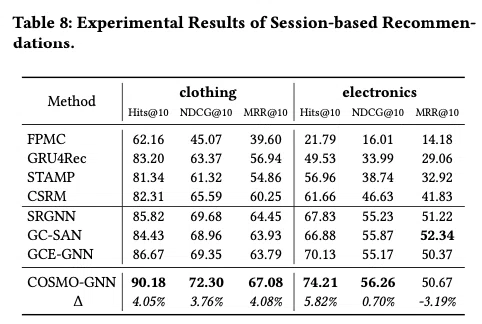
結果は顕著だった。衣類カテゴリーでHits@10が4.05%向上し、エレクトロニクスでは5.82%の改善を記録した(表8)。興味深いのは、セッション内のユニーククエリ数が多いほど改善幅が大きいという傾向である(エレクトロニクス2.47 vs 衣類1.36)。これは、検索行動が複雑で多様なほど、意図知識の価値が高まることを示唆している。
検索ナビゲーションの革新
従来の検索ナビゲーションは商品中心の分類体系に依存していたが、COSMOは顧客中心のアプローチに転換した。例えば「キャンプ」という広い検索に対し、COSMOは階層的な意図知識を動的に提供する(図8)。「キャンプ」→「エアマットレス」→「キャンプ用エアマットレス」→「湖畔キャンプ用」「山岳キャンプ用」「4人用キャンプ用」という多段階の絞り込みである。
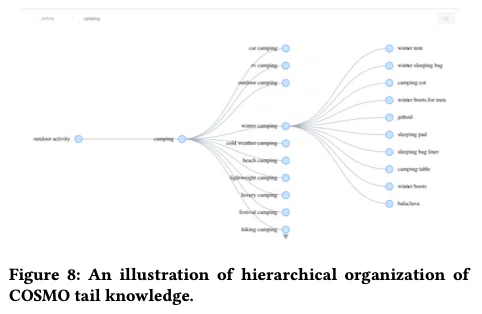
このマルチターンナビゲーションがもたらしたビジネスインパクトは、冒頭で述べた通り驚異的である。しかも、これは検索ページの比較的小さな機能改善によって達成されたという事実が重要だ。意図知識の適用範囲を全トラフィックに拡大し、他の機能にも展開すれば、さらに桁違いの価値創出が期待できる。
データ活用の本質的課題──「意図の不在」をどう乗り越えるか
COSMOの成功が示唆するのは、データ活用における根本的な転換である。
多くの企業が「データはあるのに活用できない」と悩む背景には、データ自体の量や質の問題だけでなく、データが捉えている次元の問題がある。商品属性、ユーザー属性、行動履歴──これらは全て「何が起きたか」を記述するが、「なぜ起きたか」という意図のレイヤーが欠けている。
意図は直接観測できない。しかし、大規模言語モデルという道具は、膨大な学習データから帰納的に獲得した常識を使って、観測可能な行動から意図を推論することを可能にした。COSMOはそれを産業規模で実装した最初の成功例である。
興味深いのは、論文が指摘する**「評価プロセスの革新が分析の精緻化より重要」**という洞察だ。COSMOの設計において、生成された知識をどう評価するか(妥当性と典型性の2軸)、どう人間の判断をモデルに組み込むか(インストラクションチューニング)という評価の仕組みが、高度なLLMそのものと同等かそれ以上に重要だった。
これは私たちの連載が一貫して強調してきた「データ活用のアイデアが足りない」問題への一つの答えでもある。アイデアとは単に「こういう分析をしよう」という発想だけではない。「データの何を、どういう基準で評価し、どう意思決定に結びつけるか」という評価設計そのものがアイデアの本質なのだ。
COSMOは、ユーザー行動という「データがある」領域から、購買意図という「データがない」領域へと橋を架けた。その橋の設計図は、他の多くのドメインにも応用可能だろう。あなたの組織のデータには、どんな「見えない意図」が隠れているだろうか。
