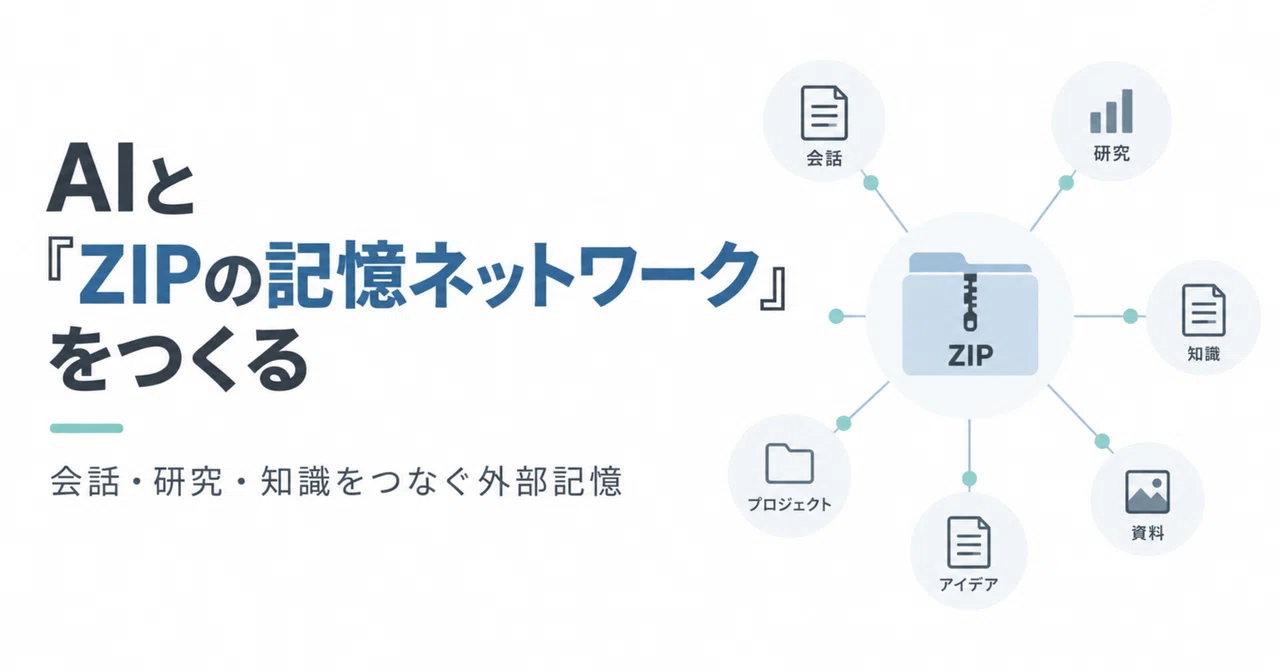
AIと「ZIPの記憶ネットワーク」をつくる会話の引継ぎから、研究・知識・履歴をつなぐ外部記憶へ

僕は普段、ChatGPTとの長期的な研究や雑談でZIPをかなり使っている。
最初は単純だった。
スレッドが長くなったら、
「ここまでをまとめて、引継ぎZIPを作って」
と頼む。
新しいチャットでそのZIPを渡して、
「この続きから話そう」
と言う。
これだけでもかなり便利だった。
ところが、長く使っているうちに気づいた。
ZIPは単なる「会話の引継ぎファイル」ではない。
複数のZIPをつなげれば、
人間とLLMが共有して利用できる「記憶のネットワーク」
として扱える。
ChatGPTとの長期作業では「記憶」より「状態管理」が難しい
現在のChatGPTは、かなり高度な数学や文章、コード、研究にも対応できる。
しかし、推論能力が高いことと、長期的な研究資料を正確に管理できることは別問題である。
研究を長期間続けると、
最新版と旧版を取り違えたり、PDFだけ更新されてTeXが古かったり、以前確認した命題が新版ではもう成立しなかったりする。
つまり必要なのは、
何を知っているか
だけではなく、
どの版について知っているか
である。
さらに、
何が正本か 何が未確認か 何が過去には正しかったが現在は無効か
まで管理しないといけない。
ここは、モデルの知能だけを上げても自動的には解決しない。
まず、一つのZIPを「記憶のノード」として扱う
僕は一つのZIPを、単なる圧縮ファイルではなく、
ある時点の会話・研究・知識状態を表す一つのノード
として扱っている。
たとえば研究なら、
Collatz_R12.zip
├─ MAIN.pdf
├─ MAIN.tex
├─ README.md
├─ STATUS.md
├─ calculations/
├─ data/
└─ manifest.json
のようにする。
重要なのはファイル数ではない。
そのZIPだけを渡されたChatGPTが、現在地をかなり復元できること
である。
READMEやSTATUSには、
何を研究しているのか、どこまで成立したのか、何が未証明なのか、どの枝を捨てたのか、次に何を調べるのかを書く。
これだけでも、チャットの長さに依存しにくくなる。
でも、本当に面白いのはZIPを複数つなげること
研究は一本道ではない。
ある研究が別の研究結果を使ったり、共通の方法論を参照したり、一度分岐した研究が後で再び合流したりする。
だからZIP同士の関係を単純なフォルダ階層や親子関係だけで表すのは少し不自然である。
より一般には、
G=(V,E)
というグラフとして考える方が分かりやすい。
ここで
V={ZIP}
を記憶ノード、
E={ZIP間の関係}
をエッジとする。
たとえば、
                ┌─ Anderson_R14.zip
                │
Gluing_Method.zip ─ Ising_R8.zip
                │
                └─ DifferentialEq_R5.zip
のように、一つの方法論ZIPを複数研究が参照してもよい。
逆に一つの研究ZIPが、
Collatz_Main_R12.zip
   ├─ depends_on → ABN_Definitions_R5.zip
   ├─ depends_on → Descent_Method_R3.zip
   ├─ supersedes → Collatz_Main_R11.zip
   └─ related_to → Numerical_Check_R7.zip
のように複数ノードへ接続してもよい。
こうなるとZIPは、
ファイルの箱
ではなく、
記憶グラフのノード
になる。
エッジにも意味を持たせる
ZIP同士が「つながっている」だけでは少し弱い。
関係そのものにも種類を持たせると、LLMがかなり扱いやすくなる。
例えば、
depends_on
supersedes
derived_from
related_to
contradicts
supports
replaces
などである。
すると、
「この研究の最新版はどれ?」
という質問には supersedes をたどればよい。
「この証明を理解するために何を先に読む必要がある?」
なら depends_on をたどればよい。
単なる意味的類似検索ではなく、
知識の来歴や依存関係まで使って記憶を探索できる。
タグを最初からLLM向けに設計する
もう一つ重要なのがタグである。
タグは人間が検索するためだけのものではない。
LLM自身が必要な記憶を選ぶための索引
として使える。
人間向けなら、
#コラッツ
#数学
#証明
#研究中
くらいでも十分かもしれない。
しかしLLM用なら、もう少し構造化できる。
domain:number_theory
object:collatz
method:descent
structure:ABN_CPE
claim_status:partial_proof
canonical:true
needs_recheck:false
こうしておけば、
「コラッツ予想の降下証明を再開したい」
という要求に対して、最初からすべてのZIPを展開する必要がない。
まずタグとグラフ構造だけを見て、
関連性の高いZIPを選ぶ。
その後、必要な依存ZIPだけを追加で読む。
つまり、
問い→記憶グラフ探索→必要ノード選択→ZIP展開→推論
という流れにできる。
巨大な記憶を全部読む必要はない
これはかなり重要だと思っている。
AIに長期記憶を持たせるというと、
「とにかく全部覚えさせる」
方向へ考えがちである。
でも、人間も毎回すべての記憶を同時に意識しているわけではない。
今考えている問題に必要な記憶だけを呼び出している。
ならAIも、
今回利用するノード

[✓] Collatz_Main_R12
[✓] ABN_Definitions_R5
[✓] Descent_Method_R3
[ ] Old_Failed_Branches
[ ] Anderson_Project
[ ] Shogi_Project
のように必要なものだけ選べばよい。
これは巨大なコンテキストへすべてを押し込むより自然だと思う。
雑談も研究も、同じネットワークにできる
僕はZIPを研究だけに使っているわけではない。
雑談でも、
「ここまでの話をまとめて引継ぎZIPにして」
と頼むことがある。
すると、
最近どんな話をしていたか、どんな研究が進んでいたか、どんな前提で会話していたかを新しいスレッドへ持ち運べる。
つまり、
研究記憶
だけでなく、
会話記憶
もノードにできる。
さらに、
「この雑談から研究Aが始まった」
という関係までグラフに持たせられる。
そう考えると、研究と雑談を完全に別物として扱う必要もない。
どちらも、
継続する知的活動の記憶
である。
AIの確認履歴も記憶ネットワークに入れる
長期研究では、AIが一度確認したことも永遠に有効とは限らない。
たとえばR10で
AI checked: passedだった命題が、R12で定義変更されたら、その確認はもう使えないかもしれない。
だから僕は、
AI確認済み
AI確認取消
要再確認
再確認済み
のような状態を持たせられる方がよいと思っている。
重要なのは、
昔AIが確認したという履歴を消さないこと
である。
「いつ、どの版に対して、何を確認したか」
「なぜ後で無効になったか」
まで追跡できれば、研究履歴そのものがかなり頑健になる。
Workモードがあっても、ZIP方式には別の意味がある
「長期作業ならWorkを使えばよい」
という意見もあると思う。
もちろん、それも一つの方法である。
ただしZIPには、
ユーザー自身が記憶を所有できる
という別の特徴がある。
ZIPなら、
Chatモードでも使える。
ローカルへ保存できる。
別のチャットへ持っていける。
別のAIへ渡すこともできる。
モデルやUIが変わっても、記憶グラフそのものは手元に残る。
つまり、
AIの記憶をAIだけに預けなくていい
のである。
なぜ、こんな便利なアイデアを公開するのか
こういう話を書くと、
「便利なら自分だけで使えばいいのでは?」
と思われるかもしれない。
僕は逆だと思っている。
広まった方が、自分にも得だからである。
現在のChatGPTは、
「ZIPで渡して」
「引継ぎZIPを作って」
と言えば、かなり対応してくれる。
つまり能力はすでにかなりある。
しかしChatGPT自体が、
ZIPの記憶ネットワークを前提に設計されているわけではない。
だから、ときどきファイル管理や版管理でミスが起きる。
もし多くの人がZIPを記憶ノードとして使い始めたら、サービス側にも需要が見える。
すると将来、
ZIPを読み込むと自動でmanifestを認識したり、正本を判定したり、依存関係をたどったり、必要なZIPだけ選択したりする機能が作られるかもしれない。
そうなれば、僕自身の環境も便利になる。
だから、
便利な運用方法ほど、広めた方がいいこともある。
ユーザーの工夫が製品設計を変えることもある
新しいソフトウェアでは、利用者が最初から想定されていなかった使い方を発見することがある。
そして、多くの人が同じ迂回路を使い始めると、それが正式機能になる。
ZIPの記憶ネットワークも、そういうものになってもいい。
僕が欲しいのは、巨大な一つの記憶ではない。
必要なときに必要な記憶へ到達できるネットワーク
である。
ZIPは、ファイル形式ではなく知能環境になり得る
ZIP自体は昔からある、ごく普通の圧縮形式である。
新しい技術でも何でもない。
でも、
ZIP+manifest+tags+typed graph
とすると、役割が変わる。
それは、
LLMが探索可能な外部記憶空間
になる。
モデル本体だけを賢くするのではなく、
モデルが正しく思考できるように、
記憶の置き方や接続方法まで設計する。
僕は、これからのAIではこうした
「知能そのもの」ではなく「知能が使う環境」の設計
もかなり重要になると思っている。
まずは一個のZIPから始めればいい
最初からグラフデータベースを作る必要はない。
長くなったチャットで、
「ここまでの内容を、次のチャットで再開できるZIPにまとめて」
と頼んでみる。
そこから、
READMEを入れる。
タグを付ける。
版番号を付ける。
親ZIPを書く。
依存ZIPを書く。
少しずつノード間の関係を増やしていけばいい。
そうしているうちに、
単なる「引継ぎZIP」が、
自分とAIが共有する記憶のネットワーク
になっていく。
僕は今、
ZIPをファイルの束ではなく、記憶のノードとして使っている。
そして、この方法を自分だけの裏技で終わらせるより、多くの人が試した方が面白いと思っている。
利用者側が先に使い方を作れば、
AI側の設計もあとから追いつくかもしれない。
「ChatGPTに全部覚えてもらう」のではなく、
人間とAIが一緒に使える記憶空間を、人間側でも持つ。
その一つの形として、
ZIPの記憶ネットワークは、かなり面白いと思う。
最後に
僕は、AIそのものの性能を上げることだけがAI開発ではないと思っている。
長くAIを使っていると、モデル本体をさらに巨大化しなくても、外部記憶、ファイル管理、状態管理、検証機構、専門的な補助ツール、AIが情報を読みやすい構造など、環境側を工夫するだけで改善できそうな部分がたくさん見えてくる。
今回紹介した「ZIPの記憶ネットワーク」も、その一例である。
僕自身、こうしたAIの知能環境について、まだいくつも開発アイデアを持っている。大規模モデルの性能そのものを上げる開発に比べれば、比較的低コストで試せるものも少なくないと思う。
もしAIの長期利用、研究環境、記憶、ファイル管理、検証、知能インフラの設計に関わる人がこれを読んでいたら、こういう利用者側から見える問題やアイデアも、AI開発の一部として面白いのではないかと思っている。
#ChatGPT #生成AI #LLM #AI活用 #知識管理 #ナレッジマネジメント #研究 #研究支援 #ZIP #AI研究
いいなと思ったら応援しよう!
 このNoteの記事は、基本的に全て無料で公開していく予定です。それでももし、僕の活動に共感して応援したいと思ったら、ささやかなチップでも次の『表現』への大きな支えになります。
