画像修正の「そこじゃない」を減らす指示の出し方|ChatGPT Images 2.5の文章・スケッチ・コメント分担

画像を1枚作ったあと、「右下の小物だけ少し小さくして。人物の顔と服はそのまま」と伝えたのに、直してほしくない場所まで変わってしまう。画像生成を使っていると、こうした「そこじゃない」は意外と時間を取ります。
研究室でしろ丸が画面を見ながら気にしていたのも、まさにそこでした。修正したい場所は目で見れば一瞬で分かるのに、それを文章へ変換しようとすると急に説明が長くなる。「右から3分の1あたり」「人物の肩より少し下」「背景の青い部分は残して」……。伝えたいのは小さな差分なのに、言葉だけで位置関係まで説明し始めると、指示そのものが仕事になってしまいます。
そんなタイミングで、OpenAIが2026年9月8日に「ChatGPT Images 2.5」を発表しました。OpenAIによると、Images 2.5では細部の表現、編集精度、参照写真に写る被写体の保持、複数回の編集での一貫性が改善されています。生成待ち時間もImages 2.0と比べて最大50%短縮したとしています。
ただ、しろ丸が最初に注目したのは「速くなった」「きれいになった」という部分でした。画像モデルの更新ニュースなら、まずそこを見るのは自然です。ところが公開内容を仕事の場面へ置き換えて読み直すと、もう一つ大きな変化が見えてきました。
ChatGPTには、手描きのラフを画像作成の参考にできるSketch、画像上で場所を示しながら修正内容を伝えられるコメント機能、よく使われる形式から始められるTemplatesなども加わっています。OpenAIのリリースノートでは、Sketchや画像上の編集・コメントはモバイルでの利用方法が案内されています。Images 2.5自体はChatGPT、ChatGPT Work、Codexの全ユーザーへ、デスクトップ・モバイル・Webで展開されていますが、個々の編集機能は利用環境ごとに確認しておくと確実です。
ここで、しろ丸は最初の見方を少し変えました。
このニュースの面白さは、画像モデルが高性能になったことだけではない。画像へ意図を伝える入口が、文章一本から広がっていることではないか。
たとえば、社内告知用の画像を作る場面を考えてみます。「明るく親しみやすい雰囲気にしたい」「ロゴは入れない」「人物の表情は変えない」といった条件は、文章の方が正確に伝えやすい。一方で、「タイトルはこの辺」「人物は左寄り」「商品をもう少し中央へ」といった空間の関係は、文章で何行も説明するより、ラフを描いた方が早いことがあります。
さらに、生成後に「この部分だけ直したい」となったら、画像上の対象へコメントできる方が、修正場所を言葉で再説明する負担を減らせます。
つまり、全部を一つの長いプロンプトへ押し込む必要がなくなってきたわけです。
しろくま研究所としての実務解釈は、ここにあります。これはOpenAIが「この方法が正解」と発表したものではなく、今回の機能から導いた使い方です。
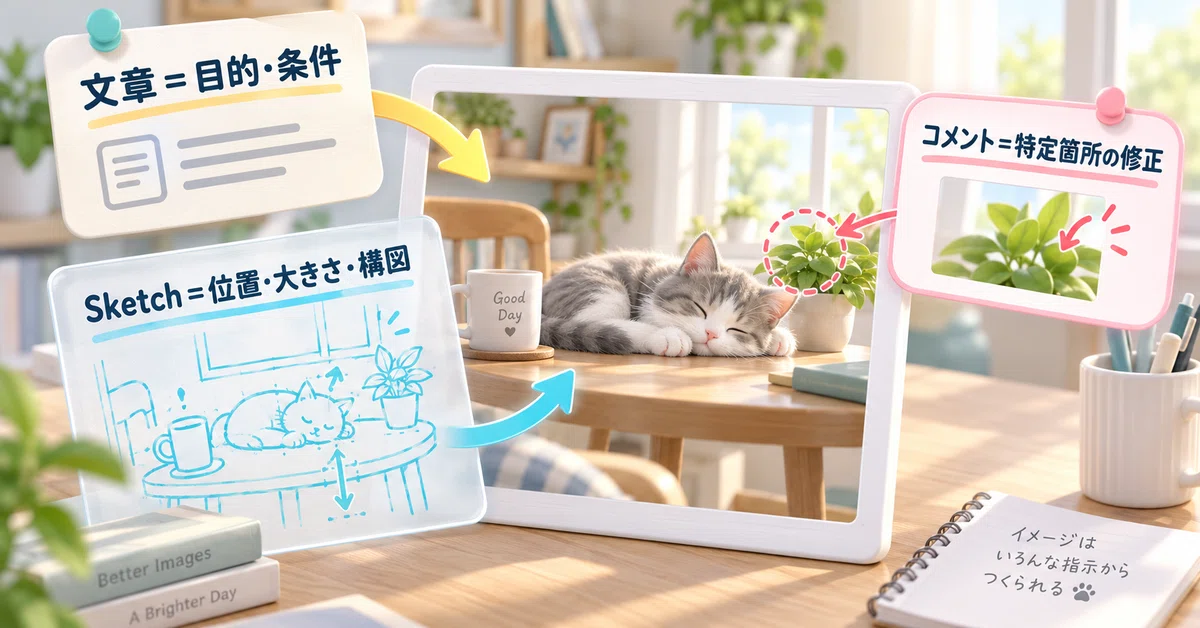
文章は、目的・雰囲気・守ってほしい条件・変えてはいけない条件を伝える。
スケッチは、位置・大きさ・視線の流れなど、空間の関係を伝える。
画像上のコメントは、生成後の局所的な修正を伝える。
この分け方をすると、「もっと詳しいプロンプトを書かなければ」と考える前に、「そもそもこれは文章で伝える情報なのか」と考えられます。
ここが今回の小さな発見でした。
画像生成では、プロンプトの文章力ばかりが注目されがちです。でも、位置を伝えるのが苦手なのは文章が下手だからとは限りません。位置や形は、そもそも視覚で渡した方が情報量の多い場合があります。逆に、禁止事項や意味、ブランド上の条件は、スケッチだけでは曖昧になりやすい。入力方法ごとに得意な情報が違います。
しろ丸は、修正がうまく伝わらない場面を「プロンプト不足」と決めつけるのをやめました。問題は文章量ではなく、情報と入力方法の組み合わせかもしれないからです。
実務で使うなら、最初から全部の機能を使う必要はありません。まず普通に文章で目的と条件を伝え、構図の説明が長くなったときだけSketchへ逃がす。生成後、場所の説明が難しい修正だけコメントへ渡す。このくらいの分担でも、指示文を延々と増やすより整理しやすくなります。
たとえばSNS用のビジュアルなら、「何を伝える画像か」「入れてはいけない要素」「必須の文字」は文章で固定する。キャラクターやタイトルの位置関係は簡単なラフで示す。完成候補を見て一部分だけ変えたいときは、その場所へコメントする。商品画像なら、商品の見え方や背景の方向はラフで伝え、商品そのものを変えない条件は文章で残す、といった使い分けができます。
もちろん、Images 2.5になったからすべての修正が必ず意図どおりになる、という意味ではありません。OpenAIは編集精度や複数回編集の一貫性向上を説明していますが、個別の画像、複雑な指示、利用環境によって結果は変わります。「最大50%高速」も常に半分の時間になるという意味ではなく、OpenAIがImages 2.0との比較で示している上限値です。
また、参照写真の被写体をより保持しやすくなったという改善も、「絶対に顔や形が変わらない」という保証ではありません。仕事で使う画像なら、完成候補を見て必要な部分が保たれているかは、用途に応じて確認する必要があります。
それでも今回の更新は、画像生成を「文章で命令して完成品を待つ道具」とだけ考える必要がなくなってきたことを示しています。描いて伝える。出来上がった画像を見ながら場所を指して直す。文章は文章が得意な情報へ集中させる。制作の会話が、少し人間同士のデザイン相談に近づいています。
研究成果として持ち帰りたいのは、「長いプロンプトを書く」より「情報に合う伝え方を選ぶ」という考え方です。
次に画像修正で「そこじゃない」が起きたら、すぐ文章を追加する前に、その指示を見直してみてください。位置や大きさの話ならSketchで見せられないか。特定部分の話なら画像上で指せないか。目的や禁止条件なら文章のまま残すべきではないか。
ChatGPT Images 2.5のニュースは、画像生成がまた少し高性能になったという話だけではありません。私たち側の「AIへの伝え方」も、文章だけから選べる時代へ進み始めています。
いいなと思ったら応援しよう!
 しろくま研究所の発信を応援していただける方へ。
いただいた応援はAIの調査・検証と仕事で使える形への整理に活かします。
