Thinking Machines、初のオープンモデル「Inkling」公開 ― 9750億パラメータでNemotron 3 Ultraの3分の1のトークン数を実現

OpenAIの元最高技術責任者(CTO)であるミラ・ムラティ氏が率いるAIスタートアップ、Thinking Machines Labが、初の自社開発AIモデル「Inkling」を公開した。OpenAI、Anthropic、Googleが提供する主力モデルとは異なり、Inklingは、オープンウェイトとして提供される点が最大の特徴だ。同社は、創業から約1年半、AIインフラの構築を公にはほとんど明かさずに進めてきており、今回が初の公開実証実験となる。
1. Inklingの技術的特徴
2-1. アーキテクチャとスペック
Inklingは、Mixture-of-Experts(専門家混合)方式を採用したTransformerで、総パラメータ数9750億のうち、実際に使用されるのは約4100億パラメータにとどまる。最大100万トークンのコンテキストウィンドウに対応し、テキスト・画像・音声・動画を含む45兆トークンで事前学習された。同社の公式発表によれば、MoE設計は、DeepSeek-V3を踏襲しつつ、各層に256のルーティング専門家と2つの共有専門家を持ち、トークンごとに6つのルーティング専門家が活性化する構成だという。
Thinking Machinesは、これを「サイズの異なるモデルファミリーの第1弾」と位置づけており、同時に軽量版「Inkling-Small」(2760億パラメータ、稼働時120億パラメータ)のプレビューも公開した。同社によれば、Inkling-Smallは、事前学習データとレシピの改良により、多くのベンチマークで上位モデルと同等かそれ以上の性能を示すという。
1-2. ベンチマーク性能
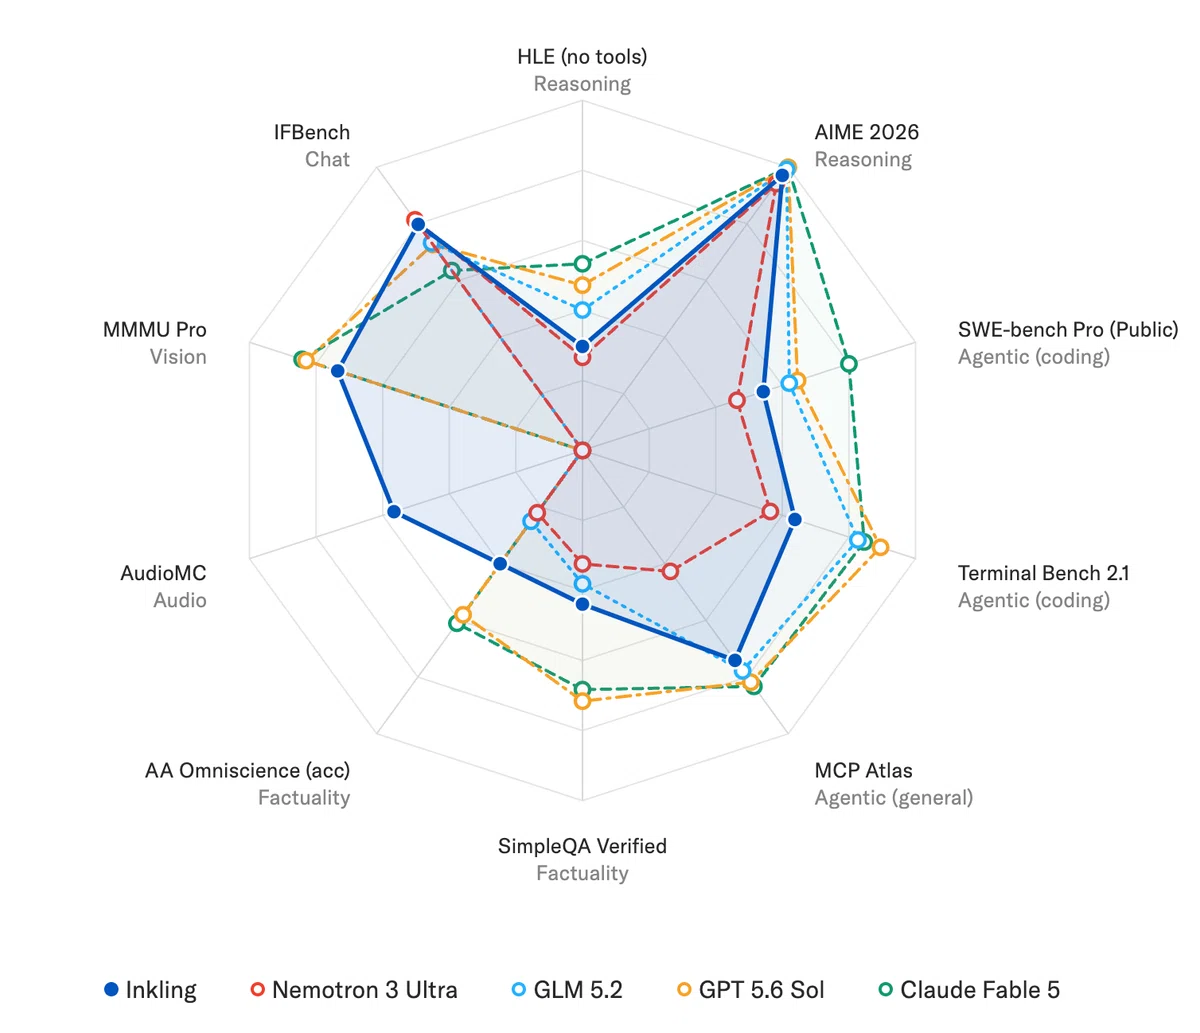
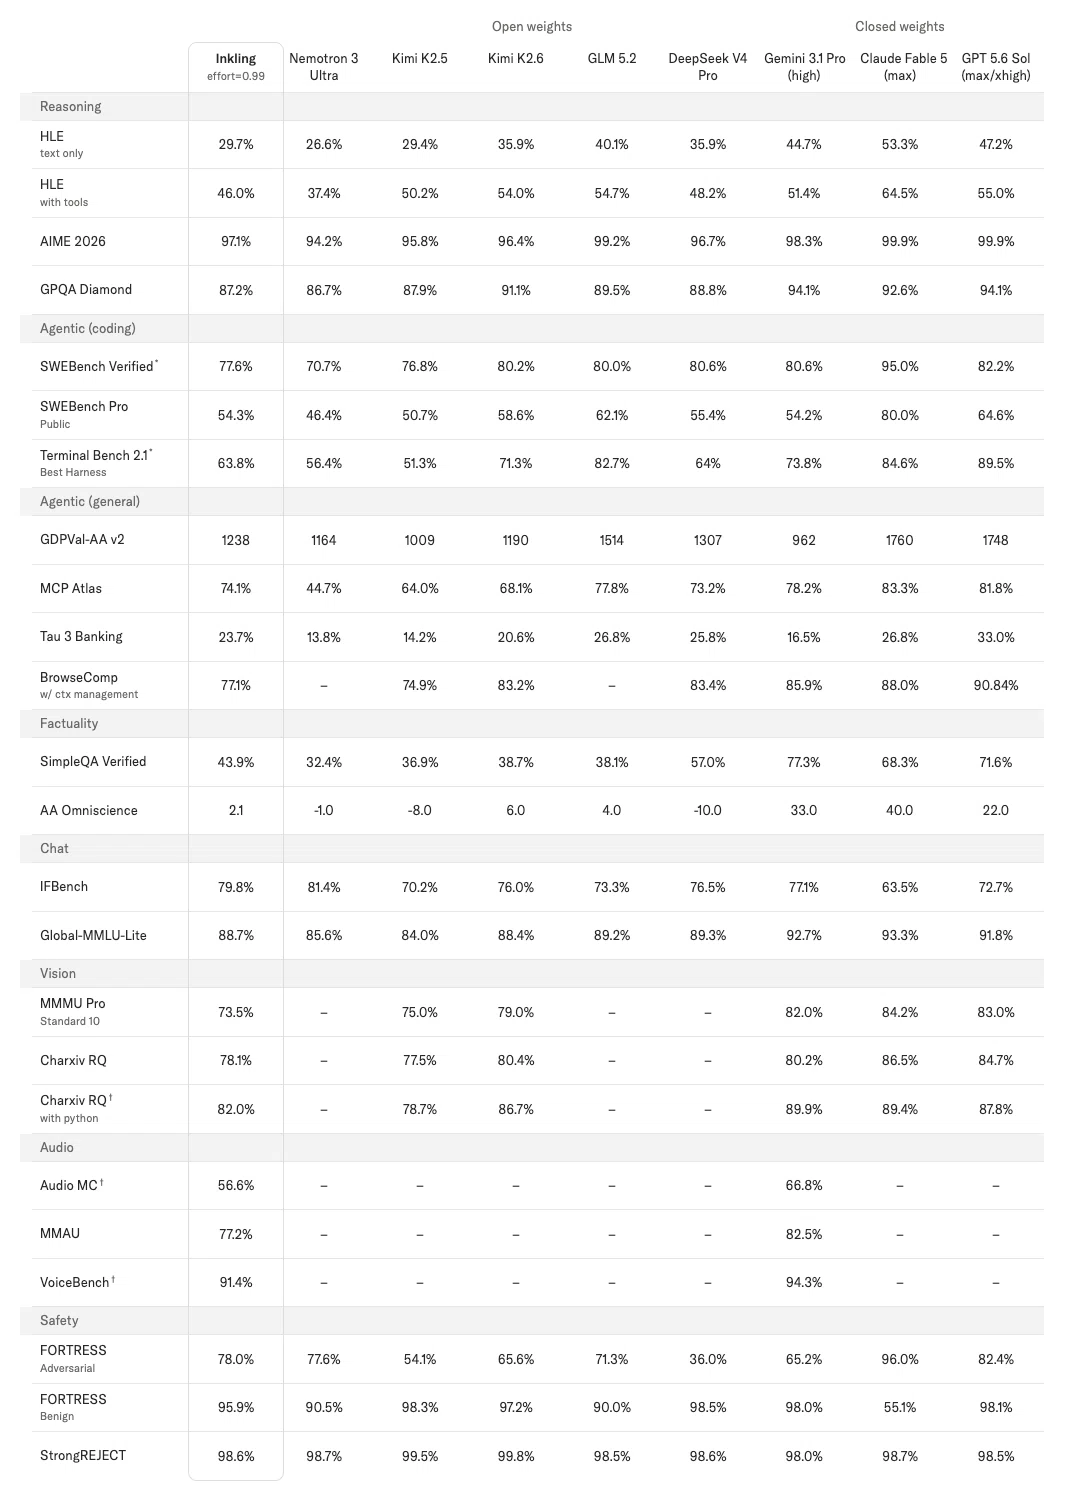
同社が公開したベンチマーク比較では、Inklingは、推論(HLE、AIME 2026、GPQA Diamond)、エージェント型コーディング(SWEBench Verified、Terminal Bench 2.1)、事実性(SimpleQA Verified)、視覚・音声(MMMU Pro、VoiceBench)など幅広い領域でNemotron 3 Ultra、Kimi K2.5/K2.6、GLM 5.2、DeepSeek V4 Proといったオープンウェイトモデルと比較されている。SWEBench Verifiedでは77.6%、GPQA Diamondでは、87.2%を記録した。
一方で、Claude Fable 5やGPT 5.6 Solといったクローズドモデルとの比較では、特にSimpleQA VerifiedやHLE(with tools)などの一部指標で差が見られる。同社自身、ブリーフィング資料に「Inklingは、クローズド・オープンを問わず現時点で最強のモデルではない」と明記しており、狙いは突出した性能ではなく、バランスの取れた総合性能だと見られる。
1-3. 「思考努力」の調整と効率性
Inklingは、「thinking effort(思考努力)」を調整できる設計で、性能とトークン消費量のトレードオフをユーザー側で選択できる。同社が公開した効果測定によれば、Terminal Bench 2.1においてInklingは、Nemotron 3 Ultraと同等の性能をおよそ3分の1のトークン数で達成するという。この効率性は、モデルを大量かつ長時間のワークフローの一部として繰り返し実行する際のコスト・レイテンシ管理において重要な意味を持つ。
1-4. 「不確実性を認める」設計(エピステミクス)
同社は、Inklingを、キャリブレーション・指示追従・検閲への耐性という3要素を合わせて「エピステミクス」と呼び、重点的に訓練したという。特に予測タスクでは、ForecastBenchのBrier Indexで61.1を記録し、GPT-5.5(59.1)を上回る一方、Claude Opus 4.8(54.6)よりも高いスコアを示した。同社は「短文形式の事実質問について、モデルが自信のある場合にのみ回答し、そうでない場合は『わからない』と答えるよう報酬設計した」と説明している。
1-5. 安全性評価
外部の安全性テスターによる検証も実施されており、武器・暴力関連のリクエストへの拒否率と、良性の類似クエリへの過剰拒否のバランスを測る「FORTRESS」ベンチマークでは、Inklingは、比較対象のオープンウェイトモデルの中で最も高い安全性スコアを示したとしている(Adversarial 78.0%、Benign 95.9%)。
2. 事業戦略:「Tinker」というカスタマイズ基盤
Thinking Machinesは、Inklingを完成品ではなく、組織が自ら微調整する「出発点」と位置づけている。その手段が同社のモデルカスタマイズ基盤Tinkerだ。Inklingは、現在Tinker上で、コンテキスト長64Kおよび256Kトークンのオプションでファインチューニング可能となっており、期間限定で50%割引が適用されている。同社は、TogetherAI、Fireworks、Modal、Databricks、Basetenなどエコシステム全体と提携し、ファインチューニング済みモデルのデプロイを支援する体制も整えた。
このアプローチは、OpenAI・Anthropic・Google各社が汎用チャットボットとして競争力を持たせた上でエージェント機能を後付けするのとは対照的だ。Thinking Machinesは先週公開したブログ記事で、「一社が中央集権的に訓練し固定化されたAIは、組織が自ら形作るAIに劣る」と主張している。この考え方は業界内でも支持を広げつつあり、マイクロソフトCEOのサティア・ナデラ氏は「プロプライエタリAIを利用する企業は事実上二重に支払っている」と警告し、Hugging Face CEOのクレマン・デランゲ氏も「本番運用の大半はプライベート・オープンソースへシフトする」と予測している。
3. Bridgewaterとの共同研究が示した実績
この主張を裏付ける事例として、世界最大のヘッジファンドBridgewater Associates(Thinking Machinesの投資家ではない)との共同プロジェクトが挙げられる。オープンソースモデルをBridgewater独自の金融知見でさらに訓練した結果、財務推論テストで84.7%のスコアを記録し大手プロプライエタリAIを上回った一方、運用コストは約14分の1に抑えられたという(両社独自の評価であり、独立検証ではない)。
4. スピード感、蒸留、コスト構造
Thinking Machinesは、OpenAIの5年・Anthropicの3年に対し、自社は約9カ月で製品化に至ったと強調する。一方で、公式発表によれば、後処理(post-training)の初期段階のブートストラップに際し、Kimi K2.5を含むオープンウェイトモデルが生成した合成データでSFT(教師ありファインチューニング)を実施したことを認めている。ただしこの部分は全体の計算資源のごく一部にとどまり、大部分は合成環境・人手作成環境での大規模強化学習(RL)に充てられたという。同社は30万ロールアウトを超える大規模非同期RLを実施し、推論性能が対数線形的に向上したと説明している。
Inkling自体はNVIDIAのGB300 NVL72システム上で訓練された。同社は3月にNVIDIAと戦略提携を結び、1ギガワット規模のVera Rubinコンピューティング容量を展開すると発表している。もっとも、収益とコストのバランスについては明らかにしておらず、報じられた500億ドル規模の資金調達も難航したとされる。ウェイトが公開されている以上、収益源はモデル自体ではなく、訓練・ファインチューニングを担うTinker周辺のエコシステムに依存する構造だ。従業員数は約200人で、今年初めの離職の波から回復している。
