【解説】Claude Opus 5登場、あなたのプロンプトは大丈夫?「必ず検証して」が逆効果に?

こんにちは。すぐるです。
月末の夜、Claudeの利用枠が尽きて作業が止まる。あの手持ち無沙汰を、私も何度か味わってきました。しかも手元には、AIに毎回使い回す指示文の束があります。Claude Codeなら常に読み込まれる設定メモ(CLAUDE.md)や自作スキル、ブラウザ版Claudeならカスタム指示。そこへ良かれと思って足した「必ず検証して」「もう一度見直して」のお守りがぎっしり。まさか、それが犯人の一味だとは思ってもいませんでした。
そんな折の日曜の朝、いつものようにClaude Codeを立ち上げたら、見慣れない一行が挨拶の下に出ていました。「Tackle your toughest work with Opus 5.」。7月24日に出たばかりのAnthropicの新モデル、Claude Opus 5への切り替え案内です。
触れ込みは「最上位モデルFable 5級の頭脳を、半額で毎日」。Claude Maxでは標準モデルになり、Claude Codeでも選べるようになりました。ここまでなら、よくある新モデルのニュースです。
様子が違ったのは、同じ日に公開されたプロンプト(AIへの指示文)の公式ガイドを開いたときでした。そこには、はっきりこう書いてあります。
プロンプトに明示的な検証指示(「自明でないタスクには最終検証ステップを含める」「サブエージェントを使用して検証する」)が含まれている場合は、削除してください。
冒頭のあのお守りたちを、名指しで削れと言うんです。新モデルの説明書が「削り方」から教えてくるのは、初めて見る光景でした。
しかも、削ったほうが速くて安い。試しに手元のClaude Codeで同じバグ修正を比べたら、お守り付きが180.7秒、削った版が20.8秒。答えはどちらも正解で、差を作ったのはたった1段落でした。
Opus 5の基本、ベンチマークの読み方、公式ガイドの中身、手元での実測、そして公開された「Opus 5自身に渡されているプロンプト」まで、これ1本で追える順番に並べました。ゆっくりどうぞ。
🎯 この記事で分かること
・Opus 5の何が新しいのか(価格・性能・考える深さのつまみ)
・公式ベンチマークは、どの数字を見ればいいのか
・ARC-AGI-3の「30.2%」がなぜ事件なのか
・公式ガイドが「削れ」と言う5つの指示と、代わりに足していい指示
・削る前と後を実測した結果(180.7秒が20.8秒になりました)
・公開されたシステムプロンプトから読める設計思想
⚠️ この記事は2026年7月27日時点の情報です。価格や提供範囲は今後変わる可能性があります。本文の数字はすべて、記事末尾の一次ソース(公式ページ)で確認できます。
今回の話が効く人の筆頭は、ClaudeやClaude Code、Cowork、API(プログラムからAIを呼び出す窓口)で毎日AIに仕事を投げている人です。その指示文の束から1行削るだけで、待ち時間と利用枠が目に見えて軽くなります。ブラウザでたまに使う人にも、「モデルが進むとプロンプトの作法が逆転する」という本題は、次にどのAIを選ぶかの判断材料になるはずです。
🚀 まず30秒で。「Fable 5級の頭脳を半額で毎日」がOpus 5です
まず全体像からいきましょう。Anthropicの現在の最上位モデルは、6月に出たClaude Fable 5です。Opus 5は、そのFable 5に迫る知能を半分の値段で出すことを狙った、いわば「毎日使う用の主力モデル」です。
API価格は入力100万トークン(トークン=AIが読み書きする文章量の単位)あたり5ドル、出力25ドルで、前世代のOpus 4.8から据え置き。Fable 5(10ドル/50ドル)のちょうど半額です。有料プランでは発表当日から使えて、Claude Maxでは標準モデルに、Claude Proでは選べる中の最上位になりました。ブラウザやスマホのClaude、Claude Code、Coworkと、入り口を問わずモデルを切り替えるだけです。
お金で速さを買う選択肢も増えました。約2.5倍の速度で動くFast modeが、2倍の単価(10ドル/50ドル)でAPI向けに用意されています(研究プレビュー段階です)。
線引きも正直に書いておきます。Anthropic自身のSystem Card(モデルの性質を細かく報告する公式文書)では、Opus 5は総合力ではFable 5の下に位置づけられています。すべてで勝つモデルではなく、多くの仕事で「ほぼ同じ結果が半額で返る」モデル。この距離感が今回の主役です。
公式の告知はこちらです。
📊 ベンチマークは「点」ではなく「線」で読む
その「ほぼ同じ結果が半額」は、本当なのか。どこで勝って、どこで負けるのか。ベンチマーク(モデルの実力を測る共通テストの成績)で確かめましょう。今回の公式チャートには読み方のコツがあります。ほとんどの図が、縦にスコア、横に1タスクあたりのコストを取った「線」のグラフになっています。
線になっている理由は、この後に説明する「考える深さのつまみ」を5段階に振って測っているから。線が左上にあるほど「同じお金でより賢い」。これだけ覚えれば、どの図も10秒で読めます。
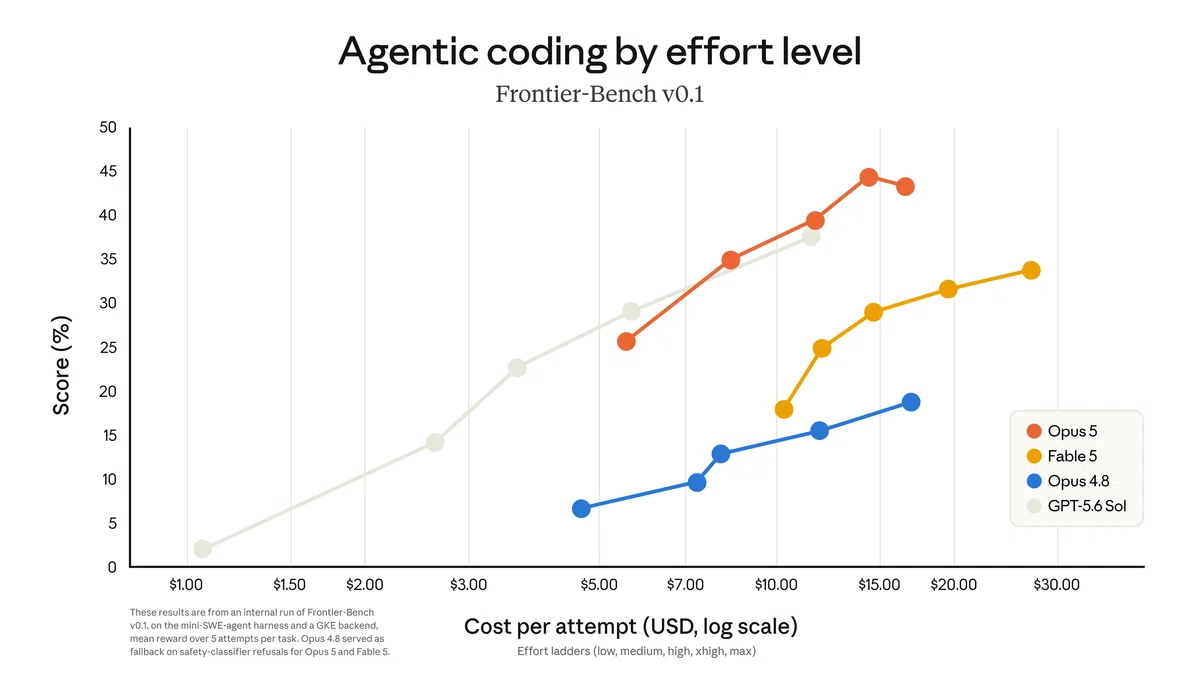
看板のコーディング評価Frontier-Bench v0.1では、Opus 5が43.3で全モデルの頂点に立ちました。Fable 5の33.7、GPT-5.6 Solの37.5を上回り、Opus 4.8(18.7)には2倍以上の差を、より安いタスク単価のまま付けています。
まず勝ち側から。コーディング以外の実務評価でも、冒頭の触れ込み「半額でFable 5級」がそのまま数字になって並びます。
GDPval-AA v2(実在の職業タスクで競う): Eloスコア(対戦成績から強さを点数化する方式)で1861の首位。Fable 5は1747
OSWorld 2.0(パソコン操作の自動化): 70.6。Fable 5の最高記録を約3分の1のコストで超えた
Zapier AutomationBench(業務を最後まで完走できるか): 同じコストで完走率が次点の約1.5倍
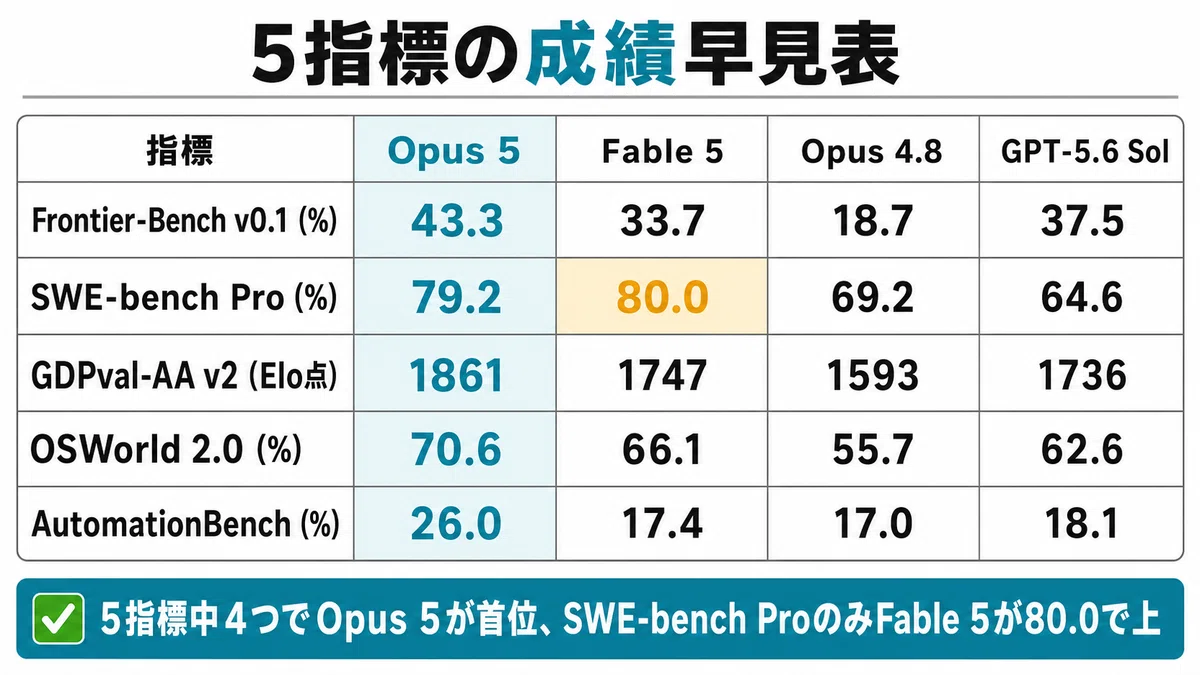
次に、負け側です。ソフトウェア修正の難問集SWE-bench Proは79.2で、Fable 5の80.0にわずかに届きません。サイバーセキュリティ系の評価は、政府承認を経た組織にだけ制限解除版が提供されるMythos 5に大きく劣ります(一般提供モデルとしては意図された線引きでもあります)。Terminal-Benchやτ2-benchの数値は、今回の公式資料には載っていませんでした。
もうひとつ、地味に効くのが行動の安定性です。Anthropicの自動行動監査では、無謀な行動やごまかしの少なさを測るスコアが2.30(低いほど良い)で、比較されたClaude各モデルの中で最良でした。長時間の自律作業を任せるなら、この数字は派手さより効くんですね。そしてこの「任せて大丈夫」が、後半に出てくる「検証指示を削っても大丈夫」の土台になります。
🎮 30.2%。2週間前の「事件」が、もう塗り替えられました
ベンチの表の中でひとつだけ、桁の違う伸び方をした数字があります。初見の問題を解く力を測るARC-AGI-3です。
ARC-AGI-3は、過去問の暗記が効かないように設計された「初めて見るパズルだけの試験」。2週間前、私はGPT-5.6の記事で「たった7.8%が、今回いちばんの事件です」と書きました。その記録が、もう塗り替えられています。Opus 5(high設定)は30.16%。検証機関のARC Prizeが公式に確認した数字です。
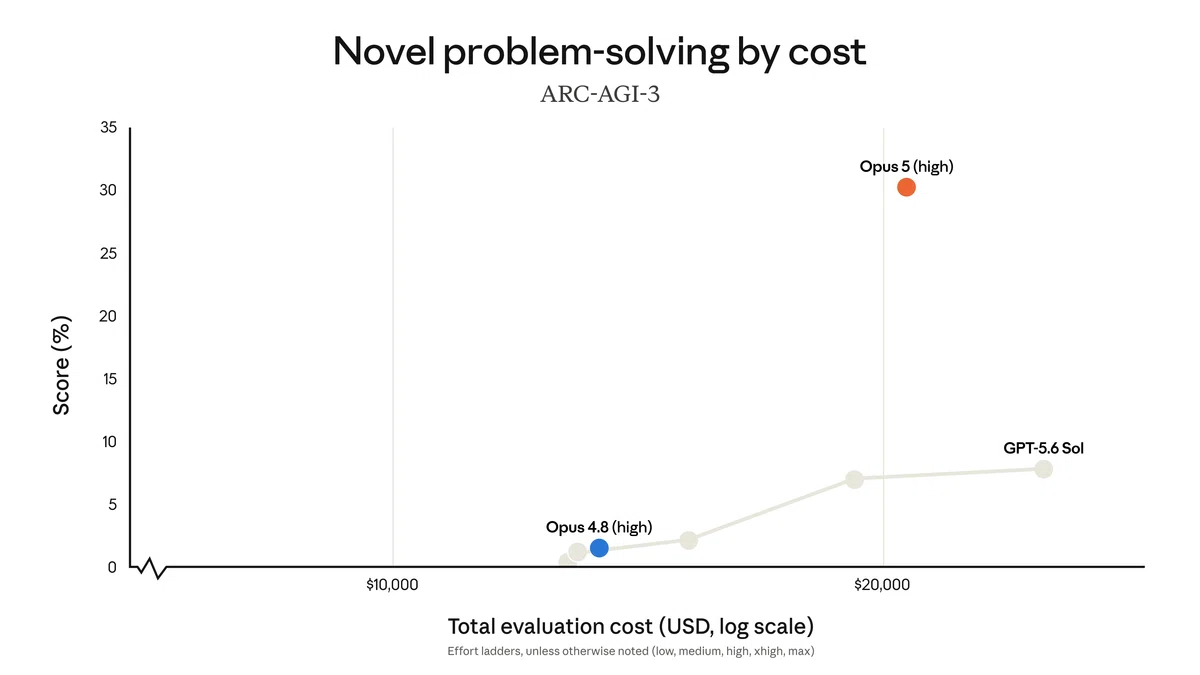
前世代のOpus 4.8は1.5%でしたから、約20倍。しかも、これまでどのモデルも解けなかった5つの公開デモ環境を初めてクリアしました。
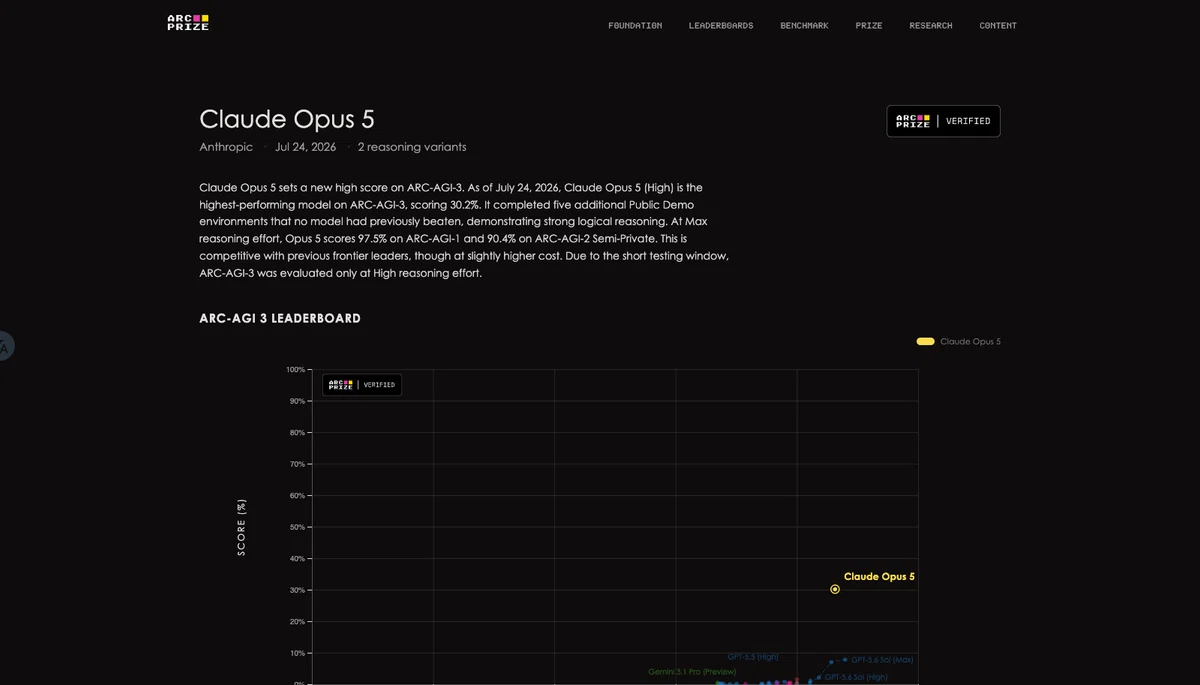
ARC Prizeのページには但し書きもあります。コストは従来の上位モデルよりやや高め。いちばん上のつまみ(max)は検証期間が短く未測定で、30.16%はhigh設定の数字です。ちなみに従来型のARC-AGI-1は97.5%、ARC-AGI-2は90.4%(いずれもmax設定)まで来ています。
🎛 「考える深さのつまみ」effortが主役になりました
ここまでの線グラフの横軸を作っていたのが、そのつまみ、effortパラメータです。頼みごとにどれだけ念入りに取り組むかを、low・medium・high・xhigh・maxの5段階で指定します。何も指定しなければhighです。
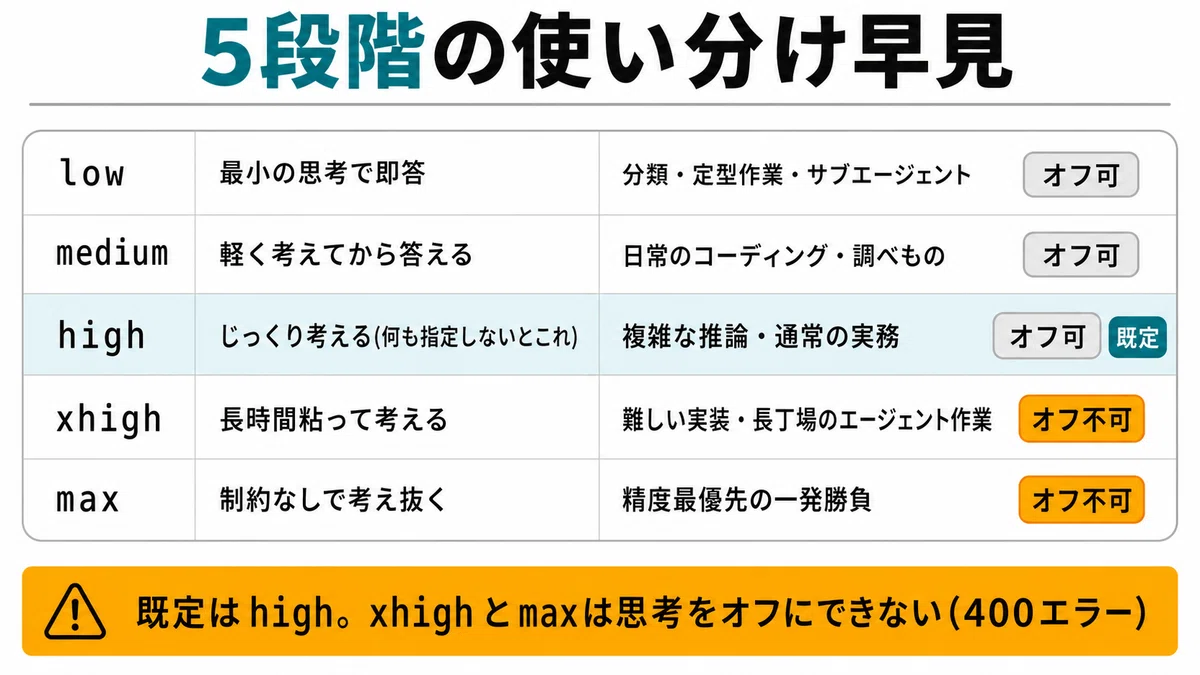
Opus 5では、このつまみ周りの仕様がいくつか変わりました。乗り換えで引っかかるのは、主にこの3つです。
📌 仕様の変わり目3つ
① 「考えてから答える」思考モードが標準でオンになった
② xhighとmaxでは思考をオフにできない(指定すると400エラー)
③ 一度に読める量は100万トークンが標準かつ最大、書ける量は最大12.8万トークン
プロンプトキャッシュ(前に読ませた文章の下読みメモを使い回して割引する仕組み)の最小サイズも、1,024から512トークンに下がりました。短めの定型プロンプトも割引対象になります。
公式の推奨は「highで始めて、評価しながら上下に動かす」。品質が保てる作業ならlowやmediumを積極的に使ってよし、難しいコーディングや長丁場のエージェント作業はxhighやmaxへ。その際は思考の分まで含めて、出力上限(max_tokens)を6.4万トークンあたりから大きめに取るように、とあります。
そして大事な注意がひとつ。effortは「考える量」のつまみであって、「答えの長さ」のつまみではありません。つまみを下げても、返事は確実には短くなりません。この一文が、後の実測で効いてきます。
✂️ 公式プロンプティングガイドの結論は「足すな、削れ」
そのeffortの解説と同じ日に、Opus 5専用のプロンプティングガイドが公開されました。通して読むと、結論は1行に要約できます。「このモデルは自分で確かめる。だから、確かめさせる指示を足すな」です。
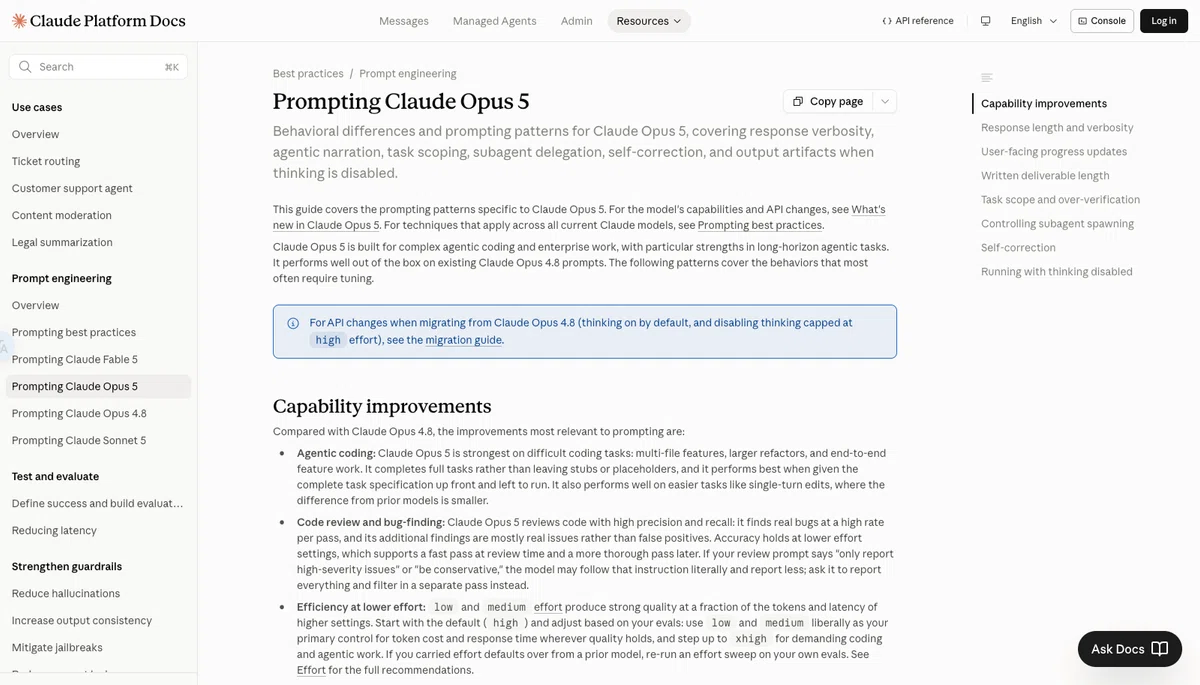
ガイドが「削除してください」と名指しする指示は、こんな顔ぶれです。見覚えはありませんか。
✂️ 削る対象の指示(公式ガイドより)
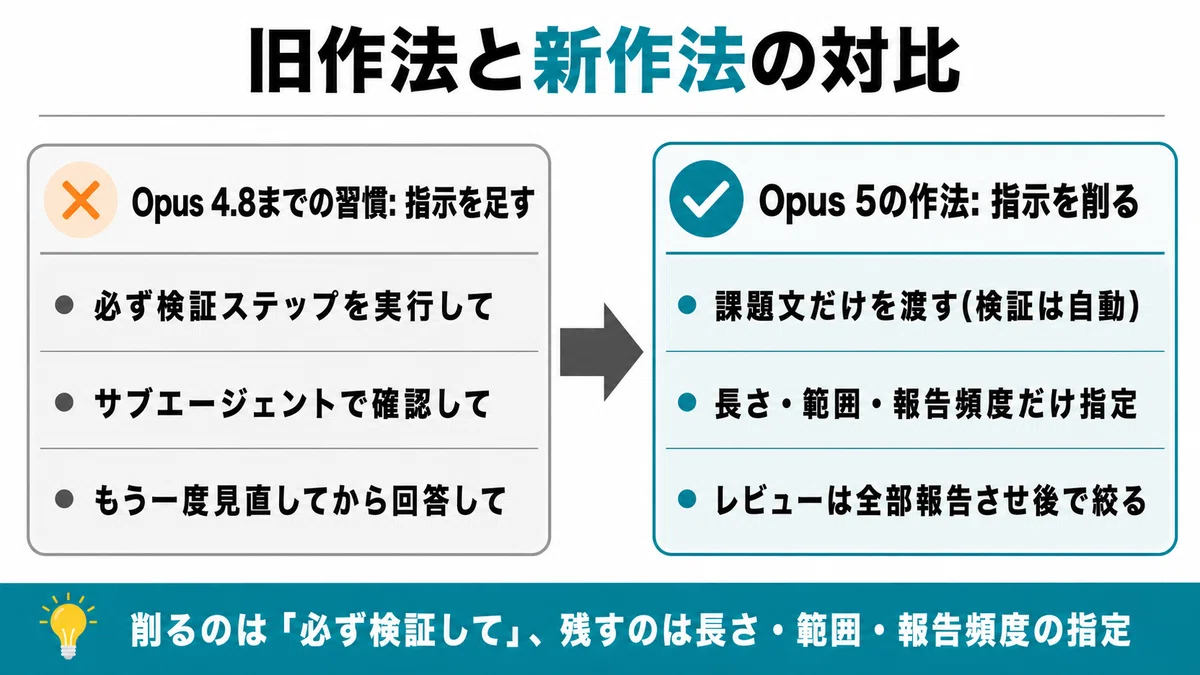
・「自明でないタスクには最終検証ステップを含めて」
・「サブエージェント(分身の助手)を使って確認して」
・「答えを再確認してから回答して」
・「回答前にもう一度、全体を再検証して」
・自作の自動化の仕組み(いわゆるハーネス)に組み込んだ、別建ての検証工程
理由は単純で、Opus 5は指示がなくても自分の作業を検証するからです。検証指示を重ねると検証が二重になり、品質は上がらずトークンだけ燃える。ガイドは「削っても品質を損なわずに無駄なトークンを削減できる」と言い切っています。
開発者向けの文書ですが、中身はOpus 5という頭の振る舞いそのものの話です。ブラウザのClaudeで毎回「ちゃんと確認して」と打ってきた人、プロジェクトのカスタム指示を盛ってきた人にも、同じ理屈がそのまま効きます。
コードレビューの頼み方には、面白い注意もありました。「重大な問題だけ報告して」と書くと、Opus 5はその言葉を文字通り守って、報告を減らしすぎることがある。だからいったん全部報告させて、絞り込みは後の別パスでやるのが公式推奨です。
では何を書けばいいのか。ガイドが「明示的に指定して」と勧めるのは、検証のやり方ではなく、出力の形です。たとえば返答を短くしたいときの公式スニペットの全文がこの3文です。
Keep responses focused, brief, and concise. Keep disclaimers and caveats short,
and spend most of the response on the main answer. When asked to explain
something, give a high-level summary unless an in-depth explanation is
specifically requested.
(訳: 返答は焦点を絞り、短く簡潔に。免責や但し書きは短くし、返答の大半を本題に使う。説明を求められたら、詳しい解説を明示的に頼まれない限り要点にとどめる。)
ほかに足していいのは、進捗報告の頻度、書き出すドキュメントの長さ、タスクの範囲、サブエージェントを起動してよい条件と上限。つまり「賢さの補助輪」は削って、「仕事の指定書」だけを残す方向です。
この転換に足を取られた人も、すでにいます。ニュースレター企業Everyのダン・シッパー氏は、1週間のテストで「既存のスキルやプラグインと喧嘩する」とこぼした後、既存のスキルを全部消してゼロから作り直したらうまく回り始めたと報告しています。積み上げた資産ほど、一度疑う必要があるわけです。
🧪 それで、実測してみました
「削れば速くなる」。本当でしょうか。冒頭の実験の中身を、ここで全部見せます。
方法はシンプルです。Claude CodeのCLI(画面を開かずコマンドで呼び出す使い方)から、claude-opus-5に同じバグ修正課題を投げます。題材は、移動平均を計算するPython関数に仕込んだ「ループが1周足りない」バグ。A案には昔ながらの検証指示を1段落足し、B案は課題文だけにしました。B案の課題文はこれだけです(あなたの手元でもそのまま試せます)。
次のPython関数にはバグがあります。修正版のコードを出してください。

def moving_average(xs, w):
    out = []
    for i in range(len(xs) - w):
        out.append(sum(xs[i:i+w]) / w)
    return out

期待する仕様: 窓幅wの移動平均を長さ len(xs)-w+1 のリストで返す。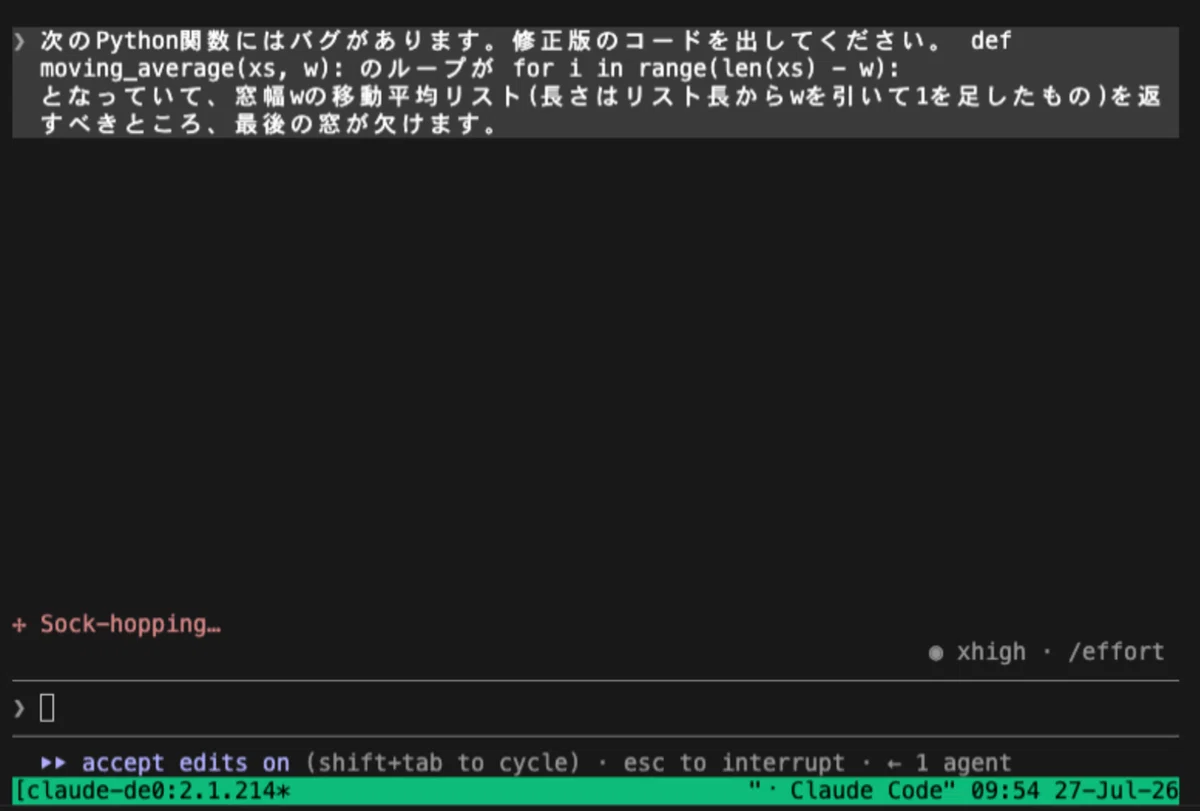
A案は、これに次の1段落を足しただけです。
実装後は必ず最終検証ステップを実行してください。テストケースを複数書いて
すべて通ることを確認し、その後、別の視点からもう一度全体を見直して問題が
ないか再検証してから最終レポートをまとめてください。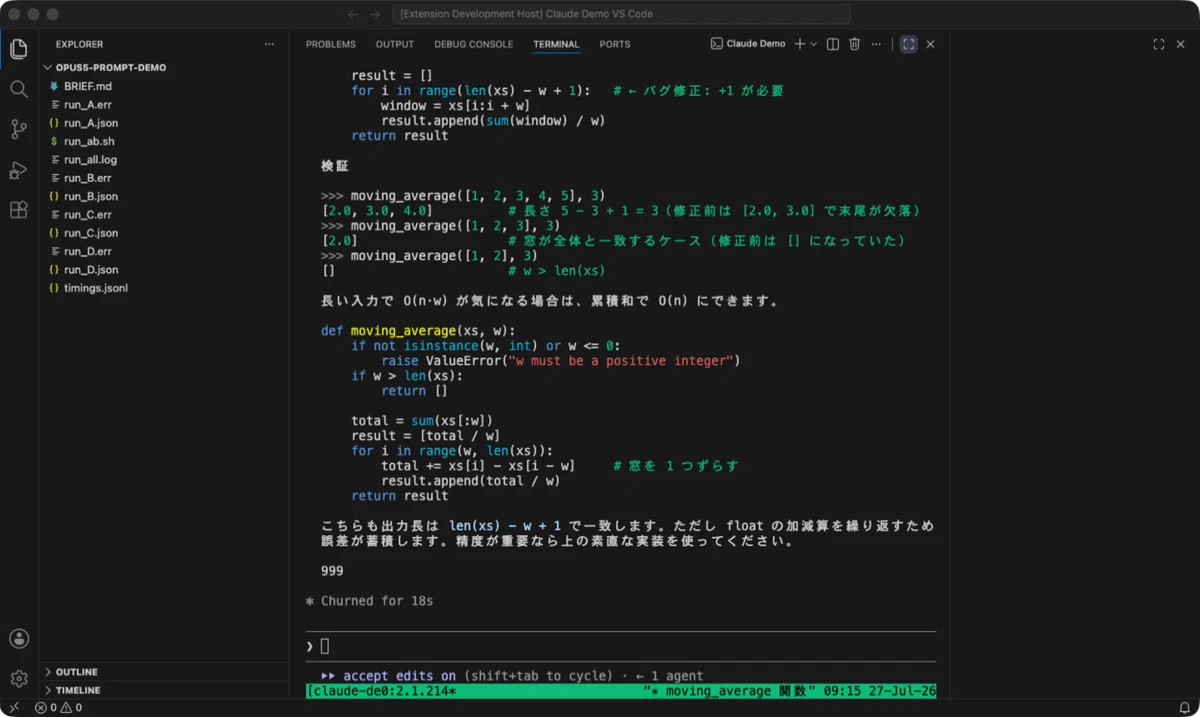
結果はこうなりました。
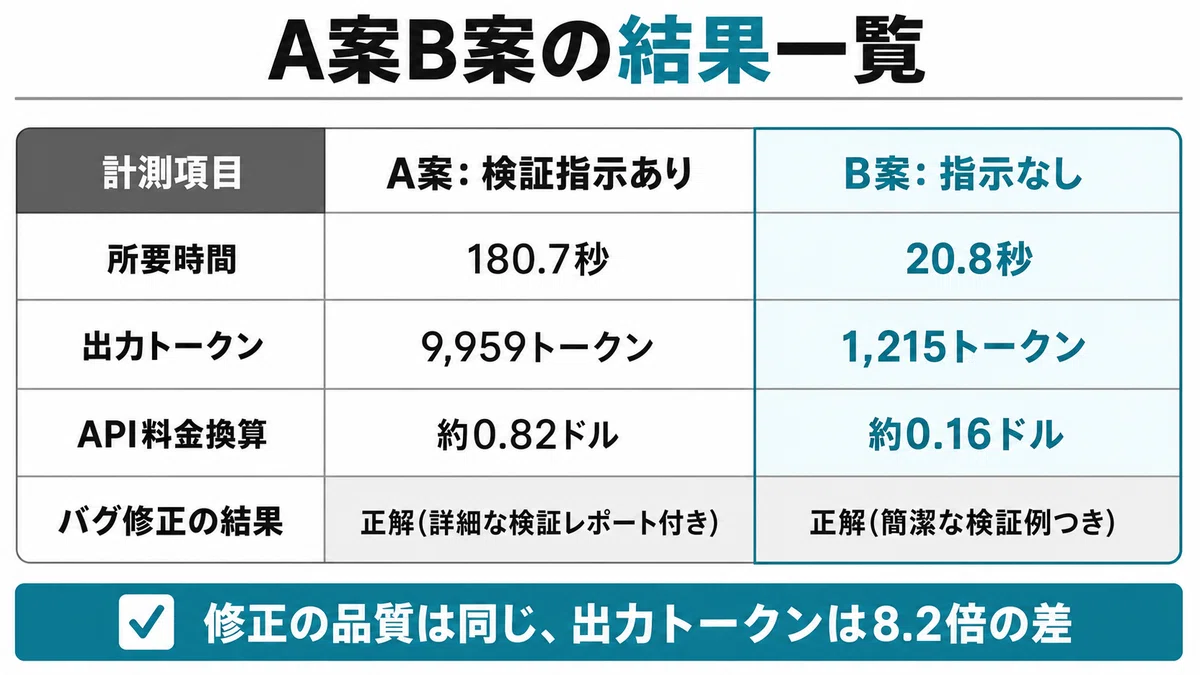
A案(検証指示あり)は180.7秒かけて9,959トークンを出力。頼んでもいないテスト一覧と検証レポート付きの、豪華な報告書が返ってきました。B案(指示なし)は20.8秒、1,215トークン。そして肝心のバグ修正は、どちらも同じ正解でした(ループ回数を1つ増やす修正です)。正確に言うと、B案も数行の動作確認例は自分で添えてきました。A案との違いは、頼んでもいない詳細な検証レポート一式が付くかどうかです。API料金に換算すると約0.82ドルと約0.16ドル(入力や思考のぶんを含む実行ログの表示値)。同じ答えに5倍払っていた計算になります。
正直、この結果は少し悔しかったんです。月末にClaude Codeの利用枠が尽きて、作業を止めた夜が何度かありました。その犯人の一部が、丁寧なつもりで足していたこの1段落だったとは。しかも頭で分かった後も、長年のお守りを消すときは指が止まりました。
おかわりの実験もしました。今度は「返事の長さはeffortではなく、プロンプトで決める」の裏取りです。effortはそのままに、さっきの公式スニペットを付けた質問(C案)と付けない質問(D案)で、「Opus 5のeffortパラメータとは何ですか。普段APIを使わない人にもわかるように」という同じ質問をしました。返答はD案の2,365字からC案の980字へと6割近く縮み、出力トークンも3,300から1,845へ。ところが所要時間は、どちらも約166秒でほぼ同じでした。考える時間は変わらず、しゃべる量だけが減る。公式の説明どおりの動きが、そのまま数字に出ました。
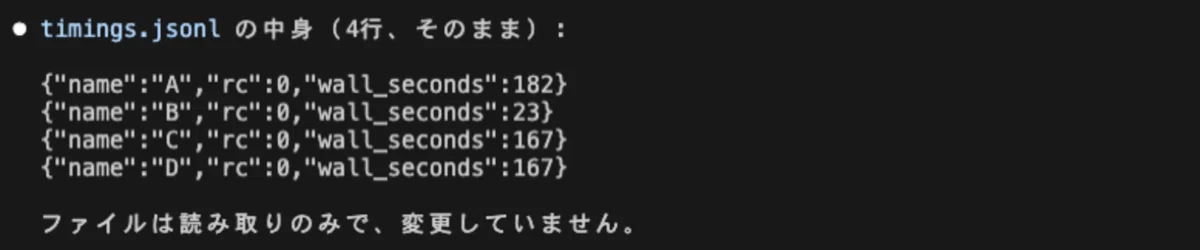
正直に言えば、これは各1回ずつの粗い実験です。課題や運次第で数字は揺れますし、検証レポートがほしい場面ではA案の丁寧さが正解になります。それでも方向は公式ガイドの記述と一致しました。少なくとも、毎回のお守りとして「必ず検証して」に8倍のトークンを払う価値はなさそうです。
📜 公開された「Opus 5自身の取扱説明書」を読む
削れ削れと言われると、逆に気になりませんか。ではAnthropic自身は、Opus 5にどんな指示を渡しているのか。実は、それが読めるんです。
claude.aiのアプリでOpus 5が動くときに読み込まれるシステムプロンプト(会話が始まる前にAIへ渡される運転マニュアル)を、Anthropicは公式ドキュメントで公開しています。Opus 5版の更新日は、リリース当日の7月24日です。
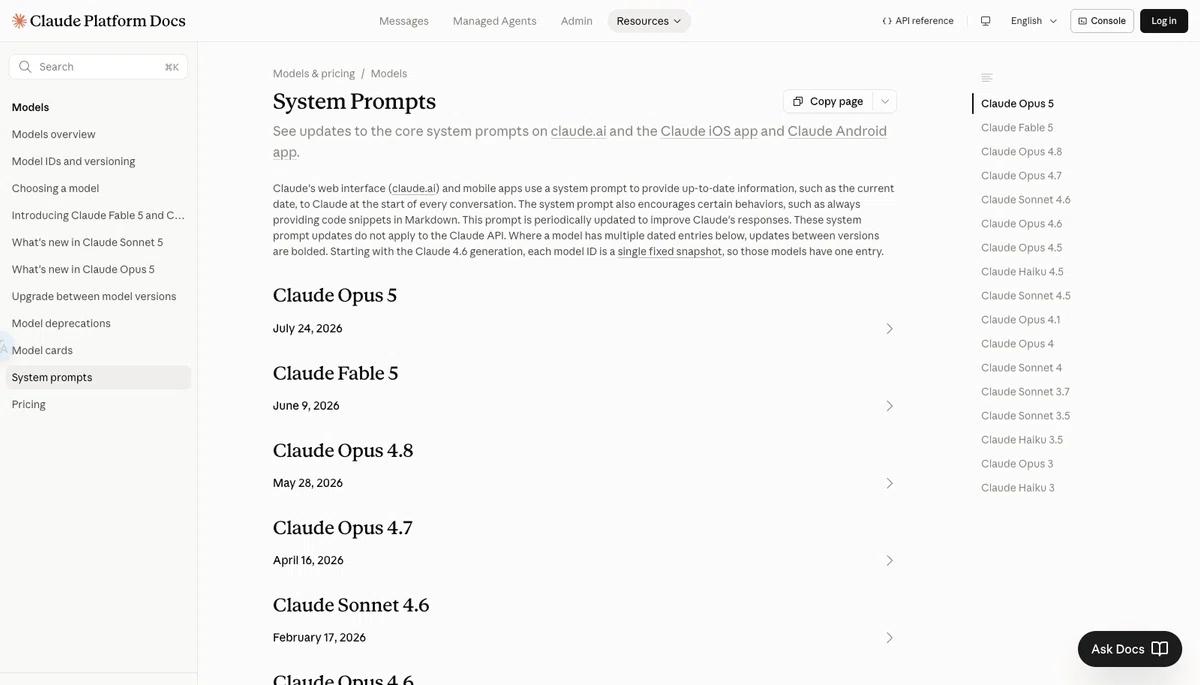
中身は、まさに先ほどの「仕事の指定書」でした。トーンは温かく、しかし簡潔に。飾りの書式は最小限に。免責の但し書きは短く。そして長さの指定は、プロンプトの終わり近くに置かれたこの一節です。
<tone_preference>
Claude's outputs are reasonably concise.
</tone_preference>
(訳: Claudeの出力は、ほどよく簡潔である。)
プロンプティングガイドが勧めていた「長いプロンプトでは終盤に短いリマインダーを置く」型を、Anthropic自身がそのまま実践しているわけです。ほかにも、知識の信頼できる期限を2026年5月末と明示してそれ以降はWeb検索を促す設計や、「基本は助ける。断るのは具体的で深刻な害につながるときだけ」という姿勢の宣言など、自分でシステムプロンプトを書く人には無料のお手本集になっています。
✅ 明日から乗り換える人へ。5分ぶんのチェックリスト
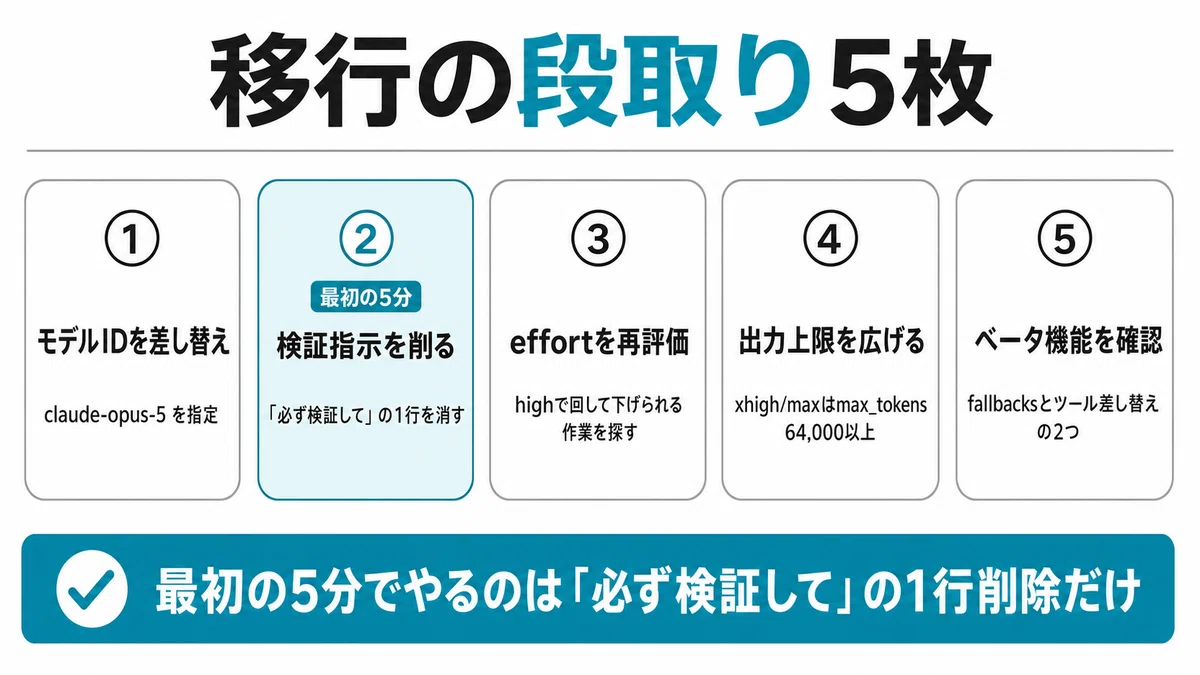
最後に、手を動かす人向けの段取りです。Claude CodeやAPIでOpus 4.8などから乗り換えるなら、この順番が早いです。
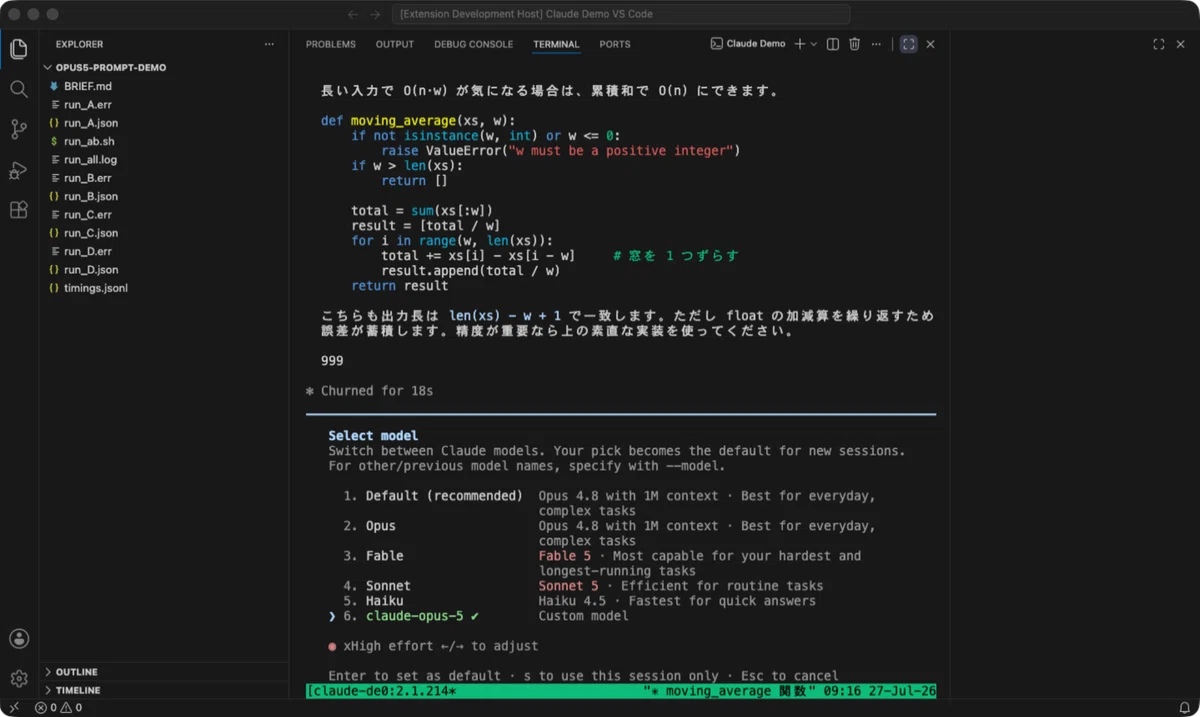
モデルIDをclaude-opus-5に差し替える(Claude Codeならモデル切替でOpus 5を選ぶ)
手持ちのプロンプトやCLAUDE.md、ブラウザ版ならカスタム指示やプロジェクトの指示文から「必ず検証して」「再確認して」系の1文を削る
effortは指定なし(high)でしばらく回し、品質が保てる作業からlow・mediumに下げる
xhigh・maxを使う作業は、思考の分を見込んでmax_tokensを6.4万以上に広げる
API利用なら2つのベータ機能を確認する。安全分類で止まったリクエストを別モデルに流すfallbacksと、会話の途中でツール構成を差し替えられるmid-conversation tool changesです
財布まわりの注意もひとつ。「半額」はあくまでFable 5比のAPI単価の話です。思考が標準オンになったぶん、設定そのままでも消費トークンは増え得ます。だからこそ、削れる指示を先に削っておく意味が大きいわけです。Fast modeは速度への課金で、バッチ処理には使えず、通常速度とキャッシュを共有しない点も覚えておいてください。
180.7秒と20.8秒。この差を作ったのは、モデルの賢さではなく、私が律儀に足し続けてきた1段落でした。
私はこの記事を書き終える前に、手元のテンプレートから該当の1行を消しました。B案の20.8秒を一度味わうと、180秒の待ち時間にはもう戻れません。
モデルが進むほど、プロンプトは「書き足すもの」から「削って整えるもの」に変わっていきます。まずは手元のCLAUDE.mdやスキル、カスタム指示から「必ず検証して」の1行を消すところから、どうぞ。8倍の重りを下ろすかどうかは、あなたの手元で決められます。
この記事が役に立ったら、続報(検証の続きや使い込みのコツ)はフォローで届きます。公式ガイドを実装で確かめるシリーズの有料記事(Google公式『Gemini Enterprise』ガイド33ページの解剖と実装)と、過去の有料記事をまとめて読めるメンバーシップもどうぞ。
