AIエージェント向けファイル(llms.txt)自動生成システム-高速かつ正確に情報処理するためのファイル-

はじめに
近年、Web上の情報を収集して自動で推論やタスクを実行するAIエージェントの開発が急速に進んでいます。
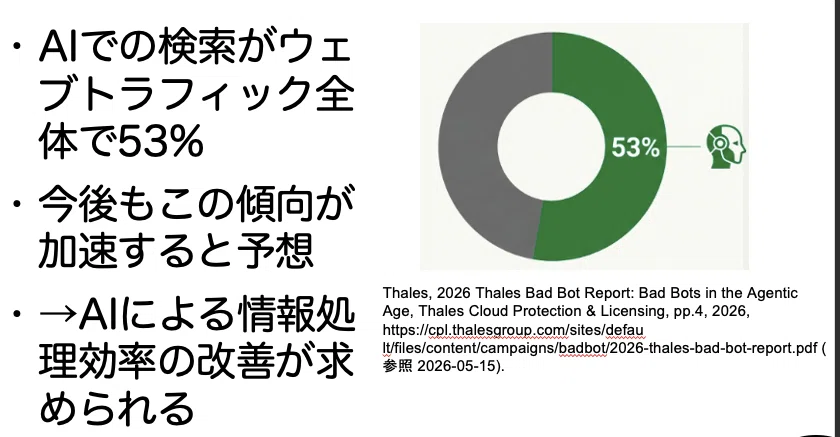
しかし、従来のWebページには、ヘッダー、フッター、広告、複雑なHTMLタグといった装飾情報が大量に含まれており、これがAIモデルに入力されるトークン量を無駄に膨れ上がらせる原因となっています。
トークン量の増大は、処理コストの上昇やレスポンスの遅延を引き起こすだけでなく、冗長な情報がノイズとなり、AIの回答精度を下げる要因にもなります。
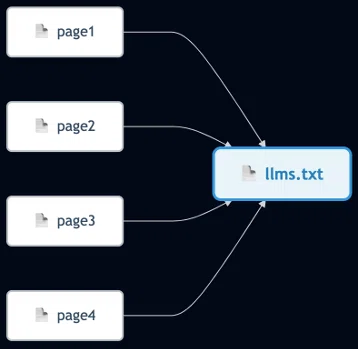
そこで注目されているのが、複数のWebページ情報を1つのシンプルなファイルに集約する提案仕様「llms.txt」や、HTML構造の最適化技術です。
本記事では、Web情報を軽量化しつつ、AIエージェントが「素早く」「正確に」処理するためのシステム設計と評価手法について考察します。
公式のllms.txt.orgと本研究・システムの違い
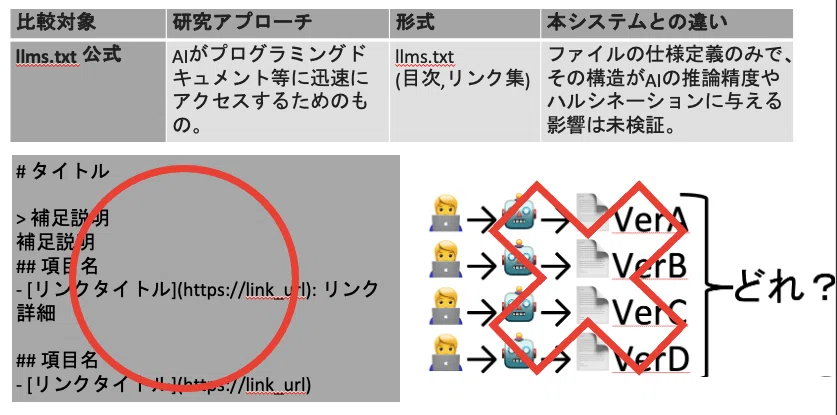
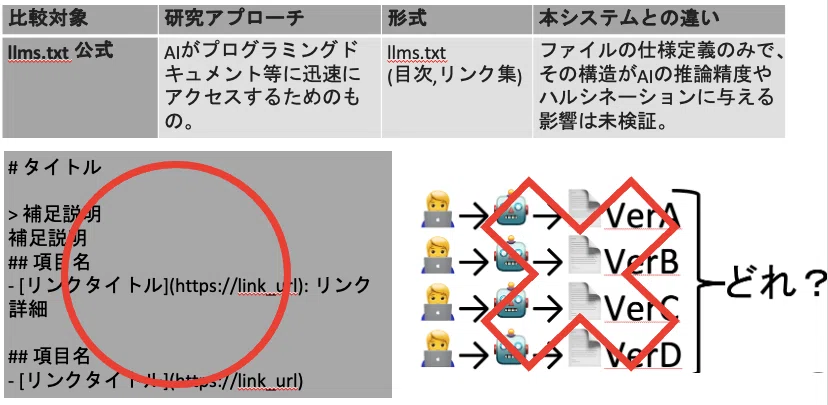
llms.txt 公式:https://llmstxt.org/
llms.txtと情報圧縮の基本概念
llms.txtとは、Webサイト上の主要なコンテンツやリンク構造を、AIが解釈しやすいMarkdown等のプレーンテキスト形式で単一のファイルにまとめたものです。
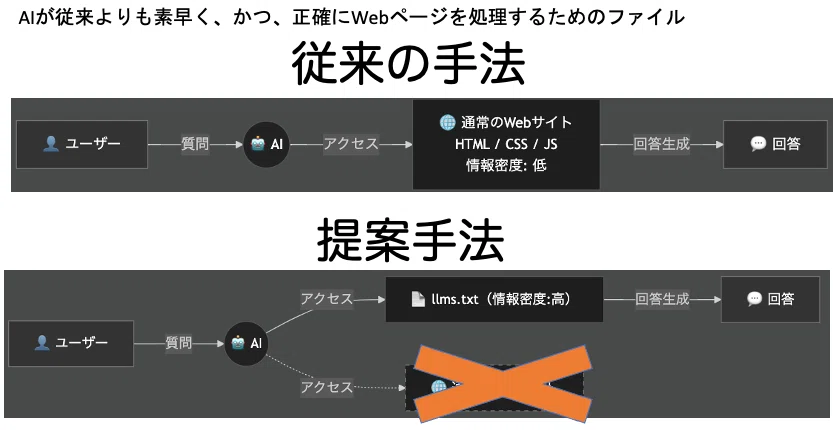
通常のWebページを取得する場合、システムは膨大なHTMLコードをそのまま読み込むか、複雑なパーサーを用いてテキストを抽出する必要があります。
これに対して、事前に最適化されたllms.txtを利用することには以下のメリットがあります。
トークン消費量の劇的な削減:装飾用HTMLやJavaScriptコードを排除し、実質的なテキストデータのみを抽出
処理スピード(応答性)の向上:入力サイズが小さくなるため、AI(ここでは、DeppResearch機能を持つ生成AIと定義しています)の処理速度が向上
コンテキストノイズの低減:サイト構造に起因する余計な文脈をカットし、モデルが必要な回答に集中できる環境を提示
パフォーマンス評価指標:正解率とトークン量のトレードオフ
Webページの軽量化(Markdown変換やHTML圧縮)を進めるシステムフローを構築するにあたり、単にデータを削れば良いというわけではありません。
極端な切り捨てを行うと、本来含まれていた文脈や重要なデータまで失われ、AIの回答精度が落ちてしまうリスクがあるためです。
評価システムにおいて定義すべきコア指標は以下の2点です。
1. トークン量(コスト・速度指標)
システムに入力されるテキストの総トークン数を計測します。この数値が小さければ小さいほど、APIコストが下がり、レスポンス速度(素早さ)が向上するため「優秀」と判定されます。
2. 回答の正解率(精度指標)
テスト用の質問セットを用意し、圧縮前のWebデータと圧縮後(llms.txt等)のWebデータから得られたAIの回答内容を比較します。どれだけ正確に元の情報を理解・保持できているかをパーセンテージ等で測定します。
システム開発においては、「トークン消費量を最小限に抑えつつ、正解率を維持・最大化できる変換アルゴリズム」のポイントを特定することが最も重要な研究課題となります。
実装に向けたシステムフローの検討
実際の処理フローとしては、下記です。
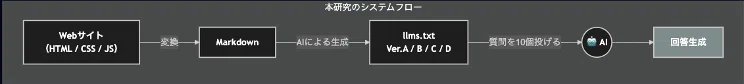
データ取得:対象WebサイトのHTMLを取得
前処理・変換:不要タグの除去、テキストのMarkdown化、したものをllms.txt形式への統合。この際、Google Gemini Flash Lite 2.5のAPIを使用しています。Markdown化する際は、JinaReaderというMarkdown変換ソフトを使用します。
AIへ質問:対象ウェブサイトの内容を正しく理解できているかを知るため、llms.txtを読み込んだAIに質問をいくつか投げます。
評価タスク実行:正確性と処理時間をログ出力し、成長率および削減率をリアルタイムで計測
このように、データ構造の最適化を繰り返し検証することで、AIエージェントにとって最も効率的な情報流通の形を模索することができます。
結果
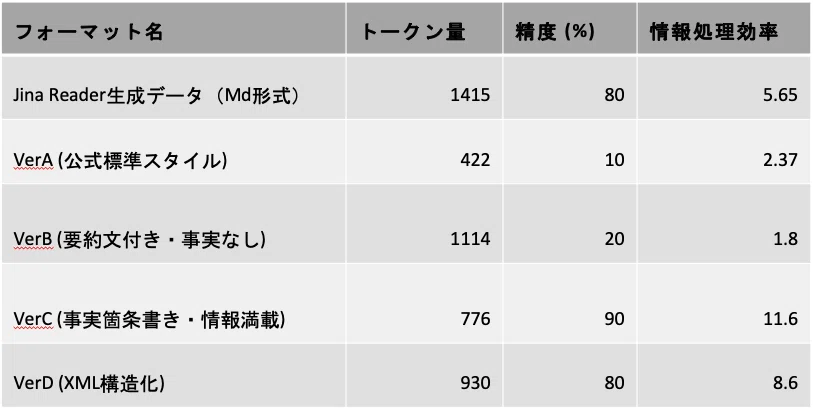
もっとも、VerCが情報
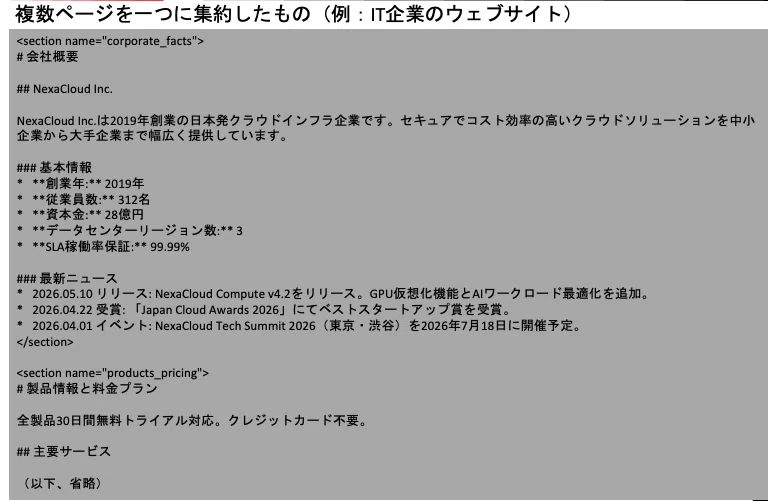
VerCの内容
今後の展望
まだ、現状では、結構自分の研究内容の領域は狭いです。実験の幅というか、ウェブサイトの幅が狭いです。そのため、この問題を解決するために、いろいろなウェブページを利用して行きながら楽しめたらなと思います。具体的には、質問おかずを増やす、Webページの数を増やすということをしたいです。
まとめ:Web情報の未来とAIの最適化
Webサイトの構造をAI親和性の高い形へと自動変換する技術は、AIエージェントが自律的に動く現代において不可欠な技術です。
今後も、精度の正解率と処理のスピードの両立を目指し、最適なデータ圧縮の手法を実験・検証していきます。
関連ハッシュタグ
#AIエージェント #llms .txt #LLM #トークン削減 #プロンプトエンジニアリング #Web最適化 #データ圧縮 #生成AI #研究開発 #技術考察 #卒論 #卒研
