中国のAIエージェントQwen Codeで、Ryzen AI MaxのローカルLLM環境を構築する 【ニコ技深圳フィールドノート】

前回は、Ryzen AI Max+ 395、メモリ128GBのWindows PCを、深圳オフィスのローカルAI端末として使う方針を検討した。
今回は実際に、中国国内からVPNなしで利用できるQwen Codeを構築エージェントとして使い、Windowsの監査、モデル取得、Ollamaへの登録、GPU動作確認、バックエンド比較まで進めた。
単にQwenを動かしたという話ではない。今回のポイントは、ローカルAI環境そのものを、中国のクラウドAIエージェントに構築させたことにある。
なぜQwen Codeを使ったのか
CodexやClaude Codeも強力だが、中国国内のPCで常用する場合、接続環境が不安定になりやすい。
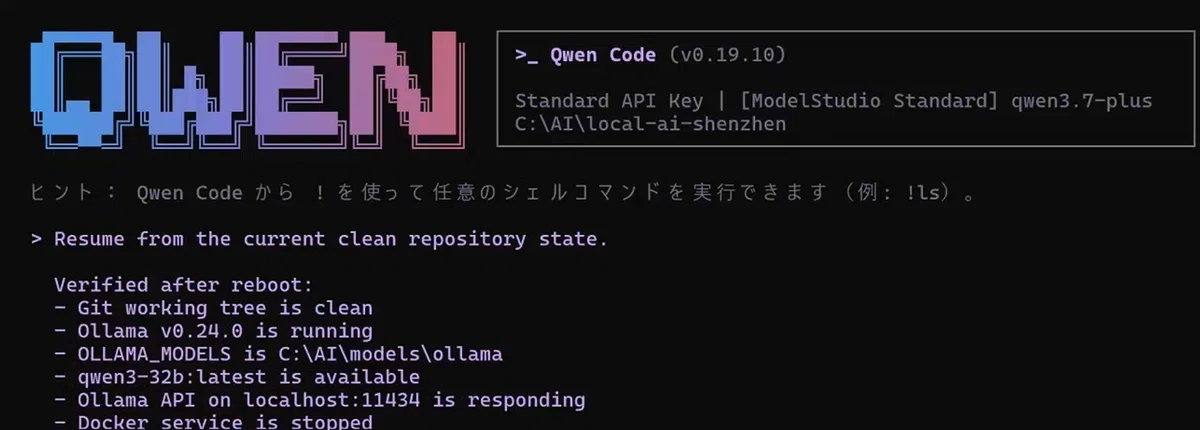
Qwen CodeはAlibaba ModelStudioに直接接続でき、中国国内からVPNなしで利用できる。ターミナル型のAIエージェントなので、質問に答えるだけでなく、ローカルのファイルを読み書きし、PowerShellを実行し、Gitで変更履歴を残せる。
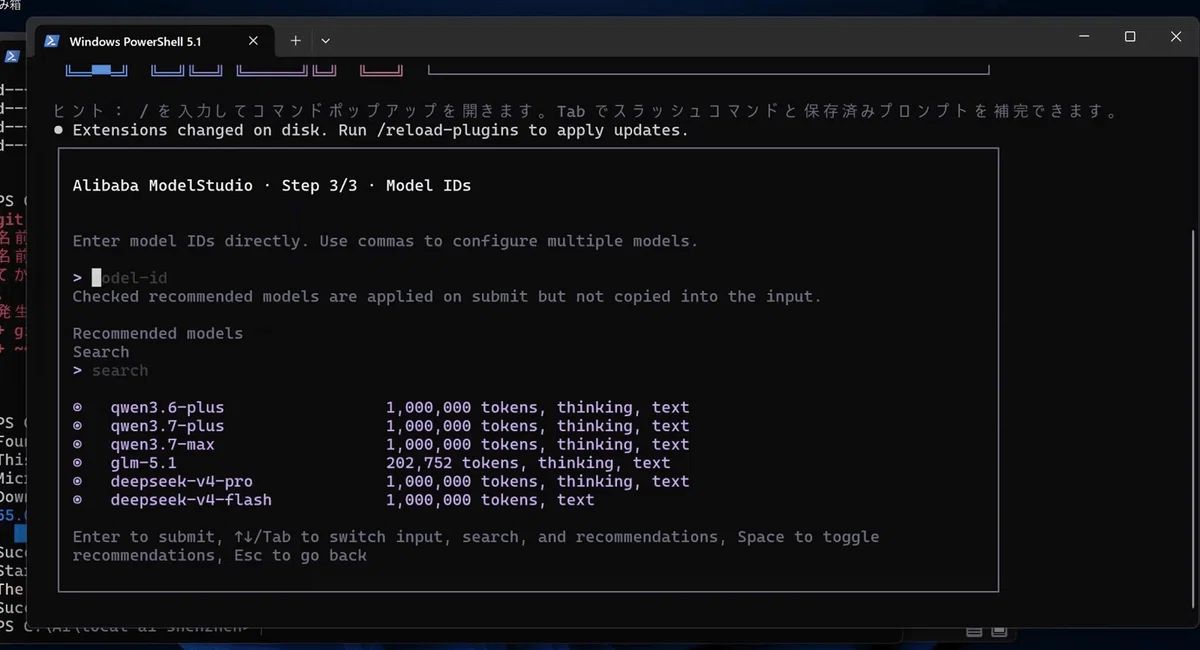
今回使ったモデルはqwen3.7-plus。Qwen Codeの実行前には、変更やコマンド実行のたびに確認するモードを有効にした。
日本語でシェルやファイル名を作ると、Windows、文字コード、ターミナル間のコピーで問題が起きやすい。そのため、Qwen Codeへの指示、スクリプト、コメント、ファイル名は英語とASCIIに統一した。
Project root:
C:\AI\local-ai-shenzhen

Rules:
- Work and report in English
- Use English and ASCII in scripts and console output
- Keep approval prompts enabled
- Do not use automatic approval
- Do not install or modify system settings without approval
最初にPCを監査させる
いきなりソフトを大量に入れるのではなく、まずQwen Codeに読み取り専用の監査スクリプトを作らせた。
作成されたリポジトリは次のような構成になった。
C:\AI\local-ai-shenzhen\
├─ scripts\
│  ├─ 00-audit.ps1
│  ├─ smoke-test.ps1
│  └─ smoke-test-qwen3.ps1
├─ reports\
│  ├─ audit.json
│  └─ audit.md
├─ docs\
│  ├─ architecture.md
│  ├─ setup-plan.md
│  └─ backend-benchmark.md
├─ TASKS.md
└─ .gitignore
00-audit.ps1では、Windows、CPU、GPU、メモリ、ディスク、AMDドライバ、WSL、Docker、Python、Git、Node.js、待受ポートなどを確認した。
ここで、対象PCの構成は次のように整理された。
OS: Windows 11
CPU: AMD Ryzen AI Max+ 395
GPU: AMD Radeon 8060S
GPU architecture: gfx1151
Memory: 128 GB unified memory
GPU allocation: 96 GB
Storage: Internal 2 TB SSD
途中でDocker Desktopを起動した際にWindowsごと落ちたため、DockerとWSLは一旦保留した。Qwen Codeには構成を修正させ、WindowsネイティブのOllamaとllama.cppから始める方針に変更した。
ここまでの監査で、DockerやWSLを前提にせず、WindowsネイティブのOllamaとllama.cppから始める方針が決まった。
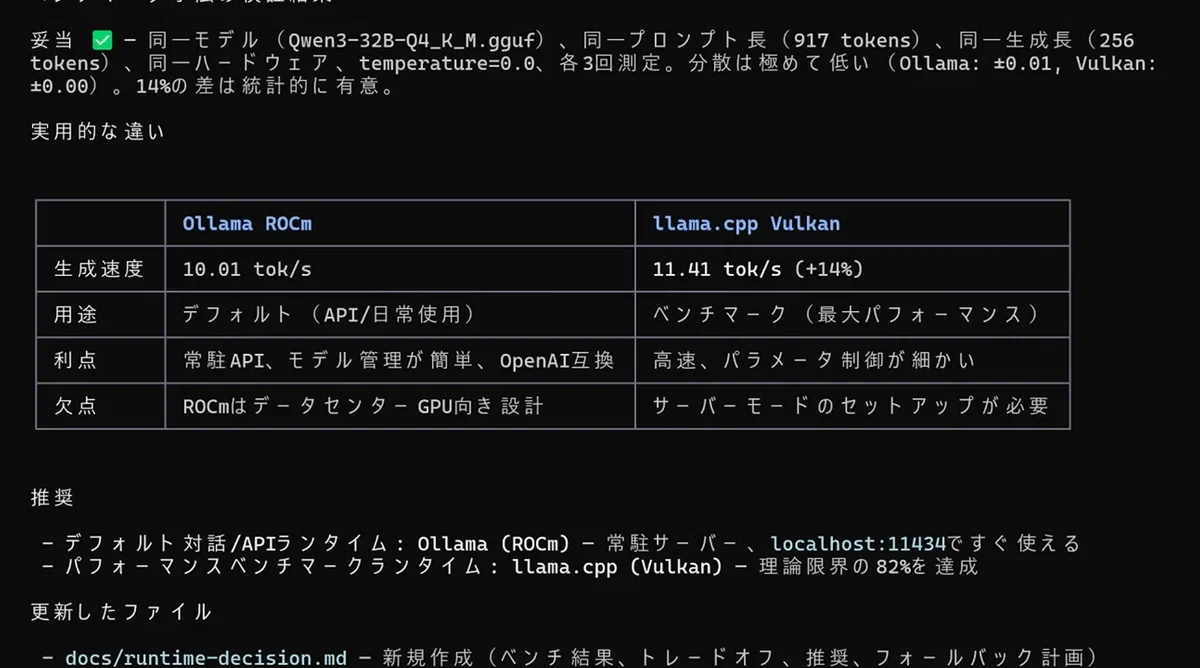
最終的にはQwen3-32B Q4_K_MをRadeon 8060S上で100% GPU動作させ、Ollama ROCmで10.01 tok/s、llama.cpp Vulkanで11.41 tok/sを確認できた。
ここから先では、ModelScopeからのモデル取得、Ollamaへの登録、ベンチマークスクリプト、Qwen Codeに与えた具体的な指示を紹介する。こうした予定変更まで、設計文書とTASKS.mdに残せるのは、チャットだけのAIよりコードエージェントが便利な点だ。
中国ではModelScopeからモデルを取得する
推論ランタイムにはWindows版Ollamaを使った。Ollama自体は中国製ではないが、ここはモデルを実行するためのランタイムにすぎない。
実際に使うモデルはQwenで、取得元には中国国内で高速にアクセスできるModelScopeを使う。
modelscope download `
  --model Qwen/Qwen3-32B-GGUF `
  --include "qwen3-32b-q4_k_m.gguf" `
  --local_dir C:\AI\models\gguf\qwen3-32b
今回ダウンロードしたのは、Qwen3-32B-InstructのQ4_K_M量子化版。ファイルサイズは約18.4GBだった。
ModelScopeからのダウンロード速度はおよそ2~3MB/sで、約2時間かかった。海外のモデル配布サイトを経由するより、中国国内では安定していた。
ダウンロードしたGGUFは、Modelfileを作ってOllamaへ登録した。
FROM C:\AI\models\gguf\qwen3-32b\qwen3-32b-q4_k_m.gguf

PARAMETER num_ctx 8192
ollama create qwen3-32b -f .\Modelfileこの構成では、モデルの取得はModelScope、モデルの実行とAPI提供はOllamaが担当する。
ModelScope
    |
    | GGUF download
    v
C:\AI\models\gguf
    |
    | Modelfile import
    v
Ollama
    |
    | localhost:11434
    v
Local applications
Radeon 8060Sで100% GPU動作
NAME                SIZE     PROCESSOR    CONTEXT
qwen3-32b:latest    22 GB    100% GPU     8192
最初の短いスモークテストでは、生成速度が2.74 tokens/secと表示された。しかし、この測定は出力が50 tokensしかなく、初期化時間の影響が大きかった。
そこでQwen Codeに、ウォームアップ、複数回実行、固定プロンプト、256 tokens以上の出力を含むベンチマークスクリプトを作らせた。
その結果は次のようになった。
Qwen Codeを使ってよかった点
今回、Qwen Codeが特に便利だったのは、個々のコマンドを生成したことではない。
PCを監査して現在の状態を文書化する
危険な操作の前に確認を求める
Dockerで問題が起きたら設計を変更する
ModelScopeからモデルを取得する
PowerShellのテストスクリプトを作る
ベンチマーク条件を揃える
結果をMarkdownへまとめる
Git(ローカルのGit)へコミットする
という一連の作業を、同じリポジトリの中で継続できたことが大きい。
最終的なGit履歴には、監査、Ollama導入、モデル登録、スモークテスト、バックエンド比較が別々のコミットとして残った。
Initial project setup
Ollama and ModelScope smoke test
Qwen3-32B benchmark
Ollama ROCm benchmark
llama.cpp Vulkan comparison
今回できた環境
現時点の構成は次のようになった。
Windows 11
├─ Qwen Code
│  └─ Alibaba ModelStudio / qwen3.7-plus
├─ ModelScope CLI
│  └─ Qwen3-32B GGUF download
├─ Ollama 0.24.0
│  └─ ROCm/HIP / 100% GPU
├─ llama.cpp
│  └─ Vulkan benchmark
└─ Git repository
   ├─ Audit scripts
   ├─ Smoke tests
   ├─ Benchmark scripts
   └─ Architecture documents
Ryzen AI Max+ 395と128GBメモリの構成では、32Bモデルをロードすること自体には余裕がある。Qwen3-32B Q4_K_Mは約22GBで動作し、96GBのGPU割当の一部しか使っていない。
一方、Dense 32Bモデルの生成速度は約10~11 tokens/secだった。対話用途でも使えるが、クラウドAIのような即応性ではない。今後は、総パラメータ数が大きくても毎回使うパラメータが少ないMoEモデルも試す予定だ。
ModelScope公式アカウントからの返信
この記事の準備中、ModelScope公式アカウントから反応があった。
Hi! we also have an international site for global users: https://t.co/Qdy035K8EB
— ModelScope (@ModelScope2022) July 16, 2026
この「フィールドノート」では、深圳ほかの技術現場で実際に試したことを、完成した結論だけでなく、途中の判断や失敗も含めて記録している。内容によっては、まだ自分の中で十分に整理しきれていない情報や、継続検証中の仮説も扱う。そのため普段は、一部を有料にして、限られた読者に向けて公開している。
一方、今回は、中国国内でQwen CodeとModelScopeを使い、Windows上にローカルLLM環境を構築する具体的な事例である。ModelScope公式からも反応があり、同じ環境を試す技術者にとって再現性のある情報として役立つ可能性が高い。公益性を優先し、コマンドやベンチマーク条件を含めて全文無料で公開することにした。
この記録が、ModelScopeやQwen、AMD GPUを使った別の検証につながればうれしい。次回は、この端末を深圳オフィスに置いたまま、Alibaba Cloud Session Manager経由で外出先から安全に利用する方法を扱う。
ここから先は
深セン・Mass Innovation フィールドノート
整理がついたものは記事やレポートとして公開していますが、 ここではその前段階――現場で見たことや考えたことを共有します。 深センを中心に…
最後まで読んでいただき、ありがとうございます。 深圳ほかアジアで見たものをシェアするマガジンをやっています。
