Photoshopで荒らしても見破られる:OpenAIのSynthID統合と、画像 provenanceの30年遅れの宿題

2026年5月19日(現地時間)、OpenAIが大きな発表を行いました。ChatGPTやAPIで生成される画像に、Googleの不可視ウォーターマーク「SynthID」が統合され、同時に「Verify」と呼ばれる無料の検証ツールが公開されたのです。
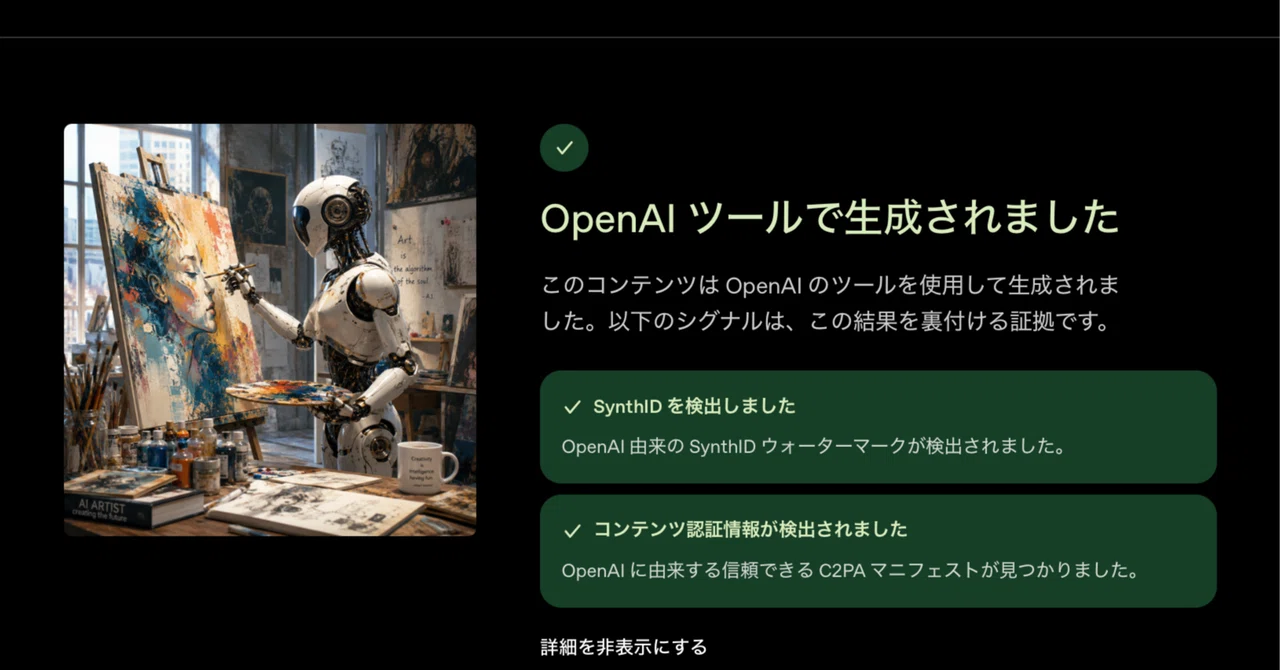
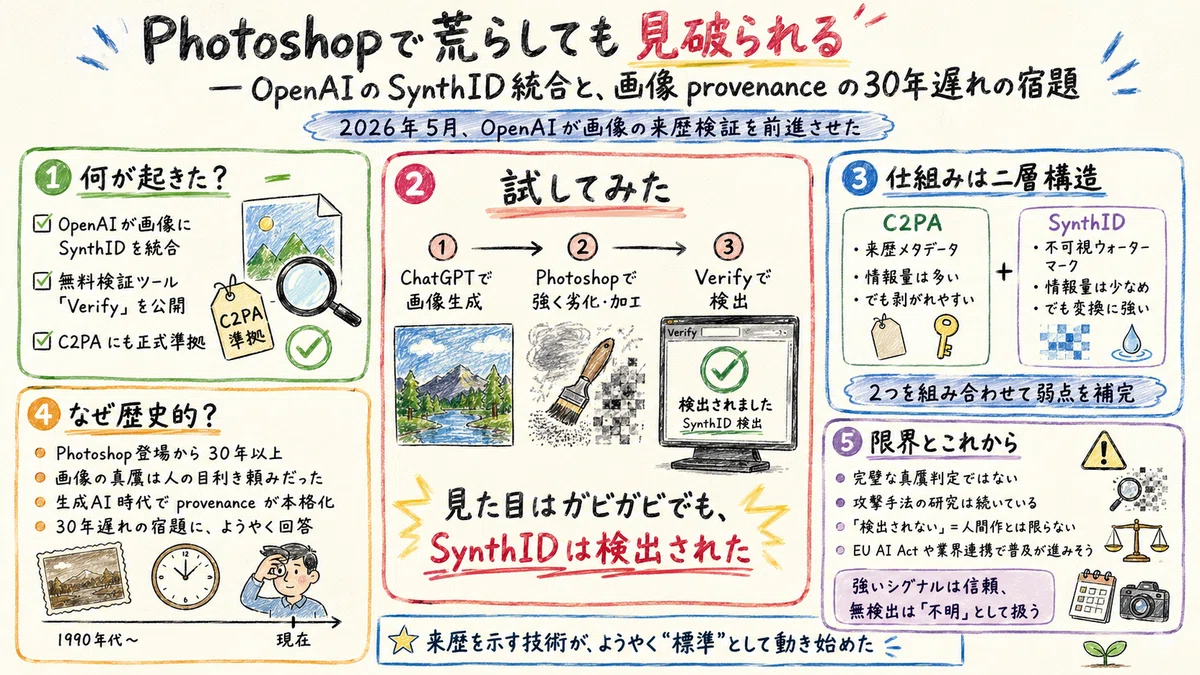
この発表を見て、自分は試したくなりました。ChatGPTで画像を生成し、Verifyツールに投げてみる。当然「OpenAIツールで生成されました」と判定されます。では、画像編集ソフトでガビガビに荒らしたらどうなるのか。試してみました。結果は、人間の目には明らかに劣化しているのに、Verifyツールは涼しい顔で「SynthIDを検出しました」と返してくる。何度試しても結果は同じでした。
これは、地味だけれども歴史的な瞬間です。なぜなら、画像編集ソフトウェアが普及してから30年以上、業界は「これは加工された画像か」「誰が作ったのか」を技術的に判別する仕組みを、ほとんど何も提供してこなかったからです。今、その状況がようやく変わり始めました。
1. 「これはAIが作りました」を技術的に証明する仕組みが動き出した
OpenAIの発表内容は、大きく分けて2つの要素で構成されています。
ひとつは、C2PA(Coalition for Content Provenance and Authenticity)という国際標準への正式準拠です。C2PAは画像ファイルに暗号署名つきのメタデータを埋め込む規格で、Adobe、Microsoft、BBCなどが共同で策定しています。OpenAIはこの規格に「Conforming Generator」として認証され、ChatGPT、Codex、APIで生成される画像にはC2PAマニフェストが自動的に付与されるようになりました。
もうひとつが、Google DeepMindのSynthIDの採用です。SynthIDは画像のピクセル領域に不可視のパターンを埋め込む技術で、これまでGeminiやImagenなど、Google系の画像生成サービスで使われてきました。OpenAIがGoogleと連携してこの技術を取り込んだ形になります。
そして、誰でも使える検証ツール「Verify」が公開されました。openai.com/verifyにアクセスし、画像をアップロードすると、C2PAメタデータの有無とSynthIDの有無を即座に判定してくれます。OpenAI製コンテンツに限定された機能ですが、将来的なクロス業界対応も計画されているとのことです。
この発表が画期的なのは、OpenAIがC2PAという共通のprovenance標準に準拠しつつ、Google DeepMindのSynthIDを不可視ウォーターマークとして採用した点です。これまで各社がバラバラに独自実装で動いていた provenance(来歴)の領域に、業界標準とGoogle由来の技術が組み合わさった具体的な実装例が現れたわけです。
🔗C2PA in ChatGPT Images | OpenAI Help Center
2. 30年遅れの宿題:なぜ Photoshop 時代にはなかったのか
ここで一度立ち止まって考えたいのは、なぜこれが「歴史的」と感じるのかという点です。
Photoshopが1990年に登場してから30年以上、デジタル画像編集は急速に普及してきました。SNSが当たり前になり、誰もが画像を加工して共有する時代になりました。その間、政治家の修整画像、ニュース報道での画像差し替え、商業写真のレタッチ、合成画像の真贋論争など、画像の真正性をめぐる議論は絶えず繰り返されてきました。
それでも、画像編集ソフトウェアの主要なベンダーは、「これは加工された」「これは元画像」を技術的に区別する仕組みを、ソフトウェアに組み込むことを、長らくしてきませんでした。撮影機器メーカーには、CanonのData Verification KitやNikonのImage Authentication Systemのように、報道現場での画像真正性確認を目的とした独自ツールが存在した時期はあります。ただし、これらは一部のプロ向け機器に限定されたソリューションで、業界共通の標準にはなりませんでした。誰がいつどう編集したかを記録し、改ざんを検知できるようにする技術的な余地は当然あったはずですが、それが業界横断の標準として動き出すには、2021年のC2PA発足を待つことになりました。
その結果、画像の真贋判定は何に頼ることになったかというと、結局のところ人間の「目利き」と、ファクトチェック組織の人手による検証でした。技術が便利になればなるほど、人間側のリテラシーと労働力に依存する構造が強まっていったのです。
なぜ今になって動き出したのか。直接的なきっかけはもちろん生成AIの登場です。本物と見分けがつかない画像が誰でも数秒で作れる時代になり、人間の目利きだけでは追いつかなくなりました。EU AI ActやアメリカのCOPIED Actといった規制の動きも、業界の重い腰を上げさせています。
つまり、SynthIDとC2PAの統合は、生成AIへの対応であると同時に、デジタル画像編集が30年間ずっと先送りしてきた宿題への、ようやくの回答でもあるのです。
🔗OpenAI Joins C2PA Steering Committee
3. 二層構造の妙:メタデータと不可視透かしが補い合う設計
OpenAIの統合方式で技術的に興味深いのは、C2PAとSynthIDという性質の異なる2つの仕組みを組み合わせている点です。
C2PAはメタデータ層です。画像ファイルに付随するC2PAマニフェスト/メタデータとして、暗号署名された情報を埋め込みます。「誰が署名したか」「どのツール由来か」「生成・編集に関する情報」など、実装が開示する範囲の来歴情報を記録できます。改ざんがあれば署名検証で検出できますし、編集履歴も含められる仕組みになっています。
ただしC2PAには大きな弱点があります。メタデータは簡単に剥がれてしまうのです。スクリーンショットを撮ればもちろん消えますし、画像編集ソフトで再保存しただけでも消える場合があります。SNSの多くは画像アップロード時に独自の再エンコードをかけるため、その過程でも失われます。実際、自分が試したときも、画像を一度別形式に変換しただけでC2PAは消えていました。
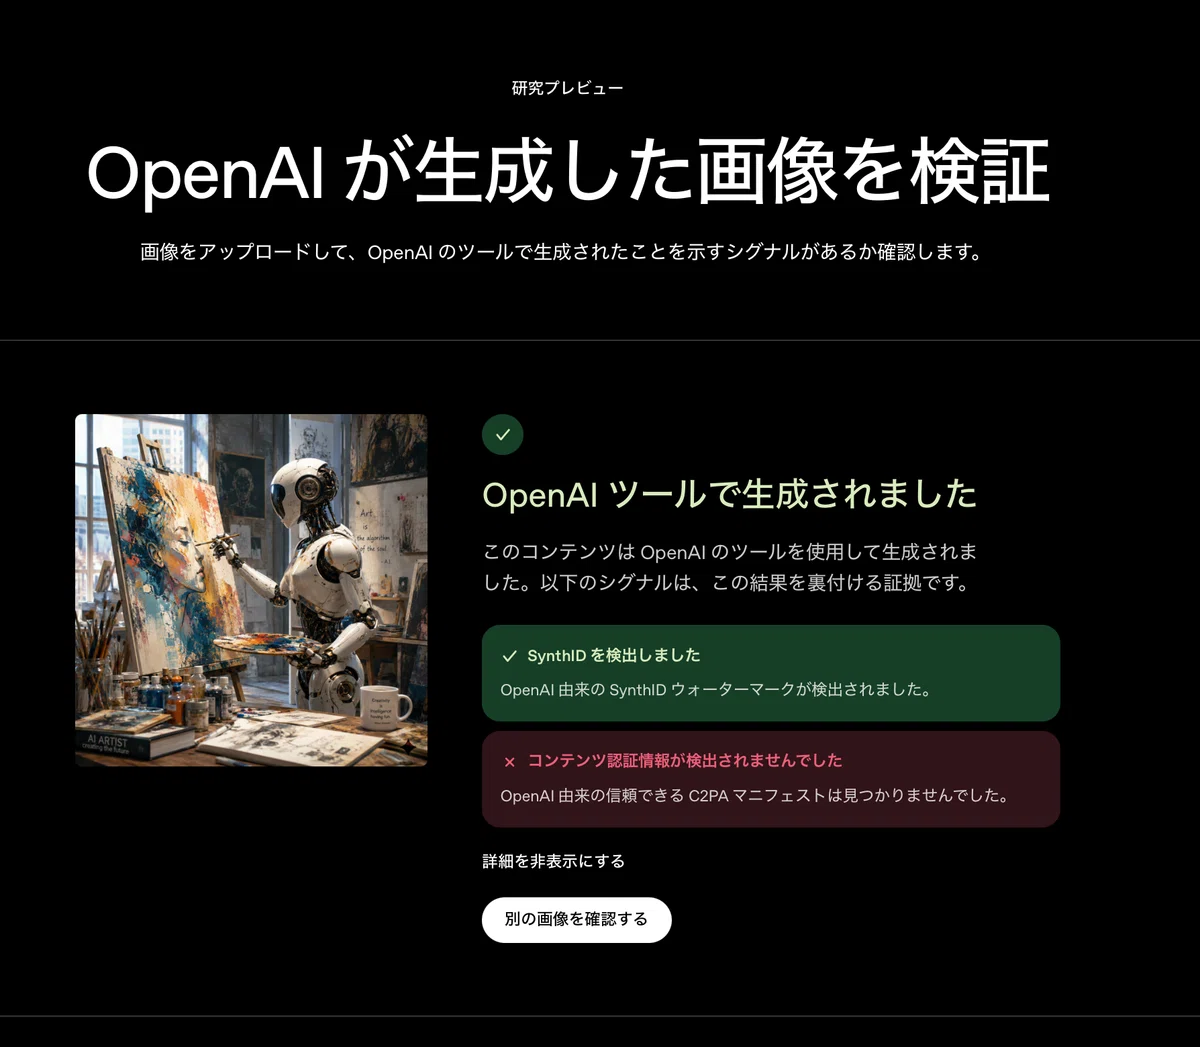
そこでSynthIDが補完役として登場します。これはピクセル領域に直接、人間の目には見えないパターンを埋め込む技術です。SynthID-Image論文で評価された外部提供版「SynthID-O」では、512×512画像に136ビットのペイロードを符号化できると説明されており、スクリーンショット、リサイズ、JPEG圧縮、色調補正など、多くの変換に対して耐性があります。情報量は限られますが、画像変換を経ても生き残る確率が高い設計です。なお、OpenAI統合版のSynthIDが論文記載のSynthID-Oと同一のペイロード仕様かどうかは、現時点の公開情報からは断定できません。
つまり、C2PAは「情報量は豊富だが脆い」、SynthIDは「情報量は限定的だが堅牢」という補完関係になっています。両方を併用することで、どちらかが失われてももう一方が来歴のシグナルを残せる、という設計思想です。
冒頭で書いたPhotoshop実験は、まさにこのSynthIDの堅牢性を体感したものでした。明らかに劣化した画像でも、ピクセルレベルで分散した透かしは生き残っていたわけです。
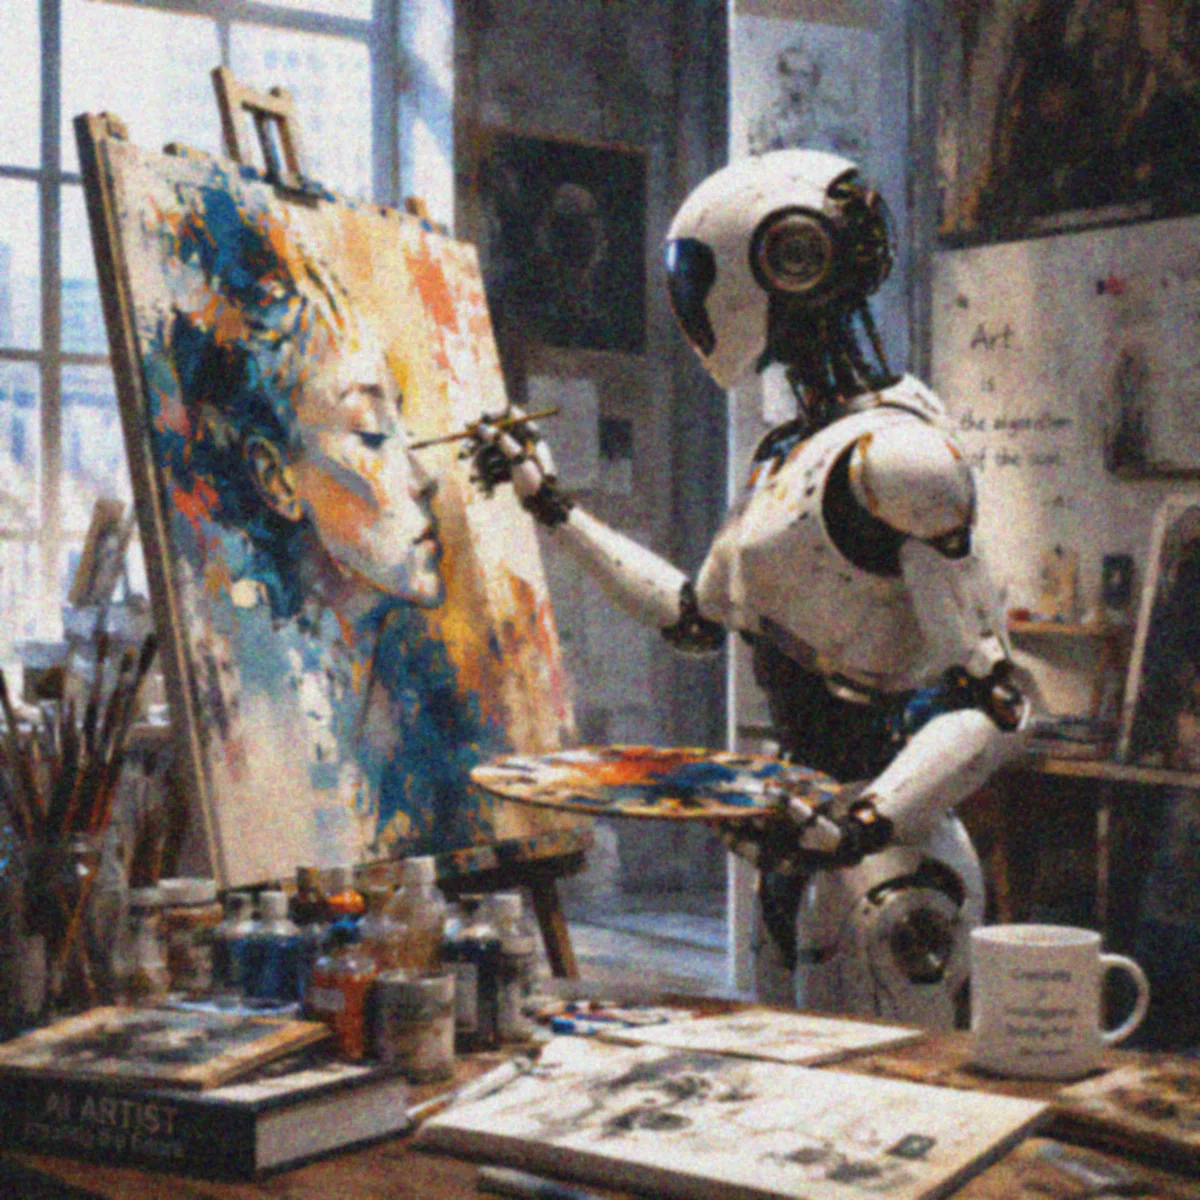
これ以上やると原型がなくなるので本末転倒です🙃
4. 完璧ではない:学術研究とリテラシー
ここまで好意的に紹介してきましたが、この仕組みは決して完璧ではありません。
学術研究の世界では、SynthIDのようなウォーターマーキング技術への攻撃手法が、すでに複数の論文として発表されています。たとえば、ウォータールー大学の研究者らが2025年のIEEE Symposium on Security and Privacyで発表した論文では、SynthIDを含む複数のウォーターマーク方式に対する汎用攻撃手法が議論されています。Googleはこの論文が主張する成功率の数値については反論していますが、攻撃の余地が原理的に存在することは、研究コミュニティの共通認識になっています。
ピクセル領域に埋め込まれた信号は、十分に複雑な画像変換を通せば破壊できる、という構造的な事実があります。攻撃と防御のいたちごっこは、今後も続いていくでしょう。
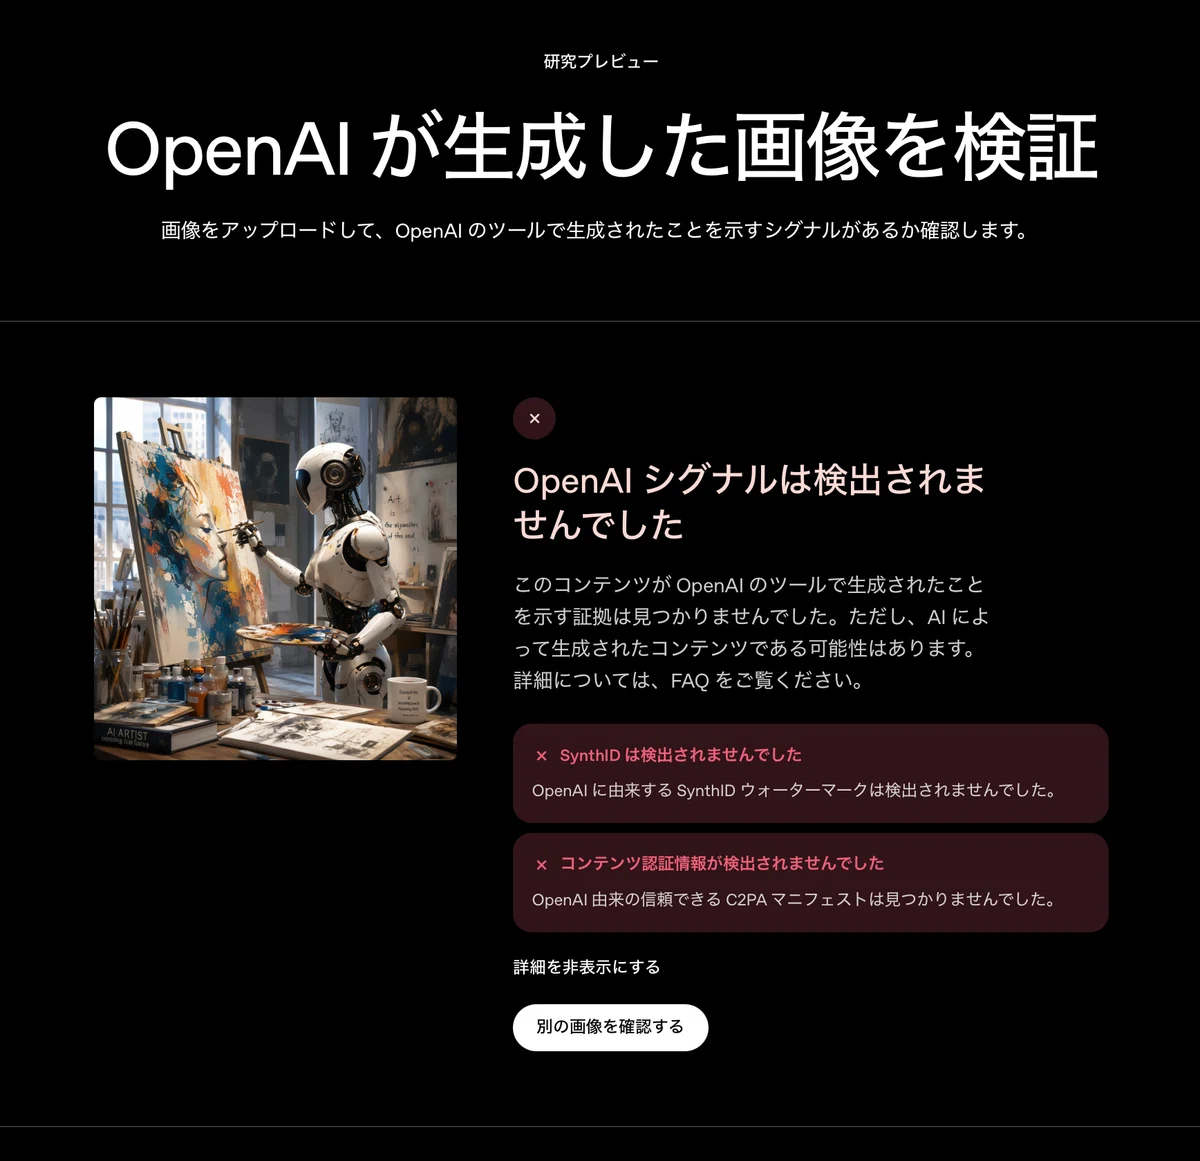
ここで重要なのは、見る側のリテラシーです。Verifyツールやその後継ツールが「シグナルが検出されませんでした」と表示したとき、それは「この画像は人間が作りました」を意味するわけではない、ということを理解しておく必要があります。OpenAIのVerifyツール自身のFAQでも、この点は明確に注意されています。検出器が言えるのは「我々の透かしの痕跡が見つかった、または見つからなかった」というだけで、後者の場合に内訳には「最初からAI製ではない」と「AI製だが透かしが何らかの理由で失われた」の両方が含まれ得るのです。
逆に、「シグナルが検出されました」は強い情報です。OpenAIのVerifyでSynthIDまたはC2PAが検出された場合、その画像がOpenAIツール由来である可能性は高いと言えます。Google製や他社製コンテンツの検証は、各社の対応や今後の相互運用に依存しますが、検出陽性の側のシグナルは信頼してよい、というのが今のところの位置づけです。
「絶対の真贋判定機ではないが、AI生成である可能性を強く示せるケースを増やす道具」として正しく使うこと。これが2026年5月時点での、現実的な向き合い方になります。
5. これからの12ヶ月 - 規制とエコシステムの行方
最後に、この領域がこれから1年でどう動きそうかを整理しておきます。
最大の外部圧力は、EU AI Actです。同法自体はすでに発効済みですが、Article 50(透明性義務)が2026年8月2日から適用開始される予定になっています。特にArticle 50(2)は、合成音声・画像・動画・テキストを生成するAIシステムの提供者に対し、出力を機械可読形式でマークし、AI生成または改変として検出可能にする義務を課すものです。OpenAIとGoogleが今このタイミングで連携を発表したのも、規制対応を見据えた動きと読むことができるでしょう。
OpenAIのVerifyツールも、現時点ではOpenAI製コンテンツに限定されていますが、OpenAIは今後数か月でクロス業界の検証努力を支援したいとしており、将来的に他社の生成コンテンツも相互運用的に検証できる方向へ進めば、消費者にとっての利便性は大きく上がります。ただし、これは各社がC2PAやSynthID互換規格を採用することが前提です。Midjourneyのように独自路線を取ってきた事業者がどう動くかは、要注目です。Anthropicは現時点で画像生成モデルを持たないため、この座組には直接参加していませんが、もし将来参入する場合、provenanceスタックへの対応は事実上の必須要件になるでしょう。
さらに、生成側だけでなく撮影側のC2PA採用も並行して進んでいます。LeicaやNikonの一部機種がC2PA対応を始めており、これが広がれば「カメラで撮影した画像」と「AIで生成した画像」が同じ規格で識別できるようになります。Photoshop時代から続いた「これは撮影か、編集か、合成か」という曖昧さに、技術的な解を与える方向です。
まとめ
冒頭のPhotoshop実験に戻ります。生成した画像を強い圧縮や粗い加工で痛めつけても、SynthIDの不可視透かしは生き残り続けました。30年間、画像編集ソフトウェアが組み込んでこなかった「来歴を示す技術」が、ようやく業界標準として動き出したことを、手元で体感できる瞬間でした。
完璧な仕組みではありません。攻撃手法は学術研究のレベルで存在しますし、これからのいたちごっこは続くでしょう。それでも、ゼロからイチに進んだ意義は大きいと感じます。「目利き」と人手のファクトチェックに依存してきた30年から、技術的なシグナルが補助線として機能する時代への移行が、ようやく始まったわけです。
大切なのは、過剰な期待も過剰な不信もせず、検出されたシグナルは強く信頼し、検出されなかったシグナルは「AI製ではない」の確証ではなく単に「分からない」として扱う姿勢でしょう。完璧な真贋判定器ではなく、現実を少しだけ見やすくしてくれる新しい道具として、付き合っていくのがよいと思います。
30年遅れの宿題は、ようやく解き始められたところです。
余談:「枠で囲うと検出されなくなる」という抜け道
記事を書きながら追加で検証していて、興味深い挙動に気づきました。
ChatGPTに素材として何かを作らせて、その出力を「AI生成ではない別の画像」の中に組み込むケースを試したところ、OpenAIのVerifyでは「OpenAIシグナルは検出されませんでした」と判定されたのです。具体的には、ChatGPTで生成した画像の周囲に、別途用意した枠を合成して取り込ませた状態にして検証しました。SynthIDが埋め込まれているはずのピクセル領域は確かに画像内に残っているのですが、画像全体に対する比率が下がったことで、検出器が信号を拾えなくなったと考えられます。
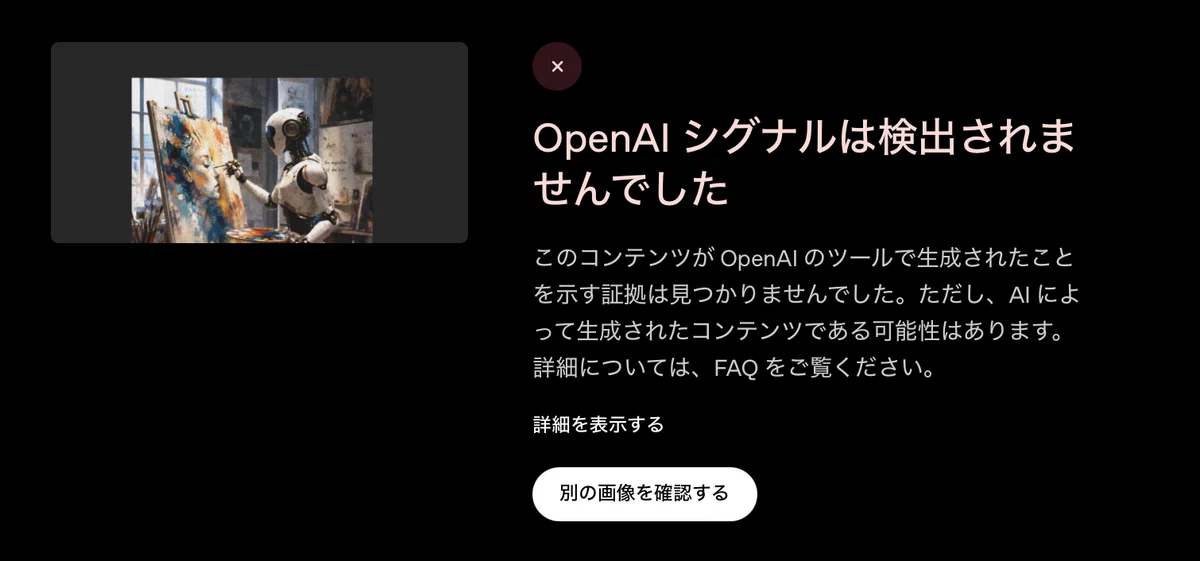
先述した手段とは毛色が違いますので。
断っておきますけど、検出させなくする手法の推奨ではありません。
むしろ本来はPhotoshopで加工したものも含め、経歴はオープンにすべきだと思っています。
これは攻撃というより、ごく自然な編集作業のなかで起こり得る検出失敗です。報道記事の中にAI生成のイメージカットを部分的に挿入する、プレゼン資料の1ページにChatGPTの作画を素材として組み込む、SNSの投稿画像にAI生成のアイキャッチを縁取りつきで使う、いずれも日常的にあり得る使い方です。そして、こうした「素材として部分的に使う」パターンでは、Verifyによる検出は通用しないことになります。
本文でも触れた読者リテラシーの話に戻りますが、ここでも同じ原則が当てはまります。「シグナルが検出されました」は強い情報ですが、「シグナルが検出されませんでした」は弱い情報です。後者には「最初からAI製ではない」「AI製だが部分的にしか使われていない」「AI製だが画像変換を経て信号が劣化した」など、複数の可能性が含まれます。
AI生成であることは高い精度で証明できる仕組みですが、転じて「AI生成ではない」ことの証明にはならない、ということです。provenanceシステムの非対称性として、頭の片隅に置いておく価値のある事実だと思います。
