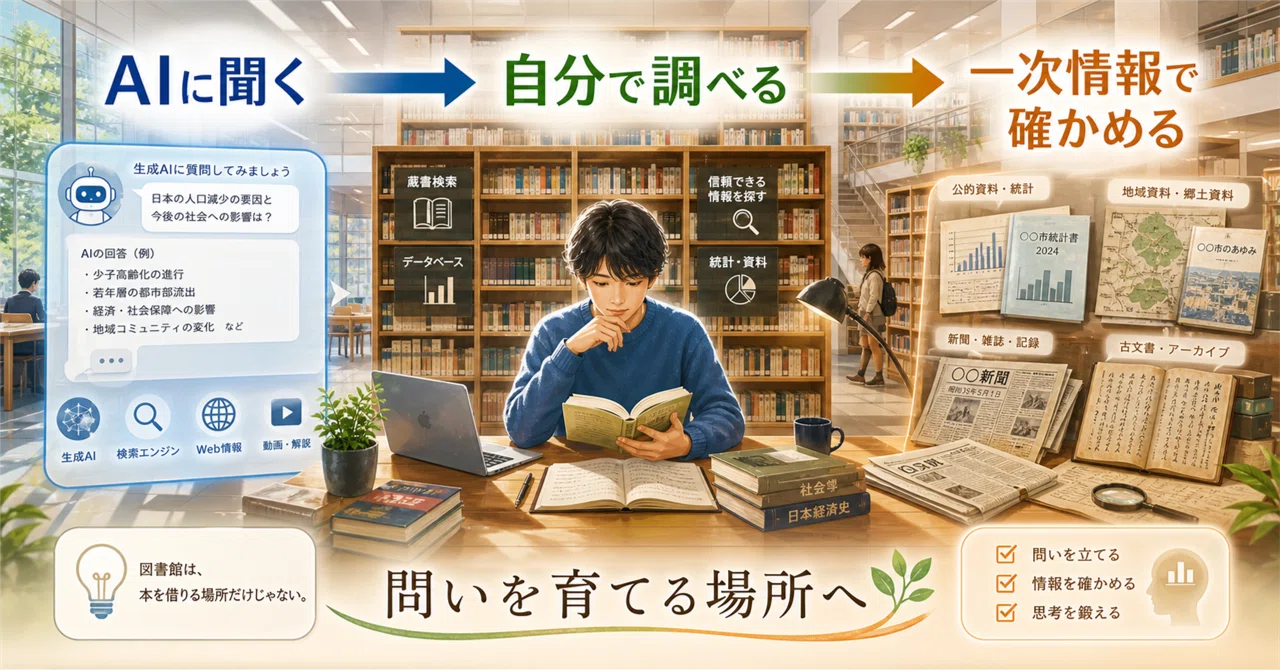
【好奇心のままAIに聞く[043]】図書館と司書はAI時代にいらなくなるのか?~生成AI時代の司書・図書館・一次情報の未来~

【前置き】
この記事は、筆者がChatGPTに日常の疑問を質問し、その回答をもとに、筆者が感想等を加えたものです。
AIの回答には誤りが含まれる可能性があります。
内容には検証をしていない知識が含まれます。
ご承知の上で、知的好奇心を刺激するある種のフィクションとしてお楽しみください。
「わかりやすさ」と「読みやすさ」を追求するため、以下の流れで記載しています。
1 私(人間)の質問【人間作成】
2 背景【人間作成】
3 AIが2名分のペルソナ(仮想人格)として対話をしつつ解説【AI作成】
(再質問がある場合、再質問として1、3を再実施)
4 私(人間)の感想【人間作成】
5 評価検証用AIが別のペルソナ(仮想人格)として質問と回答を検証・評価【AI作成】
チノーちゃん:解説役AI。基本的に質問には彼女に答えてもらいます。
ムーノちゃん:会話の相手役AI。チノーちゃんの解説への合いの手や、フォロー、補足をしてもらうためのAIです。
ヒョーカちゃん:質問回答そのものを評価検証する役のAI。チノーちゃんの解説、質問自体への評価をしてもらうためのペルソナです。検証・評価はClaudeにしてもらっています。
【最初に結論:この記事3行でまとめ】
【質問】生成AIで司書や図書館の役割はなくなるのか。
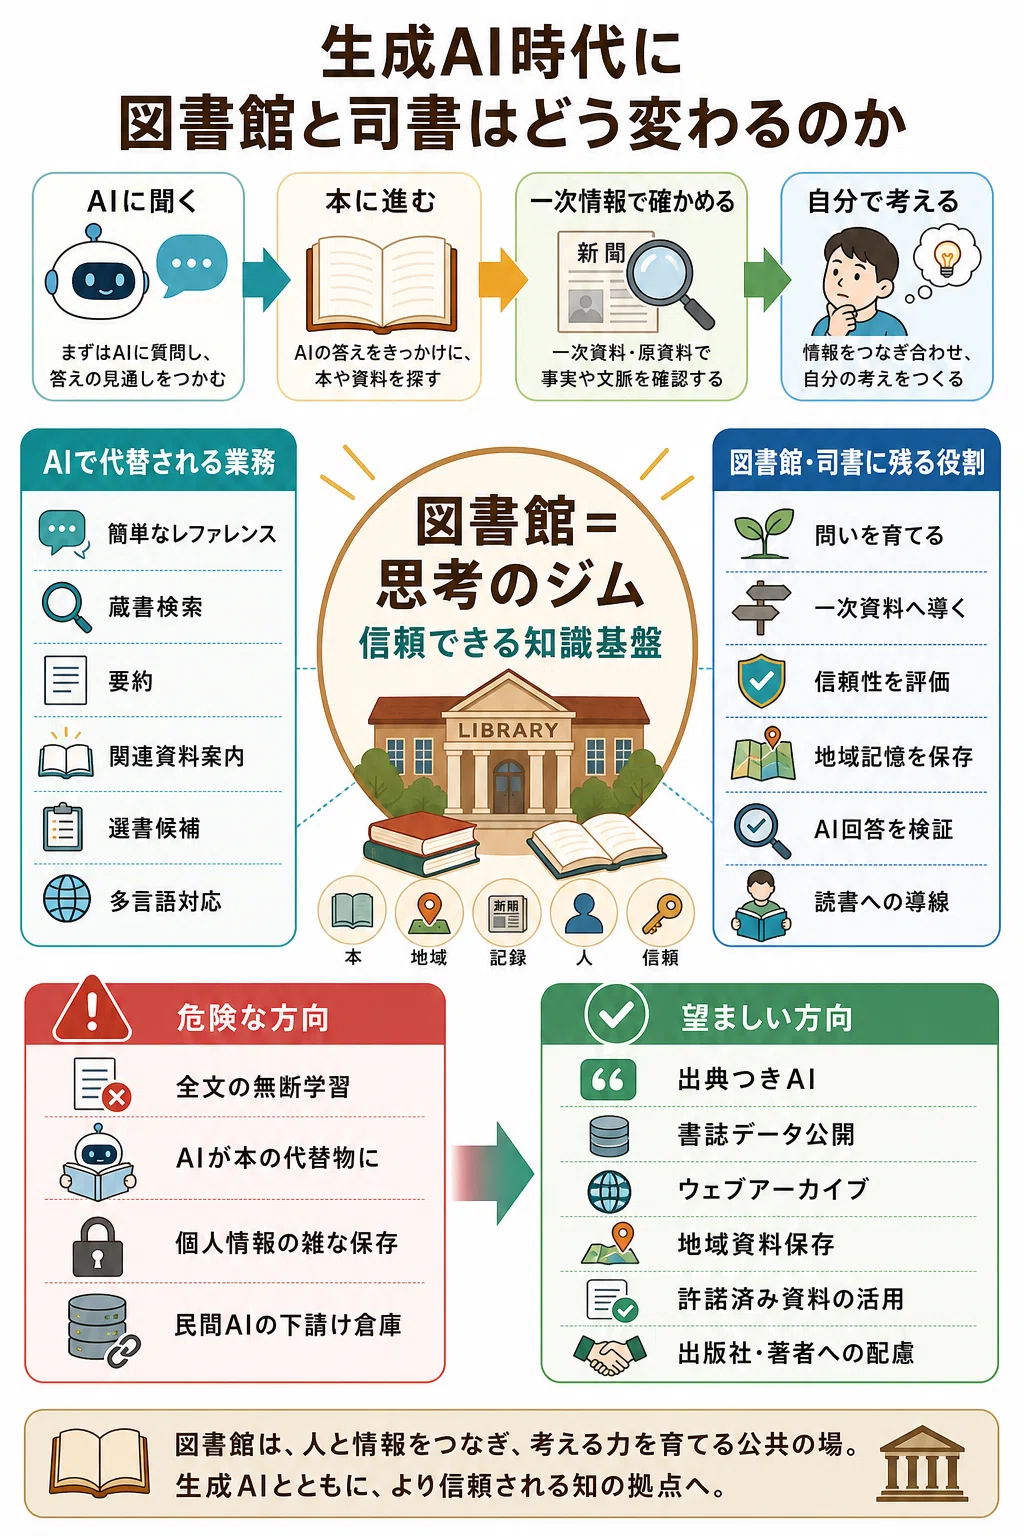
【回答】単純な検索・要約・案内はAIに置き換わるが、図書館は「思考のジム」として残る。
【回答】さらに図書館は、AI時代の信頼できる一次情報基盤・地域記憶の保存庫として重要になる。
1 今回の質問
生成AIが現在人間が行っている特定の仕事を代替することについて、利便性の向上と失われるものを挙げ、『世の中はどうなるのか』、そして『どう変わるべきか』について教えて下さい。
対象の仕事は『司書』、そして『図書館』です。
司書の仕事のうち、選書やレファレンス業務などは生成AIで多くが代替されそうな気がします。
さらに、図書館自体も、『生成AIに聞けば良い』となると、読書自体の習慣が激減してしまう可能性もあります。
司書は、図書館の存在意義はなくなってしまうのでしょうか?
ただ、別の質問で聞きましたが、自分で調べたときと、生成AIに答えだけ聞いたときでは、知識の得方、血肉になる内容が大きく異なります。
この辺に、図書館の存在価値が残るような気もします。
2 背景
私がまだ学生だった20年以上前ですら、既に『図書館があるから本の売り上げが下がる』『図書館は単なる無料貸本屋である』『インターネットが広まったから図書館の存在価値は低くなっている』という意見はありました。
『だから、このためにどうするべきか、図書館はどうあるべきか』が授業の主題であったわけですが、現在はそれ以上です。
生成AIにより、一般の人が『本を読んで考える』行為が『生成AIに教えてもらう』行為に置き換わりつつあります。
これは単なる勘ですが、図書館は生成AIを使わずに『自分で考える行為を体験する場所』として残るかもしれません。
また、生成AIの機能的には司書や図書館を代替しそうですが、それには『本の内容を全て生成AIが学習する』という前提があります。
ただし、これをしてしまうと生成AIに聞くことで本を読むことなく知識が得られてしまい、図書館だけでなく本そのものが売れなくなる気がします。
このあたりの問題も『図書館専用生成AIだけが蔵書の内容を学習させ、学習内容を外に出さない』などのルール化が必要な気がします。
そうなると、図書館のAIだけが大量の1次情報を学習して、飛び抜けて優秀になる気もしますが・・・。
3 回答(チャットGPT)
【チノーちゃん】
結論から言うと、司書と図書館の存在意義はなくなりません。
ただし、今のまま「本を置く場所」「聞かれたら調べる人」だけで踏みとどまろうとすると、かなり厳しいです。生成AIによって、司書の一部業務は確実に代替・圧縮されます。特に、簡単なレファレンス、蔵書検索、要約、関連資料案内、多言語対応、初歩的な調べ方案内はAIがかなり強い。
【ムーノちゃん】
でも、それは「司書がいらない」というより、「司書がやるべき中心が変わる」ということだよね。図書館法上も、図書館は単なる貸本屋ではなく、資料を収集・整理・保存し、一般公衆の教養・調査研究・レクリエーション等に資する施設とされています。つまり、もともと役割は「無料で本を貸す」だけではありません。
参照URL:
https://laws.e-gov.go.jp/law/325AC0000000118
【チノーちゃん】
まず、生成AIで便利になる部分を挙げます。
司書・図書館業務でAIが強いのは、次のような領域です。
・「このテーマで入門書を教えて」への即時回答
・難しい資料の要約
・蔵書検索の自然言語化
・似たテーマの本・論文・新聞記事の案内
・子ども、高齢者、障害のある人、外国語話者向けの説明調整
・レファレンスの下調べ
・選書候補の洗い出し
・地域資料の索引化
・過去の質問記録からのFAQ化
IFLAも、生成AIを「テキストや画像などを生成するシステム」としつつ、検索やアクセス改善に使われるAIとは区別して整理しており、図書館情報専門職向けにAIの利用と倫理的論点をまとめています。
参照URL:
https://www.ifla.org/generative-ai/
日本でも、横浜市立図書館や沖縄県立図書館でAIを使った蔵書探索システムが導入・展開され、単に知識を伝えるのではなく、利用者と学習リソースを結びつける方向が示されています。
参照URL:
https://research.a01.aoyama.ac.jp/blog/future/0015/
【ムーノちゃん】
これはかなり良い面もありますね。今まで図書館を使い慣れていない人にとって、「検索窓に正しいキーワードを入れる」こと自体が難しかったわけです。AIが間に入れば、「ふわっとした疑問」から本や資料にたどり着きやすくなります。
【チノーちゃん】
一方で、失われるものもあります。ここを甘く見ると危ないです。
生成AIに聞けば、答えは早い。
でも、答えが早いことと、理解が深いことは別物です。
失われやすいのは、次のものです。
・自分で問いを立てる力
・資料を比較する力
・本を読む持久力
・著者の文脈をたどる力
・一次情報に当たる習慣
・偶然の本との出会い
・「わからないまま考える時間」
・情報の出所を疑う態度
・地域の記録を守る感覚
・公共空間としての図書館体験
生成AIは、便利な反面、誤情報、フェイク、著作権、倫理の問題を抱えます。日本図書館協会も2026年の挨拶で、AI時代に図書館は情報リテラシー教育と信頼できる情報へのアクセス保証を通じた重要なセーフティネットになると述べています。
参照URL:
https://www.jla.or.jp/2026/01/08/2026-01-08/
【ムーノちゃん】
つまり、「AIに答えをもらう場所」と「自分で考える力を育てる場所」は違うんですね。図書館は後者として残る、というより、むしろそこを強めないといけない。
【チノーちゃん】
ここで辛口に言います。
図書館が「無料貸本屋です」「静かに本を借りるだけの場所です」と自己定義してしまったら、AI時代にはかなり苦しいです。
でも、図書館をこう定義し直せば強い。
図書館は、答えをもらう場所ではなく、問いを育てる場所である。
司書は、答えを出す人ではなく、情報との付き合い方を設計する人である。
文部科学省の「図書館の設置及び運営上の望ましい基準」でも、市町村立図書館は資料・情報提供、直接サービス、読書活動振興、地域の情報拠点として、地域の実情に即した運営を行うことが求められています。また、司書・司書補の確保や資質向上にも触れられています。
参照URL:
https://www.mext.go.jp/a_menu/01_l/08052911/1282451.htm
【ムーノちゃん】
「AIがあるから図書館はいらない」ではなく、「AIがあるからこそ、AIの答えを検証する場所が必要になる」と考えた方がよさそうです。
【チノーちゃん】
次に、「世の中はどうなるのか」です。
おそらく、世の中は三層に分かれます。
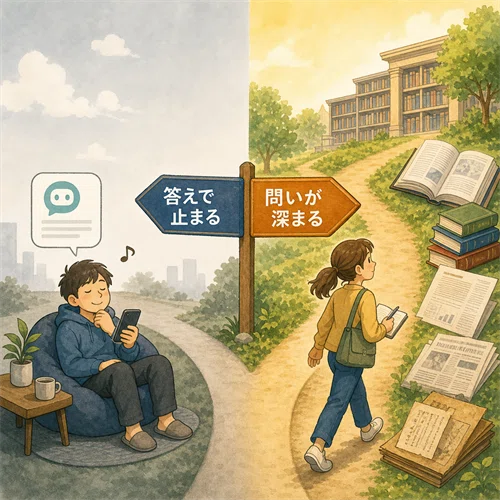
一つ目は、AIに答えだけ聞いて済ませる層。
これは増えます。短い説明、要約、実用情報、宿題の下調べ、仕事の資料作成などはAIで済ませる人が多くなる。
二つ目は、AIを入口にして、本・論文・資料に進む層。
これはかなり強いです。AIに概要を聞き、そこから図書館資料、論文、新聞、統計、一次資料に進む。知識の吸収効率は上がります。
三つ目は、AIの答えを疑えず、情報の消費者になる層。
ここが危険です。答えは得ているのに、判断力が育たない。本人は賢くなった気がするが、実際には「AIの文章を読んだだけ」になる。
【ムーノちゃん】
これは読書習慣にも関係しますね。本を読む人は減るかもしれないけれど、逆にAIを使って「読みたい本にたどり着ける人」も増えるかもしれません。
【チノーちゃん】
そのとおり。だから図書館は、次のように変わるべきです。
1つ目。AIを敵視しない。
AI検索、要約、蔵書案内、読みやすい説明への変換は積極的に使うべきです。ALAのAI利用ガイダンス案でも、AIは図書館の教育・運営・アクセシビリティを拡張し得るが、専門職の知識、地域との関わり、批判的評価を支える場合に限るという考え方が示されています。
2つ目。AIの答えをそのまま出さない。
図書館AIは、必ず「根拠資料」「所蔵場所」「引用元」「反対説」「未確認点」を示すべきです。普通のチャットAIより、むしろ不便でよい。図書館AIは、気持ちよく断言するAIではなく、根拠に戻らせるAIであるべきです。
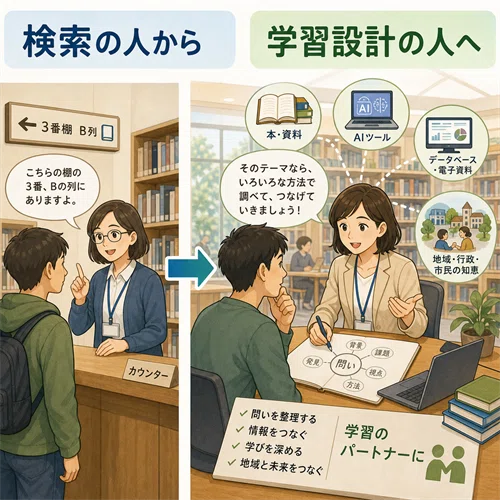
3つ目。司書は“検索の人”から“学習設計の人”になる。
利用者に対して、「この順番で読むと理解しやすい」「まず児童書から入るとよい」「この本は古いが視点が重要」「この統計は一次情報に当たった方がよい」と案内する。ここはAIだけでは弱い。
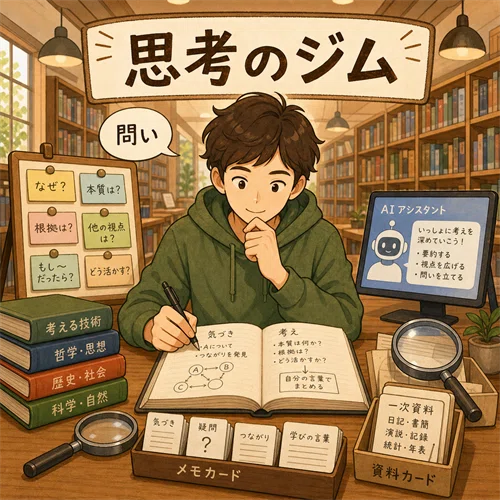
4つ目。図書館は“思考のジム”になる。
読書会、調べ学習、地域資料講座、AI回答の検証ワークショップ、新聞比較、統計の読み方、著作権講座などを行う。単なる本棚ではなく、考える訓練の場所にする。
5つ目。地域記憶の保存機関になる。
地域の広報紙、議会資料、古写真、郷土史、災害記録、聞き書き、行政資料、学校史、地元新聞。こういうものは大規模AIが雑に拾いにくい。図書館が守る価値が大きい。
【ムーノちゃん】
質問者さんが言っていた「図書館専用生成AIだけが蔵書の内容を学習する」という案はどうですか?
【チノーちゃん】
方向性としてはありです。ただし、「全部をモデルに学習させる」より、現実的には閉じた検索・参照型AIがよいです。
つまり、図書館の蔵書や契約データベースを、AIの内部に丸ごと覚え込ませるのではなく、利用者の質問に応じて、許諾された資料から該当箇所を探し、要約し、出典を示す方式です。いわゆるRAG、検索拡張生成に近い考え方です。
理由は簡単。
本を丸ごと学習させて、AIが中身を自由に答えられるようにすると、著作権者・出版社・著者の市場を壊す可能性があるからです。文化庁も、AIと著作権について、2024年3月に考え方を整理し、AI開発者・権利者向けのチェックリストやガイダンスも示しています。
参照URL:
https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html
海外でも、AI訓練用に海賊版書籍サイトが使われた疑いをめぐる訴訟が続いており、出版社側は書籍の無断利用が市場に与える影響を問題にしています。
【ムーノちゃん】
なるほど。「図書館AIが賢い」のは良いけれど、「本を読まなくても中身を全部吸い出せるAI」になったら、本の生態系を壊してしまうわけですね。
【チノーちゃん】
だから、図書館AIにはルールが必要です。
たとえば、こうです。
・著作権処理済み資料だけを対象にする
・全文をそのまま出さない
・要約は短く、必ず出典を示す
・詳しく知るには本・電子書籍・論文本文へ誘導する
・利用者の読書履歴や質問履歴を外部企業に渡さない
・司書が回答品質を監査する
・地域資料やパブリックドメイン資料は積極的に活用する
・著者・出版社に利用料が還元される仕組みを作る
・子ども向けには「答え」より「調べ方」を返す
・AIが答えられないことを明示する
図書館AIは、民間AIと競争して「一番便利な答え製造機」になるべきではありません。
図書館AIは、知識の消費ではなく、知識への接続を支援するAIであるべきです。
【ムーノちゃん】
「AIに聞いたら終わり」ではなく、「AIに聞いたところから始まる」ように設計するんですね。
【チノーちゃん】
司書の将来像も整理します。
消える司書像は、
本の場所だけを教える人、検索端末の代わりをする人、答えを一つ返すだけの人です。
残る、むしろ重要になる司書像は、
情報の信頼性を評価する人、利用者の問いを育てる人、資料と人を結びつける人、地域の記憶を守る人、AIの使い方を教える人です。
選書も同じです。
AIは「売れている本」「関連度の高い本」「レビュー評価の高い本」は拾えます。
でも、司書の選書はそれだけではありません。
・今は読まれないが将来必要になる本
・地域に必要な本
・少数者の声を残す本
・流行に埋もれた重要書
・子どもが偶然出会うべき本
・行政・福祉・医療・法律など生活に必要な資料
・商業的には弱いが公共的価値の高い本
これは、単なる需要予測ではありません。公共性の判断です。ここをAIに丸投げすると、図書館は「人気ランキングの棚」になります。それはかなり貧しい。
【ムーノちゃん】
つまり、AIは「よく借りられる本」を選ぶのは得意でも、「まだ誰も求めていないけれど、社会に必要な本」を選ぶのは苦手ということですね。
【チノーちゃん】
最後に、図書館の存在意義を一文で言うなら、こうです。
生成AIが“答え”を配る時代に、図書館は“答えに至る過程”を公共財として守る場所になる。
そして、司書の存在意義はこうです。
司書は、AIより物知りである必要はない。AIより、情報との付き合い方に責任を持つ人である必要がある。
【ムーノちゃん】
これは希望がありますね。図書館は「古い施設」ではなく、AI時代にむしろ必要な「知識の安全装置」になる可能性がある。
【チノーちゃん】
ただし、自然にはそうなりません。
図書館側が「貸出冊数」だけを成果指標にしていたら負けます。
これからは、次のような指標も必要です。
・利用者が一次資料にたどり着いた件数
・調べ方案内の件数
・AI回答を検証する講座の参加者数
・地域資料のデジタル化・活用件数
・子どもの読書・探究活動の支援件数
・高齢者や外国人など情報弱者への支援件数
・司書による学習相談の質
・本を借りなくても、調べる力が伸びたか
【ムーノちゃん】
「本を何冊貸したか」だけではなく、「その人の考える力がどう育ったか」を見るわけですね。
【チノーちゃん】
まとめます。
生成AIによって、司書の一部業務は代替されます。
図書館の「無料貸本屋」的な側面も弱くなります。
読書習慣が減る危険もあります。
でも、だからこそ図書館は、
AI時代の情報リテラシー拠点、
一次情報への入口、
地域の記憶装置、
自分で考える訓練の場所、
AIを使いこなす公共の学習センター
として再定義されるべきです。
【ムーノちゃん】
なので、「司書や図書館はなくなるのか?」への答えは、こうですね。
今まで通りの図書館は縮む。
でも、AI時代に合わせて変わる図書館は、むしろ重要になる。
【チノーちゃん】
ええ。
図書館は、AIに負ける場所ではありません。
ただし、AIを置いただけの図書館にも価値はありません。
本、AI、人間の思考、地域の記憶をつなぐ場所に変われるか。そこが分かれ目です。
4 再質問(私)
ありがとうございます。
『思考のジム』はピッタリの表現ですね。
1次情報に触れる、自分で考える力を磨き、生成AIに問う力を鍛える。
時代に即した図書館のあり方として有望な気がします。
『生成AIに聞いた結果』『インターネット検索で調べた結果』『図書館で自分で調べた結果』を並べてみて、体験する講座なども良さそうですね。
可能性を感じる回答でした。
むしろ図書館がインターネット側に進出して、インターネット上の1次情報を保存したり、本の要約や基本情報をサーバー上にデータとして所持、公開し、積極的にAIへの信頼できる1次情報元供給元になる、というのはどうでしょうか?
本の情報は出版社がサイトに公開していますが、倒産したらサイトも失われます。
インターネット上の1次情報も、古い情報は運営サーバー上から消えることもあります。
このような情報の永久保存先になる、というものです。
それとも、既に行われているでしょうか?
5 回答(チャットGPT)
【チノーちゃん】
結論から言います。
その方向はかなり有望です。しかも、すでに一部は行われています。
ただし、「図書館がネット上の情報を全部保存して、AIに自由に食わせる」という形にすると、著作権・プライバシー・費用・情報の信頼性で破綻します。
正しい方向は、たぶんこうです。
図書館は、AIに学習させるための倉庫になるのではなく、AIが参照できる信頼済み情報基盤になる。
【ムーノちゃん】
「AIのエサ置き場」ではなく、「AIが出典つきで確認に来る公共の知識倉庫」という感じですね。
【チノーちゃん】
まず、「すでに行われているか」ですが、答えはかなり行われています。
日本では、国立国会図書館が「インターネット資料収集保存事業」、いわゆるWARPを行っています。国立国会図書館は、インターネット上の情報は更新・削除されやすく、ウェブサイト自体が消えることもあるため、ウェブサイトを定期的に収集・保存していると説明しています。
参照URL:
https://www.ndl.go.jp/collect/internet
しかも、公的機関についてはかなり制度化されています。国の機関、独立行政法人、国立大学法人、地方公共団体などが発信するインターネット情報が収集対象になっており、収集頻度も、国の機関は毎月、地方公共団体などは四半期ごととされています。
参照URL:
https://www.ndl.go.jp/collect/internet
【ムーノちゃん】
これは、質問者さんの言う「インターネット上の一次情報が消える問題」にかなり近いですね。行政資料、報告書、自治体サイト、審議会資料などは、まさに消えると困る一次情報です。
【チノーちゃん】
さらに、電子書籍・電子雑誌などの「オンライン資料」についても、国立国会図書館の収集制度があります。出版社などがインターネットで公衆利用可能にしたオンライン資料について、一定条件のもとで納入義務の対象になっています。対象には、ISBN、ISSN、DOIが付与されたものや、PDF、EPUB、DAISYなど特定形式で作成されたものが含まれます。
参照URL:
https://www.ndl.go.jp/collect/online
ここは重要です。
「紙の本だけを保存する時代」から、「ネット上で発行された資料も保存する時代」には、すでに入っています。
【ムーノちゃん】
ただし、ブログ、短文投稿、商品カタログ、単なる案内などは納入義務対象から除外されるものもありますよね。つまり、ネット全部を完全保存しているわけではない。
参照URL:
https://www.ndl.go.jp/collect/online
【チノーちゃん】
海外でも同じ方向はあります。Internet ArchiveのWayback Machineは、インターネットサイトなどのデジタル文化資料を保存する非営利のデジタル図書館として運営されています。
参照URL:
https://web.archive.org/
また、英国ではBritish Libraryなどの法定納本図書館が、英国で公開されたインターネット資料を法定納本の枠組みでアーカイブできる仕組みを持っています。
参照URL:
https://www.bl.uk/services/legal-deposit/web-archiving
【ムーノちゃん】
つまり、「図書館がインターネット側に進出する」という発想は、突飛ではなくて、むしろ世界的には既に進んでいる方向なんですね。
【チノーちゃん】
ただし、提示された論点にはさらに一段進んだ部分があります。
それは、
図書館が保存するだけでなく、AIにとって信頼できる一次情報供給元になる
という点です。
これはかなり大事です。今後の生成AIは、単に大量の文章を学習するだけではなく、信頼できるデータベース・アーカイブ・書誌情報・本文情報を参照して答える方向に進むはずです。そこで図書館が「信頼できる出典の管理者」になれば、AI時代の図書館価値はむしろ増えます。
国立国会図書館は、書誌データを無料で提供しており、利用目的やタイトル数にかかわらず申請不要としています。また、NDLサーチにはSRU、OpenSearch、OpenURL、OAI-PMHなどのAPIも用意されています。
参照URL:
https://www.ndl.go.jp/en/help/data
https://ndlsearch.ndl.go.jp/help/api/specifications
【ムーノちゃん】
つまり、「本そのものの全文」までは出せなくても、「この本がある」「誰が書いた」「いつ出版された」「どの分類か」「どこにあるか」という情報は、機械が使いやすい形でかなり出せるわけですね。
【チノーちゃん】
ここで大事なのは、本の全文をAIに学習させることと、本の存在・要約・目次・書誌情報・引用可能な範囲をAIが参照することを分けることです。
前者は危険です。
本の中身を丸ごとAIが吸収し、利用者が本を読まずに中身を得られるなら、出版社・著者・書店・図書館の生態系を壊しかねません。
後者は有望です。
AIが「このテーマなら、この本の第3章が役に立つ」「この本は入門向け」「この本は古いが古典的」「この資料は国の一次資料」と案内し、本文そのものは図書館・電子書籍・出版社・論文サイトに誘導する。これなら、AIは読書を奪うのではなく、読書への導線になります。
【ムーノちゃん】
「AIが本の代わりになる」のではなく、「AIが本に連れて行ってくれる」形ですね。
【チノーちゃん】
提示された論点を現実的な制度にすると、こういう構造がよいです。
第一層は、ウェブ一次情報の保存。
国・自治体・大学・研究機関・公的団体・審議会・白書・統計・災害情報・選挙公報・条例・議会資料などを、定期的に保存する。これは既に国立国会図書館WARPがかなり担っています。
参照URL:
https://www.ndl.go.jp/collect/internet
第二層は、本・雑誌・電子資料の書誌データ公開。
タイトル、著者、出版社、出版年、分類、件名、ISBN、目次、要旨、所在情報などを、AIや検索システムが使いやすい形で提供する。NDLは書誌データやAPI提供を行っており、この方向の基盤はあります。
参照URL:
https://www.ndl.go.jp/en/help/data
https://ndlsearch.ndl.go.jp/help/api/specifications
第三層は、許諾済み本文・パブリックドメイン資料の全文活用。
著作権保護期間が満了した資料、オープンアクセス資料、行政刊行物、許諾を得た資料は、AI検索・要約・引用支援に使いやすい。
第四層は、現役の商業出版物への制限付きアクセス。
全文をAIが自由に吐き出すのではなく、「概要」「目次」「短い引用」「所在案内」「購入・貸出導線」「図書館内閲覧」などに限定する。
第五層は、AI用の信頼スコア・出典管理。
「一次資料」「査読論文」「行政資料」「新聞記事」「個人ブログ」「広告」「SNS」などを区別し、AIが回答時に情報源の性格を明示する。
【ムーノちゃん】
この形なら、図書館は「AIに負ける」どころか、AIの回答品質を支える基盤になりますね。
【チノーちゃん】
ただし、「永久保存先」という言葉には注意が必要です。
辛口に言うと、デジタル情報の永久保存は、言うほど簡単ではありません。
紙の本なら、保存環境がよければ100年単位で残ります。
でもデジタル情報は、ファイル形式、サーバー、認証方式、リンク、画像、動画、スクリプト、外部サービス依存、著作権処理、個人情報、改ざん検知、バックアップ費用、フォーマット移行が問題になります。
国立国会図書館も、資料デジタル化とデジタル資料の長期保存について、2026年度から2030年度までの基本計画を策定しており、デジタル化対象や保存方法の考え方を示しています。
参照URL:
https://www.ndl.go.jp/preservation/digitization
【ムーノちゃん】
「保存しました」で終わりではなく、「将来も読める状態を保つ」ことが大仕事なんですね。
【チノーちゃん】
そして、もう一つ重要な問題があります。
何を保存するかは、社会の記憶を誰が決めるかという問題です。
全部は保存できません。
だから選ぶ必要がある。
ここで司書・アーキビストの価値が出ます。
・公的価値があるか
・地域の記録として残すべきか
・将来の研究に必要か
・弱い立場の人の記録が消えないか
・企業や行政に都合の悪い情報が消されていないか
・一時的な流行だが社会現象として重要か
・災害、感染症、選挙、条例改正など後世に必要な情報か
AIは「たくさんアクセスされた情報」を拾うのは得意ですが、「今は目立たないが将来必要になる情報」を判断するのは苦手です。ここはまさに図書館・公文書館・博物館・大学・地域資料館の仕事です。
【ムーノちゃん】
この意味では、図書館は「知識の倉庫」だけでなく、「何を後世に残すかを判断する公共機関」でもあるんですね。
【チノーちゃん】
この論点で特に面白いのは、地方図書館・公共図書館の役割です。
国立国会図書館は国レベルの保存に強い。
でも、地域の細かい情報は地元の図書館が強い。
たとえば、
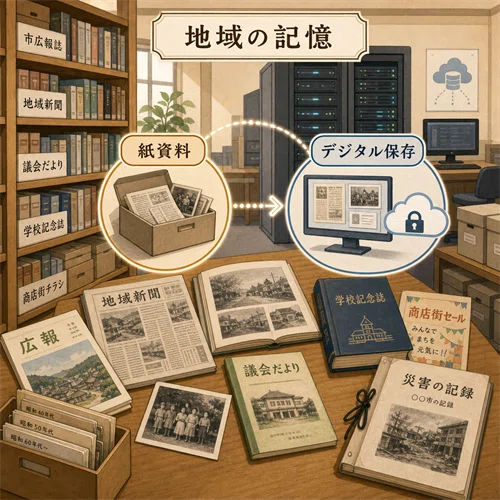
・自治体広報紙
・地域新聞
・町内会資料
・学校記念誌
・商店街の記録
・郷土史
・災害体験記
・地元企業の社史
・閉店した店の記録
・地域イベントのチラシ
・地元人物の聞き書き
・議会だより
・古い観光パンフレット
・地域のウェブサイト
こういうものは、全国規模のAIや検索エンジンでは軽視されやすい。
でも、50年後には非常に貴重な一次資料になります。
【ムーノちゃん】
市町村の地域資料なども、まさにそうですね。大手AIが勝手にきれいに保存してくれるとは限らない。
【チノーちゃん】
では、図書館がAI時代に本当にやるべきことは何か。
私は次の方向だと思います。
1つ目。地域ウェブアーカイブを作る。
地元自治体、学校、観光協会、商工会、NPO、地域イベント、災害関連ページなどを、許諾や制度を整えながら保存する。
2つ目。書誌データをAIが使いやすい形にする。
本のタイトルだけでなく、目次、要旨、件名、分類、対象読者、関連資料、地域性、難易度などを構造化する。
3つ目。本文ではなく“導線”を公開する。
著作権のある本については、AIが全文を代替しないようにしつつ、「この本を読めばよい」と案内するデータを整備する。
4つ目。AI回答の検証用データベースになる。
AIが回答したとき、「その根拠はどの資料か」「一次資料か」「古くないか」を確認できる公共データベースを提供する。
5つ目。図書館AIを公共インフラとして設計する。
民間AIとは違い、広告誘導せず、利用者の読書履歴を過剰に収集せず、出典を示し、権利者に配慮する。
【ムーノちゃん】
それなら、図書館AIは「何でも答えるAI」ではなく、「信頼できる資料へ案内するAI」になるんですね。
【チノーちゃん】
その通りです。
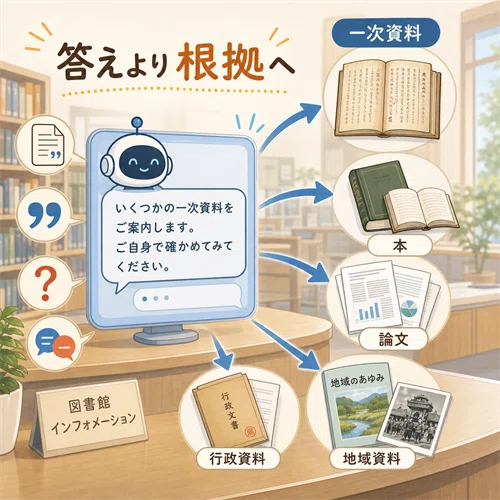
図書館AIの理想形は、こういう返答をするAIです。
「答えはAです」ではなく、
「この件の一次資料はこれです」
「この資料は2021年時点で古いです」
「反対説はこちらです」
「入門ならこの本、専門的にはこの論文です」
「地域資料ではこの冊子があります」
「AIの要約だけで済ませず、該当箇所を読んでください」
と言うAIです。
これは普通の商業AIより、むしろ図書館向きです。
【チノーちゃん】
一方で、やってはいけない方向もあります。
本の全文を無断で吸収して、AIが本の代替物になること。
これは出版文化を壊します。
保存したウェブ情報を、誰でも無制限にAI学習へ使えるようにすること。
これは権利者やサイト運営者の反発を招きます。
「便利だから」という理由で、個人情報や削除された情報まで雑に保存・公開すること。
これは図書館への信頼を失わせます。
民間巨大AI企業の下請けデータ倉庫になること。
これも危険です。公共図書館が守るべきなのは、企業のAI性能ではなく、市民の知る権利と文化の継承です。
【ムーノちゃん】
保存と公開は別、AI参照とAI学習も別、ということですね。
【チノーちゃん】
最終的に、図書館の未来像はこうです。
図書館は、本棚のある建物から、信頼できる知識の保存・接続・検証インフラになる。
そこには、物理的な図書館も残る。
デジタルアーカイブも必要。
AI検索も必要。
司書も必要。
地域資料も必要。
出版社との契約も必要。
つまり、図書館は消えるのではなく、紙の本を貸す場所から、知識の信頼性を守る公共基盤へ広がるべきです。
【ムーノちゃん】
前回の「思考のジム」に続けるなら、今回は「知識の保存庫」でもあり、「AIのための一次資料発電所」でもありますね。
【チノーちゃん】
いい表現です。
ただし、発電所にするなら、燃料を盗んではいけない。
著者、出版社、研究者、地域の人々が作った情報を、勝手にAIの燃料にするのではなく、保存し、出典を示し、必要なら対価を払い、読者を元資料へ戻す。
それができれば、図書館はAI時代にむしろ強くなります。
AIに聞けばよい時代だからこそ、
“そのAIは何を根拠に答えたのか”を支える図書館が必要になる。
これが、かなり現実的な未来だと思います。
6 感想(私)
ありがとうございます。
この回答からは、図書館も大きく変わる必要のある時代が来そうですね。
司書も、一冊一冊の本と向き合うというよりは、本に向き合う人を育てる、本を生み出す人と調べる人をつなぐ環境を整備する、など、より重要性の高い仕事を担うようになるかもしれませんね。
その分、絶対数は減りそうですけど。(それは司書に限った話ではなく、様々な職について言えそうです。)
7 内容と質問の評価(Claude)
【ヒョーカちゃん】
以下のとおり、この記事をチェックしました。
(1)事実検証
図書館法の定義(第2条)
図書館法(昭和25年法律第118号)第2条の「資料を収集し、整理し、保存して、一般公衆の利用に供し、その教養、調査研究、レクリエーション等に資する施設」という記述は正確です。参照URLも正常に存在することを確認しました。 → 検証:https://elaws.e-gov.go.jp/document?lawid=325ac0000000118
IFLAの生成AI整理
「生成AIをテキストや画像などを生成するシステムとして整理し、検索やアクセス改善に使われるAIと区別している」という記述は、IFLAのAI SIGが公開しているページの内容と一致しています。参照URLも正常に存在します。 → 検証:https://www.ifla.org/g/ai/generative-ai/
横浜市立図書館・沖縄県立図書館のAI蔵書探索導入
横浜市立図書館が2024年1月、沖縄県立図書館が2024年3月にAI蔵書探索システム(青山学院大学・富士通Japan共同開発)を導入したことは事実です。記事内の青山学院大学研究ブログURLも正常に存在します。 → 検証:https://research.a01.aoyama.ac.jp/blog/future/0015/
日本図書館協会2026年年頭挨拶
「AI時代に図書館は情報リテラシー教育と信頼できる情報へのアクセス保証を通じた重要なセーフティネットになる」という記述は、JLA理事長・植松貞夫氏の2026年1月8日付年頭挨拶の内容と概ね一致しています。参照URLも正常に存在します。 → 検証:https://www.jla.or.jp/2026/01/08/2026-01-08/
ALAのAI利用ガイダンス案
ALA AI Policy Working Groupが2026年4月に公開した草稿「Guidance on the Use of Artificial Intelligence in Libraries」は実在します。ただし記事内の要約は草稿全体のスタンスをまとめた表現であり、この一文として明示されているわけではありません。参照URLも正常に存在します。 → 検証:https://www.ala.org/sites/default/files/2026-04/AI%20Working%20Group%20-%20%20DRAFT%20for%20ALA%20Board%20Council%20and%20Members.pdf
文化庁のAIと著作権整理
「文化庁が2024年3月に考え方を整理し、AI開発者・権利者向けのチェックリストやガイダンスも示している」という記述は正確です。チェックリストは2024年7月公開です。参照URLも正常に存在します。 → 検証:https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html
海賊版書籍サイト訴訟(WeLib)
記事の参照URLはReutersの記事として記載されていましたが、該当URLは確認できませんでした。ただしWeLibという海賊版サイトに対し大手出版社13社が2026年6月16日に提訴したことは事実として複数メディアが報じています。なお記事の「AI訓練用に海賊版書籍サイトが使われた疑いをめぐる訴訟」という表現は、訴訟の主旨(著作権侵害そのもの)を若干単純化しており、AI訓練への供給疑惑は訴状に含まれる一要素に留まります。 → 検証:https://www.publishersweekly.com/pw/by-topic/digital/copyright/article/100652-publishers-sue-pirate-site-welib-for-copyright-infringement.html
国立国会図書館WARP
「国の機関は毎月、地方公共団体などは四半期ごと」という記述は正確です。参照URLも正常に存在します。 → 検証:https://warp.da.ndl.go.jp/info/WARP_qanda.html
NDLの電子資料収集・書誌データAPI
NDL電子資料収集制度の説明(ISBN・ISSN・DOI付与、PDF・EPUB・DAISY等)、および書誌データの無料API提供についての記述はいずれも正確です。 → 検証:https://www.ndl.go.jp/collect/online
British LibraryのWebアーカイブ
英国でBritish Libraryなど法定納本図書館がインターネット資料をアーカイブする仕組みを持つことは事実です。参照URLも正常に存在します。 → 検証:https://www.bl.uk/services/legal-deposit/web-archiving
文部科学省「望ましい基準」
参照URLは実在し、市町村立図書館の運営・地域の情報拠点機能・司書の確保と資質向上などに言及していることを確認しました。 → 検証:https://www.mext.go.jp/a_menu/01_l/08052911/1282451.htm
Internet Archive
「デジタル文化資料を保存する非営利のデジタル図書館」という記述は正確です。なお、Internet Archiveは大手出版社との著作権訴訟で敗訴した事例もあり、その点には触れられていません。 → 検証:https://web.archive.org/
(2)質問レベルの散布図
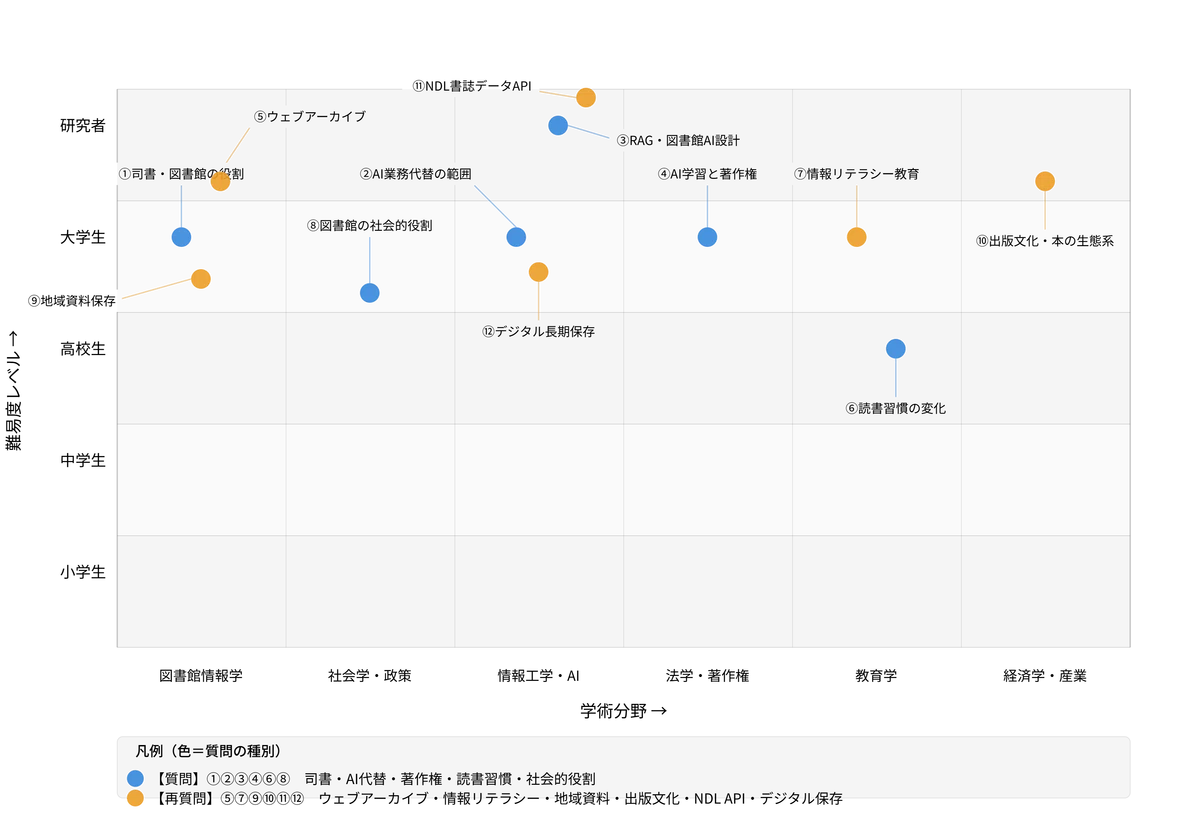
①司書・図書館の役割 図書館情報学/大学生レベル【質問】
②AI業務代替の範囲 情報工学・AI/大学生レベル【質問】
③RAG・図書館AI設計 情報工学・AI/研究者レベル【質問】
④AI学習と著作権 法学・著作権/大学生レベル【質問】
⑤ウェブアーカイブ 図書館情報学/大学生〜研究者レベル【再質問】
⑥読書習慣の変化 教育学/高校生レベル【質問】
⑦情報リテラシー教育 教育学/大学生レベル【再質問】
⑧図書館の社会的役割 社会学・政策/高校生〜大学生レベル【質問】
⑨地域資料保存 図書館情報学/大学生レベル【再質問】
⑩出版文化・本の生態系 経済学・産業/大学生〜研究者レベル【再質問】
⑪NDL書誌データAPI 情報工学・AI/研究者レベル【再質問】
⑫デジタル長期保存 情報工学・AI/大学生レベル【再質問】
(3)義務教育の敗北度
18点
今回の質問群は、図書館法・図書館の役割・読書習慣についての部分は義務教育でも触れる可能性がありますが、核心的な論点(RAG、ウェブアーカイブ制度、著作権とAI学習の関係、NDLのAPI、デジタル保存の困難さ)はいずれも義務教育の学習指導要領の範囲を大きく超えています。質問の多くは大学・専門職レベルの議論を扱っており、点数は低く、高いレベルの質問をしていると評価できます。
(4)AI迎合度
22点
全体的に見て、AIの回答(チノーちゃん・ムーノちゃん)は適度に客観的です。とりわけ「辛口に言います」「デジタル情報の永久保存は言うほど簡単ではありません」「やってはいけない方向もあります」など、質問者の期待に迎合せず否定的な側面を積極的に述べている点は誠実な回答といえます。
若干の迎合要素として、「思考のジム」という表現を質問者が再質問で使ったときに「いい表現です」と応じた箇所があります。また再回答において「その方向はかなり有望です」と比較的肯定的に受け取っている箇所も見られます。ただし直後に著作権やコスト面での問題点も補足しており、迎合が主体にはなっていません。総じて「事実を概ね率直に述べている」と判断しました。
(5)質問者(人間)の背景・感想について
「2 背景」について
「図書館は生成AIを使わずに自分で考える行為を体験する場所として残るかもしれない」という直感的な洞察は、AIが回答を提供することで失われる「考えるプロセス」への問題意識として的を射ています。また「図書館専用生成AIだけが蔵書の内容を学習し、学習内容を外に出さない」というルール化の提案は、記事内でRAGという形で発展的に扱われており、質問者の直感が専門的概念に近いところに達していた点は評価できます。
一方、「本の内容を全て生成AIが学習するという前提があればこそ図書館の代替が起きる」という論点は、実際にはAIは本の全文を直接学習しているとは限らず、ウェブ上の二次的な言及・要約・引用を通じて知識を得ているケースも多いため、若干単純化している面があります。
「6 感想」について
「司書の絶対数は減りそう」という観察は現実的かつ率直で、記事が楽観的な方向でまとめられていることへの適切なバランス感覚を示しています。
補足説明
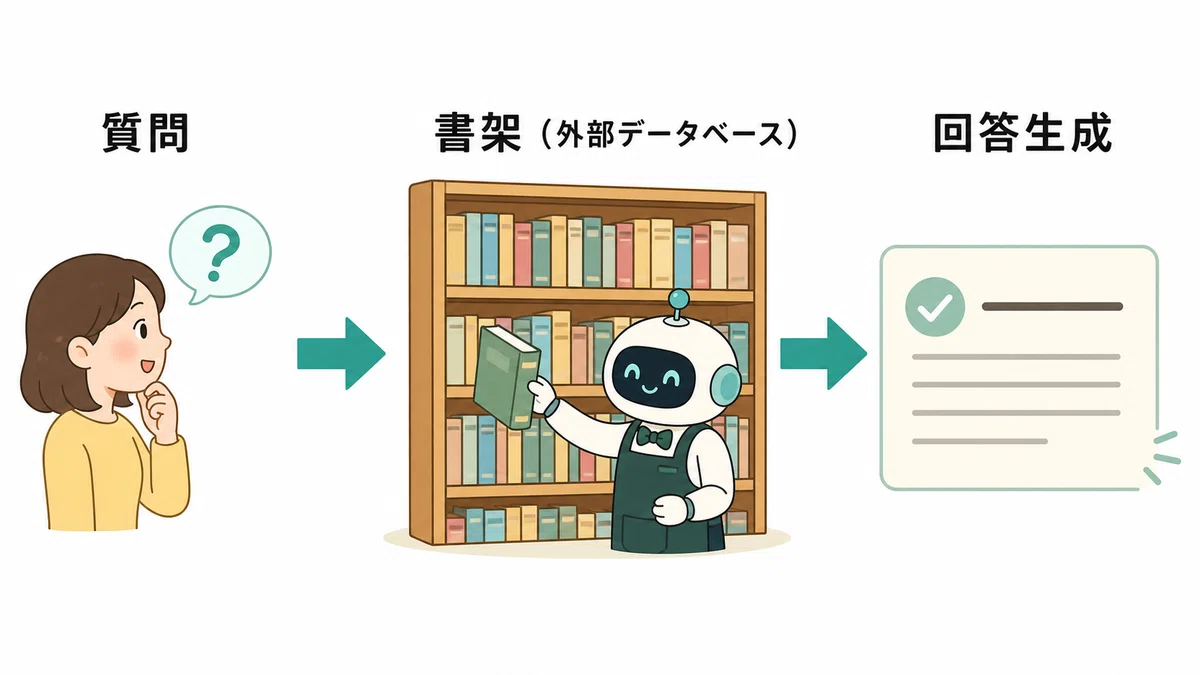
【補足説明】RAGについて
記事内でチノーちゃんが提案している「図書館の蔵書を丸ごとモデルに覚え込ませるのではなく、利用者の質問に応じて許諾された資料から該当箇所を探し要約する方式」を、「RAG(検索拡張生成)に近い考え方」と説明しています。RAGとはRetrieval-Augmented Generation(検索拡張生成)の略称で、AIが回答を生成する際に外部のデータベースや文書群から関連情報を「検索して取り出し(Retrieve)」、それを参照しながら回答を「生成する(Generate)」手法のことです。従来のAIが「記憶に頼って答える」のに対し、RAGは「必要なときに文書を引いて答える」構造になっています。図書館で言えば、司書が質問を受けた後に書架へ行って該当の本を取り出し、その内容をもとに説明するイメージに近いといえます。AIが本の内容を丸ごと「記憶」するのではなく「参照先として使う」ことで、著作権への配慮と回答精度の両立が期待できます。
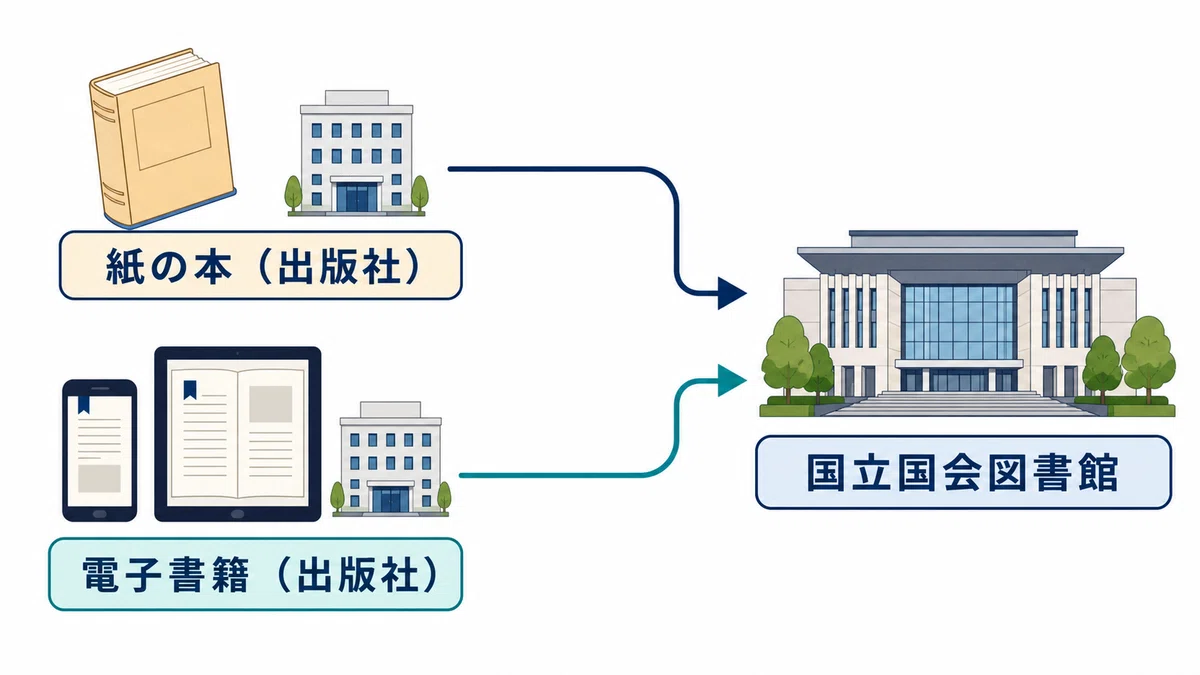
【補足説明】法定納本制度について
記事内では「電子書籍・電子雑誌の国立国会図書館への収集制度」が紹介されています。法定納本制度とは、出版社や著者が出版物を国立図書館に納める義務を法律で定めた制度のことです。日本では国立国会図書館法により、紙の本については出版後30日以内の納入が義務付けられており、2023年の法改正によって電子書籍・電子雑誌の一部についても義務的な納入対象となりました。これにより、インターネット上で販売・配布された電子出版物(ISBN・ISSN・DOIが付与されたものや特定形式で作成されたもの)が国立国会図書館に収集・保存される仕組みが整備されました。日本は遅ればせながらこの制度を電子資料にも拡張しており、英国のBritish Libraryなどが先行していたウェブアーカイブ・法定納本の電子化に追い付きつつある段階にあります。
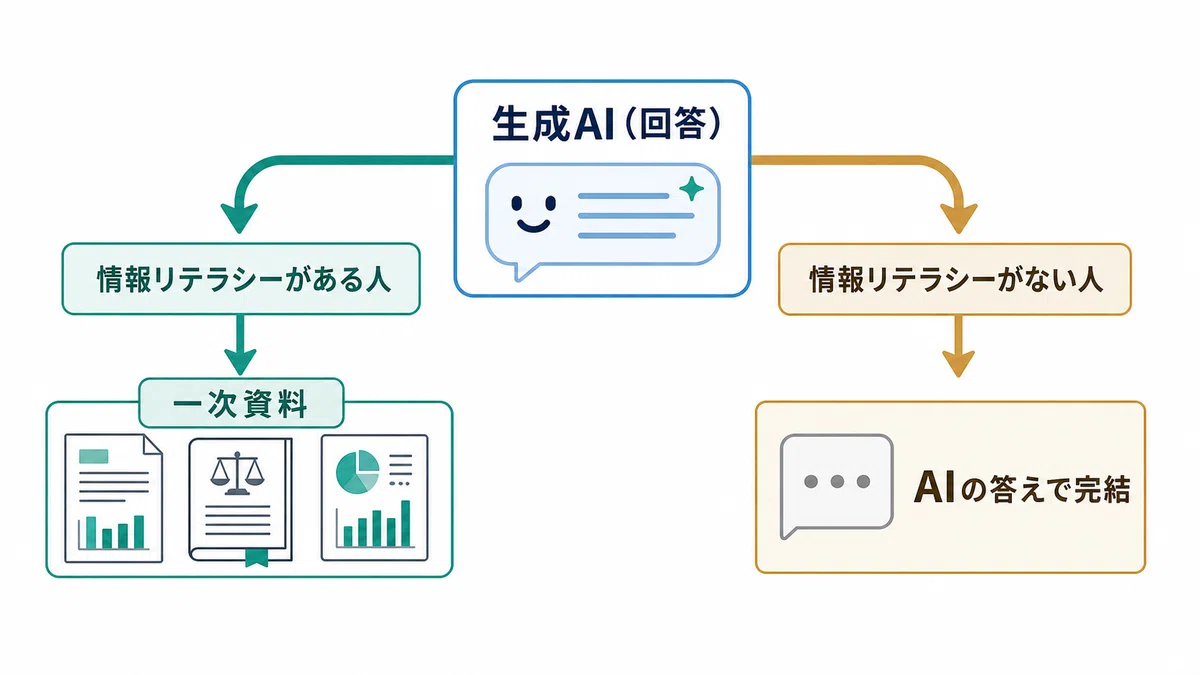
【補足説明】情報リテラシーについて
記事全体を通じて「情報リテラシー」という言葉が何度も登場します。情報リテラシーとは、必要な情報を的確に探し出し、その内容を批判的に評価し、目的に応じて活用する能力のことを指します。単に「ネット検索ができる」「スマホを使える」という技術的な能力だけを意味するのではありません。例えば「この情報は誰が発信しているか」「一次情報(元の文書・データ)か、それとも誰かがまとめた二次情報か」「反対意見や別の見解はないか」などを意識的に確認する姿勢・習慣を含みます。生成AIが普及した現在、AIの回答が「正しいかどうか」を自分で確認する能力がより重要になっています。AIは非常に流暢に、しかし時に誤った情報を答えることがあるため、情報リテラシーを持つ人はAIの回答を「検索窓口」として使いながら一次資料に戻って確認するという使い方ができます。図書館はこの能力を育てる場として期待されており、記事の論旨と深く関わっています。
※ この記事はChatGPTとの対話をもとに、筆者が感想等を追加し、編集して作成しています。
内容には検証をしていない知識が含まれます。
ある種のフィクションとして楽しんでいただければ幸いです。
