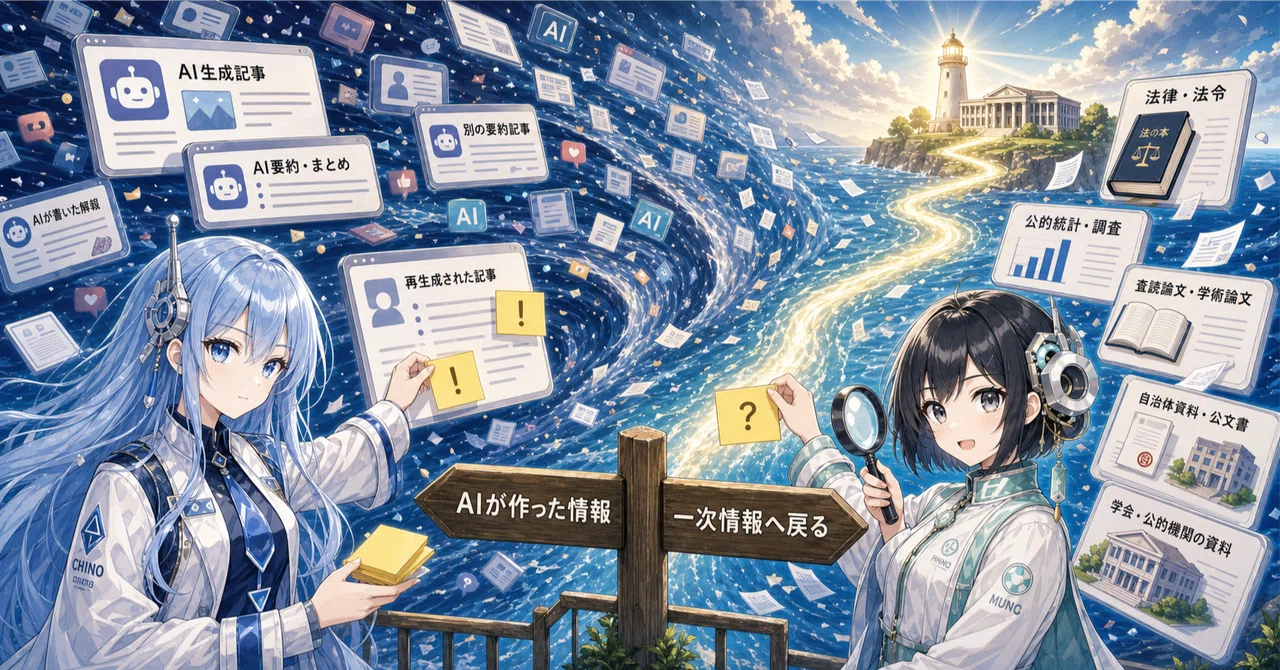
【好奇心のままAIに聞く[032]】インターネット上に生成AI作成の情報が溢れることについてどう思うか?

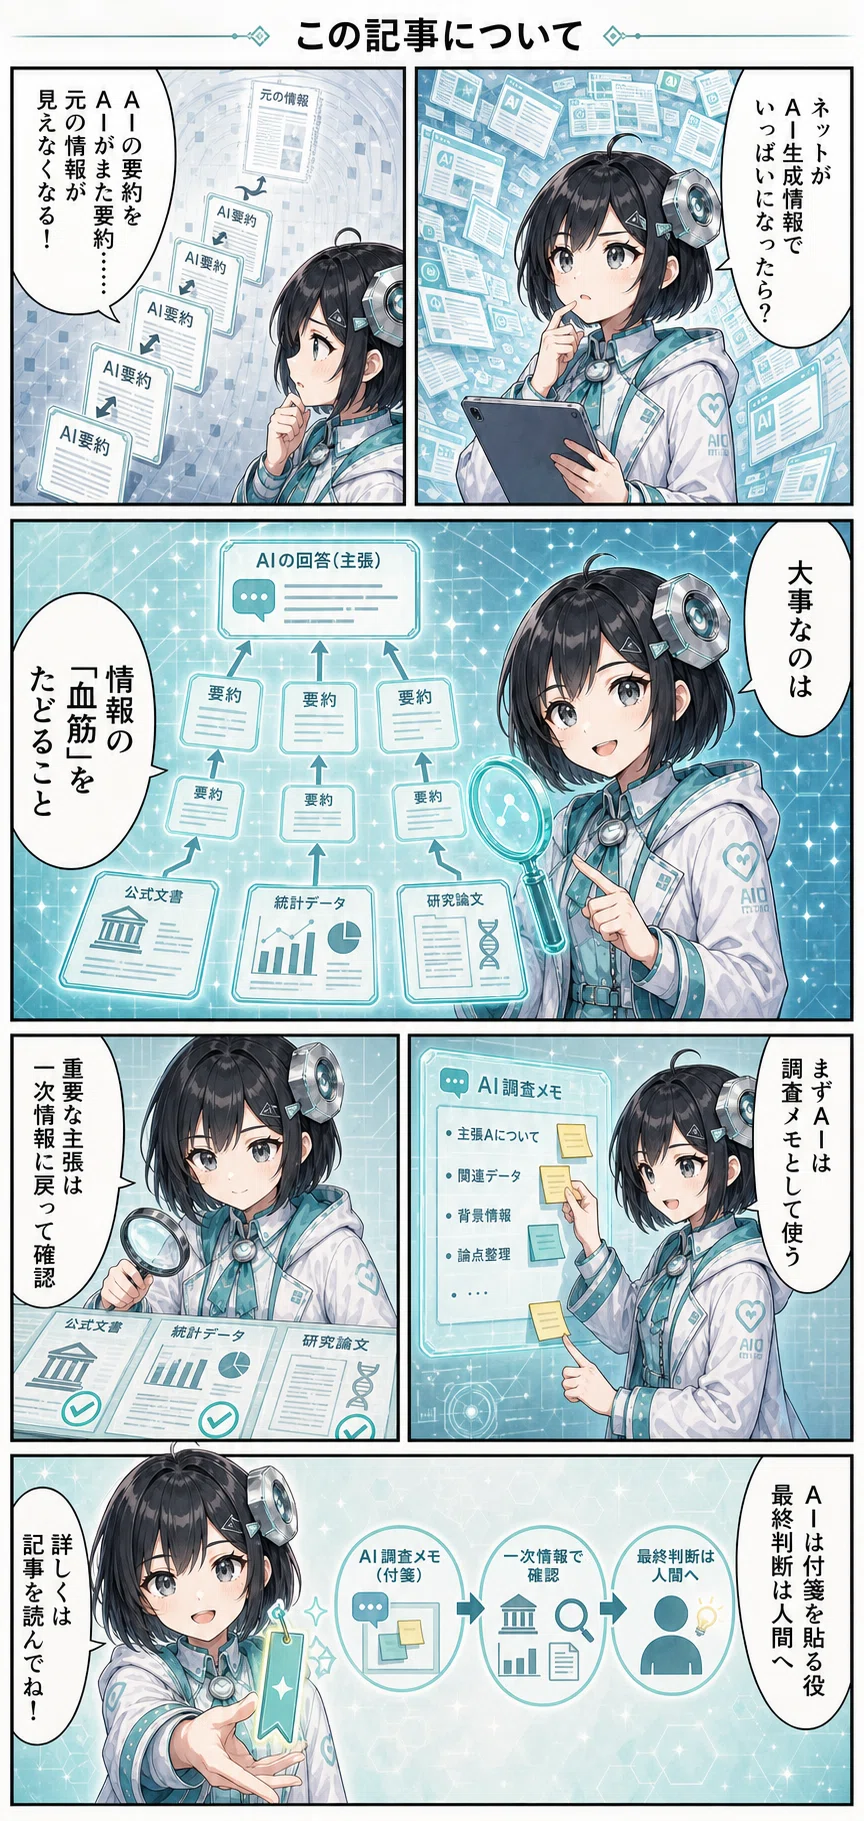
【前置き】
この記事は、筆者がChatGPTに日常の疑問を質問し、その回答をもとに、筆者が感想等を加えたものです。
AIの回答には誤りが含まれる可能性があります。
内容には検証をしていない知識が含まれます。
ご承知の上で、知的好奇心を刺激するある種のフィクションとしてお楽しみください。
「わかりやすさ」と「読みやすさ」を追求するため、以下の流れで記載しています。
1 私(人間)の質問【人間作成】
2 背景【人間作成】
3 AIが2名分のペルソナ(仮想人格)として対話をしつつ解説【AI作成】
(再質問がある場合、再質問として1、3を再実施)
4 私(人間)の感想【人間作成】
5 評価検証用AIが別のペルソナ(仮想人格)として質問と回答を検証・評価【AI作成】
チノーちゃん:解説役AI。基本的に質問には彼女に答えてもらいます。
ムーノちゃん:会話の相手役AI。チノーちゃんの解説への合いの手や、フォロー、補足をしてもらうためのAIです。
ヒョーカちゃん:質問回答そのものを評価検証する役のAI。チノーちゃんの解説、質問自体への評価をしてもらうためのペルソナです。検証・評価はClaudeにしてもらっています。
1 今回の質問
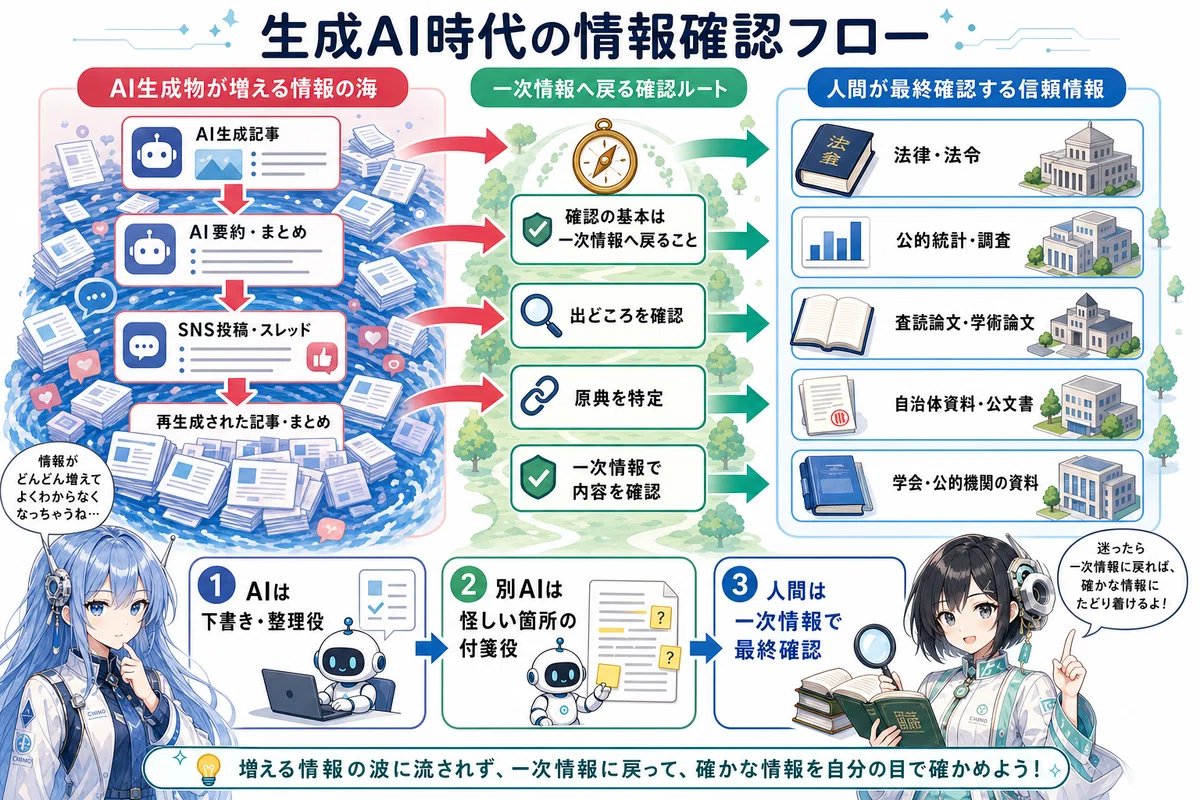
インターネット上に生成AIがまとめたり作った情報(生成物)が溢れると、1次情報ではなく『生成AIが作った情報』を元に別の生成AIがさらに『生成物』を作ることになり、それらが繰り返されることで『1次情報ではない情報』、つまり『信頼できない情報』が今以上にインターネット上に溢れるのではないかと懸念する意見があります。
これは実際に憂慮すべき事態なのでしょうか?
そして、どのように対応すべきでしょうか?
個人的には、『信頼できる認証ドメインからの情報だけを根拠とする』などの対応で、情報に一定の信頼性を持たせることはできると思うのですが・・・。
2 背景
【好奇心のままAIに聞いてみた】なんていうnote記事を作成している私が言うことではないですが、生成AI作成の文章・絵・動画が溢れる時代になりました。
正直、「じゃあ生成AIデータ氾濫前の状態は大丈夫なのか?」というと、人間が作った記事だって、嘘や思い込み等もたくさんあった訳で。
ただし、これまでは「嘘」や「思い込み」であっても、『作る側の労力』はあったワケです。それが圧倒的に簡単に『それっぽいサイト』ができるようになってしまった。
昔は相手をだましたり、広告するにしても「郵便物」として郵送料がかかっていた※ものが、電子メールによって「ただ同然」で「簡単に」大量送付できるようになったのと似ています。
※ 私が子どもの頃には、「おめでとうございます。懸賞が当たりました!カタログの承認をお得に購入可能です。」といって、「別に安くもない製品のカタログ」が送られてくる、なんて手法もあったのです。
私たちは、「スパムメール」を見分けるように、インターネットの情報やAIの作成した情報を見分ける目が必要とされるようになってきたのでは、と思ったのがきっかけです。
3 回答(チャットGPT)
(1)AI生成物がAI生成物を食べ続ける問題
【チノーちゃん】
結論から言うと、かなり憂慮すべき事態です。
ただし、「生成AIが作った情報=全部ダメ」という単純な話ではありません。問題は、一次情報・実測データ・現場記録・公式文書・専門家の検証から切り離された文章が、もっともらしい形で大量に増殖することです。
研究面では、AI生成物が次世代AIの訓練データに混ざり続けると、モデルの出力品質や現実認識が劣化する「model collapse」が起こり得ることが指摘されています。Nature掲載の2024年論文でも、生成モデルが作ったデータが次世代モデルの訓練データを汚染し、世代を重ねると現実の分布を誤って学ぶ問題が扱われています。
参照元:Nature「AI models collapse when trained on recursively generated data」
https://www.nature.com/articles/s41586-024-07566-y
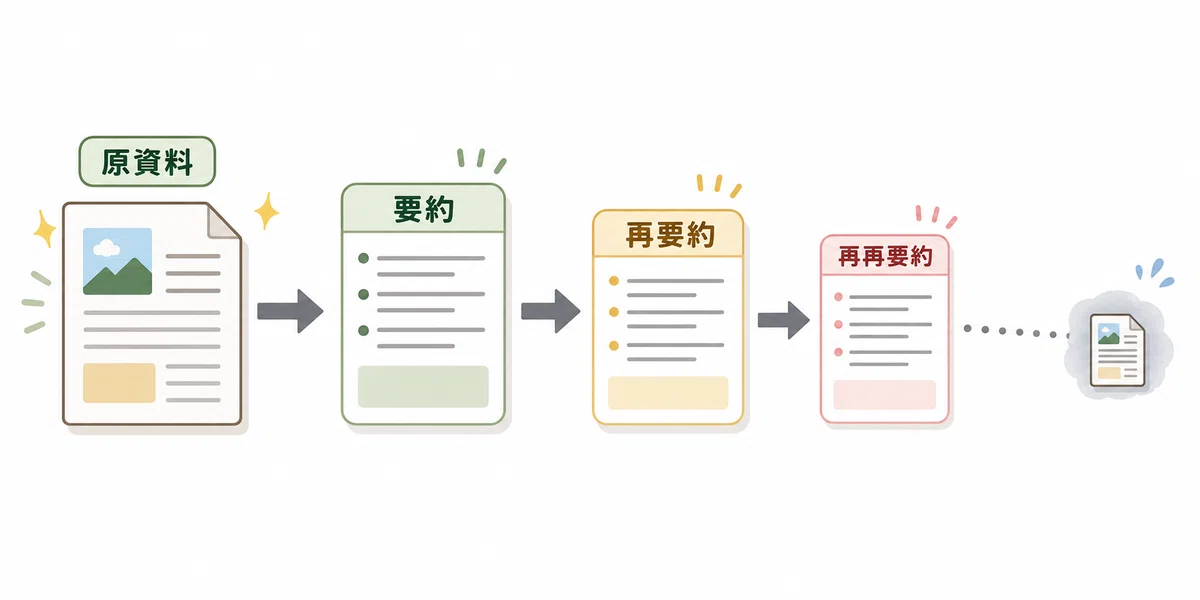
要するに、AIがAIの作った要約を食べ続けると、情報の栄養失調を起こすということです。雑に言えば、インターネットが「孫引きの孫引きの孫引き」だらけになる。
【ムーノちゃん】
それって、「AIが間違えるから危険」というより、間違いかどうかを確かめる元の情報に戻りにくくなるのが危ない、ということですね。
たとえば、ある制度についてAI記事ができる。別のAIがそれを要約する。さらに別のサイトがそれを再構成する。すると、最初の根拠だった法律・統計・論文・公式通知が見えなくなる。
見た目は整った文章なのに、実は「根拠の所在が消えた文章」になるわけですね。
【チノーちゃん】
そう。しかも悪質なのは、AI生成物は文体だけは妙に立派なことです。
昔のデマは、誤字だらけ・陰謀論っぽい・出典が怪しい、という手がかりがありました。今後は、間違った情報でも「行政資料風」「論文要約風」「専門家解説風」に整えられる。
これが怖い。
(2)信頼できるドメインだけで十分か
ただし、あなたの考えている「信頼できる認証ドメインからの情報だけを根拠にする」という方向性は、かなり妥当です。
ただし、それだけでは不十分です。理由は三つあります。
第一に、信頼できるドメインにも、二次情報・広報文・古い情報・誤記はある。
第二に、ドメイン名だけでは、内容の正確性までは保証できない。
第三に、AIが引用元を示していても、その引用が本当に本文の主張を支えているとは限らない。
ここを見落とすと、「公式っぽいところを引用しているから大丈夫」という、ちょっと危ない安心になります。
【ムーノちゃん】
まあまあ、でも「認証ドメインだけを根拠にする」は出発点としてはかなり良いですよね。
特に行政・医療・法律・統計・制度説明では、個人ブログやAIまとめサイトより、政府、自治体、学会、大学、査読論文、一次統計に戻るのは大事です。
ただ、「ドメインを見る」だけではなく、そのページが一次情報なのか、解説なのか、意見なのかまで見る必要がある、という感じでしょうか。
【チノーちゃん】
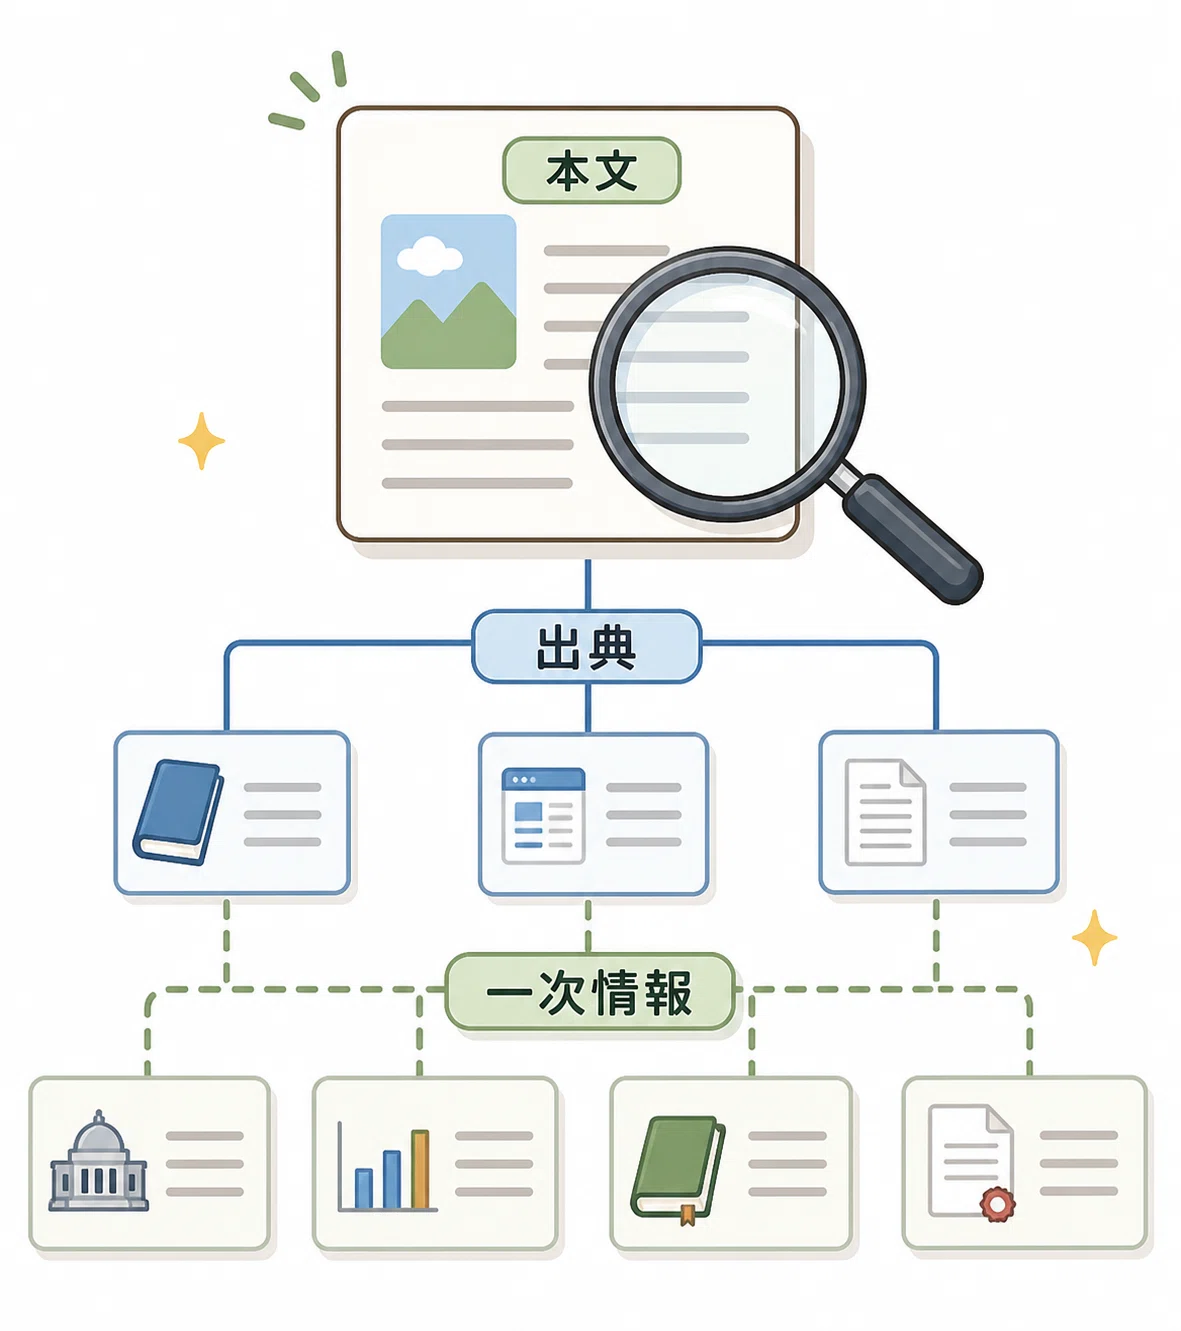
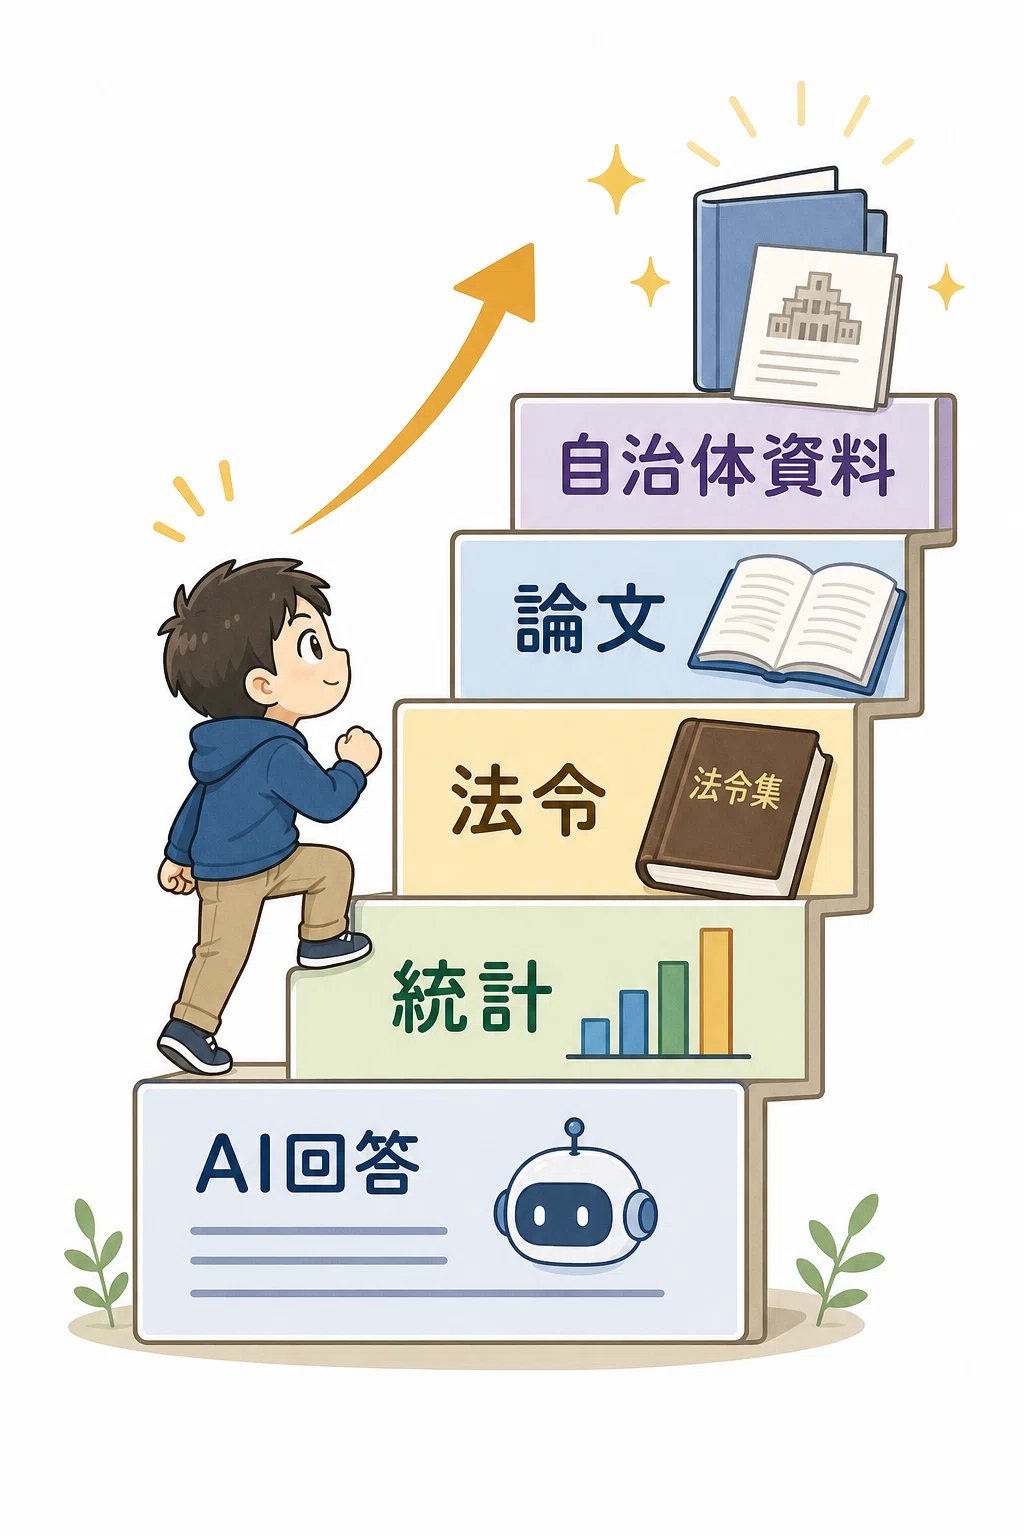
その通り。実務的には、情報源を次のように階層化するとよいです。
もっとも強い根拠は、法律本文、政省令、告示、公式統計、査読論文、一次データ、裁判例、公式マニュアル、原文資料です。
次に強い根拠は、官公庁・自治体・大学・学会・国際機関などによる解説資料です。
補助的に使う根拠は、新聞、専門メディア、業界団体、専門家の寄稿です。
注意して使う根拠は、まとめサイト、個人ブログ、SNS、出典不明のAI記事です。
そして、根拠にしてはいけないものは、「出典がないのに断定しているAI風記事」です。
【ムーノちゃん】
つまり、今後のネット検索は、単に「検索上位を見る」ではなく、情報の血筋を見る必要があるんですね。
「この文章は、どこから来たのか?」
「元のデータは何か?」
「誰が、いつ、何の責任で出したのか?」
このあたりが大事になる。
(3)来歴証明・電子署名・ウォーターマーク
【チノーちゃん】
ここで重要になるのが、来歴証明・電子署名・コンテンツ認証です。
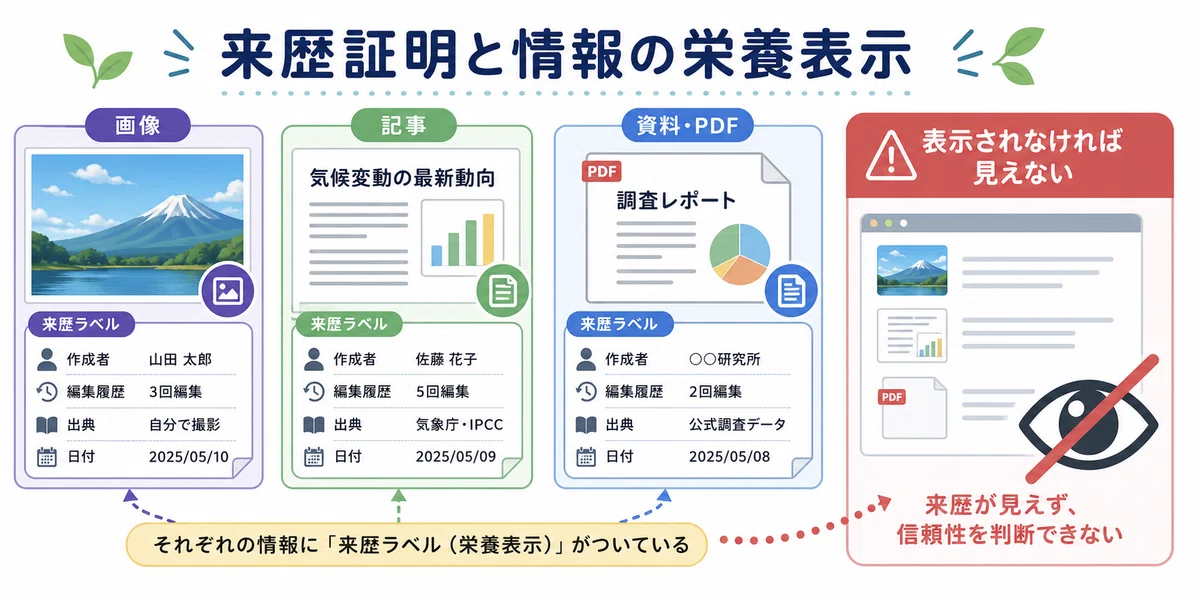
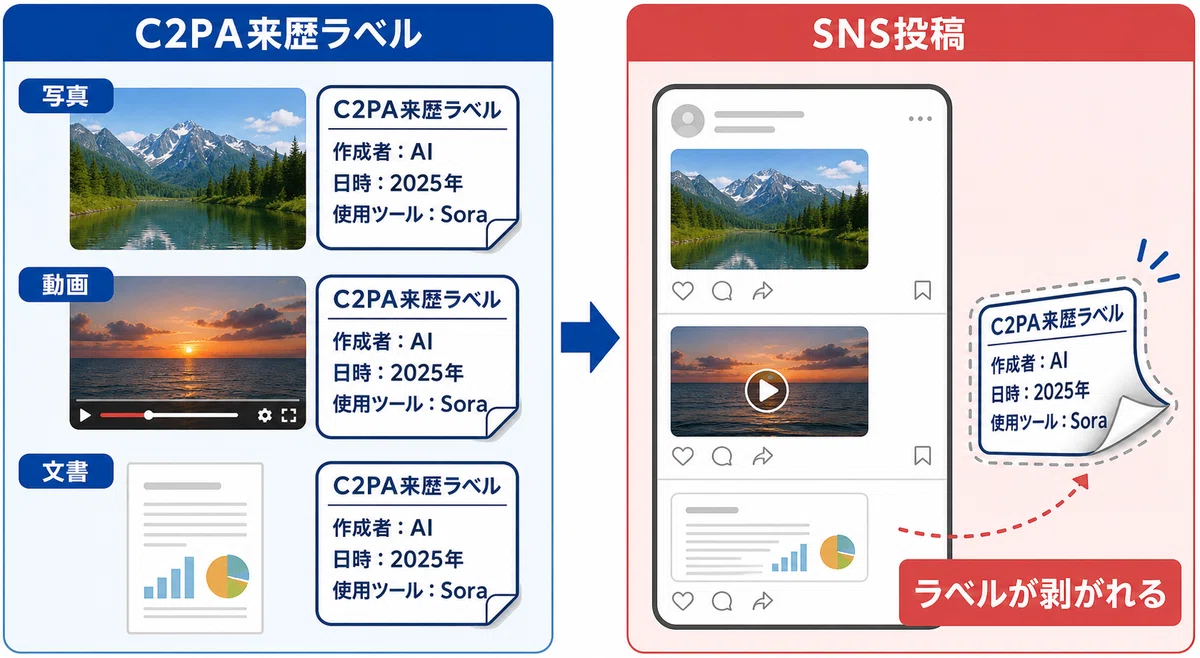
たとえばC2PAは、画像や動画などのデジタルコンテンツに「どこで作られ、どう編集されたか」を示すContent Credentialsのような仕組みを提供しようとしています。C2PA自身も、Content Credentialsをデジタルコンテンツの「栄養表示」のようなものだと説明しています。
参照元:C2PA
https://c2pa.org/
ただし、これも万能ではありません。2026年の独立研究では、C2PA仕様について、現時点では高リスク用途、たとえば法的証拠・報道・金融開示などで過信すべきではないという批判的分析も出ています。
参照元:arXiv「SoK: Not Quite a Trust Machine: Perils of Propagating C2PA in High-Stakes Data」
https://arxiv.org/abs/2604.24890
さらに、実際のSNSやプラットフォームが来歴情報を保持・表示しなければ、せっかくの認証情報もユーザーに届きません。報道では、AI動画に埋め込まれたContent Credentialsが主要SNSで十分表示されなかった事例も報じられています。
参照元:The Washington Post
https://www.washingtonpost.com/technology/2025/10/22/ai-deepfake-sora-platforms-c2pa/
【ムーノちゃん】
なるほど。
「認証技術があるから安心」ではなく、
作る側が付ける
配信側が消さない
見る側が確認できる
制度や運用で支える
ところまで揃わないといけないんですね。
【チノーちゃん】
そうです。さらに、AI透かし、つまりウォーターマークも議論されています。AI生成物を識別するための有力な方法ではありますが、研究整理では、ウォーターマークは有望だが万能ではなく、攻撃・変換・削除・再生成への耐性などが課題だとされています。
参照元:arXiv「A Survey of Text Watermarking in the Era of Large Language Models」
https://arxiv.org/abs/2411.18479
つまり、「AI生成物を完全に見分ける魔法の印」はまだない。ここを勘違いすると危ない。
(4)個人や職場での現実的対応
【ムーノちゃん】
では、個人や職場ではどう対応するのが現実的ですか?
【チノーちゃん】
対応は、かなり実務的に分けられます。
まず、AIに調べさせるときは「一次情報に限定」と明示する。
たとえば、
「政府・自治体・学会・査読論文・公式統計のみを根拠にして」
「ブログやまとめサイトは使わないで」
「根拠URLと、どの記述を根拠にしたかを示して」
と指定する。
次に、AIの答えを最終回答にしない。
AIの回答は「調査メモ」や「論点整理」として扱い、重要部分は元資料で確認する。特に、法律、医療、福祉制度、補助金、契約、統計、歴史的事実は、一次資料確認が必要です。
第三に、引用の質を見る。
URLがあるかではなく、
「そのURLは一次情報か」
「本文中に本当にその内容が書いてあるか」
「日付は古くないか」
「別の一次情報と矛盾しないか」
を見る。
ここをサボると、AIの引用つき幻覚に引っかかります。辛口に言えば、URLが付いているだけで安心するのは、名札を付けた詐欺師を信用するようなものです。
【ムーノちゃん】
言い方はきついですが、大事ですね。
特に行政や職場の資料だと、「どこに書いてあるのか」を聞かれることが多いので、AIの説明だけでは足りない。
「この考え方は、この省庁資料のこの部分に基づく」まで戻れるようにしておく必要がある。
【チノーちゃん】
組織としては、次の対応が現実的です。
一つ目は、信頼ドメインリストを作ること。
官公庁、自治体、国会、裁判所、学会、大学、国際機関、公式統計サイトなどを優先する。
ただし、「信頼ドメインなら全部正しい」ではなく、一次情報・解説・広報・古い資料を区別する。
二つ目は、AI利用ルールを作ること。
「AI出力をそのまま根拠資料にしない」
「外部説明資料では出典を明示する」
「制度・法令・金額・期限は原典確認する」
「生成AIで作った文章は、人間が責任を持って確認する」
こういう運用が必要です。NISTのAIリスク管理フレームワークも、AIリスクを組織的に管理する枠組みとして、ガバナンス、測定、管理などの考え方を示しています。
参照元:NIST AI Risk Management Framework
https://www.nist.gov/itl/ai-risk-management-framework
三つ目は、検索の仕方を変えること。
普通に検索するとAIまとめ記事が上がってくるなら、
「site:go.jp」
「site:lg.jp」
「site:ac.jp」
「filetype:pdf」
「白書」「統計」「報告書」「ガイドライン」
などを組み合わせる。
これはかなり効きます。
四つ目は、情報の更新日を管理すること。
AI生成物の厄介な点は、古い情報を新しい文体で出せることです。制度改正がある分野では、作成日・更新日・適用日を必ず見るべきです。
【ムーノちゃん】
個人向けには、こういう感じでしょうか。
「AIに聞く」
↓
「答えの全体像をつかむ」
↓
「重要な主張だけ一次情報に戻る」
↓
「複数の信頼できる情報源で照合する」
↓
「不明なところは不明と残す」
これなら、AIを使いながらも、AI生成物の沼に沈みにくいですね。
(5)これからの情報空間は二層化する
【チノーちゃん】
その流れでよいです。
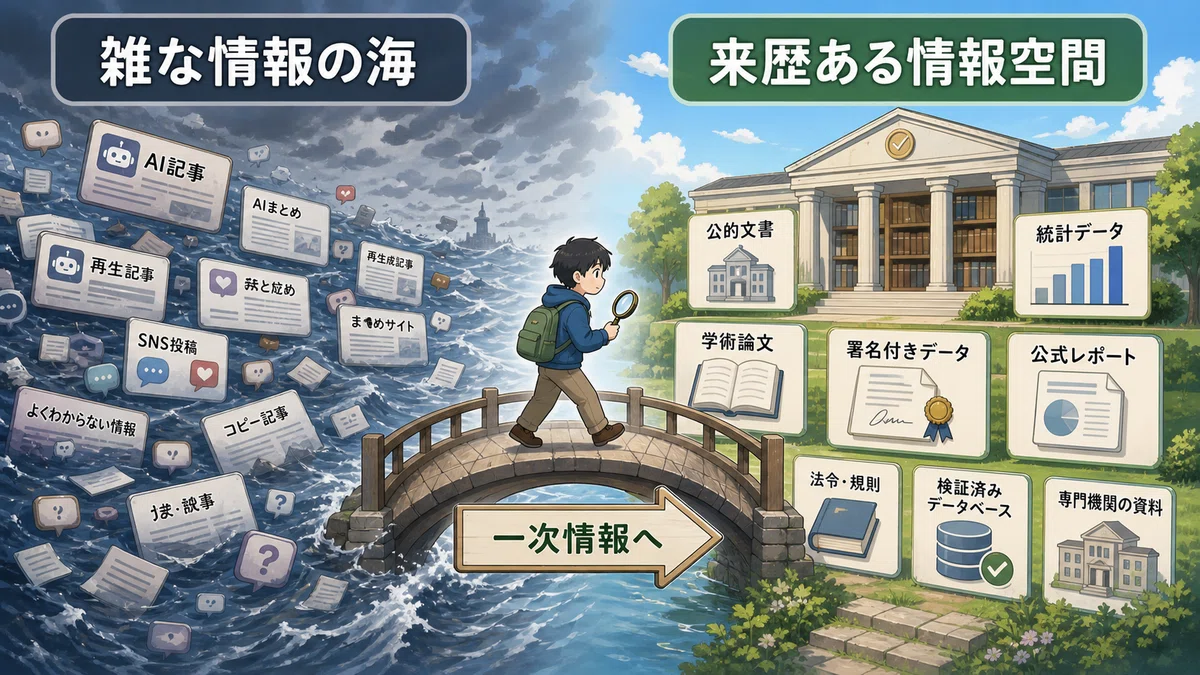
そして、今後はおそらくインターネット全体が二層化します。
一つは、雑な情報の海。
AI記事、SEO記事、SNS投稿、要約の再要約、真偽不明の画像・動画が流れ続ける領域です。
もう一つは、来歴のある情報空間。
公式文書、署名付きデータ、査読論文、行政統計、認証済みメディア、出典管理されたデータベースです。
問題は、前者の量が圧倒的に増えること。OECDも、生成AIを含むデジタル情報環境が偽情報・情報操作のリスクを高めており、透明性や多様で独立した情報源へのアクセスが重要だと述べています。
参照元:OECD
https://www.oecd.org/en/about/news/press-releases/2024/03/more-action-needed-to-tackle-disinformation-and-enhance-transparency-of-online-platforms-oecd.html
【ムーノちゃん】
つまり、インターネット全体を信じる時代から、どの情報経路を信じるかを設計する時代になるわけですね。
【チノーちゃん】
そう。
あなたの考えた「信頼できる認証ドメインからの情報だけを根拠にする」は、かなり有効です。
ただし、完成形はこうです。
信頼できるドメインを見る。
一次情報かどうかを見る。
更新日を見る。
著者・責任主体を見る。
根拠データを見る。
複数情報源で照合する。
AIの回答は下書き・整理役に留める。
ここまでやれば、生成AI時代でも情報の信頼性はかなり確保できます。
【ムーノちゃん】
では、最後に一言でまとめると?
【チノーちゃん】
憂慮すべきだが、絶望する必要はない。
ただし、これからの情報リテラシーは「文章を読む力」では足りません。
必要なのは、情報の出どころを追跡する力です。
【ムーノちゃん】
AIを使わない、ではなく、
AIに調べさせるけれど、根拠は人間が一次情報まで戻す。
これが現実的な付き合い方ですね。
【チノーちゃん】
その通り。
生成AI時代の合言葉は、たぶんこれです。
「うまく書かれているか」ではなく、「どこから来た情報か」を見る。
4 再質問(私)
ありがとうございます。
確認の手間が増えますが、全部人力でやっていたときと比べれば省力化しているので、これは仕方のないことなのでしょうね。
【再質問】
『ある生成AI』が作成した情報を『別の生成AI』にチェックさせる手法は有効でしょうか?
最終的には人間のチェックは欠かせないと思いますが、『怪しい部分』を洗い出せれば、確認に割く時間を省力化できる気がします。
5 再回答(チャットGPT)
(1)別AIチェックは有効だが、役割を間違えてはいけない
【チノーちゃん】
有効です。
ただし、位置づけを間違えると危ないです。
正しくは、**「別の生成AIに真偽判定を任せる」ではなく、「別の生成AIに監査メモを作らせる」**です。
ここを間違えると、「AIの出力をAIが保証したから大丈夫」という、かなり雑な二重チェックになります。辛口に言えば、酔っ払いに酔っ払いの足取りを採点させるようなものです。
【ムーノちゃん】
まあまあ。
でも、使い方を限定すればかなり便利ですよね。
人間が全部を最初から読むのではなく、AIに「怪しい主張」「根拠が必要な箇所」「日付確認が必要な箇所」「数字が出ている箇所」を拾わせる。
それなら、人間の確認作業をかなり絞れます。
【チノーちゃん】
その通りです。
特に効果があるのは、次のようなチェックです。
1 事実主張の抽出
文章の中から、確認すべき主張を抜き出す。
たとえば「○○年に制度が始まった」「死亡率は○%」「この法律では○○と定められている」などです。
2 根拠不足の発見
「この断定には出典が必要です」
「この数値は出典なしでは危険です」
「この比較は基準が曖昧です」
といった箇所を拾う。
3 内部矛盾の発見
前半では「増加している」と書き、後半では「減少傾向」と書いている。
日付や制度名が途中で変わっている。
こういう文章内の矛盾は、AIチェックがかなり得意です。
4 古くなりやすい情報の発見
法令、制度、補助金、医療ガイドライン、統計、価格、役職者、製品仕様など。
「これは最新確認が必要」とフラグを立てさせる使い方です。
5 一次情報に戻すべき箇所の分類
「これは公式統計で確認」
「これは法律本文で確認」
「これは自治体要綱で確認」
「これは査読論文で確認」
というように、確認先の種類を分けさせる。
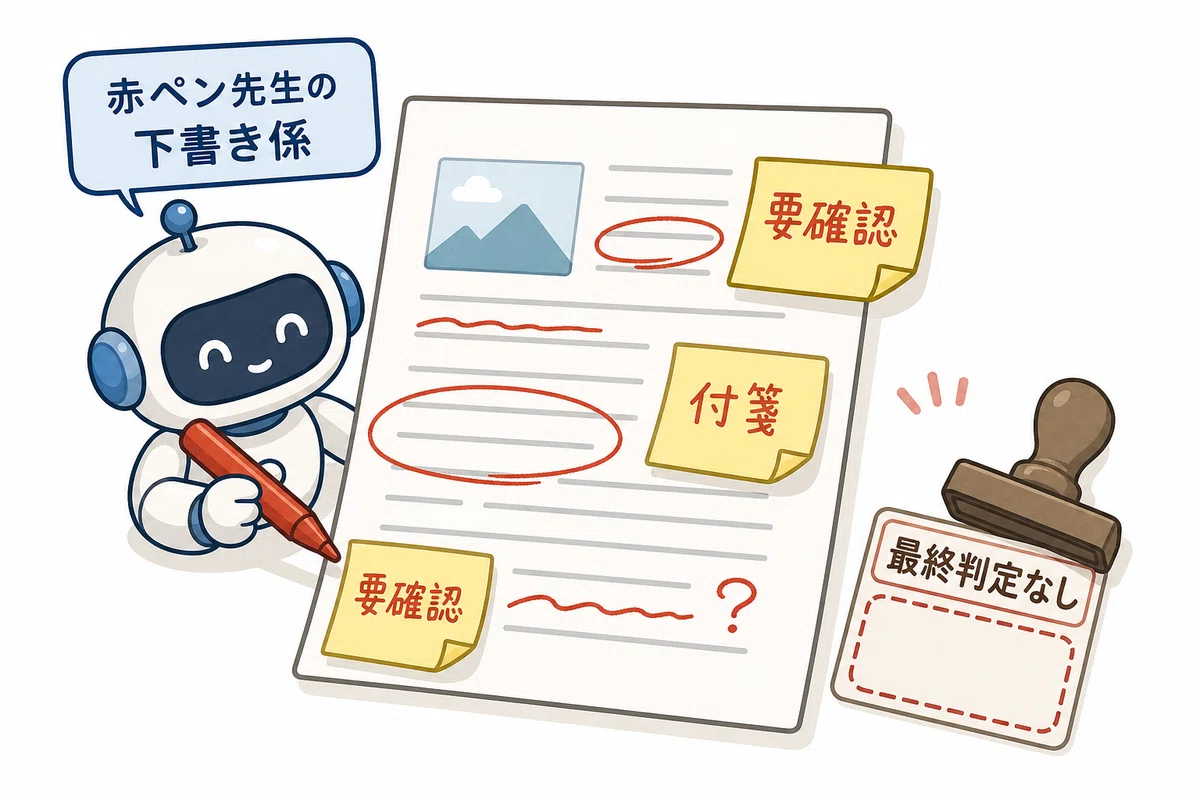
【ムーノちゃん】
つまり、「答え合わせ係」ではなく、赤ペン先生の下書き係ですね。
怪しい場所に付箋を貼ってもらう感じです。
【チノーちゃん】
そうです。
研究面でも、LLMによる自己チェックや別モデルチェックには一定の有効性がある一方、万能ではないことが示されています。たとえばSelfCheckGPTは、同じモデルに複数回答を出させ、内容の食い違いから幻覚を検出する考え方を示しています。事実でない内容は、複数回生成したときに揺れやすい、という発想です。
参照元:arXiv「SelfCheckGPT」
https://arxiv.org/abs/2303.08896
また、KnowHaluのように、推論分解、知識検索、判断の統合を組み合わせて幻覚検出を行う研究もあります。単に「AIに合ってる?」と聞くより、確認プロセスを分けたほうが有効だという方向です。
参照元:arXiv「KnowHalu」
https://arxiv.org/abs/2404.02935
【ムーノちゃん】
ただ、「別AIが正しいと言ったから正しい」ではないんですね。
【チノーちゃん】
そこが一番大事です。
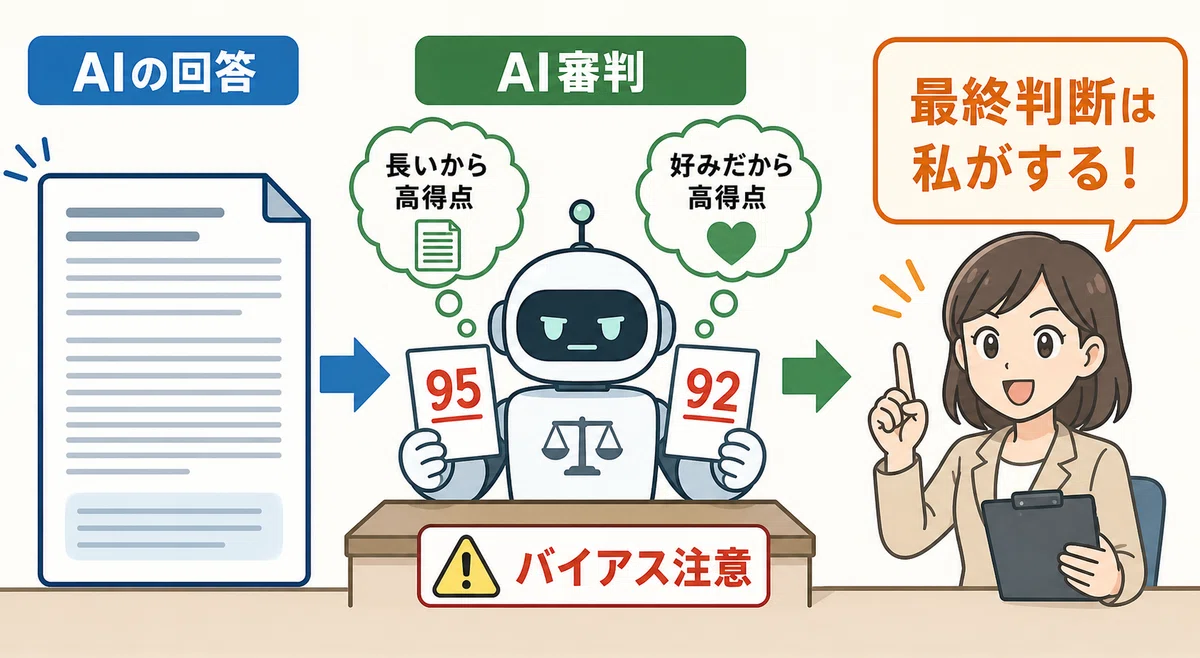
LLMを評価者として使う、いわゆる「LLM-as-a-Judge」には、回答の長さ、順番、文体、フォーマット、モデル自身の知識の偏りなどによるバイアスがあると指摘されています。2025年の研究でも、人間による根拠づけなしにLLMを評価者として使う限界が論じられています。
参照元:arXiv「LLM-as-a-Judge」関連研究
https://arxiv.org/html/2503.05061v1
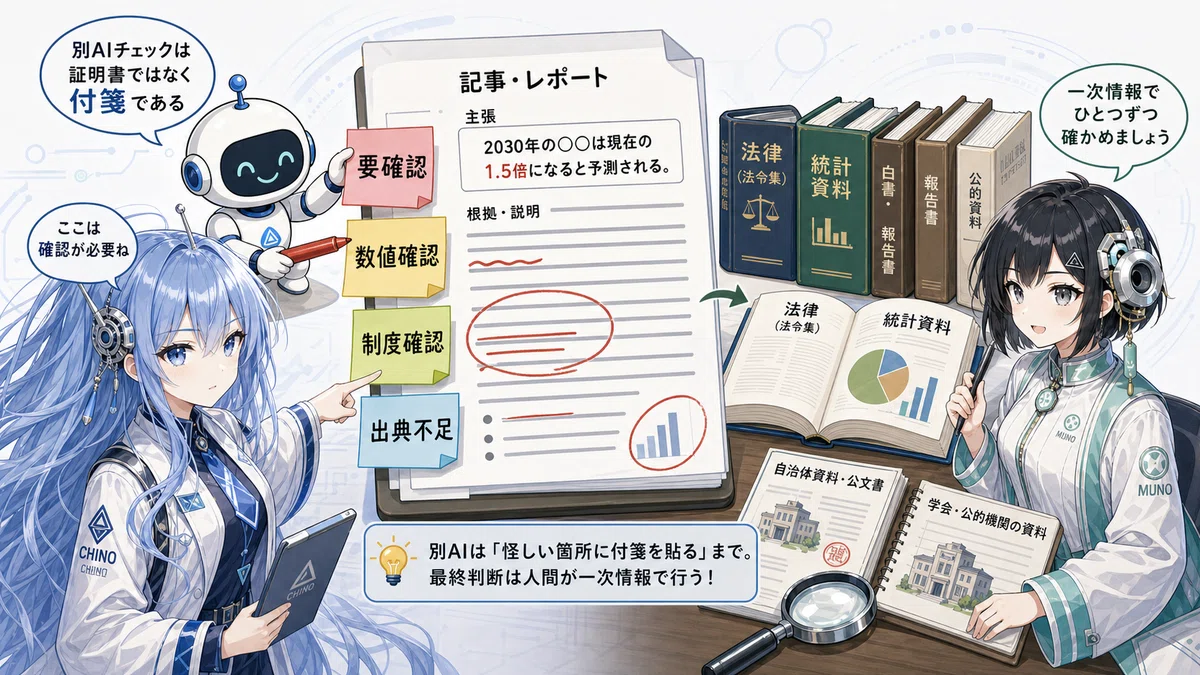
つまり、別AIチェックは検査機にはなりますが、証明書にはなりません。
(2)実務で使う場合の流れ
【ムーノちゃん】
では、実務で使うなら、どういう流れがよさそうですか?
【チノーちゃん】
おすすめは、次の流れです。
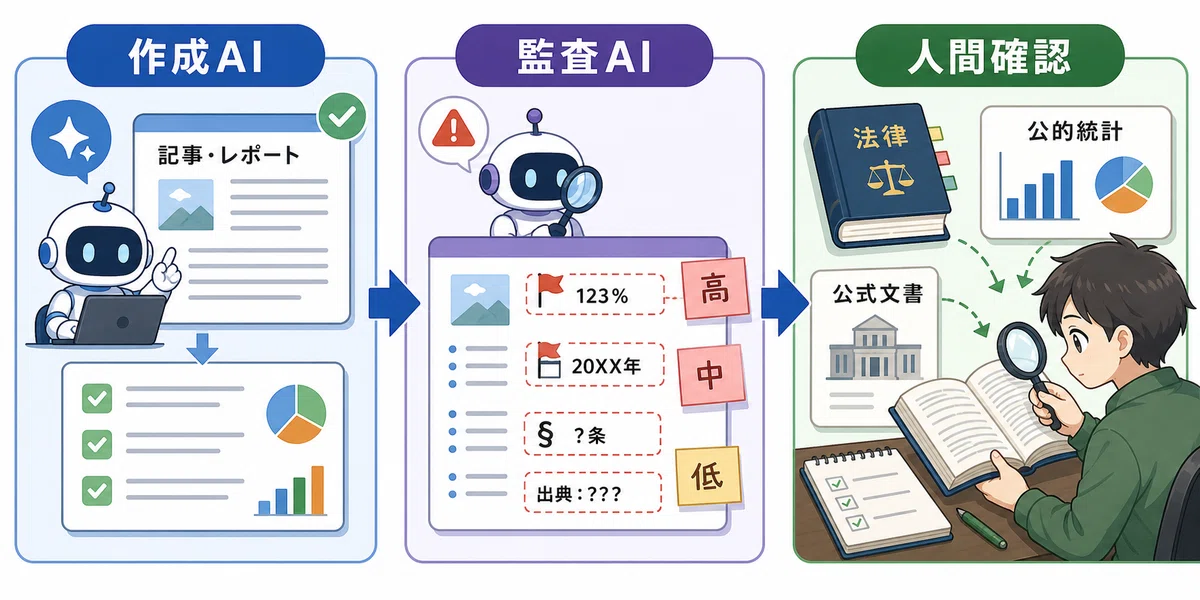
第1段階:作成AIに文章を作らせる
ここでは、普通に説明文や資料案を作る。
第2段階:チェックAIには「正しいか?」ではなく「検証すべき主張を抜き出せ」と頼む
この聞き方が重要です。
「この文章は正しいですか?」はダメです。AIが雰囲気で丸をつけます。
「本文中の事実主張をすべて抜き出し、検証優先度をつけてください」と頼むほうがよいです。
第3段階:チェックAIにリスク分類させる
分類は、たとえば次のようにします。
・法令、制度、補助金、期限、金額
・統計、割合、人数、ランキング
・医学、健康、安全
・歴史的事実、年号、人名
・原因と結果の説明
・一般論、推測、意見
このうち、人間が優先して確認すべきなのは、法令・制度・数字・医療・安全・金額・期限です。
第4段階:確認先を指定させる
「この主張は、どの種類の一次情報で確認すべきか」まで出させる。
ここで「URLを出して」と頼む場合もありますが、AIが存在しないURLや関係ないURLを出すことがあるので、最後は人間が開いて確認します。
第5段階:人間が高リスク箇所だけ確認する
全部読むのではなく、AIが付箋を貼った箇所から確認する。
これなら省力化になります。
【ムーノちゃん】
かなり現実的ですね。
「人間のチェックをなくす」のではなく、人間が見るべき場所を減らすという発想ですね。
【チノーちゃん】
そうです。
そして、チェックAIへの指示は少し厳しめにしたほうがいいです。たとえば、こうです。
> あなたは本文の正しさを保証する役ではありません。
> 本文から、事実確認が必要な主張を抜き出してください。
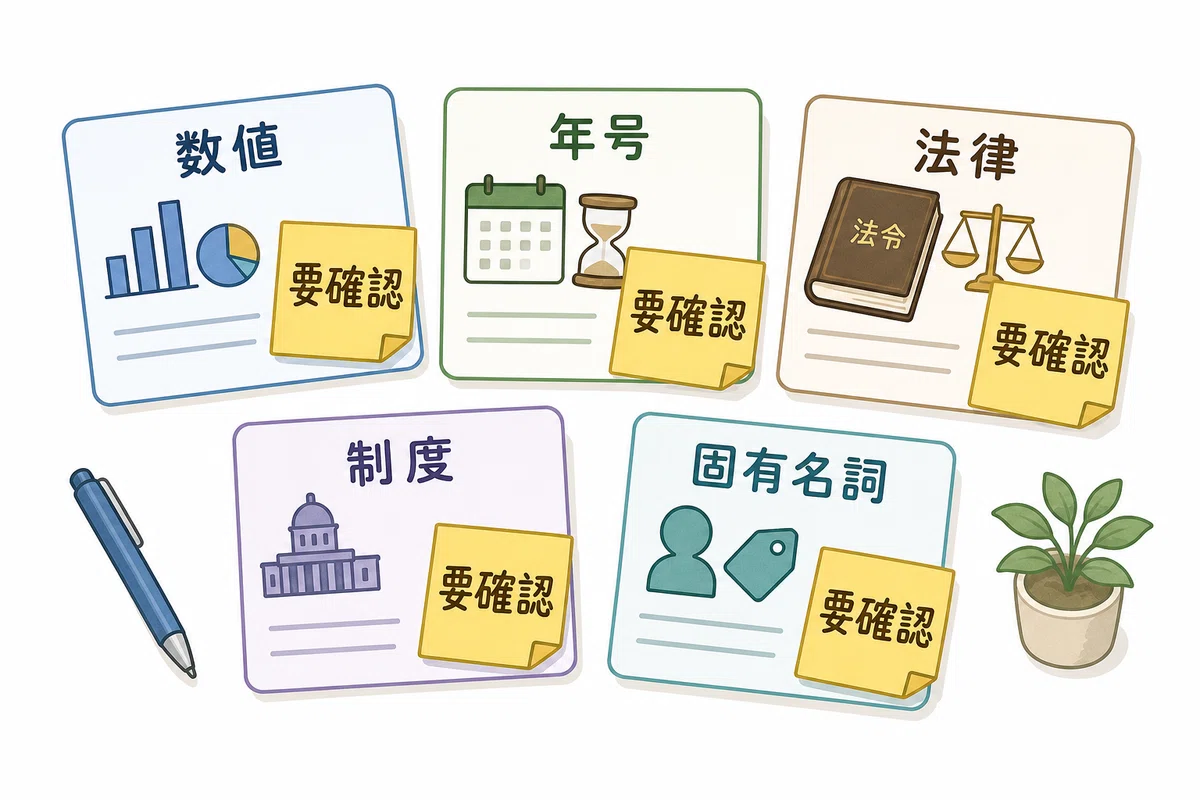
> 特に、数値、年号、法律、制度、医学、統計、固有名詞、因果関係、比較表現を優先してください。
> 各項目について、確認優先度を「高・中・低」で分類し、確認すべき一次情報の種類を示してください。
> 出典がない断定、古くなりやすい情報、曖昧な比較、過剰な一般化を指摘してください。
> 分からない場合は、正しいと推測せず「要確認」としてください。
【ムーノちゃん】
これはそのまま使えそうですね。
特に「正しいと推測せず、要確認とする」が大事そうです。
【チノーちゃん】
もう少し実務向けにするなら、出力形式はこうです。
・確認すべき記述
・なぜ怪しい、または確認が必要か
・リスクの種類
・確認優先度
・確認すべき一次情報
・人間が確認するときの検索語
この形式にすると、確認作業がかなり速くなります。
【ムーノちゃん】
たとえば行政資料なら、
「制度名」「根拠法令」「対象者」「金額」「期限」「申請方法」「自治体独自部分」
あたりをAIに重点チェックさせるとよさそうですね。
【チノーちゃん】
はい。行政・福祉・医療・法律系では、特に次の言葉が出たらチェック対象です。
「必ず」
「義務」
「違法」
「対象となる」
「対象外」
「○万円」
「○日まで」
「全国で」
「多くの自治体で」
「一般的に」
「研究で証明されている」
「原因は○○である」
こういう断定語は、AIが勢いで書きがちです。
人間が読むと自然に見えても、根拠が薄い場合があります。
(3)別AIチェックが苦手なこと
【ムーノちゃん】
逆に、別AIチェックが苦手なことは何ですか?
【チノーちゃん】
主に五つあります。
一つ目は、元情報がないと真偽までは分からないこと。
AIは文章の不自然さは見抜けても、現実の最新制度や統計を自動的に保証できません。
二つ目は、同じような学習データや癖を持つAI同士だと、同じ間違いを見逃すこと。
モデルが違っても、ネット上の同じ誤情報を学んでいる可能性があります。
三つ目は、もっともらしい説明に弱いこと。
文章が整っていると、チェックAIも納得してしまう場合があります。
四つ目は、細かい制度差に弱いこと。
国制度と自治体独自制度、旧制度と新制度、一般論と例外規定の違いなどです。
五つ目は、引用チェックが甘いこと。
「その出典は実在するか」だけでなく、「その出典が本当にその主張を支えているか」までは、別途確認が必要です。
【ムーノちゃん】
なるほど。
だから、AIチェックを入れるなら、できれば「別モデル」だけでなく「別の観点」も必要なんですね。
【チノーちゃん】
非常に重要です。
単に「A社AIで作ったものをB社AIで確認」より、以下のように役割を分けるほうが効果的です。
作成AI:分かりやすい文章を作る。
監査AI:事実主張を抜き出す。
批判AI:過剰な断定・論理の飛躍を指摘する。
出典AI:一次情報の候補を探す。
人間:高リスク箇所を原典で確認し、最終判断する。
【ムーノちゃん】
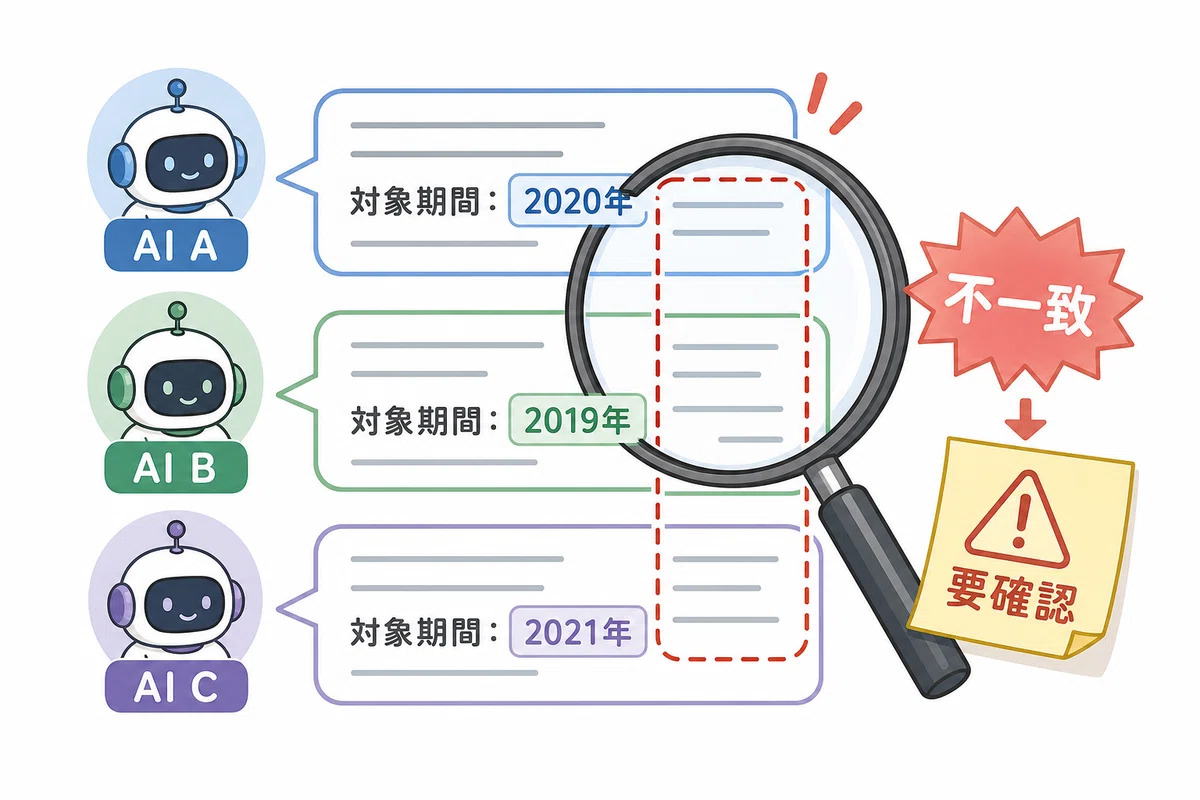
AI同士の多数決はどうですか?
3つのAIが同じことを言えば信頼できる、みたいな。
【チノーちゃん】
補助にはなりますが、過信は禁物です。
複数AIが同じ誤情報を共有している可能性があります。特に、ネット上に広まった誤解や古い定説は、複数モデルが同じように答えることがあります。
ただし、**AIごとの回答が食い違った部分は、かなり有力な「要確認ポイント」**です。
つまり、多数決よりも、不一致検出に価値があります。
【ムーノちゃん】
「あっているか」より、
「AI同士で答えが割れたところを見る」
ということですね。
【チノーちゃん】
そうです。
生成AIチェックで一番使えるのは、実は「正解判定」ではなく、違和感検出・不一致検出・確認優先度づけです。
(4)リスク別の使い方
【ムーノちゃん】
最終的なおすすめはどうなりますか?
【チノーちゃん】
こうです。
低リスク文書、たとえば雑談記事、一般的な解説、アイデア出しなら、別AIチェックはかなり有効です。
人間は気になったところだけ確認すればよい。
中リスク文書、たとえば職場資料、研修資料、住民向け説明、note記事なら、別AIチェックで怪しい部分を洗い出し、数値・固有名詞・制度・引用だけ人間が確認する。
高リスク文書、たとえば法令解釈、医療、契約、補助金、対外的な公式説明、議会答弁、金額や期限を伴う資料では、別AIチェックは使ってよいが、最終的には必ず一次情報で人間確認する。
NISTのAIリスク管理フレームワークも、AIリスクは組織として管理し、測定・管理・ガバナンスを組み合わせて扱う考え方を示しています。
参照元:NIST AI Risk Management Framework
https://www.nist.gov/itl/ai-risk-management-framework
【ムーノちゃん】
つまり、別AIチェックは「確認作業の代替」ではなく、確認作業の前処理ですね。
【チノーちゃん】
その表現が一番正確です。
あなたの発想は妥当です。
ただし、設計はこうしたほうがいい。
「AIにAIをチェックさせる」ではなく、
「AIに、人間がチェックすべき場所を見つけさせる」。
これならかなり有効です。
そして現実的には、全部人力で一から確認するより、かなり省力化できます。
【ムーノちゃん】
最後に、実際に使うときの短い指示文をまとめると?
【チノーちゃん】
こうです。
> 次の文章について、正誤を断定せず、事実確認が必要な箇所を抽出してください。
> 数値、年号、法律、制度、固有名詞、医学・安全、統計、因果関係、比較表現を優先してください。
> 各項目について、確認優先度を高・中・低で示し、確認すべき一次情報の種類と検索語を提案してください。
> 出典がない断定、古くなりやすい情報、過剰な一般化、本文内の矛盾も指摘してください。
> 不明な場合は、正しいと推測せず「要確認」としてください。
【ムーノちゃん】
この指示なら、「AIが保証する」のではなく、「AIが付箋を貼る」使い方になりますね。
【チノーちゃん】
はい。
結論はこれです。
別AIチェックは有効。
ただし、真偽の最終判定ではなく、怪しい箇所を洗い出すために使う。
人間は、その洗い出された高リスク箇所だけを一次情報で確認する。
これが、生成AI時代のかなり現実的な確認手順です。
6 感想(私)
「酔っ払いに酔っ払いの足取りを採点させるようなもの」ですか。
残念ですが、確かにその通りです。
そこまで手を抜いてはいけませんね。
インターネット黎明期にも、まず最初に好き勝手できる時代があり、その後ルールが作られ、セキュリティ対策も整っていきました。
生成AIについても、今からルールが作られるフェーズが来るのでしょう。
その時は『何で不便にするんだ』と思ってしまうことはあるでしょうけれど、社会全体を壊さないための必要なコストだと思うべきなのでしょう。
今は、それまでの『好き勝手している時代』であると思われるため、自分を守るためにはこれくらいの手間は必要、ということだと思います。
7 内容と質問の評価(Claude)
【ヒョーカちゃん】
以下の4軸でこの記事をチェックしました。
① 事実検証
■ 検証1:model collapseに関するNature 2024論文
記事では「AI生成物が次世代AIの訓練データに混ざり続けると、モデルの出力品質や現実認識が劣化する『model collapse』が起こり得る……Nature掲載の2024年論文でも……」と記載されています。
判定:正確です。
Nature誌掲載論文「AI models collapse when trained on recursively generated data」(Shumailov et al., 2024、volume 631, pages 755–759)は実在が確認できました。AI生成データを再帰的に訓練データとして使い続けると、分布の端(tail)が失われ「model collapse」が生じることを示した論文で、記事の記述は内容と整合しています。
→ 検証:https://www.nature.com/articles/s41586-024-07566-y
■ 検証2:C2PAとContent Credentials
記事では「C2PAは、画像や動画などのデジタルコンテンツに『どこで作られ、どう編集されたか』を示すContent Credentialsのような仕組みを提供しようとしています。C2PA自身も、Content Credentialsをデジタルコンテンツの『栄養表示』のようなものだと説明しています」と記載されています。
判定:正確です。
C2PA(Coalition for Content Provenance and Authenticity)は2021年設立の標準化団体として実在し、Content Credentialsは「nutrition labels for digital media(デジタルメディアの栄養表示)」という説明が公式サイト等でも使われています。Adobe、Microsoft、OpenAI、Meta、BBCなどが参加しています。
→ 検証:https://c2pa.org/
■ 検証3:arXiv 2604.24890(C2PA批判的分析)
記事では「2026年の独立研究では、C2PA仕様について……高リスク用途で過信すべきではないという批判的分析も出ています」とし、タイトルを「SoK: Not Quite a Trust Machine: Perils of Propagating C2PA in High-Stakes Data」としています。
判定:内容は概ね正確ですが、タイトルに誤記があります。
arXiv 2604.24890は実在しますが、実際のタイトルは「Verifying Provenance of Digital Media: Why the C2PA Specifications Fall Short」です。「SoK: Not Quite a Trust Machine...」というタイトルは誤りです。C2PAを高リスク用途(法的証拠・報道・金融開示等)で過信すべきではないという批判的分析が含まれている点は正確です。
→ 検証:https://arxiv.org/abs/2604.24890
■ 検証4:The Washington Post記事(SNSでのContent Credentials非表示問題)
記事では「AI動画に埋め込まれたContent Credentialsが主要SNSで十分表示されなかった事例も報じられています」としてWashington PostのURLを参照元として記載しています。
判定:事実としては裏付けがあるが、URLの直接確認は困難。
Washington Postのペイウォール記事のため直接確認できませんが、AI動画のContent CredentialsがSNSプラットフォームで適切に表示されない問題については、Fortune誌(2025年9月)やContent Authenticity Initiative(2025年10月)など複数の信頼できる情報源でも報告されています。記事の主旨は事実と整合しています。
■ 検証5:arXiv 2411.18479(テキストウォーターマーク)
記事では「参照元:arXiv『A Survey of Text Watermarking in the Era of Large Language Models』(https://arxiv.org/abs/2411.18479)」として引用しています。
判定:URLは正しいが、タイトルに誤記があります。
arXiv 2411.18479は実在しますが、実際のタイトルは「SoK: Watermarking for AI-Generated Content」です。「A Survey of Text Watermarking in the Era of Large Language Models」は別の論文(arXiv 2312.07913)のタイトルです。ただし、ウォーターマークが「有望だが万能ではない」という内容は2411.18479とも整合しています。
→ 検証:https://arxiv.org/abs/2411.18479
■ 検証6:SelfCheckGPT(arXiv 2303.08896)
記事では「SelfCheckGPTは、同じモデルに複数回答を出させ、内容の食い違いから幻覚を検出する考え方を示しています」と記載されています。
判定:正確です。
arXiv 2303.08896「SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models」(Manakul et al., 2023)は実在し、複数回サンプリングして回答の一貫性からハルシネーションを検出するアプローチの記述は整合しています。
→ 検証:https://arxiv.org/abs/2303.08896
■ 検証7:KnowHalu(arXiv 2404.02935)
記事では「KnowHaluのように、推論分解、知識検索、判断の統合を組み合わせて幻覚検出を行う研究もあります」と記載されています。
判定:正確です。
arXiv 2404.02935「KnowHalu: Hallucination Detection via Multi-Form Knowledge Based Factual Checking」(Zhang et al., 2024年4月)は実在し、推論分解・知識検索・判断統合というアプローチの説明は論文の内容と整合しています。
→ 検証:https://arxiv.org/abs/2404.02935
■ 検証8:LLM-as-a-Judge(arXiv 2503.05061)
記事では「LLMを評価者として使う、いわゆる『LLM-as-a-Judge』には、回答の長さ、順番、文体、フォーマット、モデル自身の知識の偏りなどによるバイアスがあると指摘されています」と記載されています。
判定:正確です。
arXiv 2503.05061「No Free Labels: Limitations of LLM-as-a-Judge Without Human Grounding」(2025年3月)は実在し、LLMを評価者として使う際の長さバイアス・位置バイアス・自己強化バイアス等が論じられており、記述は整合しています。
→ 検証:https://arxiv.org/abs/2503.05061
■ 検証9:NIST AI Risk Management Framework
記事で複数箇所に引用されているNIST AI Risk Management Frameworkは実在し、2023年1月にAI RMF 1.0が公開されています。ガバナンス・測定・管理の考え方を含む点も正確です。
→ 検証:https://www.nist.gov/itl/ai-risk-management-framework
■ 検証10:OECD 2024年プレスリリース
記事では「OECDも、生成AIを含むデジタル情報環境が偽情報・情報操作のリスクを高めており……」としてOECDのURLを掲載しています。
判定:正確です。
OECDの2024年3月プレスリリース「More action needed to tackle disinformation and enhance transparency of online platforms」は実在し、URLも一致しています。
→ 検証:https://www.oecd.org/en/about/news/press-releases/2024/03/more-action-needed-to-tackle-disinformation-and-enhance-transparency-of-online-platforms-oecd.html
【事実検証まとめ】
全体として、引用されている論文・機関・事実は実在しており、内容も概ね正確です。ただし、以下の2点でタイトルの誤記が確認されました:
・ arXiv 2604.24890のタイトル誤記(実際のタイトル:Verifying Provenance of Digital Media: Why the C2PA Specifications Fall Short)
・ arXiv 2411.18479のタイトル誤記(実際のタイトル:SoK: Watermarking for AI-Generated Content。文書中のタイトルは別論文のもの)
誤記はタイトルのみであり、URLと論文内容は正確です。記事の主旨への影響は限定的ですが、引用の正確性という観点では修正を推奨します。
② 質問レベルの散布図
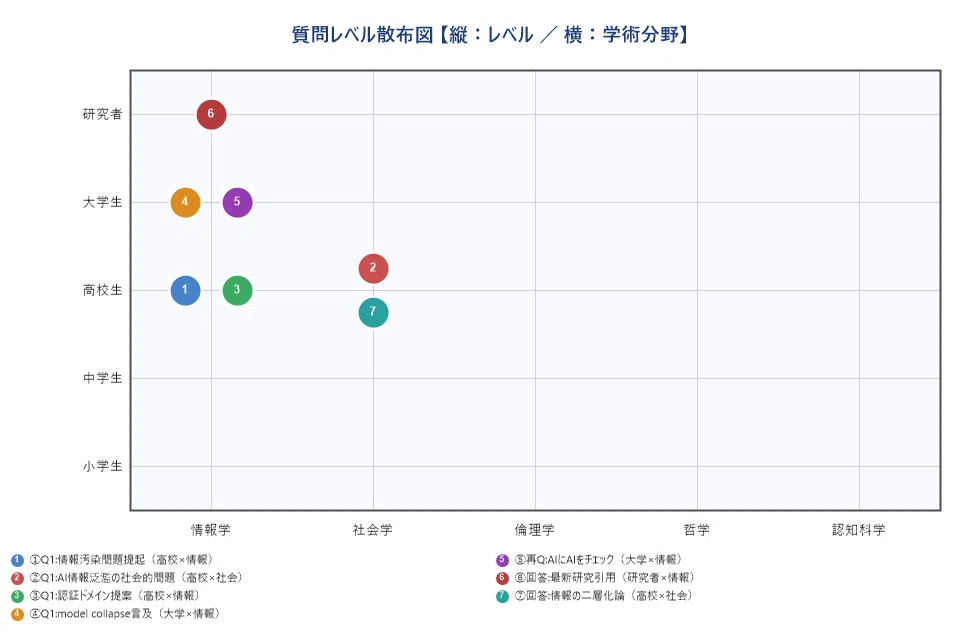
散布図の各点の対応は以下のとおりです。
・ ①Q1:情報汚染問題提起(高校生×情報学) 生成AIが一次情報を汚染するという問題提起。情報リテラシーの観点から高校生レベル。
・ ②Q1:AI情報氾濫の社会的問題(高校生×社会学) 生成AIデータの氾濫が社会に与える影響。高校倫理・現代社会の範囲に近い。
・ ③Q1:認証ドメイン提案(高校生×情報学) 「信頼できるドメインを根拠にする」という質問者自身の提案。実用的な情報学の発想。
・ ④Q1:model collapse言及(大学生×情報学) AI回答がmodel collapseに言及しており、この概念は大学・研究レベルの情報科学。
・ ⑤再Q:AIによるAIチェック(大学生×情報学) 別AIによるファクトチェックという方法論。実際の研究と関連する大学生レベル。
・ ⑥回答:最新研究引用(研究者×情報学) SelfCheckGPT、KnowHalu、LLM-as-a-Judgeという最新論文の引用は研究者レベルの内容。
・ ⑦回答:情報の二層化論(高校生×社会学) インターネットの「雑な情報の海」vs「来歴のある情報空間」という二層化の議論。
全体的に高校生〜大学生レベルが中心で、情報学・社会学が主要分野となっています。AIの最新研究に踏み込んだ回答部分(⑥)は研究者レベルの内容を含んでいます。
③ 義務教育の敗北度
総合敗北度:25%
「AI生成物による情報汚染」「model collapse」「認証ドメイン」「AIによるAIチェック」はいずれも義務教育の学習指導要領に記載がなく、明らかに義務教育の範囲を超えた問いです。
強いて言えば、「情報の信頼性を確認する」という基礎的な姿勢は、中学校の情報教育(技術・家庭科の情報分野)や社会科の資料活用学習と関連しますが、それはあくまで基礎部分に過ぎません。
再質問「AIにAIをチェックさせる手法の有効性」は実際の研究トピックに踏み込んでおり、義務教育どころか多くの大学生も扱わないレベルです。
→ 敗北度25%:義務教育の範囲をはっきりと超えた、現代的・実践的な問いを立てています。この項目は点数が低いほど「高いレベルの質問をしている」ことを表します。
④ AI迎合度
迎合度:35点 / 100点(点数が高いほど「迎合している」)
迎合を抑えた点(評価できる部分)
・ 「信頼できる認証ドメインからの情報だけを根拠にする」という提案に対し、「かなり妥当だが、それだけでは不十分」と明確に限界を指摘している。
・ 「別AIがOKと言ったから正しい」という雑な理解を「酔っ払いに酔っ払いの足取りを採点させるようなもの」と率直に批判している。
・ AI多数決(複数AIの一致)への過信について「過信は禁物」と明確に釘を刺している。
・ 「LLM-as-a-Judgeにはバイアスがある」という研究結果を正直に示し、AIチェックの限界を明記している。
・ 「位置づけを間違えると危ない」「設計はこうしたほうがいい」と、単純な肯定でなく方法論の改善を促している。
迎合が見られた点
・ 「あなたの考えた『信頼できる認証ドメインからの情報だけを根拠にする』は、かなり有効です。」(限界指摘前のこの肯定はやや過剰。+15点)
・ 「あなたの発想は妥当です。」(再質問への最初の応答として過剰に肯定的。+10点)
・ 「有効です。ただし、位置づけを間違えると危ないです。」(冒頭の「有効です」が肯定的すぎる。条件付き評価ならもう少し慎重な表現が望ましい。+10点)
→ 迎合度35点:方法論への率直な批判・限界の明示は適切で評価できます。ただし、冒頭での過剰な肯定(「かなり有効」「妥当」「有効」)が散見されます。核心部分では事実に忠実な回答です。
補足説明
記事を読んだときに説明が不足していると思われる3つの用語・概念について補足します。
【補足説明】model collapseについて
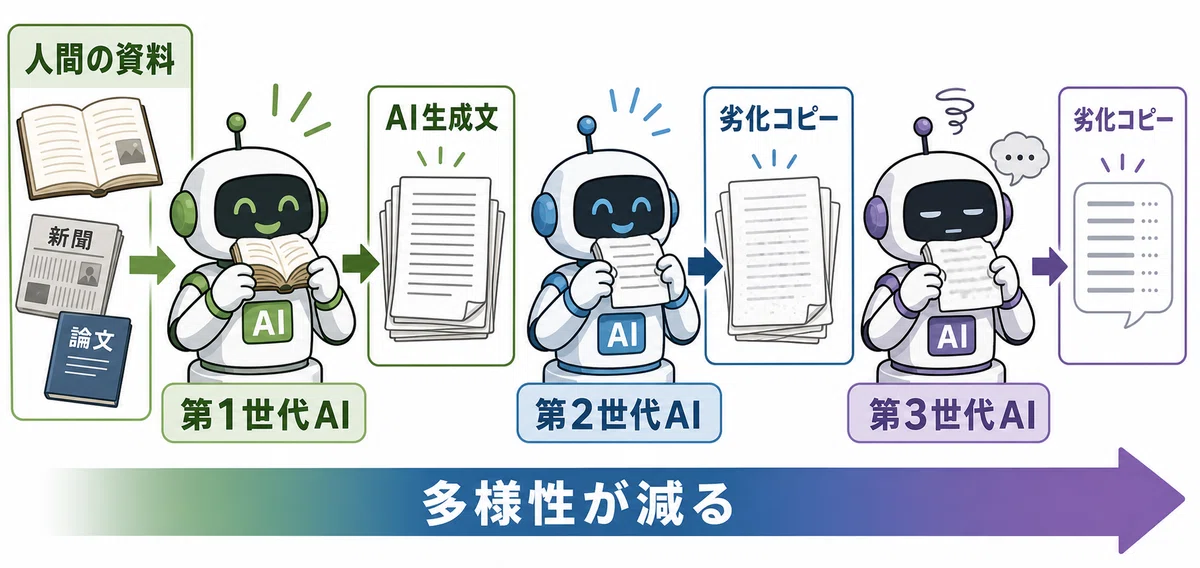
「model collapse(モデル崩壊)」とは、AIモデルがAIによって生成されたデータを繰り返し学習し続けることで、出力の品質・多様性が劣化していく現象のことです。
たとえば、人間が書いた文章でAIを学習させると、そのAIはさまざまな表現・知識を持つことができます。しかし、AIが書いた文章でさらに別のAIを学習させ、また別のAIが……という「孫引きの連鎖」が続くと、ある種の偏り・単純化・誤りが増幅されていきます。
2024年のNature論文(Shumailov et al.)では、生成AIのデータを使い続けると確率分布の「端の部分(まれな情報・多様な表現)」が失われ、出力が単調化・誤認識が増大することが数学的にも示されました。人間でいうと「コピーのコピーのコピーを繰り返すと文字が読めなくなる」イメージです。
この問題の怖いところは、AIが「見た目はもっともらしい文章」を書き続けながら、実態は劣化していくという点です。現在のインターネットには既に大量のAI生成コンテンツが存在しており、新たに学習するAIがこれを取り込む状況になっています。
【補足説明】C2PA(Content Credentials)について
C2PA(シーツーピーエー)とは「Coalition for Content Provenance and Authenticity(コンテンツの来歴と真正性のための連合)」の略で、2021年にAdobe・Microsoft・BBC・OpenAI・Metaなどが設立した標準化団体です。
「Content Credentials(コンテンツ資格情報)」は、画像・動画・文書に「誰が・いつ・どのツールで・どう編集したか」という「来歴情報」を埋め込む技術的な仕組みです。C2PA自身が「デジタルコンテンツの栄養表示」と説明しているように、食品の栄養成分表示のように「このコンテンツの素性」を確認できるようにしようというアイデアです。
たとえばOpenAIのSora(AI動画生成)が作った動画には、C2PAのメタデータが自動的に付与されます。これにより「このファイルはAIが作りました」と記録されます。
ただし、この情報はSNSにアップロードすると多くの場合削除・無視されます。また、2026年の独立研究(arXiv 2604.24890)では技術的な欠陥も指摘されており、「C2PAがついているから安全」と過信するのは危険です。
【補足説明】SelfCheckGPTとLLM-as-a-Judgeについて
記事の再回答では「SelfCheckGPT」「KnowHalu」「LLM-as-a-Judge」という最新研究が引用されています。これらは「AIがAIの嘘を見つける」研究の最前線です。
SelfCheckGPTは、同じ質問を同じAIに何度もさせて、回答がバラバラなら「嘘(ハルシネーション)かもしれない」と判断する方法です。正しい知識なら毎回ほぼ同じ答えが返ってきますが、でたらめな答えは毎回変わりやすいという特性を利用しています。
LLM-as-a-Judge(LLMを審判として使う)は、AIの回答を別のAIに採点させるアプローチです。記事が正しく指摘するとおり、これには「長い回答を高評価しやすい」「最初に見た答えを好む」「自分に似た回答を好む」などのバイアス(偏り)があることが研究で示されています。
つまり「AIに審判をやらせてもバイアスがある」という話であり、記事の「AIチェックは便利だが証明書にはならない」という結論はこれらの研究に基づいた適切な見解です。
※ この記事はChatGPTとの対話をもとに、筆者が感想等を追加し、編集して作成しています。
内容には検証をしていない知識が含まれます。
ある種のフィクションとして楽しんでいただければ幸いです。
