AIは考えていない|LLMとは何か、AIが文章を作る本当の仕組み

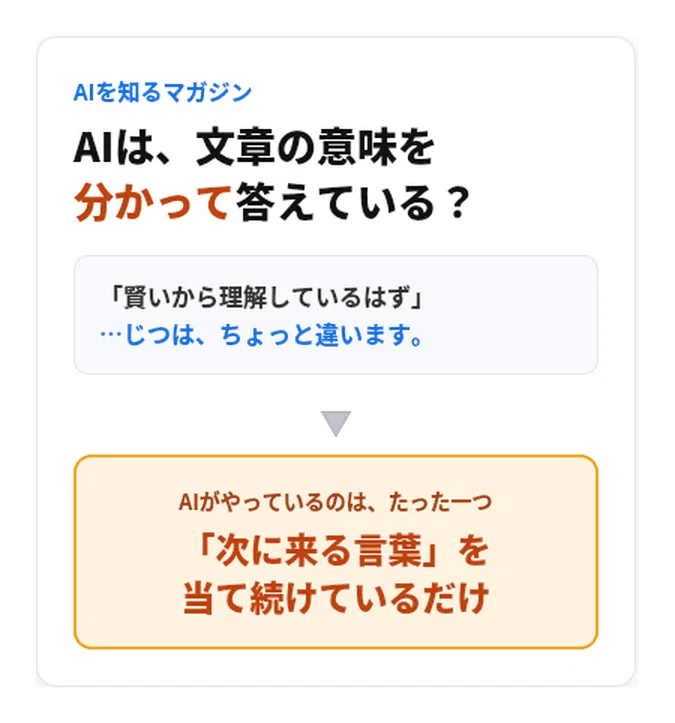
AIに質問すると、まるで人間のように自然な文章が返ってきます。あれを見ていると、つい「AIは中身の意味をちゃんと理解して、考えて答えているんだろう」と感じてしまいます。でも、その答えを作っている正体は、驚くほど単純な仕組みです。それが今日のテーマ「LLM(大規模言語モデル)」です。
あなたが毎日使っているChatGPTやその仲間も、すべてこのLLMでできています。この一語の正体を知ると、AIが得意なことも、なぜか苦手なことも、いっきに腑に落ちます。
ひとことで言うとLLMとは、膨大な文章から「次に来る言葉」の確率を学び、それを選び続けて文章を作るAI。意味を理解しているわけではありません。
僕はTrex(Tレックス)。AIブリッジエンジニアとして、AIを毎日実務で使い倒しています。自己紹介はこちら
🔍 LLMって、結局なに?
LLMは「Large Language Model」の略で、日本語では「大規模言語モデル」と呼びます。ChatGPTをはじめ、いま僕たちが使っている生成AIの頭脳にあたる部分が、このLLMです。まずは名前を3つに分けて見ると、正体がつかめます。
最後の「モデル」から見ていきましょう。ここでいう言語モデルとは、ものすごくかみくだくと「ある言葉の次に、どの言葉が来やすいか」を確率で言い当てる仕組みのことです。たとえば「朝ごはんにパンを」と来たら、次は「食べる」が来そうだと予想がつきますよね。あの感覚を、膨大な文章から学んで身につけたものだと思ってください。
では「大規模」とは何が大規模なのか。ポイントは3つあります。学習に使う文章の量(データ量)、その計算にかける手間(計算量)、そしてモデルの賢さを決めるパラメータの数です。従来の言語モデルに対して、この3つをけた違いに増やしたことで、急に人間らしい文章が書けるようになりました。つまりLLMは、まったく新しい魔法が生まれたというより、「次の言葉を当てる仕組み」を、とんでもない規模まで大きくしたものなのです。
ここでひとつ、誤解を解いておきます。LLMは、僕たちのように言葉の意味を理解して話しているわけではありません。やっているのは、あくまで「次に来そうな言葉を確率で選ぶ」こと。意味が分かっているように見えるのは、膨大な文章のパターンを学んだ結果、それらしい並びを上手に作れるからです。研究の世界では、この性質をたとえて「確率でしゃべるオウム」と呼ぶこともあります。なめらかに話せても、中身を分かっているとは限らない、という戒めの言葉です。
⚙️ なぜ「次の言葉」を当てるだけで文章になるのか
「次の言葉を当てているだけ」と聞くと、それでどうしてあんなに長い文章が書けるのか、不思議に思うはずです。からくりは「1語ずつ、ひたすら繰り返す」ことにあります。
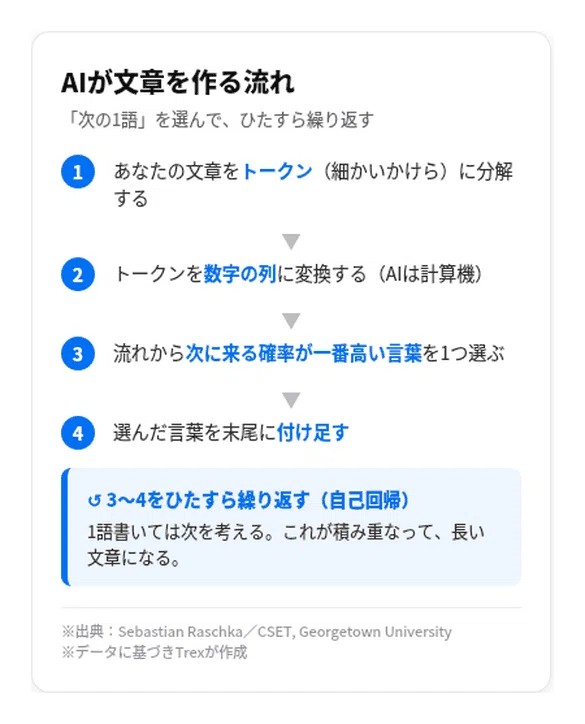
AIが文章を作る流れを追ってみましょう。まず、あなたが送った文章を「トークン」という細かいかけらに分解します。これは前にお話しした、文字数とは別の最小単位ですね。次に、そのトークンを数字の列に変換します。AIの中身は巨大な計算機なので、言葉のままでは扱えず、いったん数字に直す必要があるのです。そして、これまでの流れから「次に来る確率がいちばん高い言葉」を1つ選んで書き出す。書き出したらそれを文章の末尾に付け足し、また次の1語を選ぶ。これをひたすら繰り返して、長い文章ができあがります。
ポイントは、AIは文章全体をあらかじめ用意してから話しているわけではない、ということです。1語書いては次を考え、また1語書いては次を考える。この「1語ずつ前に進む」やり方を、専門的には自己回帰と呼びます。AIの返事が、ときどき人がしゃべるように少しずつ表示されるのは、まさに裏でこの1語ずつの処理が動いているからです。
身近なところにも、同じ仕組みは隠れています。スマホで文字を打っていると、変換候補が次々と先回りして出てきますよね。「おはよう」と打てば「ございます」が候補に並ぶ、あれです。LLMは、あの予測変換を桁外れに賢く、長くしたものだと思うと、距離がぐっと縮まります。違いは規模だけ。スマホは数文字先を予想しますが、LLMは同じ理屈で、論文1本ぶんの文章でも最後まで書き切ってしまうのです。
では、その「次に来やすい言葉」を、AIはどうやって覚えたのか。これがLLMの学習の正体です。やり方は、いってみれば壮大な穴埋めドリルです。インターネット上の膨大な文章を集めてきて、わざと一部を隠し、「ここに入る言葉は何?」と当てさせる。外れたら少しずつ調整し、また当てさせる。これを天文学的な回数くり返すうちに、AIは「この文脈なら次はこの言葉」というパターンを、文法も言い回しもまとめて身につけていきます。おもしろいのは、この訓練には人間が一つひとつ正解を教える必要がないことです。元の文章の続きが、そのまま正解になってくれるからです。だからこそ、あれほど大量の文章で学習できたわけです。
💡 「考えている」と思い込むと、なぜ事故るのか
ここまで分かると、AIとの付き合い方が変わります。いちばん大事なのは、「AIは意味を理解して考えている」という思い込みを手放すことです。AIがやっているのは、人間の思考とは別物の、確率にもとづく言葉選びだからです。
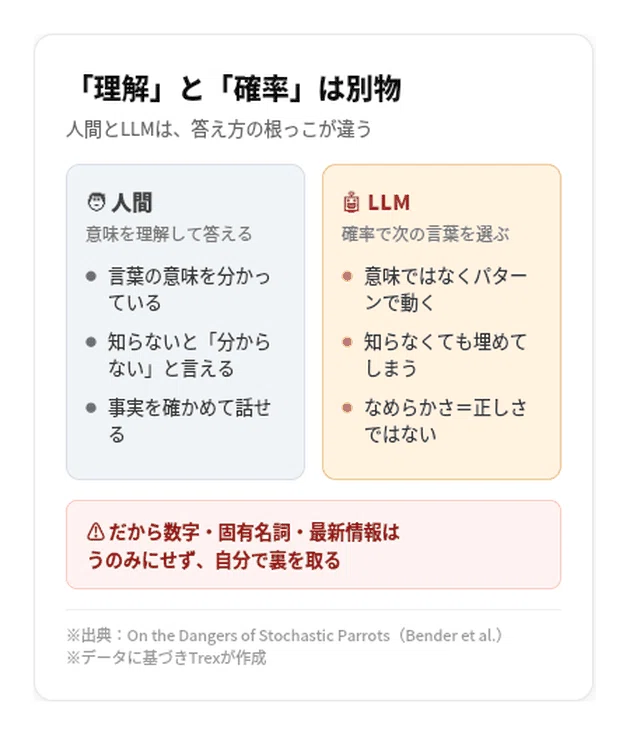
この違いを知らないと、具体的にどんな事故が起きるのか。たとえば、あまり世に出回っていない情報を聞くと、AIは平気でそれらしい作り話を返してきます。学習した文章の中にほとんど登場しない事実は、確率からは導けません。それでもAIは「次の言葉」を出し続ける仕組みなので、知らないことでも、それらしく埋めてしまう。これが前回お話しした、自信たっぷりに間違える「ハルシネーション」の正体でもあります。仕組みが同じなので、当然つながっているわけです。最新のニュースや料金、珍しい人物の経歴をうのみにしてはいけないのは、このためです。
逆に、LLMが得意なことも仕組みから見えてきます。文章の要約、言い回しの修正、翻訳、たたき台づくり。こうした「ありがちな言葉のパターンを上手に組み替える」仕事は、まさに本領発揮です。一方で、誰も書いていない真実を掘り当てたり、厳密な計算を間違いなくこなしたりするのは、本来苦手な領域。LLMを使うコツは、この得意と苦手の線引きを、仕組みから理解しておくことに尽きます。
実務での向き合い方も、ここから自然に決まります。僕がいつもやっているのは、AIの答えを「とてもよくできた下書き」として受け取り、事実の部分だけは必ず自分で確かめることです。確率で作られた文章だと分かっていれば、なめらかな語り口にだまされず、ちょうどよい距離で頼れます。AIを賢い物知り博士だと思って全部を信じるのが、いちばん危ない使い方なのです。
もう少し具体的に、僕の使い分けを書いておきます。文章を整える、要約する、たたき台を作るといった「言葉の組み替え仕事」は、ほぼそのまま任せます。ここはLLMがいちばん輝くところだからです。一方で、数字・固有名詞・日付・最新の事実がからむ部分は、たとえ答えがなめらかでも、いったん疑ってから公式情報で裏を取ります。どこを任せてどこを握るか。この線引きさえできれば、LLMは一日に何度でも頼れる仕事道具になります。難しい知識はいりません。「これは確率で言葉を選ぶ仕組みだ」という土台を一つ持っておくだけです。
🙋 僕はLLMを「物知り」ではなく「言葉の達人」だと思っている
僕はLLMを、何でも知っている博士ではなく、「言葉の扱いがとびきり上手な達人」だと思って付き合っています。意味を深く理解しているわけではないけれど、言葉を組み立てる腕前は人間離れしている。その素性が分かっていれば、頼れる場面と、自分で手綱を握るべき場面を、はっきり分けられます。
長くAIを使ってきて確信しているのは、「文章のなめらかさ」と「中身の正しさ」は別物だということです。LLMは前者の達人ですが、後者を保証する仕組みは持っていません。だから僕は、新しいモデルが出るたびに「どれだけ賢くなったか」だけでなく、「結局これは確率で言葉を選ぶ道具だ」という土台を忘れないようにしています。仕組みを知って使えば、これほど頼もしい相棒もいません。「すごい」で止めず「で、どういう仕組みで、どこまで任せるか」まで落とし込む。これは僕がずっと持っている基準です。
📝 まとめ
AIがあれほど自然に話せるのは、意味を理解しているからではなく、「次に来る言葉」を膨大な文章から学び、確率で選び続けているからでした。最初に感じた「中で考えているはず」という印象は、仕組みを知れば、よくできた言葉の組み立ての結果だと分かります。大規模というのは、その仕組みをけた違いの規模まで大きくしたという意味でした。難しい数式は要りません。「LLMは意味を理解する脳ではなく、次の言葉を当て続ける、とてつもなく大きな確率の仕組みだ」。まずはこれだけ持って帰ってもらえれば十分です。
🔗 その他のマガジン記事は以下をご確認ください!
https://note.com/trex_ai/m/m9ea42d92706b
