ChatGPT Images 2.5の部分編集検証が無効になった理由――公開版と作業用画像を混同しない

前回の記事では、Astraにダンスモーションの制作を任せた結果、指定した生成経路や作業範囲まで変わってしまった問題を整理しました。
今回は、作業を進めるエージェントではなく、画像編集モデルの部分修正能力を検証する予定でした。テーマは、既存のキャラクター画像に対して「胸元の赤いリボンだけを、参照画像に合わせて直してください」という指示が通じるかどうかです。
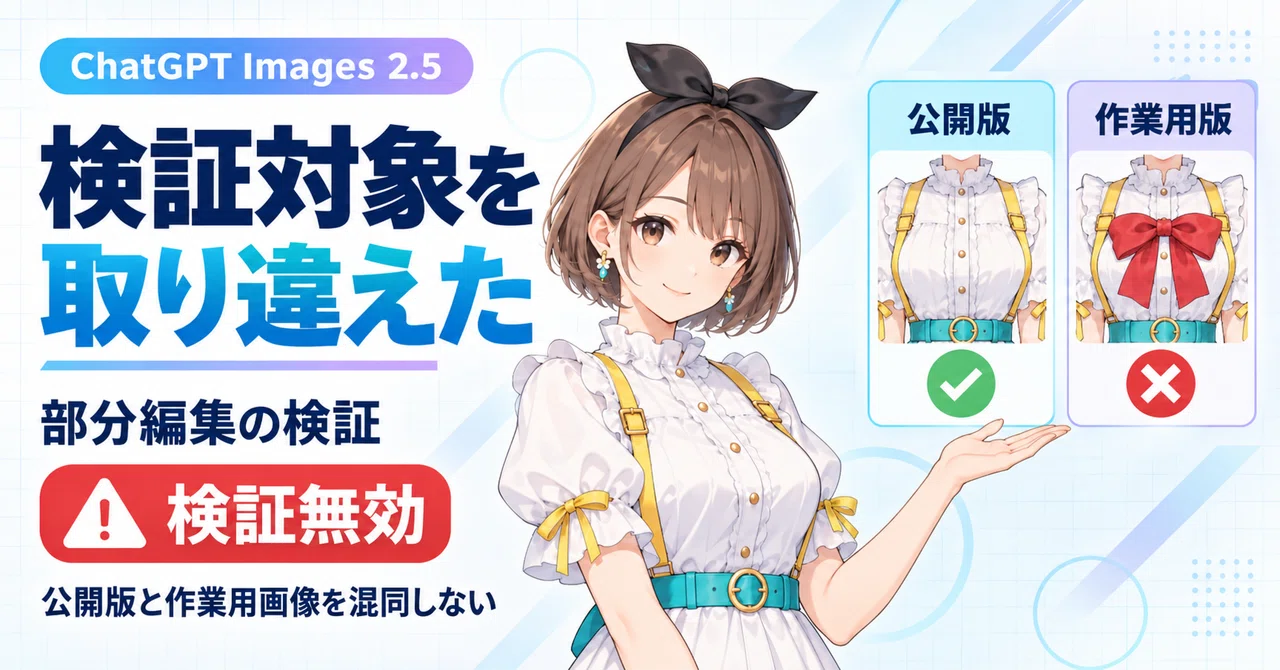
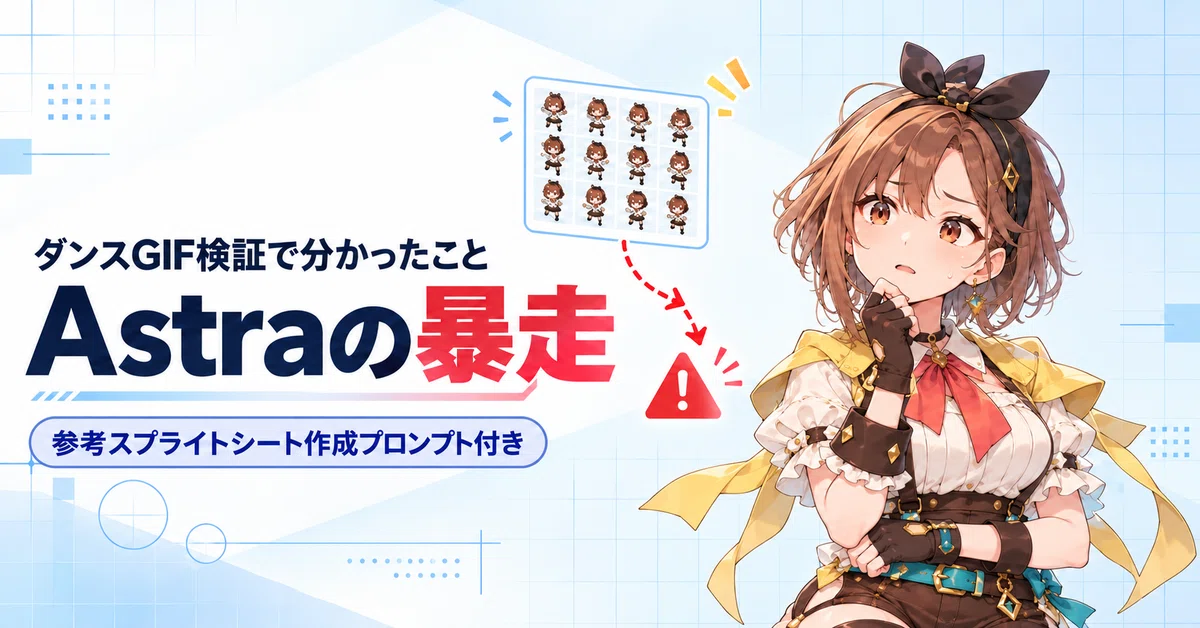
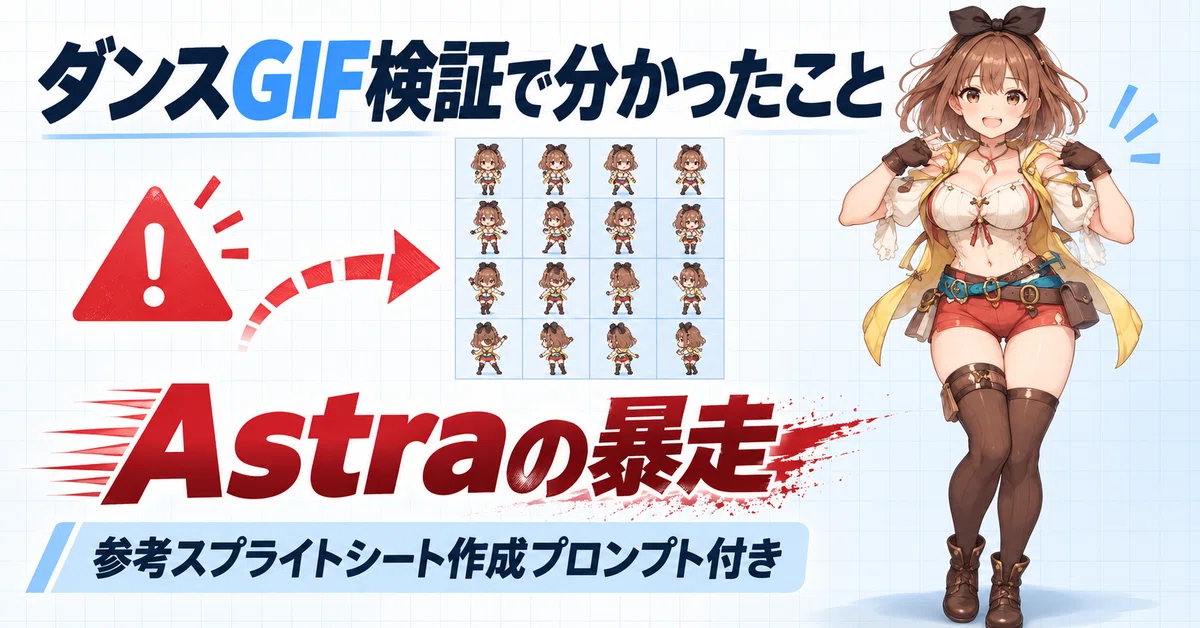
ところが、検証後に重要な問題が分かりました。実際に入力した画像は、公開済みサムネイルではなく、公開前の作業用バージョンでした。作業用バージョンには大きな赤いリボンが残っていましたが、公開済みサムネイルでは、その問題のリボンはすでに修正して取り除かれています。
公開済みの記事の見出し画像と、検証に使った入力画像が一致していない以上、生成結果を「公開サムネイルの部分編集結果」として扱うことはできません。
今回の結論は、ChatGPT Images 2.5が成功したか失敗したかではありません。検証対象を固定せずに進めたため、実験そのものが無効になった、という記録です。
1. 前回の記事との違い
前回は、Astraが作業の途中で生成経路や作業範囲を変えてしまったことが問題でした。
今回は、生成経路を固定したうえで、ChatGPT Images 2.5の画像編集そのものを検証する予定でした。
しかし、生成経路を固定していても、入力画像が違えば検証にはなりません。公開済みサムネイルと、公開前の作業用画像を取り違えた時点で、今回の試行は性能評価から外すべきです。
つまり、次の2つを分けて考えます。
エージェントが勝手に手段を変えないか
画像生成モデルが指定した部分だけを編集できるか
前者については、前回の記事で運用ルールを整理しました。
今回は後者を確認する前段階で、対象画像の不一致が判明しました。
2. 公式情報と今回の検証を分ける
2026年9月13日時点で確認したOpenAI公式発表では、ChatGPT Images 2.5の特徴として、より鮮明なディテール、より正確な編集、複数回の編集での一貫性などが説明されています。
今回関係するのは、「指定した部分を編集しながら、周囲の要素を維持する」という点です。
ただし、これは公式が説明する機能や改善点であり、今回の試行から確認できた結果ではありません。入力画像が公開済みサムネイルと一致していないため、リボンの修正結果をChatGPT Images 2.5の性能評価として採用できないからです。
この記事では、公式発表、公開済み画像、実際に使った誤った入力画像、生成された参考画像を分けて記録します。
3. 検証する画像と条件
本来の編集対象は、公開済み記事に表示されている見出し画像です。
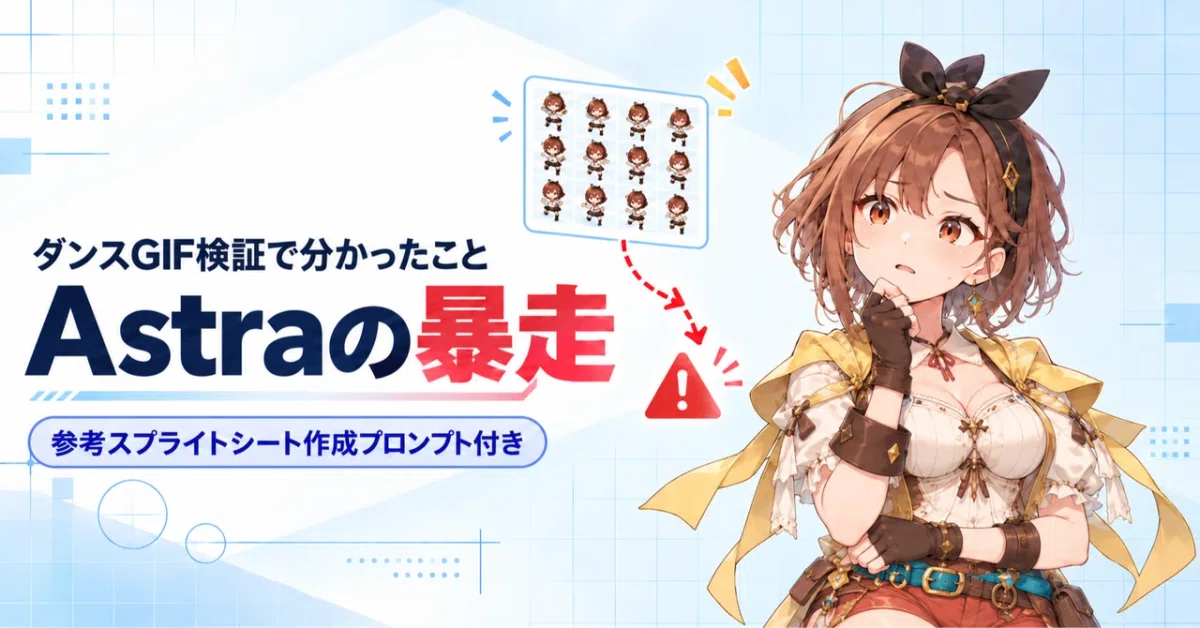
しかし、実際の1回目の試行では、公開済み画像ではなく、公開前の作業用サムネイルを画像1として添付していました。作業用サムネイルには大きな赤いリボンが残っていました。
この取り違えを確認できるよう、実際に使った作業用版は次のファイルです。
参照画像には、同じキャラクターの胸元を確認できる画像を使いました。
正しい対象画像が一致していた場合、変更を許可するのは、胸元の赤いリボンの形、幅、結び目、長さ、位置だけです。
次の要素は、正しい対象画像を使った再検証で変更してはいけないものとして扱います。
短い暖色ブラウンのボブヘア
大きな黒いリボン
白いフリル付きパフスリーブのブラウス
黄色い肩掛けと流れる黄色いリボン
ターコイズ色のベルトと装飾
顔、表情、体型、ポーズ
「ダンスGIF検証で分かったこと」
「Astraの暴走」
「参考スプライトシート作成プロンプト付き」
4×4スプライトシート、警告アイコン、壊れた矢印
白〜淡い青のグリッド背景
横長の画面比率とキャラクターの配置
検証時には、ブラウザ版ChatGPTのChatGPT Images 2.5を使ったこと、入力画像が公開済み画像と一致していること、実際の生成日時を記録します。どれかを確認できない場合は、検証結果として扱いません。
4. 合格・部分成功・失敗の基準
単に画像が生成できたかどうかでは判定しません。
成功とするのは、次の条件をすべて満たした場合です。
赤いリボンの主要な形状、幅、結び目、垂れ方、取り付け位置が参照画像と一致している
画像1にあった大きく幅広い赤いボウへ戻っていない
顔、髪型、表情が変わっていない
黄色い肩掛け、白い袖、ターコイズのベルトが維持されている
タイトルと補足バッジの文字が変わっていない
スプライトシート、警告アイコン、背景、構図が維持されている
完全なピクセル一致を求めるのではなく、参照画像との比較で主要な特徴が一致しているかを目視で判定します。
1回目は8点満点とし、リボンの修正を3点、顔・髪・衣装などの維持を3点、タイトル・バッジ・レイアウトの維持を2点で評価します。
ただし、今回の試行にはこの点数表を適用しません。入力画像が公開済みサムネイルと一致していないため、比較条件が成立していないからです。
5. 実際に送ったプロンプト(検証無効)
以下は、実際の1回目の試行で送ったプロンプトです。変更箇所は1つに限定していましたが、入力画像が公開済みサムネイルと一致していなかったため、このプロンプトの成否をモデルの性能評価には使いません。
プロンプト中の「添付画像1」「添付画像2」は、ChatGPTへ実際に送ったときの添付順です。この記事の画像番号では、画像2が誤った作業用版、画像3が参照画像に当たります。
添付画像1を編集対象のnote用サムネイル、添付画像2を胸元の衣装を確認するための優先参照画像として使用してください。

画像1の構図を作り直さず、胸元の赤いリボンだけを画像2に合わせて修正してください。

最重要条件:
画像1にある現在の大きく幅広い赤いリボンの形を正解として扱わないでください。
画像2に描かれている赤いリボンの形・幅・結び目・垂れ方・取り付け位置を、そのまま視覚的な基準にしてください。
画像2にない大きな蝶結び、幅広い赤いパネル、長いスカーフ形状へ拡張しないでください。

変更してはいけないもの:
顔、表情、短い暖色ブラウンのボブヘア、大きな黒いリボン、白いフリル付きパフスリーブ、黄色い肩掛けと黄色いリボン、ターコイズ色のベルト、ポーズ、背景、4×4スプライトシート、警告三角形、壊れた矢印、キャラクターの配置。

次の既存テキストは一字一句そのまま残してください。
「ダンスGIF検証で分かったこと」
「Astraの暴走」
「参考スプライトシート作成プロンプト付き」

新しい文字、ロゴ、透かし、疑問符、UI要素は追加しないでください。
1.91:1の横長、2Dアニメ調、文字化けなし、見切れなし、レイアウト崩れなしで出力してください。
6. 1回目の編集結果――対象画像の取り違えにより無効
画像自体は生成されました。しかし、画像1として使ったのは公開済みサムネイルではなく、公開前の作業用サムネイルでした。
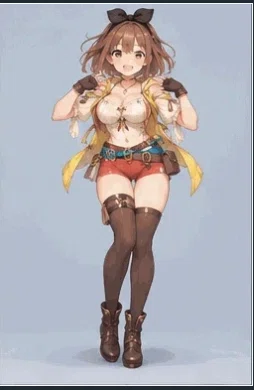
生成画像では、胸元の赤いリボンが細い結び目と短いテールへ変わっているように見えます。ただし、これは大きな赤いリボンが残っていた作業用画像に対する変化です。公開済みサムネイルのリボンを編集した結果ではありません。
参考観測としては、サムネイル全体が描き直され、キャラクターは上半身中心の見え方から全身表示へ変わりました。顔、髪、表情、ポーズ、衣装の細部、4×4スプライトシート、警告アイコン、矢印、背景の配置も維持されていません。
タイトルと補足バッジの文言は読める形で残りましたが、タイトルの改行・配置は変わっています。これらは作業用画像に対する参考観測であり、公開画像に対する成功・失敗の判定ではありません。
検証ログ:2026年9月13日、ブラウザ版ChatGPTの「ChatGPT 画像 2.5 | AI 画像生成ツール」画面で生成。入力画像の一致確認は不合格。点数は採点対象外。判定は「検証無効」です。
7. 2回目の編集は実施しない
1回目が成功した場合だけ、同じ会話で別の小さな変更を加えて一貫性を確認する予定でした。
しかし、1回目は入力画像が公開済みサムネイルと一致していませんでした。この状態で2回目を実施すると、誤った対象を前提に試行回数だけが増えてしまいます。そのため、2回目は実施しません。
一貫性テストは、公開済み画像を正しい入力として固定したうえで、改めて最初からやり直す必要があります。
8. 再検証するなら、先に入力画像を固定する
今回のような失敗では、プロンプトを長くする前に、検証対象そのものを固定しなければなりません。
公開記事のURLを記録し、現在表示されている見出し画像を確認する。
その見出し画像を、検証に使う画像1として明示的に保存する。
ファイル名だけでなく、画像の見た目、幅・高さ、取得日時を記録する。
公開版と作業用版を並べ、変更対象が本当に存在するかを確認する。
対象が存在しない場合は、プロンプトを送らずに検証を中止する。
対象が一致した場合だけ、画像1と参照画像を添付して、部分編集のプロンプトを送る。
今回の公開済みサムネイルには、問題になっていた大きな赤いリボンがすでにありません。そのため、公開版を対象にするなら「赤いリボンを修正する」というテーマ自体を、公開画像に実在する別の要素へ変更する必要があります。
検証では、生成結果だけでなく、次の3つをセットで残します。
検証対象のURLと画像ファイル
実際に送ったプロンプト
対象画像が一致していることの確認記録
この3つが揃っていなければ、画像がきれいに生成されても、再現可能な検証結果とは呼べません。
9. この検証で分けて考えること
画像編集の評価では、少なくとも次の3段階を分ける必要があります。
検証対象が正しいか
正しい対象に対して、画像が生成されたか
指定箇所以外を維持できたか
今回は2と3の観測はできましたが、1が成立していませんでした。したがって、作業用画像で見えた変化を、公開済みサムネイルに対する性能結果へ一般化してはいけません。
対象画像の取り違えは、プロンプトの表現力やモデルの性能以前に、実験設計を壊します。
10. まとめ
今回の検証で、ChatGPT Images 2.5の一般的な性能を評価することはできませんでした。
理由は明確です。検証に使った画像1が、公開済みサムネイルではなく、公開前の作業用サムネイルだったからです。公開済みサムネイルでは問題の赤いリボンがすでに修正されているため、今回の生成結果は公開画像に対する検証結果ではありません。
先に記載した4/8点という評価も取り消します。対象画像が一致していない以上、点数を付ける比較条件そのものが成立していません。
今回確実に言えるのは、対象を取り違えたままでは、どれだけ詳細なプロンプトを書いても、正しい検証結果にはならないということです。
画像生成では、ファイルが作られたことと、依頼どおりに編集されたことは別です。さらにその前提として、正しい画像を編集していることを確認しなければなりません。
再検証するなら、まず公開版を正式な入力画像として固定し、公開版に実在する変更対象を定義し直す必要があります。その後に初めて、部分編集の精度と維持性能を評価できます。
