
DifyのAgentでパーソナルメンターを創る-3(改訂版概要;長期記憶の追加)

はじめに
前回から、ちょっと間が空いてしまいましたが、パーソナルメンター機能の基本形が、ほぼできたので、それをメモっておきたいと思います。
この開発にあたっては、Gemini2.5ProのDeep Researchに、大分お世話になりました。直近だと、Preview06-05バージョンですね。
本開発にあたっては、05-06と06-05に2つのバージョンを主に使いました。
05-06もとても助けになりましたが、06-05になって、一段と能力が向上したように感じます。
DeepResearchを使うには、毎回新規チャットにする、という原則があります。必ずしも、原則通りではないような印象もありますが、、、新規の場合、前の内容をどれぐらい引き継いでいるかどうかは、定かではありません。
ただ、100万トークンがOKですから、関係するGoogleドキュメントファイルとかも全部入れ、相当長い質問でも大体は受け入れてくれます。
ちょっと手間ですが、それだけの価値のある懇切丁寧な出力が得られます。
ということで、今回は、現時点での最新フローを示し、その機能の概説をしておこうと思います。
なお、今回の開発環境は、MacBook Air-M2(24GB, 1T SSD)のMacOS15.5で、Difyコミュニティ版のv1.4.1を使っています。
改訂版について
概要
最大の改善点は、長期記憶機能を付加した、ということです。
最初に現時点での最新版のチャットフローを示します。
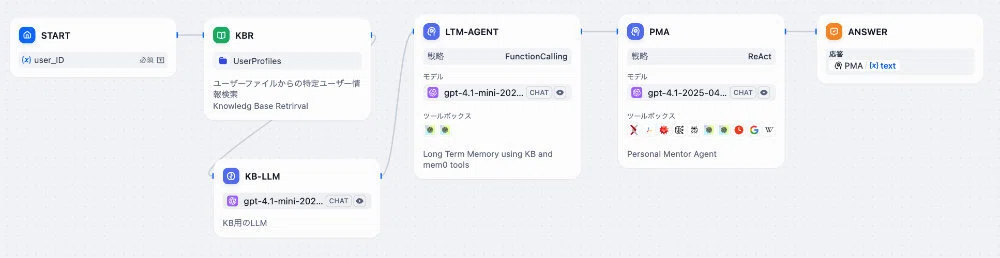
機能のブロックでくくると、次のようになります。
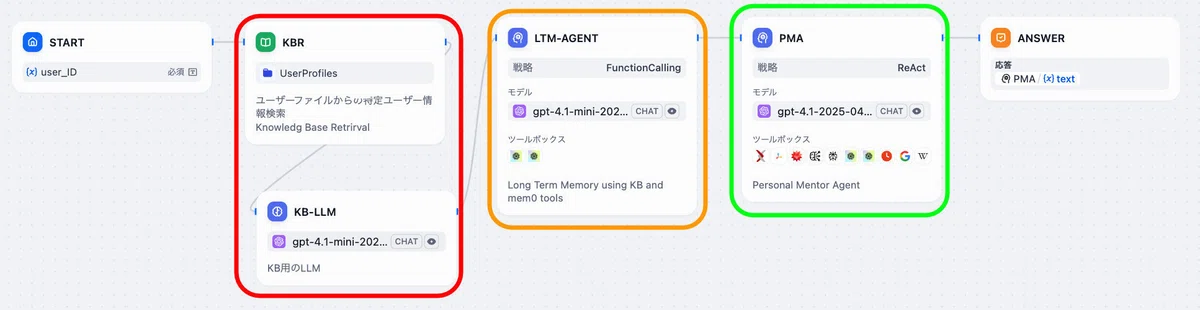
長期記憶;固定データ(KB-KBLLM)
赤の枠で囲んだ2つのnodeが、ナレッジベース(知識検索)関連で、知識検索nodeと検索結果を処理するLLM(KB-LLM)nodeからなります。
これは、たとえば、名前、誕生日、住所、趣味など固定化できる情報を入れます。
長期記憶エージェント(LTM-Agent)
次のオレンジの枠は、長期記憶(Long Term Memory)エージェントです。これは、チャットの会話などで、このエージェントが長期記憶しておくべきと判断した事項や、私が記憶するように指示した事項を長期記憶する機能があります。長期記憶は、一旦システムをシャットダウンしても、覚えています。
つまり、自動学習機能のある長期記憶となっています。
パーソナル メンター エージェント(PMA)
その次の黄緑の枠は、PMA(Personal Mentor Agent)で、このフローの肝となる部分です。これには、検索ツールが6種類、Thinkツール、時間情報ツールと、中期記憶のツールが入っています。
中期記憶は、一連のチャットをしている間は記憶を保持しますが、一旦システムをシャットダウンすると消えてしまいます。
PMAの機能は、前回までのフローにもありました。しかしながら、今回、LTM等を追加したことや検索ツールを増やした(3→6) こと、また、LLM同士のデータ通信がスムーズにいくように、JASON Schemaを導入したことにより、Instructionの内容がかなり変わっています。
これらの機能の導入は、一度に行ったのではなく、ステップバイステップで行っていきました。
以下に、そのバージョンアップ履歴を簡単に記載します。
パーソナルメンター用フローのバージョンアップ履歴
個人データ(固定データ)の長期記憶化
最初は、Geminiの提案にしたがって、ナレッジベースnodeでのRAGによる個人情報を追加、をやってみました。
まず、事前に、個人データのテキストファイル(データ)を作ります。これは、CotEditorで行いました。テキストエディットでもいいと思います。
複数のメンバー入る場合は、それぞれのデータを準備します。
それぞれの識別は、たとえば、user_idで行います。
次に、そのデータをDifyのナレッジのRAG(Retrieval-Augmented Generation)で処理をしてナレッジベースとします。
チャットフローでは、そのナレッジベースを知識検索(KBR)nodeで読み込みます。
その読み込んだナレッジベース(KB)を、次のLLMで処理します。つまり、チャットの開始の時点で入力した質問(System Query)とKBとを照らし合わせる、などということが記述されたLLM内のプロンプトに従って処理されます。
これは、RAGの最も単純な処理方法でもあり、まあ比較的簡単にできました。
ただ、なんと、Geminiとの質疑のやり取りの中で、Geminiが、”これじゃあ機能が低いですよね、この長期記憶機能をエージェント化して、会話でのやりとりからデータを抽出して長期記憶化できるように追加処理した方がいいんじゃあないですか?、と提案してきたのです。
あ、Gemniの場合、オリジナルの語調はもっと真面目です。Grok3の語調だと面白いかも。
チャットからの長期記憶事項の抽出と記憶化(mem0)
確かに。それは欲しい。
どうやら、前回PMAのツールとして用いたmem0のAdd MemoryとRetrieve Memoryを使うとそれが実現できるらしい。
前回、同じくそれらを使って、長期記憶化ができなかったのは、Instructionの設定になんらかの問題があったためのようです。
ということで、長期記憶、Long-Term Memory(LTM)のエージェント化を行いました。Instructionとか、Queryの変数とかは、全部Geminiにご相談。
確かに、会話中で覚えさせた項目を、リスタートしても覚えてくれるようになりました。また、特に指定しなくても、いくつかの項目は自動的に覚えてくれるようになっています。
それにしても、前回の時も、Gemini2.5ProのDeep Researchにお願いして作ってもらったのですが、、、ここで、バージョンの違いを思い出しました。
前回は、05-06でした。そして今回は、06-05。そして、特に、このバージョンは数学とかコーディング能力を強化したとのこと。
その違いかもしれません。また、巷でのmemO関連の使い方の情報が増えたためかもしれません、、ともかくmem0は、長期記憶に使えます。
今の所無料枠です。
PMA(Personal Mentor Agent)用のInstructionの見直し
LTM-Aができたので、最初に作ったパーソナル・メンター・エージェント(PMA)のInstructionを、見直しすることにしました。
少なくも、mem0のツールをLTM-Aに持っていったので、その部分の修正が必要かと考えました。つまりPMAからは、mem0系をオミット。
するとGeminiからは、異なる見解を得ました。
mem0系は残し、中期記憶として使えばいい、と。
なるほど、ということで、mem0を中期記憶として使うために残すことにしました。
さらに、検索機能を増強することにしました。実は、PMA用のInstructionを再びよく読んでみると、思いつきで追加していたPerplexityが、その記述にないことに気づきました。追記しないといけません。
この際なので、検索ツールについて、Geminiに見解を色々と聞きました。
その結果、現行の、Tabily Search, Arxiv Search, WolframAlfaに加え、より一般的な、Google Search, Wikipedia Search そしてPerplexity Searchを追加することにしました。
パーソナルメンターとして、一般的な情報もやはり必要だろう、ということでした。確かに、、。
そして、各ツールの詳細な比較を出力してくれましたが、この組み合わせの場合、Perplexityの優先順位を一番に持ってくる方が、より効率的だ、とのことでした。
mem0関連と、ツールの追加を織り込んだInstructionを作成してもらいました。前のバージョンよりも、より整理されてわかりやすくなっているように感じます。
それと、各ツールには、それぞれ説明文があります。その内容についても、Geminiに確認しました。Difyのオリジナルに大改訂が加えられています。
各ツールの説明文の記述内容の例
この説明文は、LLMがツール選定の際の判断理由とするので、とても重要なのだ、そうです。
そんなの、マニュアルのどこにも書いてないような気がする。
見落とし、ですかね。
たとえば、今回追加のPerplexity Searchの場合はこんな感じです。
全く違います。
オリジナル:
Search information using Perplexity AI's language models.
改訂版;
Tool name: Perplexity Search
Purpose: Provides direct, synthesized answers to questions by searching the web and consolidating information, often citing sources. Functions as an AI-native search and conversational answer engine.
Use case: When queries ask for explanations, summaries of complex topics, direct answers to "how" or "why" questions, or when a conversational exploration of a subject is beneficial. Ideal if the user prefers a concise, AI-generated answer with cited sources over a list of web links. Use when LTM indicates a user preference for summarized insights or when the query implies a need for deeper understanding rather than raw data.
Input: Question or search query string.
Output: Synthesized answer, potentially with a list of sources used. Output may include follow-up questions or related topics. (Output structure may vary based on Dify's specific Perplexity tool implementation).
ちなみに、InstructionとかPronptは、英語の方が動作がいいような気がしてます。
内容を理解するために、日本語でも出力してもらいますが。
構造化出力(JASON Schema)
Geminiと色々と質疑をしていく中で、データの伝達速度向上と、精度向上のために、データは、JASON Schemaで構造化出力にした方がいい、という表現が何度か出てきました。
はっきり言って、よく理解できていないので、初めは無視してましたが、ツールの数も増え、Thinkも入り、また、繰り返しも入れてるので、特に速度対策は必要なように思いました。
そこで、JASON Schemaを、KB-LLM nodeとLTM-Agent nodeのLLMに導入しました。それに伴い、LTM-Agent nodeのQueryの内容が追加されています。また、PMAのInstructionに対応する表現が新たに導入されています。
本チャットフローに用いるLLMについて
現在、選定理由としてわかってるのは、用いるLLMはOpenAI系のものにしておいた方がいいということです。
少なくとも、Gemini系とGrok3はダメです。
どうやら、JASON構文のルールが若干異なる、という本質的な理由らしく、
GeminiAPIのケースなどは、バグとしてDIfyに報告すべきだ、とのアドバイスをGemini2.5Pro-DRから頂いてしまいました。
Grok3も別な理由ですが、エラーが出ます。
さらに、OpenAI系でも、DifyのDify Agent Strategies 0.0.15では、o3やo4系は使えません。そもそも、このnodeの中では、選択リストに表示されません。今後のバージョンアップを待つしかなさそうです。ということで、現在は、LLMにgpt-4.1-mini-2025-04-14などを使っています。
まとめ
各nodeのLLMにOpenAIのgpt-4.1を使って、パーソナルメンター機能を発揮するチャットフローを作成しました。
本フローには、長期記憶と中期記憶機能があります。長期記憶には、Difyのナレッジ(RAG)とmem0のツールを組み込んだエージェントnode(LTM-A)を組み合わせて用いました。その結果、長期記憶にはチャットからの学習能力があります。
また、中期記憶には、別途、mem0のツールを用いて、LTM-Aとは別のPMA(Personal Mentor Agent) nodeに組み込んでいます。
パーソナルメンター機能の補助のために検索ツールを6種類導入し、適宜用いるようにInstructionを作成しました。
検索用ツールは、以下の6種類です。
Tabily Search, Arxiv Search, WolframAlfa、Google Search, Wikipedia Search Perplexity Search。
また、エージェントの思考を深化させるために、ツールとして、Think、を用いています。
現在の日時情報を得るために、Current Timeを用いました。
これらのツール(計10個)の説明文も新たに作成しました。既存のDifyのオリジナル説明文では、Agent nodeのInstructionの判断材料として不十分なためです。
今回は、上記構成の概略をノートしました。次回以降で、現バージョンのそれぞれの詳細説明と今後のバージョンアップ案を述べる予定です。
なお、現時点では、本フローは、DifyのDify Agent Strategies 0.0.15の制限により、OpenAIの、たとえばgpt-4.1のような限られたLLMでのみ使えるようです。
最新のo3系やo4系は使えません。
今後の同nodeのバージョンアップに期待したいと思います。
また、他社のLLMについても、少なくもGoogleのGemini2,5系とxAIのGrok3は、JASON文法の取り扱いの違いなどにより、エラーがでます。これは、いちユーザーには、解決が困難なようです。
その他については、今後、確認予定です。
