LLM Observability Toolの進化 -AI Agentの継続的品質向上の重要性 (2026年上旬まで)

はじめに
AI Agentの開発・活用が広がるにつれ、単に「動くものを作る」ことを超え、「本番で使い続けられる品質を保ちつつ、継続的に改善できること」に注目が集まってきました。特に業務・プロダクトに深く組み込まれるAI Agentでは、同じ入力でも出力がぶれる非決定性や、モデル・プロンプト・ツール定義の変更に伴うリグレッション(デグレ)によって、継続的に品質を担保しきれない場面が増えています。そこで鍵になるのが、実行時の推論経路やツール呼び出しをトレースし、評価・改善・監視を一体で回すための LLM Observability です。
本稿では、企業における生成AIの活用パターンの中でも、主に「業務・プロダクトに組み込まれるAI Agent」の開発を対象に、継続的に利用されるAI Agentの開発サイクルと、その難しさを整理します。そのうえで、LLM Observabilityツールに求められる役割がどのように進化してきたかを概観し、W&B Weave を例に、今日のLLM Observabilityツールが持つ機能を解説していきます。なお、このブログは以下のホワイトペーパーのIntroductionになります。フルバージョンは以下よりご確認ください。
本ブログが対象とする生成AI活用パターン
生成AIの活用が進む中、企業では「解決したい課題の複雑さ」や「業務・システムへの組み込み度合い」に応じて、生成AIの活用はいくつかのパターンに分かれていきます。大企業では、全社展開を進めるために活用の型を整理し、教育・ガバナンス・プロダクト提供の方針を揃える動きも出てきました。例えばSanofiでは、「全社員向けに手軽に使えるAI」「専門家向けAI」「生成AI/エージェント」を区別し、浸透と統制の両立を設計しています。こちらのケースの詳細は、Fully Connected London 2025 におけるSanofiの講演を参照してください。
個別企業ごとに差はありますが、大きなパターンとしては以下の図の通りです。一企業の中でどれかのパターンだけに取り組むというよりも、複数のパターンを技術的障壁とカスタマイズ性を考慮し、使い分けられるのが一般的です。
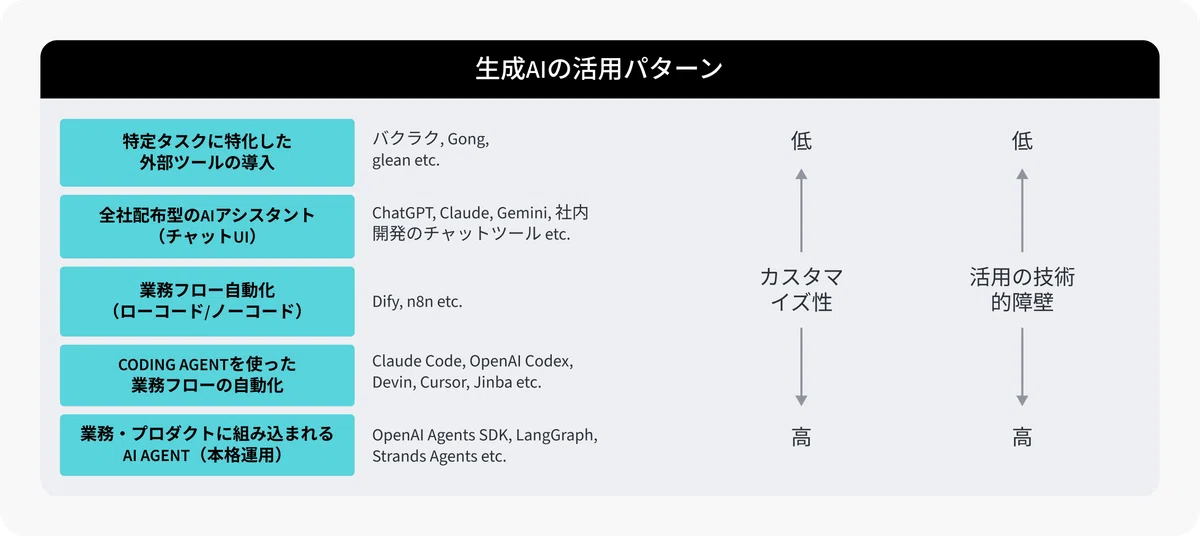
特定タスクに特化した外部ツールの導入: 特定タスクに特化した外部ツールを業務に導入するパターンです。業務特化の生成AIツールが提供されており、自社の業務フローにそのまま適応できる場合には、生成AIの恩恵を素早く受けることができます。業務特化のツールの例としては、議事録作成や商談記録の支援であればGong、社内ナレッジ検索・エンタープライズサーチであればglean、経費精算の自動化であればバクラクなどがあります。
全社配布型のAIアシスタント(チャットUI): 全社員が使えるチャット型の生成AIを用いて、文書作成・要約・情報整理などの日々の業務の生産性を上げたり、新しいアイデアを得ることを促進するパターンです。非エンジニアも含めた個人の生産性を広く底上げできる一方、専門的な業務フローや権限管理に深く組み込みづらく、カスタマイズ性には制限があります。ツール例としては、ChatGPTやClaude、Geminiなどがあります。
業務フロー自動化(ローコード/ノーコード): 1回の応答で終わらない定型業務に対して、生成AIを含む複数ステップの自動化フローを組み立てるパターンです。例えば、社内の複数リソースにアクセスして必要情報を集め、それぞれに適切な処理(分類・要約・承認依頼など)をかけ、次のプロセスへ流すといった形です。ローコードで自動化フローを実現できるサービスが登場し、複雑なAI Agentを開発する必要がない業務に比較的少ないコストで定型業務に生成AIを適用できる利点があります。ツールの例としてはDifyやn8nなどがあります。
Coding Agentを使った業務フローの自動化: エンジニアが、Coding Agentを使い、コーディング業務を効率化したり、調査・資料作成などの業務自動化を行うパターンです。近年はSkillsのような仕組みの普及も進み、コーディングだけではなく、業務フローの自動化を「再利用可能な型」として蓄積するという流れもあります。サービス例としては Claude Code、OpenAI Codex、Devin、Cursorがあります。ビジネスユーザー向けに、自然言語でフローを自動生成してくれるJinbaなどもあります。
業務・プロダクトに組み込まれるAI Agent(本格運用型): 複雑なタスクや中核の業務、外部向けサービスを対象に、コードを用いてAI Agentの開発を行うパターンです。実装の難易度は上がりますが、カスタマイズ性がもっとも高く、うまく管理できれば組織としてのアセットも蓄積しやすい方法です。実装には OpenAI Agents SDK、LangGraph、Strands Agents(AWS)などのライブラリが使われたり、独自のAgent構築ライブラリを開発するケースも増えています。
本稿が主に対象とするのは、カスタム性の高い社内コールセンター向けのAgentic RAGや特定領域に特化した研究支援ツール、自動運転開発のための動画トリアージ自動化ツールなどを含む「業務・プロダクトに組み込まれるAI Agent(本番運用型)」です(一部、「業務フロー自動化(ローコード/ノーコード)」も含みます)。このパターンでは、開発時のデバッグだけでなく、本番での挙動の可視化・評価・監視を通じて改善サイクルを回し続け、品質を向上させるためのOps(運用の仕組み)が欠かせません。本稿では、そうしたOpsを支える LLM Observability の観点から整理していきます。
継続的に利用されるAI Agentの開発に向けて
AI Agent開発のサイクル
まずは、AI Agentの開発サイクルを見ていきましょう。以下に全体像を示します。
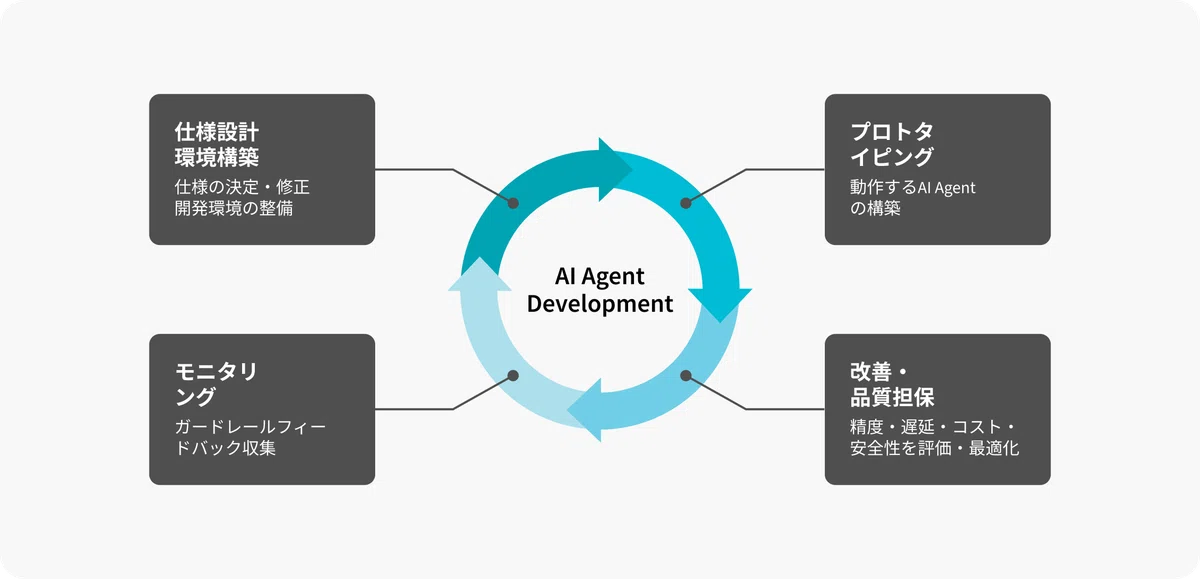
仕様設計・環境構築: ビジネス起点で目的と期待値を定め、現場や経営層も巻き込んで合意します。あわせてセキュリティの前提を整理し、データソースや社内ツールへの権限付与、開発・実行環境を整えます。
プロトタイピング: まず動くMVP(Minimum Viable Product: 価値検証に必要な機能に絞った最小プロダクト)を作り、実データや実際の業務シナリオで試します。この段階でユーザーに確認してもらい、使われ方や期待との差分を踏まえて、大きな仕様の方向性を固めていきます。また、この段階で、大まかな技術検証も行います。
改善・品質担保: 品質担保・向上に向け、数件の確認だけで判断せず、さまざまなケースで評価し、正確性やレイテンシ、コストをはじめとする評価指標を設け、最適化していきます。変更のたびに品質を比較できるよう、評価データセットと評価体系を継続的に整備することが重要になります。
モニタリング: 本番での品質、コスト、遅延、失敗率を継続的に監視します。ユーザーの利用状況やフィードバックを集め、評価データセットの更新や次の改善につなげます。
当たり前ですが、AI Agentは一度リリースしたら終わりではなく、上記のステップを繰り返し行っていく必要があります。<span class="hl-yellow-soft">ここまで何の違和感もなく読まれた読者も多いのではないでしょうか。一方で、従来のAI開発よりも改善・品質担保の難易度がはるかに高く、さらに高い頻度で再開発が求められるケースが多いため、上記のサイクルを回すこと自体、困難を伴います。</span>なぜ難易度が高いのか、見ていきましょう。
求められる継続的な開発の難しさと解決策
まず、なぜ「改善・品質担保」が難しいかを見ていきましょう。すべての挙動がハードコードで制御される従来ソフトウェアと異なり、AI Agentは性質上、挙動が確率的に決まります。また、従来のAIと比べて、1つのシステムで多数の課題を解決できるようになった一方、さまざまなシナリオに対して複数の指標で良し悪しを判断できる評価体系を整備する必要があります。さらに厄介なのは、自然言語などの非構造化データを出力することが多く、単一の数値指標で明確に勝敗が決まるとは限らない点です。何をもって「良い」とするかが現場の好みに依存するケースも多く、基準の定義から時間がかかります。加えて、人手での確認が欠かせない場面も多く、検証そのものにも時間がかかります。さらに、評価に用いるデータセットの整備も容易ではありません。
また、評価が一通り終わり、本番運用を開始したとしても、AI Agentは多くのケースで自然言語などの非構造データを受け付けるため、入力の自由度が高く、想定外の問いや使い方が発生しやすい特性があります。さらに、利用が広がるにつれてユーザーの使い方や期待値も変化し、運用の中で挙動のドリフトが起きやすくなります。加えて、LLMや関連フレームワークは数ヶ月単位で進化するため、従来のAI以上に、外部環境の変化を前提とした更新が求められます。評価プロセスをOpsとして構築していないと、再評価・改善に時間がかかり、ビジネスで求められる頻度での再開発が非現実的になってしまいます。こうした点に、AI Agent開発の難しさがあります。
こうした課題を解決するために、Opsが必要となります。まず、評価体系の属人化の解消に着手する必要があります。この課題を放置すると判断が属人化し、改善がスケールしません。「全体的に良い/悪い」といった印象論ではなく、評価項目を分解し、判断基準を揃えたうえで運用できる仕組みを作り上げていきます。また、すべてのバージョンを毎回人手で確認し続けるのは現実的ではないため、LLM as a Judge などを取り入れて自動評価を拡張し、人手評価を補完しながら、検証の量と速度を確保するOpsが重要になります。
評価データについても、いきなり多くのデータを用意できないため、運用しながら評価体系を作っていくというマインドセットとOpsが重要になります。なお、評価体系構築のマインドセットについては次のコラムを参照ください。
また、改善に向けては、運用時にユーザーのフィードバックやレイテンシ、コストを常に監視するモニタリングダッシュボードも必須になります。ユーザーからのフィードバックが常に得られるとは限らないため、簡単な評価を LLM as a Judge で準リアルタイムに行う仕組みが必要になることもあります。
上記のモニタリングをもとに、再開発の判断を行い、新しいバージョンを開発(モデルやプロンプト、ナレッジベース、ツールなどを改善)しても、これまで動いていたケースが動かなくなるリグレッション(デグレ)が起こり得ます。そのために、評価体系のバージョンとAI Agentのバージョンをしっかり管理し、品質を比較できる状態を作ることもサイクルを回す上での重要ポイントです。このあたりのワークフローは、属人要素が多いほど、各ステップに時間がかかってしまいます。
上記のように、継続的に利用されるAI Agentを開発するためには、Opsを組織で作り上げ、成長させていく体制づくりが求められます。この体制ができてはじめて、AI Agentは資産として持続的に活きてきます。
そして、そのOpsの構築にあたっては、LLM Observabilityツールが大きな役割を果たします。次にLLM Observabilityツールを見ていきますが、その前にAI Agentの評価体系の作り方を理解しておくことが重要なので、次のコラムで理解を深めていきます。
コラム: AI Agentの評価体系の作り方
AI Agentの評価体系をどのように設計・構築すべきか、迷う場面は少なくないでしょう。このコラムでは、AI Agent評価体系構築の概要を示します。なお、よくある評価指標や評価方法(LLM as a Judge など)、実装上の論点は、W&Bのホワイトペーパー「生成AIアプリケーションの評価とオブザーバビリティ」で体系的に解説されているので、そちらをご参照ください
AI Agentの評価体系は、成果物(AIの出力)に対する評価の基準が曖昧であることがプロジェクトの初期段階が多く、また評価データセットも豊富に最初から多くあるわけではないので、最初から完璧なものを作ることはできません。「逐次的に評価体系を構築していく」という心持ちが最も重要になります。例えば、Algomaticの事例がわかりやすいので、その例をもとにみていきましょう。
Algomaticは、生成AIの前からある開発の考え方 “Inner Loop・Middle Loop・Outer Loop”をベースに、開発サイクルを意識し、評価を単発のテスト設計ではなく、速度と役割が異なるループを同時に回す運用モデルとして捉えています(2025年2月の発表より: W&B AIエージェントLT会・Algomatic 宮脇(Speaker Deck))。
Inner Loop(速く試す): まずInner Loopでは、モデル選択やプロンプト作成を行い、ドメインエキスパートと実際の挙動を見ながら「この方向性に価値があるか」を最速で試します。ここでは完璧な評価よりもスピードを優先し、仮説検証を高速に回すことで、変化の兆しや新しい要求を早期に捉えます。
Middle Loop(品質を固める): 次にMiddle Loopでは、Inner Loopで見えた有望な案を、評価データセットやテスト設計を用いて検証します。概念ドリフトや評価指標ドリフトに向き合いながら、性能・安全性・制御可能性を確認し、本番に出せる品質を固めていきます。
Outer Loop(現実から学ぶ): そしてOuter Loopでは、本番環境でAIエージェントを運用し、レイテンシや品質、ユーザーの反応を継続的にモニタリングします。現実の利用から得られたデータやフィードバックを次の改善に活かし、必要に応じてInner LoopやMiddle Loopへと戻していきます。
このように、Inner Loopで速く試し、Middle Loopで品質を固め、Outer Loopで現実から学び続けるという構造を用いることで、本番環境において継続的に価値を生み出すプロダクトにされています。また、この方法の良いところは、Inner Loopを回しながら、評価データセットのサンプルをいくつか集めることができるという点で、改善を回しながら評価体系を太くしていくことができるようになります。
同じ思想を、Anthropicもブログで解説しています。評価がない場合の開発リスクとして、劣化に気づけない・デバッグが常に後手になる・変更の影響範囲を把握できない・改善効果を説明できない・新しいモデルや手法を試しにくいといった点を挙げ、評価を“後から品質を測る仕組み”ではなく、開発を加速させるための基盤として位置づけています。以下、Anthropicの「ゼロから始めるAIエージェント評価の作り方」のまとめです。
https://www.anthropic.com/news/demystifying-evals-for-ai-agents
Step 0: とにかく早く始める: 評価は遅れるほど作りにくくなります。最初は20〜50件程度の小さなタスクで十分です。実際の失敗例や想定ユースケースから作ることで、初期段階でも十分な効果があります。
Step 1: 手動で確認していることをそのまま評価にする: リリース前に人が確認している挙動や、ユーザーから報告された不具合は、そのまま評価タスクになります。実利用に近い評価を優先することで、投資対効果が高くなります。
Step 2: 曖昧さのないタスクを書く: 良い評価タスクとは、2人の専門家が同じ合否判断をするタスクです。仕様が曖昧だと、評価結果はノイズになります。各タスクには「正しく動いた例(リファレンス解)」を用意し、評価自体が壊れていないことを確認します。
Step 3: 偏らない問題セットを作る: 「やるべきケース」と「やらないべきケース」の両方を評価します。片側だけを評価すると、過剰に反応するエージェントが生まれやすくなります。
Step 4: 本番に近い安定した評価環境を作る: 評価用エージェントは本番とほぼ同じ構成で動かし、各実行はクリーンな状態から始めます。環境由来の失敗や偶然の成功は、評価の信頼性を大きく下げます。
Step 5: グレーダーは慎重に設計する: 可能な限り決定的な評価を使い、必要な場合のみLLM-as-a-Judgeを使います。重要なのは「どう作ったか」ではなく「何を達成したか」を評価することです。部分点も積極的に取り入れます。
Step 6: 必ずトランスクリプトを読む: スコアだけを信じてはいけません。失敗がエージェントの問題なのか、評価の問題なのかを見極めるために、定期的に実行ログを確認します。
Step 7: 評価の“飽和”に注意する: スコアが100%に近づくと、改善のシグナルは弱くなります。その場合は、より難しいタスクを追加し、評価自体を進化させる必要があります。
Step 8: 評価は「育て続けるもの」: 評価は生き物です。専任の基盤管理と、プロダクト・ドメイン担当者による継続的なタスク追加が、長期的な価値を生みます。
評価は単体では不十分であり、多層で捉えることが重要であることもブログでは解説されています。自動評価は高速で再現性が高く、CI/CDにも組み込みやすい強力な手法ですが、それだけでAIエージェントの品質を完全に把握できるわけではありません。本番モニタリングは実ユーザーの現実を捉え、A/Bテストは変更の因果効果を検証し、ユーザーフィードバックや人手レビューは自動評価では見逃されがちな問題や微妙な品質差を明らかにします。重要なのは、これらをどれか一つに頼るのではなく、重ねて使うことで、これは安全工学における「スイスチーズモデル」と同じ考え方であることをAnthropicは強調しています。複数の評価手法を組み合わせることで、一つの抜け穴を別の層が補い、重大な問題を防ぐことができます。上記のように、評価は運用する中で継続的に育てていくものという認識を持ち、進めていくことが重要になります。
製薬企業GSKの事例
実際の上記の考えを実装している製薬企業のGSKでは、社内のGenAI/Agent基盤(AIGA)の中核レイヤーに、後ほど紹介する W&B Weave の評価とトレーシングを組み込み、「開発初日からすべてをトレースする」状態を前提に運用を設計しています。
そのうえで、次の3本柱からなる「Agentic AI Playbook」を整備し、改善サイクルを回しています。
(1) 現場のフィードバックを蓄積してゴールデンデータセット化する Knowledge capture
(2) 再利用可能な評価指標・スコアラーで新しいLLMやAgent戦略を素早く比較する Rapid prototyping
(3) 本番トレースを継続的に記録してブラックボックス化を防ぎ、どの振る舞いがどの変更に起因するかを追える Monitoring and governance
これは、評価データ・評価体系・監視を“場当たり的に”揃えるのではなく、ツールと運用を一体で整え、継続的に回せる形に落とし込むことが重要であることを示す好例です。(参照: Physical AI at GSK: Unlocking business value with foundation models and digital twins)
AI Agent開発のOpsが蓄積されたLLM Observabilityツール
なぜLLM Observabilityツールが必要になったのか
従来のソフトウェアでは、コードを読めば処理の流れが分かり、入力とコードが分かれば振る舞いもある程度は予測できました。不具合が出ても、ログやスタックトレースを手がかりに原因を特定し、コードを直して再デプロイすれば改善できます。従来のObservabilityは、この「壊れていないか」を素早く検知し、「なぜ壊れたか」を追えるようにするための仕組みでした。
一方、生成AIアプリケーションやAI Agentは、同じ入力でも出力がぶれる非決定的な振る舞いをします。さらにAI Agentでは、実行のたびに推論の経路やツール呼び出しが変わりやすく、失敗したときに「どの行が悪いか」ではなく「どの判断・どの一手が期待とずれたか」を突き止める必要があります。つまり、コードやプロンプトは枠を作るだけで、実際に何が起きたかは実行時の記録を見ないと分かりません。
そこで中心になるのが、推論やツール実行の流れを記録するトレースです。LLM Observabilityでは、トレースを軸に、デバッグ、評価、監視を一体で回せる状態を作り、AI Agentを継続的に改善していくための土台を提供します。
LLM Observabilityツールに求められる役割の進化
生成AIの登場に伴い生まれたLLM Observabilityですが、求められる役割もAI Agentの進化に伴い、変化しつつあります。ここ数年で、当初の「ログを集めて見られる」から、AI Agentの継続的な品質改善と品質担保を支えるものへと広がってきました。ここでは、今日のLLM Observabilityに求められる役割の全体像をつかむために、役割の進化を3つのフェーズに分けて見ていきましょう。
第1フェーズ: 基本的なトレースと監視・評価
まず必要になったことは、開発者が生成AIアプリケーションの中で「何が起きたか」を事実ベースで追えることでした。いわゆるトレースと呼ばれる機能です。プロンプト、入出力の記録、レイテンシやコストの把握といった“見える化”に加え、本番での基本的な監視、ヒューマンフィードバックの収集がここに含まれます。例えばRAGなら、どのクエリで、どのドキュメントが検索・抽出され、どのプロンプトが適用され、どの出力が返ったのかを辿れる状態を作ります。これにより、遅延やコストがどこで発生しているか、失敗がどの入力パターンで起きているかを把握でき、改善の当たり所が明確になります。
また同時に、評価体系の構築への関心も高く、評価体系を構築する機能がLLM Observabilityツールの要件として初期から求められました。なお、この時点では、RAGのように処理手順があらかじめ決められた(決定論的な)ワークフローが中心となっています。
第2フェーズ: AI Agent対応とモニタリング
その後、LLMがタスクを理解し、必要なツールを自律的に選択し、計画を立て、その計画に基づいて外部ツールを呼び出しながら目標達成を進めるAI Agentが登場し、LLM Observabilityツールに求められる要件が大きく変わっていきます。
AI Agentでは、マルチステップでツールを呼び出し、途中結果を保持しながら進むため、「どのツールをいつ呼び、何が返り、その結果どんな判断をしたか」まで追えるトレースが必要になります。加えて、ステップ間の親子関係や分岐が見えるなど、AI Agentに特化した可視化も求められるようになってきました。例えば、AI Agentは複数のやり取りにまたがって動作することが多く、リクエスト単位のトレースだけでは全体像が掴めません。そこで、関連するトレースを会話・セッション単位で束ねて見られる仕組みが `Threads` です。これにより、セッション全体を通じて「どこから期待とずれたか」「どの時点で誤った前提が入ったか」を追いやすくなります。
また、本番運用に進むAI Agentも増え、ガードレール(禁止事項や許容範囲を定めたルール)への関心も高くなってきました。「危ない出力を防ぐ」だけでなく、どのルールに該当したのか、その根拠となる入出力を記録として残し、後から妥当性を検証・改善できることが求められてきました。
あわせて、開発速度への要求が日々上がり、Playgroundのような機能も求められるようになりました。Playgroundとは、UI上でモデルやプロンプトを素早く変更し、その効果をすぐに確認できる機能です。第2フェーズでは、AI Agent開発の分かりやすいペインポイントに対応する機能開発が進んだフェーズといえます。
第3フェーズ: 本番運用を意識した基盤と継続的な品質改善
プロトタイプから本番運用に進むAI Agentが本格的に増えてくる中で、「作ったAgentが安定して本番で使われ、しかも改善を続けられる」要件へのニーズが高くなってきました。「単に作る」から「使われる」への意識の変化です。前述の通り、本番運用に進むAI Agentが増えるほど、デバッグのしやすさだけでは足りず、継続的な品質改善を回すための運用と基盤が重要になります。
そのため、単に「評価ができる」だけでは不十分で、改善サイクルを回し続けるための細かな設計が求められるようになります。プロンプトやモデル、ツール定義を少し変えただけで別のケースの品質が落ちる(デグレする)ことを前提に、変更のたびに代表ケースで性能比較を回してデグレを検知し、問題のある変更を早期に止められる状態が必要です。そのために、評価体系の構築が求められる一方、最初から完璧な評価データセット(ゴールデンデータセット)は存在しないため、実際のユーザーのクエリ(入力)とフィードバックから継続的に評価データセットを更新する機能など、継続改善を意識した要件が細かく求められてきました。
また、品質改善をスケールさせるには、現場のアノテーション作業の効率化も無視できません。そのため、現場の人がツール上で人手評価できる導線(キュー/レビュー/差戻しなど)を用意するアノテーション機能も求められています。
本番利用に進むAI Agentの開発が進むにつれ、エンタープライズ企業では、トレースしたデータをどこに置くか(データレジデンシや機密情報の扱い)を含むセキュリティ要件、権限管理、監査ログ、データ保持ポリシーなどへの関心もより一層高くなります。加えて、トレース量が増えても欠損や遅延が実用上問題にならないスケーラビリティも重要なポイントです。最初はDockerでローカルに立てた軽量な仕組みで始められても、本番運用が広がると運用・スケールの壁に直面し、そこから先へ進みにくくなるケースも多いです。こうした点も含めて、セキュアでスケーラブル、かつメンテナンスしやすい環境へのニーズも地味ですが、クリティカルになってきました。
大きな流れとして、LLM Observabilityツールに求められる機能は「デバッグ・監視のためのツール」から「Agentの挙動を可視化する基盤」へ、さらに「エンタープライズレベルで品質を継続的に改善する仕組み」へと広がってきました。
なお、このフェーズ分けは厳密に時系列で区切れるものではなく、実際には前後する部分もありますが、大きな流れは上記の整理で掴んでいただけるかと思います。継続的に活用されるAI Agentの開発に向けては、単にトレースが見られるだけでは不十分です。セキュアでスケーラブルに運用できる環境の上で、AI Agentのバージョンと評価のバージョンを一体で追跡し、さまざまなシナリオで性能比較・デグレ検証を回せることが重要になります。さらに、現場の人手評価を運用に組み込みつつ、LLM as a Judge などの自動評価でスケールさせ、ガードレールやオンライン評価の根拠を残しながら、ゴールデンデータセットを継続的に更新できることが「回し続ける」ための鍵になります。
Weights & Biasesは、エンタープライズレベルで品質を継続的に改善する仕組みを重要視し、Weaveの開発を進めてきました。Weave以外にもLLM Observabilityツールが提供されていますが、Weaveと他のLLM Observabilityツールも含めた機能表を以下に示します。
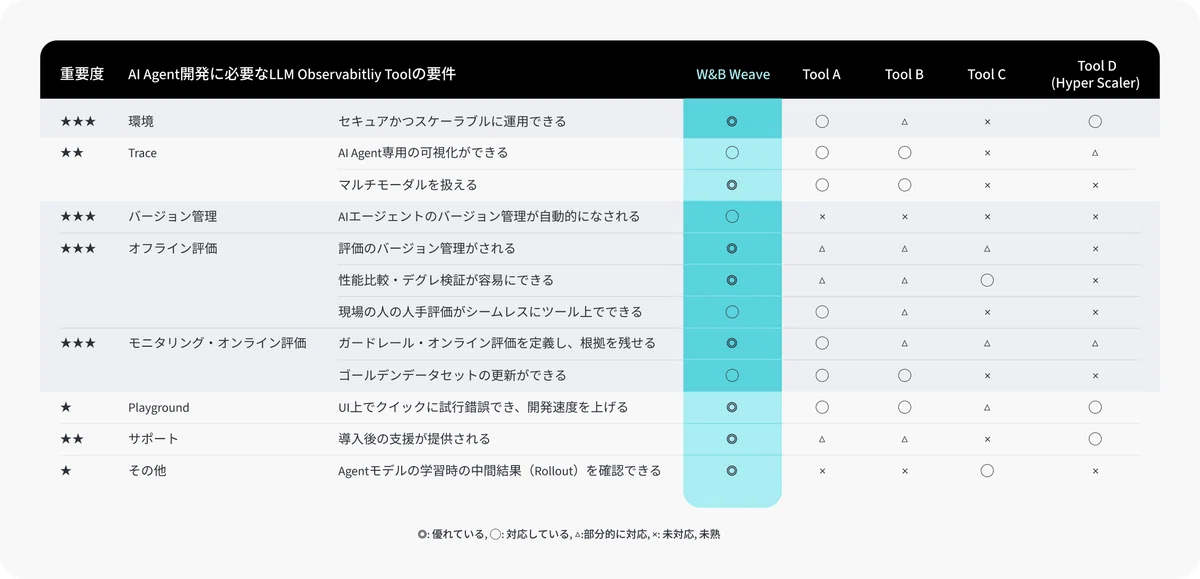
なお、表には上記の観点に加えて「サポート」と「その他」も入れました。OSSツールと異なり、Weights & BiasesはサーバーのデプロイやWeaveの利用に伴うサポートも提供しています。新しい領域のOpsを開発・運用する際は、企業ごとの要件に合わせた個別対応や、機能改善の相談が発生しやすく、サポート体制の厚さは無視できません。特にAPACでは、現地のエンジニアが日本語・韓国語でサポートしている点が、他のObservabilityツールとの大きな違いの一つです(2026年3月現在)。
また2025年頃から、AI Agentを支えるモデルの学習(ファインチューニング/強化学習など)に取り組む例が増え、学習過程でAI Agentの振る舞いをトレースして検証したいニーズも高まってきました。Weights & Biasesが提供する実験管理ツールのW&B Modelsと、本稿で紹介するW&B Weaveを組み合わせることで、学習から運用までをつなぐワークフローを構築できます。これもWeaveが他のObservabilityツールとの違いの一つです。
コラム: Vibe Coding から Agentic engineering へ
生成AIを用いたコーディングは、Andrej Karpathyが2025年2月にXでふとした考えを投稿したことをきっかけに、Vibe Coding という名前で広まりました。当時はLLMの能力がまだ低く、おもに趣味のプロジェクトやデモ・探索で「なんとなく動く」楽しさが中心でした。
それから1年後のいま、LLMエージェントを使ったプログラミングは、プロの現場でも当たり前のワークフローになりつつあります。ただし、役割は変わっています。コードの大半を自分で書くのではなく、エージェントをオーケストレートし、監視・レビューする側に回ることが多くなっている、というのがKarpathyの整理です。目的は、エージェントのレバレッジを手に入れつつ、ソフトウェアの品質を妥協しないこと。この「質を妥協しない」文脈で、彼は Agentic engineering(エージェント開発の工学)という呼び方を推しています。Vibe Codingの文脈でも品質への関心が集まるようになり、本番で使い続けるための品質担保がますます重視されています。「agentic」は「直接書くのではなくエージェントを指揮し、監視する」こと、「engineering」はそこに学べる技と深みがあるという意味を込めた名前です。Vibe Codingから品質を意識したAgentic engineeringへのシフトは、大量にAI Agentが生み出される中で、AI Agentの品質がますます重要になってきたことを物語る一つの視点になります。
Weaveについては、ホワイトペーパーの続きをご確認ください。
