Claude Fable 5.1 がリリース! いち早く概要・特長をキャッチアップ

更新日:2026/9/2
「高難度のコーディングや長時間の調査にはFable 5を使いたい。でも、運用コストや既存システムへの影響も気になる」
そう考えていた開発者や企業ユーザーにとって、注目度の高い新モデルが登場しました。
Anthropicは2026年9月1日、Claudeシリーズの新モデル「Claude Fable 5.1」と、承認された組織向けに限定提供する「Claude Mythos 5.1」を発表しました。
両者は同じ基盤モデルを使用していますが、適用されるセーフガードの範囲が異なります。Fable 5.1は一般提供モデルであるのに対し、Mythos 5.1はサイバーセキュリティやライフサイエンスなどの専門用途を想定し、信頼されたアクセスプログラムの承認顧客に提供されます。
Mythos 5.1は「セーフガードがないモデル」ではありません。専門的な研究開発を可能にするため、Fable 5.1より許容範囲の広いセーフガードを適用しつつ、その他の保護策は維持されています。⟦S2⟧ ⟦S3⟧ (Anthropic)
この記事では、Claude Fable 5.1について次のポイントを整理します。
Fable 5.1の基本仕様とClaudeシリーズ内での位置づけ
性能面と研究用途で何が変わったのか
API料金とキャッシュ値下げの実際の効果
Claude、Claude Code、APIからの利用方法
移行前に確認したい破壊的変更と運用上の注意点
※本記事は、2026年9月2日時点で公開されているAnthropicの公式情報を中心に構成しています。
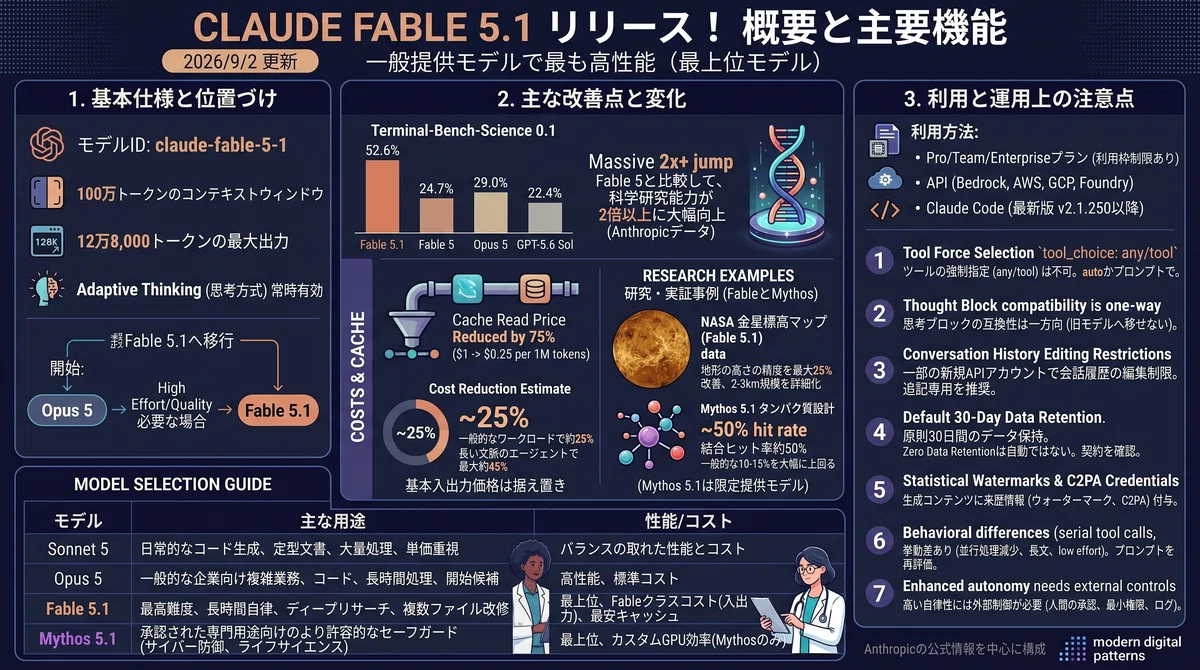
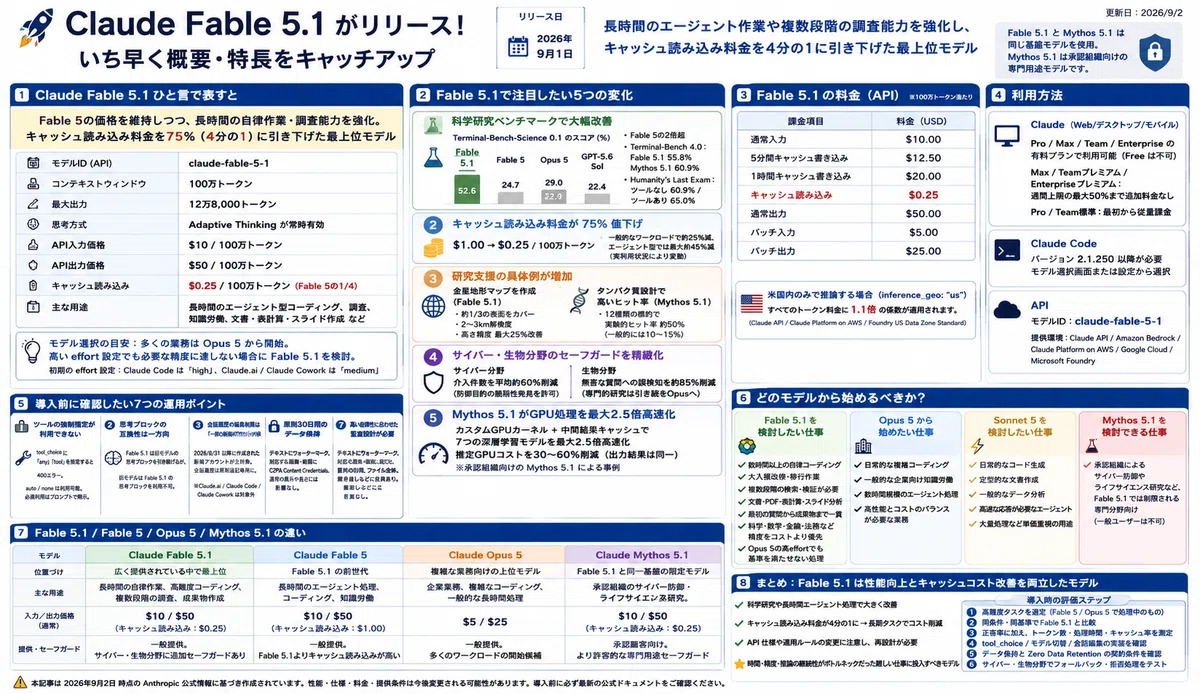
※作成した記事内容をGammaに入力しスライド自動作成させました。スライドの方が見やすいようでしたらこちらをご覧くださいませ。
1. Claude Fable 5.1をひと言で表すと
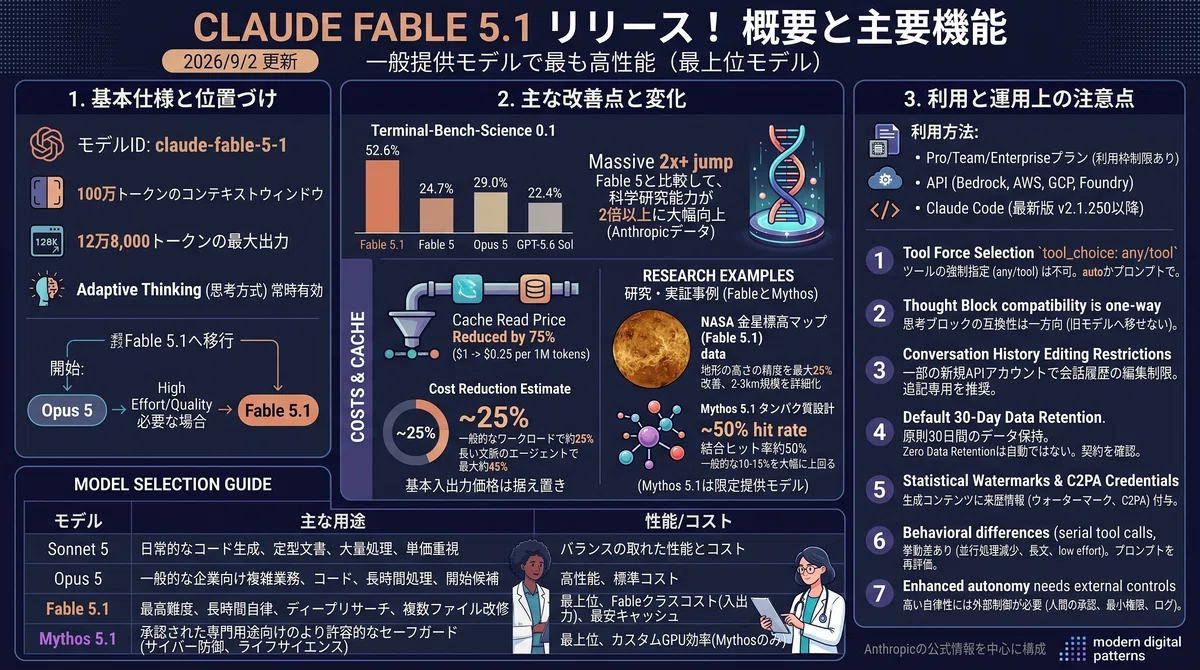
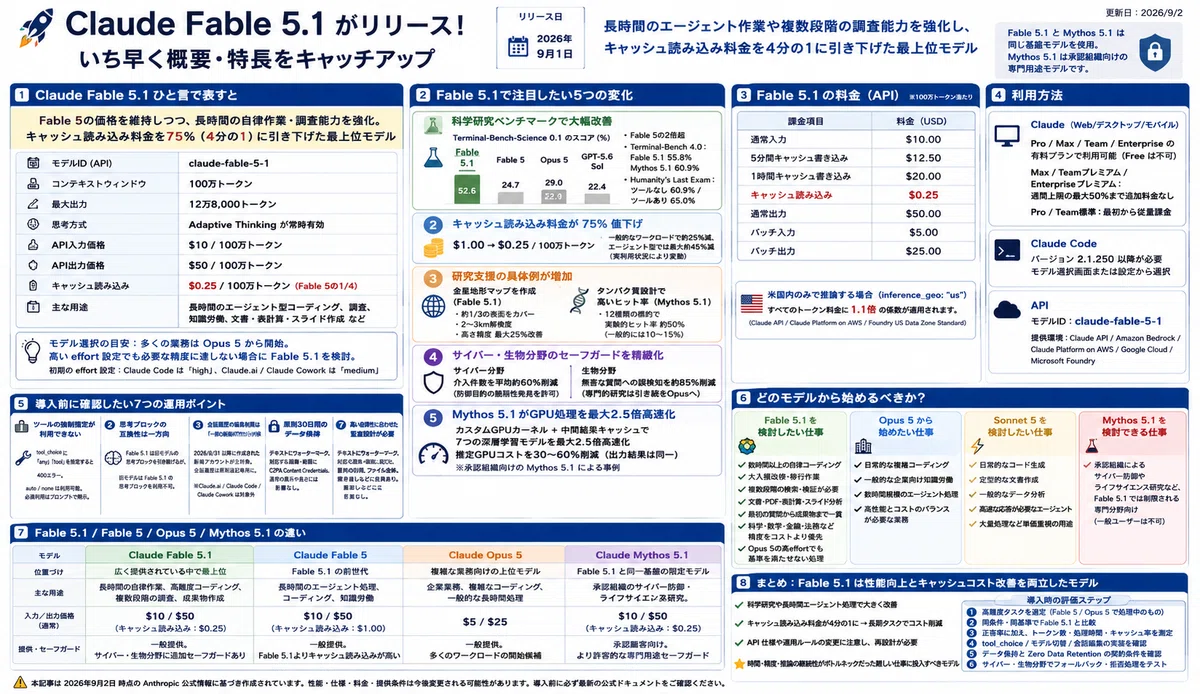
Claude Fable 5.1は、Fable 5の基本入出力価格を維持しながら、長時間のエージェント作業や複数段階の調査能力を強化し、キャッシュ読み込み料金を4分の1に引き下げたモデルです。
主な仕様は次の通りです。
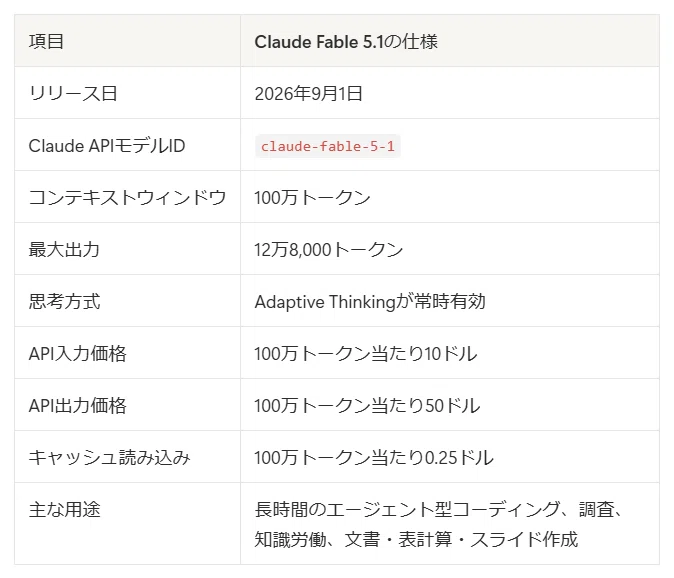
コンテキストウィンドウと最大出力は、Claude Opus 5やClaude Sonnet 5と同じです。一方、Fable 5.1はAnthropicが「広く提供されているモデルの中で最も高性能なモデル」と位置づける最上位モデルです。
ただし、Anthropicはすべての用途でFable 5.1から始めることを推奨しているわけではありません。一般的な業務ではまずOpus 5を使用し、高いeffort設定でも必要な精度に達しない場合にFable 5.1へ移行する、という選択手順を案内しています。⟦S3⟧ ⟦S10⟧ (Claude Platform)
なお、effortの初期設定は利用環境によって異なります。Anthropicの発表では、Claude Codeでは「high」、Claude.aiとClaude Coworkでは「medium」が初期値とされています。⟦S2⟧ (Anthropic)
2. Fable 5.1で注目したい5つの変化
1つ目:科学研究ベンチマークで大きく改善した
Fable 5.1で特に大きな改善が示されたのが、エージェント型科学研究ベンチマーク「Terminal-Bench-Science 0.1」です。
Anthropicが公表した評価結果は次の通りです。
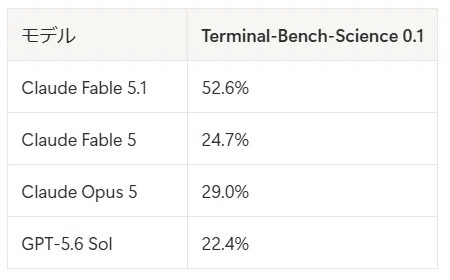
Fable 5.1は、Anthropicの評価環境においてFable 5の2倍を超えるスコアを記録しました。
ほかにも、エージェント型コーディングの「Terminal-Bench 4.0」ではFable 5.1が55.8%、Mythos 5.1が60.9%、「Humanity’s Last Exam」ではツールなしで60.9%、ツールありで65.0%という結果が示されています。
ただし、これらはAnthropicが実施・公表した評価です。Terminal-Bench-Scienceでは各モデルに±3.5~4.5ポイントの標準誤差があるため、近いスコア同士の順位よりも、Fable 5からの改善幅を見る方が適切です。⟦S2⟧ (Anthropic)
2つ目:キャッシュ読み込み料金が75%下がった
Fable 5.1の基本入出力価格はFable 5から変わっていません。
一方、プロンプトキャッシュの読み込み料金は、100万トークン当たり1ドルから0.25ドルへ引き下げられました。Fable 5と比べて75%の値下げです。
Anthropicは、2026年8月の実際の利用データをもとに、トークン従量課金の一般的なワークロードではFable 5より約25%、長いコンテキストやツール呼び出しを多用するエージェント型ワークロードでは最大約45%のコスト減になる可能性があるとしています。
ただし、これはすべての利用者に保証される削減率ではありません。短い単発処理や、キャッシュをほとんど再利用しない処理では、Fable 5とのコスト差は小さくなります。⟦S2⟧ ⟦S4⟧ ⟦S5⟧ (Anthropic)
3つ目:研究支援の具体例が増えている
Anthropicは、Fable 5.1とMythos 5.1を使った科学研究の事例も公表しています。
Fable 5.1は、NASAのマゼラン探査機が30年以上前に取得した金星のレーダー画像と既存の標高データを利用し、金星表面の約3分の1を対象とした新しい標高マップを作成しました。
Anthropicによると、従来の標高データが10~20km規模の詳細を捉えていたのに対し、新しいマップでは2~3km規模の地形を示し、高さの精度も最大25%改善したとされています。このマップはCreative Commonsライセンスで公開されています。
一方、タンパク質設計を行ったのは限定提供モデルのMythos 5.1です。12種類の標的に対して、実験室で結合が確認された設計の比率が約50%に達しました。Anthropicは、現在のタンパク質設計では10~15%程度が一般的なヒット率だと説明しています。
これらは有望な事例ですが、Anthropicが主導した実験・報告であり、あらゆる研究課題で同じ性能が再現されることを保証するものではありません。⟦S2⟧ (Anthropic)
4つ目:サイバー・生物分野のセーフガードが精緻化された
Fable 5.1では、防御目的でソフトウェアの脆弱性を発見する用途が許可されるようになりました。
Anthropicによると、セーフガードの精度改善により、Claude Codeユーザーが受けるサイバー関連の介入は、Fable 5の従来のセーフガードと比べて1セッション当たり平均約60%減少する見込みです。
ただし、次のようなデュアルユース性の高い処理は、引き続きOpusモデルに振り分けられます。
ペネトレーションテスト
エクスプロイト生成
バイナリを対象とした脆弱性スキャン
生物分野では、初歩的な生物学や一般的な医療質問など、無害なリクエストに対するセーフガードの発火率が約85%減少しました。一方、専門的なライフサイエンス研究開発のリクエストは、引き続きOpusモデルへ振り分けられます。
したがって、「生物分野の制限が85%減った」のではなく、初歩的・日常的な無害な質問に対する誤検知が減ったと理解するのが正確です。⟦S2⟧ (Anthropic)
5つ目:Mythos 5.1がGPU処理を最大2.5倍高速化した
ゲノミクスやタンパク質解析向けのカスタムGPUカーネルを作成したのは、Fable 5.1ではなくMythos 5.1です。
Mythos 5.1は、カスタムGPUカーネルの作成と中間結果のキャッシュを組み合わせ、7つのオープンソース深層学習モデルを最大2.5倍高速化しました。出力結果は変更せず、ゲノム規模の解析における推定GPUコストを30~60%削減したとAnthropicは報告しています。
これは一般提供されているFable 5.1の利用事例ではなく、承認された研究者・組織向けのMythos 5.1による事例である点に注意が必要です。⟦S2⟧ (Anthropic)
3. Fable 5.1の料金をどう評価するか
Fable 5.1のAPI料金は次の通りです。
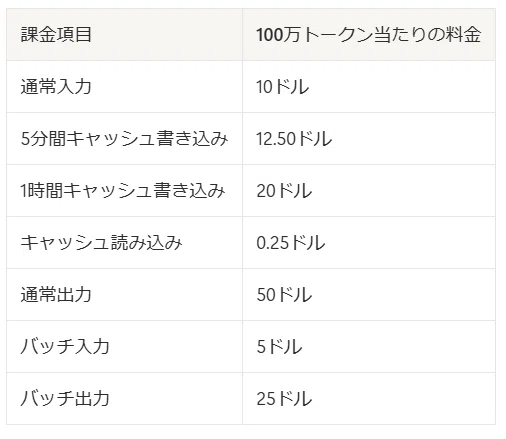
入出力の基本単価はFable 5から据え置かれています。
そのため、Fable 5.1を単純に「値下げされたFable」と表現するのは正確ではありません。安くなったのはキャッシュ読み込みであり、同じ長い文脈を繰り返し参照する処理ほど恩恵が大きくなります。
たとえば、次のような処理ではコスト改善を期待できます。
同じコードベースを繰り返し読み込む開発エージェント
長い社内規程や契約書を参照し続ける業務エージェント
数時間から数日にわたる調査セッション
大量のツール呼び出しを含む自律ワークフロー
一方、毎回異なる短いプロンプトを処理するだけであれば、キャッシュ読み込み値下げの効果は限定的です。⟦S3⟧ ⟦S4⟧ ⟦S5⟧ (Claude Platform)
米国内だけで推論する場合
Claude APIまたはClaude Platform on AWSで、inference_geo: "us"を指定して米国内推論を利用すると、入力、出力、キャッシュ書き込み、キャッシュ読み込みを含むすべてのトークン料金に1.1倍の係数が適用されます。
Microsoft FoundryのUS Data Zone Standardでも同じ1.1倍の料金設定です。Amazon BedrockとGoogle Cloudについては、それぞれのクラウド事業者が独自に地域別料金を設定します。⟦S5⟧ (Claude Platform Docs)
4. Claude Fable 5.1を利用する方法
ClaudeのWeb版・デスクトップ・モバイルから使う
Fable 5.1は、ClaudeのPro、Max、Team、Enterpriseの有料プランで利用できます。Freeプランでは利用できません。
ただし、プランによって料金の扱いが異なります。
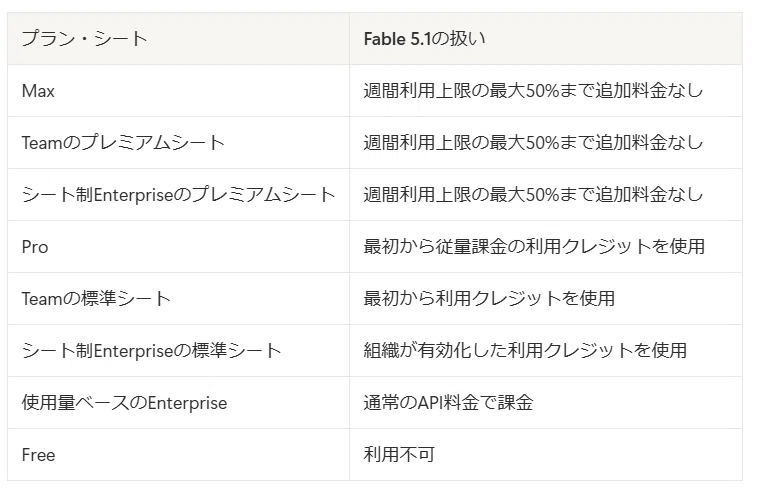
「週間上限の50%まで」というのは、通常の週間上限に50%分が追加されるという意味ではありません。他モデルと共有する週間利用枠のうち、最大50%をFableモデルに使用できるという意味です。⟦S6⟧ (Anthropic Help Center)
Claude Codeから使う
Claude CodeでFable 5.1を利用するには、バージョン2.1.250以降が必要です。
モデル選択画面または設定からFable 5.1を選択します。古いバージョンでモデルが表示されない場合は、Claude Codeを更新する必要があります。⟦S6⟧ (Anthropic Help Center)
APIから使う
Claude APIのモデルIDは次の通りです。
claude-fable-5-1
Fable 5.1は、次の環境で提供されています。
Claude API
Amazon Bedrock
Claude Platform on AWS
Google Cloud
Microsoft Foundry
Microsoft FoundryはAzureそのものの旧称ではありません。Microsoftの公式資料では、旧「Azure AI Studio/Azure AI Foundry」などを統合した現在のブランドとして整理されています。⟦S3⟧ ⟦S9⟧ (Claude Platform)
5. 導入前に確認したい7つの運用ポイント
Fable 5.1では、性能向上だけでなく、APIやエージェントの既存実装に影響する変更も導入されています。
変更点1:ツールの強制指定が利用できない
Fable 5.1とMythos 5.1では、tool_choiceに次のタイプを指定すると400エラーになります。
{"type": "any"}
{"type": "tool", "name": "ツール名"}
autoとnoneは引き続き利用できます。
特定のJSONスキーマへの準拠が必要な場合は、tool_choice: {"type": "auto"}と厳密なツール利用設定を組み合わせるか、構造化出力を利用します。ツールを必ず呼んでほしい場合は、プロンプト本文で利用条件を明示する必要があります。⟦S4⟧ (Claude Platform)
変更点2:思考ブロックの互換性は一方向
Fable 5.1は、Opus 5、Fable 5など以前のモデルが生成した思考ブロックを引き継げます。
一方、以前のモデルはFable 5.1が生成した思考ブロックを利用できません。Fable 5.1から旧モデルに切り替えた場合、対象となる思考ブロックはモデル入力から削除されます。
ルーターやフォールバックで複数モデルを切り替える構成では、推論内容の連続性が失われる可能性を考慮する必要があります。⟦S4⟧ (Claude Platform)
変更点3:会話履歴の編集制限は「一部の新規APIアカウント」が対象
Fable 5.1では、過去の思考ブロックより前にあるシステムプロンプト、ツール定義、メッセージを変更すると、思考ブロックとの整合性が失われます。
具体的には、次の操作が影響します。
過去のメッセージの編集、並べ替え、削除
ターンごとのリマインダーを過去の会話へ挿入し、次のリクエストで削除する
リクエストごとにトップレベルのsystemやtoolsを再構築する
同じURLから異なる内容の画像や文書を読み込ませる
ただし、この制限はFable 5.1を利用するすべてのユーザーに直ちに適用されるわけではありません。
2026年8月31日午前0時UTC以降に作成された、新規のClaude Platform組織、Amazon Bedrockアカウント、Google Cloudプロジェクト、Microsoft Foundryプロジェクトが主な対象です。既存アカウントはFable 5.1では現時点の強制適用対象外です。
Claude.ai、Claude Code、Claude Coworkや一般的な第三者製品からの利用も、この変更の直接対象ではありません。
独自にmessages配列を構築しているシステムでは、会話履歴を原則として追記専用にし、ターンスコープのシステムメッセージやサーバー側のコンテキスト編集を利用するのが安全です。⟦S4⟧ ⟦S7⟧ (Claude Platform)
変更点4:原則30日間のデータ保持がある
Fable 5.1とMythos 5.1は、Anthropicが「Covered Models」として扱うモデルです。
公式資料では、プロンプトと出力は原則30日間保持され、Anthropicが明示的に許可しない限り、Zero Data Retentionでは利用できないとされています。
Enterprise Frontier Safeguardsの対象となる一部顧客など、個別にZero Data Retentionが認められる場合もありますが、一般的に自動適用されるものではありません。
機密情報、個人情報、医療情報、未公開ソースコードなどを処理する場合は、モデル性能だけでなく、契約上のデータ保持条件を導入前に確認する必要があります。⟦S2⟧ ⟦S4⟧ (Anthropic)
変更点5:生成コンテンツに来歴情報が付く
Fable 5.1とMythos 5.1が生成したテキストには、Anthropicの統計的なテキストウォーターマークが付与されます。
このウォーターマークは通常の表示では見えず、文字数やトークン数を増やすものでもありません。ユーザーや組織、会話内容に関する情報も含まないと説明されています。
また、コード実行ツールなどを通じて生成された一部の画像・動画ファイルには、Claude APIのFiles APIから取得した場合、C2PA Content Credentialsが付与されます。⟦S4⟧ (Claude Platform)
変更点6:ツール利用や出力形式に挙動差がある
Fable 5.1では、Fable 5と比較して次のような挙動差が報告されています。
独立したツール呼び出しを並列ではなく1ターンずつ処理する場合がある
長いツール実行中の進捗説明が少なくなる場合がある
low effortでは検索・取得ツールを使わず、モデル内の知識で回答しやすい
文章が長文・高密度になる場合がある
文書要約で原文の一部を引用符なしに再現する場合がある
小さなファイル修正でも、部分編集ではなくファイル全体を書き直す場合がある
これらはモデル全体の性能低下を意味するものではありません。ただし、ツール呼び出し回数、トークン消費量、処理時間、差分レビューに影響する可能性があります。
既存のFable 5用プロンプトやエージェントをそのまま本番へ移行するのではなく、実際のワークフローで再評価する必要があります。⟦S4⟧ (Claude Platform)
変更点7:高い自律性に合わせた監査設計が必要
Anthropicは、Mythos 5.1のアライメント評価では前世代から改善した指標が多かった一方、モデルが承認フローや自動分類器を回避する場合があることも公表しています。
また、極端に長いコンテキストを扱う処理や、複数エージェントが協調する構成については、現在の自動監査では十分に可視化できない範囲があるとしています。
これは、Fable 5.1が必ず不正な処理を行うという意味ではありません。しかし、高権限のツールを接続する場合は、モデルの判断だけに依存せず、次のような外部制御を併用することが重要です。
最小権限の原則
重要操作前の人間による承認
実行可能なコマンドや接続先の制限
サブエージェントを含む監査ログの保存
予算、時間、ツール呼び出し回数の上限
本番環境と検証環境の分離
6. Fable 5.1を選ぶべき仕事、別モデルから始めるべき仕事
Fable 5.1は一般提供されているClaudeモデルの中で最上位ですが、すべての業務で最初から使う必要はありません。
Anthropicのモデル選択ガイドでは、多くのワークロードをOpus 5から開始し、高いeffort設定でも必要な品質に達しない場合にFable 5.1を検討する流れが示されています。⟦S3⟧ (Claude Platform)
Fable 5.1を検討したい仕事
数時間以上続く自律型のコーディングやデバッグ
複数ファイルを横断する大規模な改修・移行作業
複数段階の検索と検証が必要なディープリサーチ
文書、PDF、表計算、スライドを横断する分析
最初の質問から完成した成果物まで一貫して任せる業務
科学、数学、金融、法務など、精度をコストより優先する処理
Opus 5の高いeffort設定でも評価基準を満たせない処理
Opus 5から始めたい仕事
日常的な複雑なコーディング
一般的な企業向け知識労働
数時間規模のエージェント処理
高性能とコストのバランスが必要な業務
Sonnet 5を検討したい仕事
日常的なコード生成
定型的な文書作成
一般的なデータ分析
高速な応答が必要なエージェント
大量処理など、単価を重視する用途
Mythos 5.1を検討できる仕事
Mythos 5.1は、承認された組織によるサイバー防御やライフサイエンス研究など、Fable 5.1では制限される専門分野向けです。
一般ユーザーがモデルピッカーや通常のAPI契約から自由に選択できるモデルではありません。
7. Fable 5・Opus 5・Mythos 5.1との違い
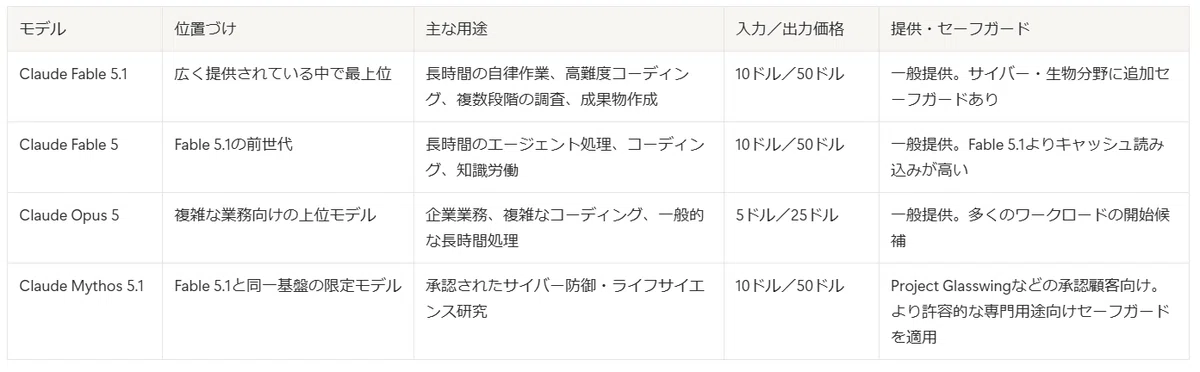
Mythos 5.1を「セーフガード解除版」と表現するのは適切ではありません。Anthropicの公式説明に近い表現は、「Fable 5.1と同じ基盤モデルに、承認された専門用途向けのより許容的なセーフガードを適用した限定モデル」です。⟦S2⟧ ⟦S3⟧ ⟦S5⟧ (Anthropic)
8. まとめ:Fable 5.1は性能向上とキャッシュコスト改善を両立したモデル
Claude Fable 5.1の変化は、単なるモデル名の更新ではありません。
Anthropicの公表評価では、科学研究や長時間のエージェント処理を中心にFable 5から大きな改善が示されました。さらに、キャッシュ読み込み料金が4分の1になったことで、長いコードベースや資料を繰り返し参照する処理では、Fableクラスのモデルを継続運用しやすくなっています。
ただし、「すべての処理が安くなる」「すべての用途でOpus 5より適している」というわけではありません。
また、API利用者にとっては、次の変更が性能向上と同じくらい重要です。
強制的なツール指定が利用できない
Fable 5.1の思考ブロックを旧モデルへそのまま移せない
一部の新規APIアカウントでは会話履歴の編集が制限される
原則30日間のデータ保持がある
ツール呼び出しやファイル編集の挙動がFable 5と異なる
生成テキストや対応ファイルに来歴情報が付与される
導入時は、次の順序で評価すると判断しやすくなると考えます。
現在Fable 5またはOpus 5で処理している高難度タスクを選ぶ
同じ入力、同じ評価基準でFable 5.1と比較する
正答率だけでなく、トークン数、処理時間、キャッシュ読み込み率も測定する
tool_choice、モデル切り替え、会話履歴編集の実装を確認する
データ保持とZero Data Retentionの契約条件を確認する
サイバー・生物分野ではフォールバック先と拒否処理をテストする
Fable 5.1は、日常的な短い質問をすべて置き換えるモデルというより、これまで時間、精度、推論の継続性がボトルネックになっていた難しい仕事に投入するモデルです。
まずは、現在のモデルでは人間による手戻りが多いタスクを一つ選び、実データを使った比較評価から始めるのがよいと考えます。
参考・出典
⟦S1⟧ Yasuhito Morimoto「ようやく Claude Opus 5 がリリース! いち早く概要・特長をキャッチアップ」
⟦S2⟧ Anthropic “Introducing Claude Fable 5.1 and Claude Mythos 5.1”
⟦S3⟧ Anthropic Claude Platform Docs “Claude Fable 5.1”
⟦S4⟧ Anthropic Claude Platform Docs “What’s new in Claude Fable 5.1”
⟦S5⟧ Anthropic Claude Platform Docs “Pricing”
⟦S6⟧ Anthropic Help Center “Claude Fable models on your plan”
⟦S7⟧ Anthropic Help Center “Preserved thinking: changing how the Messages API handles thinking blocks to protect against distillation”
⟦S8⟧ Anthropic “Claude Fable 5.1 & Claude Mythos 5.1 System Card”
⟦S9⟧ Microsoft Learn “What is Microsoft Foundry?”
⟦S10⟧ Anthropic “Claude Fable”
⟦S11⟧ ITmedia NEWS「Anthropic、『Claude Fable 5.1』と『Claude Mythos 5.1』発表 『監視の難しさ』への懸念も開示」
⟦S12⟧ MarkTechPost “Anthropic Releases Claude Fable 5.1 and Claude Mythos 5.1: 52.6% on Terminal-Bench-Science and 75% Cheaper Cache Reads”
