デイリーAI検索備忘録(2026/6/5号)

更新日: 2026/6/5
エグゼクティブサマリー
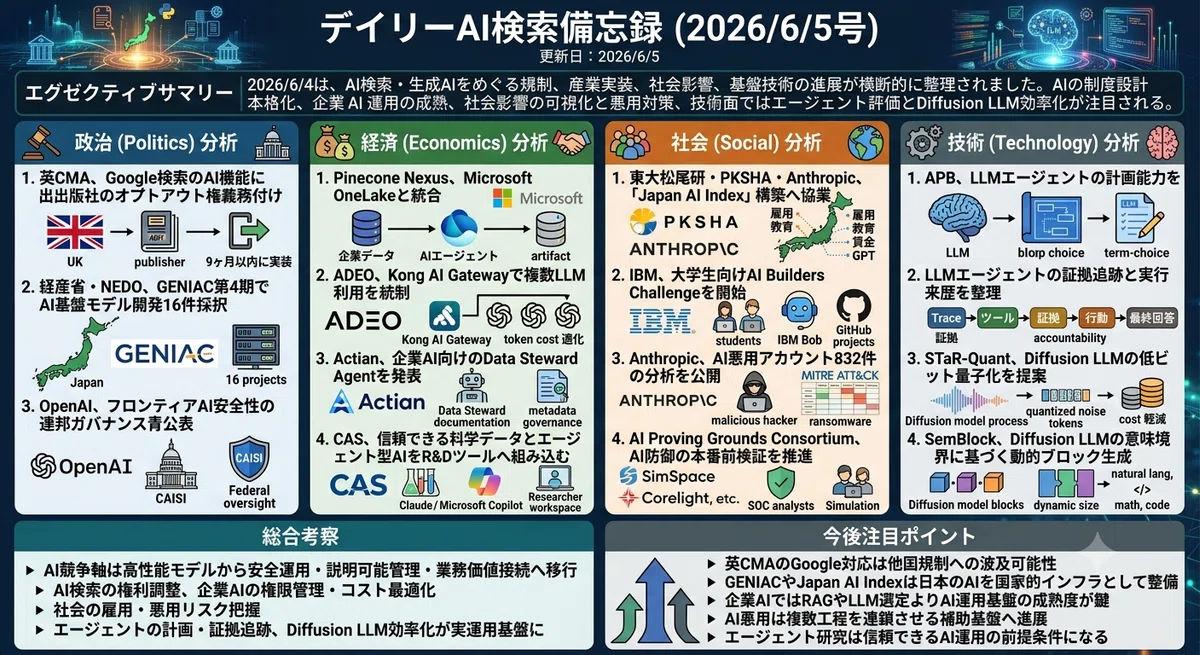
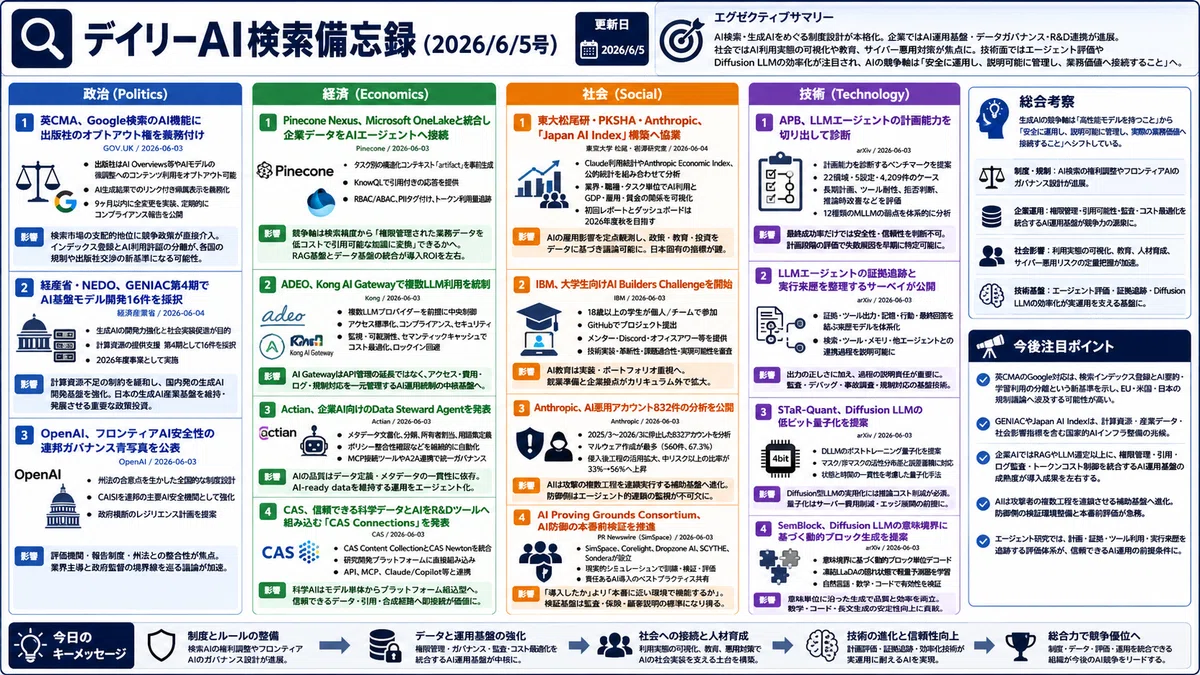
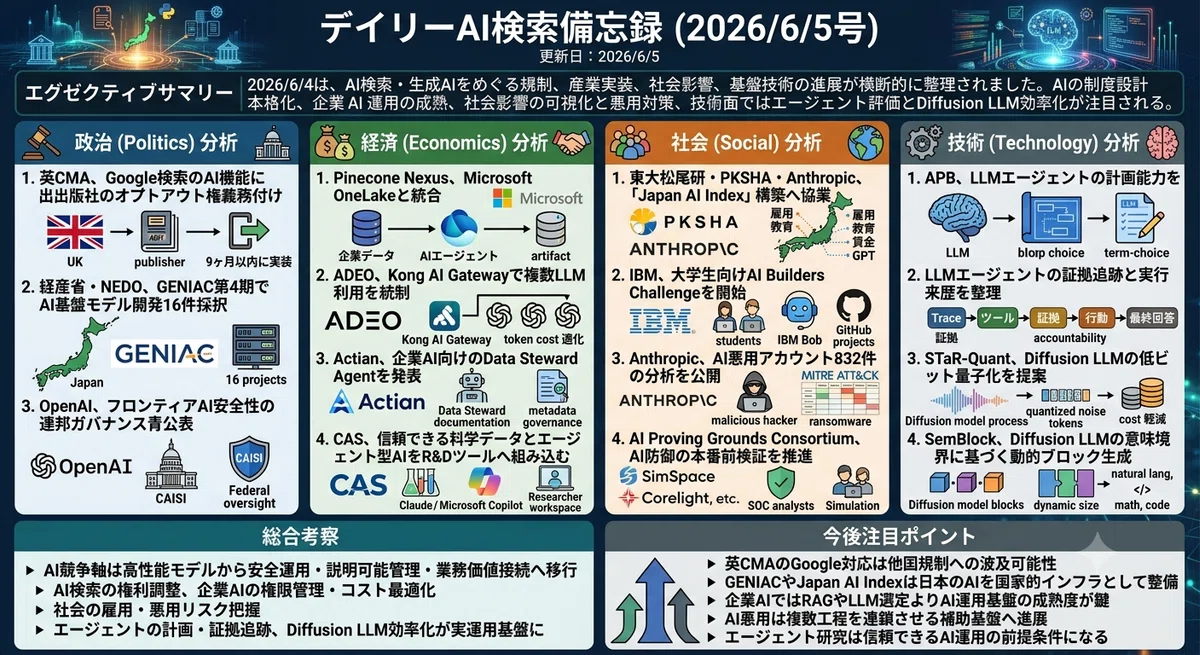
2026/6/4は、AI検索・生成AIをめぐる規制、産業実装、社会影響、基盤技術の進展が横断的に整理されていました。英国CMAによるGoogle検索AI機能へのオプトアウト義務化、経産省・NEDOのGENIAC第4期、OpenAIのフロンティアAI統治提案は、AIの制度設計が本格化していることを示す。一方、企業領域ではAIエージェント活用を支えるデータ基盤、AI Gateway、データガバナンス、R&D連携が進展。社会面ではAI利用実態の可視化、教育、サイバー悪用対策が焦点となり、技術面ではエージェント評価やDiffusion LLMの効率化が注目される。
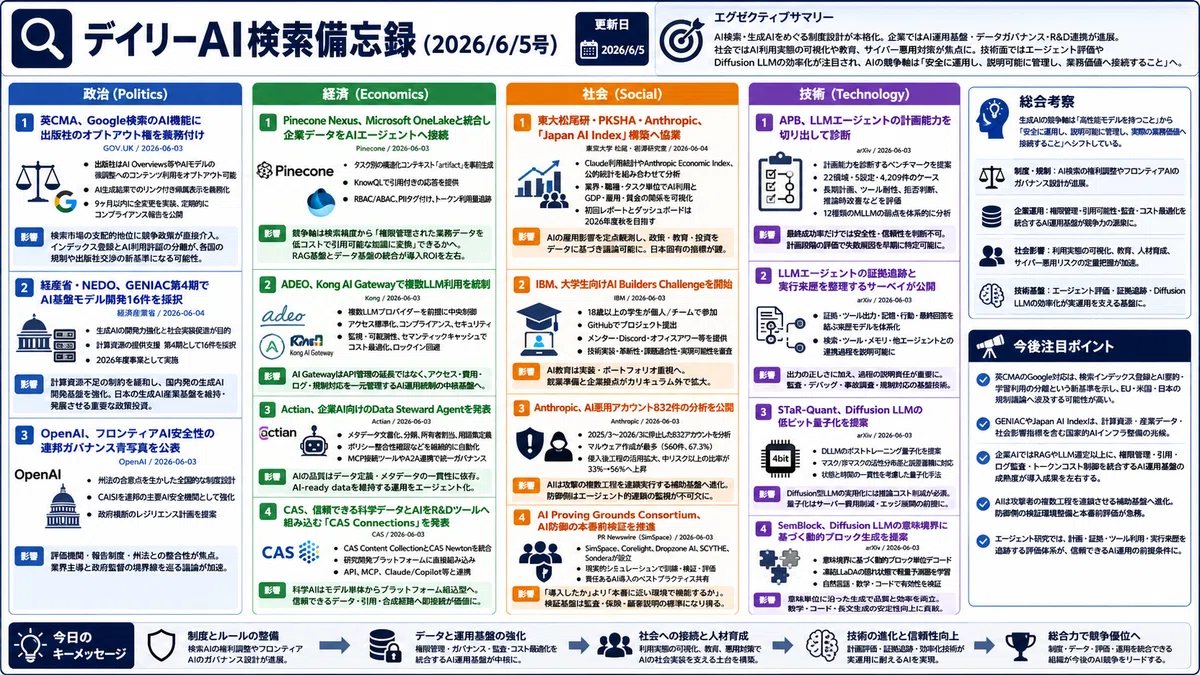
※作成した記事内容をGammaに入力しスライド自動作成させました。スライドの方が見やすいようでしたらこちらをご覧くださいませ。
政治(Politics)分析
1. 英CMA、Google検索のAI機能に出版社のオプトアウト権を義務付け
引用元: GOV.UK / 2026-06-03
要点: 英国競争・市場庁(CMA)は2026年6月3日、Google検索に対する新たな行動要件を導入した。世界初の取り組みとして、出版社はAI Overviewsなどの検索AI機能やAIモデルの微調整に自社コンテンツが使用されることをオプトアウトできるようになる。またGoogleは、AI生成検索結果において出版社コンテンツに明確なリンク付きの帰属表示を行うことも義務付けられた。Googleは9ヶ月以内に全変更を実装し、最初の1年間は6ヶ月ごとにコンプライアンス報告書を提出・公開する必要がある。検索市場における支配的地位を背景に、AI要約とコンテンツ提供者の交渉力を制度的に調整する動きである。
影響: AI検索による流入減やコンテンツ利用をめぐる対立に、競争政策が直接介入し始めた。今後は、検索インデックスへの登録とAI利用許諾を分離する考え方が、他国の規制や出版社交渉の基準になる可能性がある。
2. 経産省・NEDO、GENIAC第4期でAI基盤モデル開発16件を採択
引用元: 経済産業省 / 2026-06-04
要点: 経済産業省とNEDOは、生成AIの開発力強化と社会実装促進を目的とする「GENIAC」において、AI基盤モデル開発に必要な計算資源の提供支援第4期として16件の開発テーマを採択した。GENIACは2024年2月から始まった取り組みで、基盤モデル開発に不可欠な計算資源の利用料などを補助し、国内で生成AI開発力を育成する狙いを持つ。第4期は2026年度事業として実施される。
影響: 国産・国内発の生成AI開発を進めるうえで、計算資源不足は大きな制約である。今回の採択は、個別企業や研究機関の開発支援にとどまらず、日本の生成AI産業基盤を維持する政策投資として重要になる。
3. OpenAI、フロンティアAI安全性の連邦ガバナンス青写真を公表
引用元: OpenAI / 2026-06-03
要点: OpenAIは、米国で高性能AIシステムを統治するための連邦レベルの枠組みとして「A blueprint for democratic governance of frontier AI」を公表した。内容は、州レベルで進むフロンティアAI安全法案の合意点を生かした全国的な制度設計、CAISIを米連邦政府の主要なAI安全機関として強化すること、国家安全保障・公共安全上の課題に備える政府横断のレジリエンス計画を柱にしている。企業側から制度設計に関与する提案である。
影響: フロンティアAI規制は、禁止や許認可だけでなく、評価機関、報告制度、州法との整合性をどう設計するかが焦点になっている。OpenAIの提案は、業界主導と政府監督の境界線をめぐる議論を強める。
経済(Economics)分析
1. Pinecone Nexus、Microsoft OneLakeと統合し企業データをAIエージェントへ接続
要点: Pineconeは、Pinecone NexusとMicrosoft OneLakeの統合を発表した。企業AIエージェントが毎回生データを検索・結合してLLMに渡すのではなく、Nexusが事前にタスク別の構造化コンテキスト「artifact」を作成し、KnowQLを通じて引用付きの応答を返す。Microsoft Fabric上の文書、表、Power BIセマンティックモデルなどに接続し、RBACやABACに基づく権限管理、PIIタグ付け、トークン利用量の追跡も提供する。
影響: 企業AIエージェントの競争軸は、単なる検索精度から、権限管理された業務データを低コストで引用可能な知識に変換できるかへ移っている。RAG基盤とデータ基盤の統合が、導入ROIを左右する。
2. ADEO、Kong AI Gatewayで複数LLM利用を統制
引用元: Kong / 2026-06-03
要点: Kongは、欧州ホームインプルーブメント大手ADEOが生成AI導入を拡張するため、Kong AI Gatewayを採用したと発表した。ADEOは複数のLLMプロバイダーを使う前提で、AIトラフィックの中央制御面を構築し、標準化されたアクセス、コンプライアンス管理、セキュリティ、監視、可観測性、セマンティックキャッシュによるトークン・コスト最適化を進める。ベンダーロックイン回避も主要な目的とされる。
影響: 生成AIの本番導入では、モデル選定以上に、利用部門ごとのアクセス、費用、ログ、規制対応を一元管理する仕組みが重要になる。AI GatewayはAPI管理の延長ではなく、AI利用統制の中核基盤になりつつある。
3. Actian、企業AI向けのData Steward Agentを発表
引用元: Actian / 2026-06-03
要点: Actianは、Data Intelligence Platformに組み込むAIエージェント「Data Steward Agent」を発表した。メタデータ文書化、データ分類、所有者割り当て、用語集定義、ポリシー整合性の確認など、データスチュワード業務を継続的に自動化する。MCP接続ツールやA2A連携、第三者AIエージェントも、同じガバナンスされたビジネス文脈で動作できるようにする狙いである。
影響: 企業AIの品質は、モデル性能よりもデータ定義やメタデータの一貫性に左右されやすい。Actianの動きは、AI-ready dataを維持する運用そのものをエージェント化する方向性を示している。
4. CAS、信頼できる科学データとエージェント型AIをR&Dツールへ組み込む「CAS Connections」を発表
引用元: CAS / 2026-06-03
要点: CASは、CAS Content Collectionとエージェント型AI「CAS Newton」を研究開発プラットフォームに直接組み込む統合フレームワーク「CAS Connections」を発表した。初期連携先にはAlbert Invent、Sapio Sciences、Inductive Bio、Scilligence、Wolfram Researchが含まれる。API、Model Context Protocol、ClaudeやMicrosoft CopilotなどのAIプラットフォーム連携を通じ、研究者が既存ワークフロー内で検証可能な科学情報を使えるようにする。
影響: 研究開発向け生成AIでは、汎用回答よりも、信頼できるデータ、引用、合成経路、安全性、先行技術情報へ即座に接続できることが価値になる。科学AIは、モデル単体から業務プラットフォーム組み込み型へ進む。
社会(Social)分析
1. 東大松尾研・PKSHA・Anthropic、「Japan AI Index」構築へ協業
要点: 東京大学松尾・岩澤研究室は、PKSHA Technology、Anthropicと協業し、日本における生成AIの社会的インパクトを継続的に観測・分析する「Japan AI Index」の構築を発表した。匿名化・集計されたClaude利用統計やAnthropic Economic Index、日本国内の経済・雇用・教育に関する公的統計を組み合わせ、業界、職種、タスク単位でAI利用の進展やGDP・雇用・賃金との関係を可視化する。初回レポートとダッシュボードは2026年度秋を目指す。
影響: 生成AIの雇用影響は印象論で語られやすいが、定点観測が整えば政策、教育、企業投資をデータに基づいて議論しやすくなる。日本固有の産業構造を反映した指標づくりが鍵になる。
2. IBM、大学生向けAI Builders Challengeを開始
引用元: IBM / 2026-06-03
要点: IBMは、大学生向けの「AI Builders Challenge」を開始し、AI開発パートナー「IBM Bob」の利用対象を世界2万の高等教育機関に広げると発表した。18歳以上の対象学生は個人またはチームで参加し、GitHubを通じてプロジェクトを提出する。Discord、メンター、オフィスアワー、ウェビナーの支援も提供され、技術実装、革新性、課題適合性、実現可能性などを基準に審査される。
影響: AI教育は講義型から、ポートフォリオ作成や実装経験を通じて就業準備につなげる形式へ変わっている。大学と企業の接点が増えるほど、AI人材育成はカリキュラム外の実践機会に依存しやすくなる。
3. Anthropic、AI悪用アカウント832件の分析を公開
要点: Anthropicは、2025年3月から2026年3月にかけて悪質なサイバー活動で停止した832アカウントをMITRE ATT&CKに対応付けて分析した結果を公表した。AI利用はマルウェア作成が最多で560件、67.3%を占めたが、内部ネットワークでの横展開、アカウント探索、権限昇格など、侵入後の高度な工程にも利用が広がっている。中リスク以上に分類される比率も前半33%から後半56%へ上昇した。
影響: AIによって低熟練の攻撃者でも複雑な攻撃工程を組み合わせやすくなっている。防御側は、従来の攻撃手法数だけで脅威度を測るのではなく、AIエージェント的な連鎖実行そのものを監視する必要がある。
4. AI Proving Grounds Consortium、AI防御の本番前検証を推進
要点: SimSpace、Corelight、Dropzone AI、SCYTHE、Sonderaは、AI Proving Grounds Consortiumの設立を発表した。CISO、SOC責任者、AI・イノベーション責任者を対象に、AI駆動の防御システムや人間チームを本番に近い環境で訓練、検証、評価し、実運用前に信頼性を確認することを目的とする。コンソーシアムは、現実的なシミュレーション、エージェント型ワークフロー検証、運用準備性、責任あるAI導入のベストプラクティス共有を掲げる。
影響: 企業のAIセキュリティ導入では、「導入したか」より「本番に近い圧力下で機能するか」が問われる。AI防御を演習・評価する共通基盤は、監査や保険、顧客説明にも関わる標準になり得る。
技術(Technology)分析
1. APB、LLMエージェントの計画能力を切り出して診断
引用元: arXiv / 2026-06-03
要点: 「Agent Planning Benchmark」は、LLMエージェントの計画能力を診断するためのベンチマークを提案した研究である。既存評価は最終的な成功率に偏り、失敗が計画段階にあるのか実行段階にあるのかを分けにくい。APBは22領域・5設定・4,209件のマルチモーダルケースを含み、長期計画、ツールノイズ耐性、実行不能タスクの拒否、推論時の改善能力などを測る。12種類のMLLMで系統的な弱点も示した。
影響: エージェントの実用化では、最終回答の正誤だけでは安全性や信頼性を判断できない。計画段階を独立評価できれば、ツール選択ミス、拒否失敗、長期タスク崩壊を早期に発見しやすくなる。
2. LLMエージェントの証拠追跡と実行来歴を整理するサーベイが公開
引用元: arXiv / 2026-06-03
要点: 「From Agent Traces to Trust」は、LLMエージェントの証拠追跡と実行来歴を体系化するサーベイ研究である。外部ツール、検索、メモリ、環境、他エージェントと連携するLLMエージェントでは、最終回答だけでは、どの証拠が主張を支えたか、ツール呼び出しが妥当だったか、メモリが後続判断へどう影響したかを説明できない。論文は、証拠、ツール出力、記憶、行動、最終回答を結ぶ来歴モデルを整理している。
影響: エージェントの監査では、出力の正しさだけでなく、過程の説明責任が重要になる。証拠追跡と実行来歴は、デバッグ、事故調査、規制対応、企業内監査の基盤技術になりやすい。
3. STaR-Quant、Diffusion LLMの低ビット量子化を提案
引用元: arXiv / 2026-06-03
要点: 「STaR-Quant」は、Diffusion Large Language Models(DLLMs)のポストトレーニング量子化を扱う研究である。DLLMはマスク付きノイズ除去を反復してテキストを生成するため、並列性の利点がある一方、モデルサイズと反復処理により計算・メモリ負荷が高い。研究は、マスク済み・非マスクトークンの活性分布差と、反復デコード中の量子化誤差蓄積を課題として整理し、状態と時間の一貫性を考慮した量子化手法を示した。
影響: Diffusion型言語モデルが実用化に向かうには、生成品質だけでなく、推論コストとメモリ効率の改善が欠かせない。量子化技術は、サーバー費用削減やエッジ展開の前提条件になる。
4. SemBlock、Diffusion LLMの意味境界に基づく動的ブロック生成を提案
引用元: arXiv / 2026-06-03
要点: 「SemBlock」は、Diffusion LLMのブロック単位デコードを、固定長ではなく意味境界に基づいて動的に構成する手法を提案した研究である。既存のブロック型手法は固定サイズや区切り記号に依存し、文意や推論ステップ、コード実装範囲と一致しない場合がある。SemBlockは、凍結したLLaDAの隠れ状態上で軽量予測器を訓練し、自然言語、数学、コードタスクの意味境界データセットを用いて動的なブロック終了位置を選ぶ。
影響: Diffusion LLMの改善は、モデル規模拡大だけでなく、デコード単位の設計にも広がっている。意味単位に沿った生成が安定すれば、数学・コード・長文生成での品質と効率の両立につながる。
総合考察
2026/6/4のトピックから見える特長は、生成AIの競争軸は「高性能モデルを持つこと」から、「安全に運用し、説明可能に管理し、実際の業務価値へ接続すること」へ移行している点でした。AI検索では出版社との権利調整、企業AIでは権限管理・監査・コスト最適化、社会面では雇用影響や悪用リスクの定量把握が重要になっている。さらに、エージェントの計画能力や証拠追跡、Diffusion LLMの推論効率といった研究は、AIを実運用に耐える基盤へ押し上げる流れを示す。今後はモデル単体の優劣よりも、制度、データ、評価、運用を統合できる組織が優位に立つ。
今後注目ポイント
英CMAのGoogle対応は、検索インデックス登録とAI要約・学習利用の分離という新しい基準を示しており、EU・米国・日本の規制議論へ波及する可能性が高い。
GENIACやJapan AI Indexは、日本がAIを単なる導入支援ではなく、計算資源・産業データ・社会影響指標を含む国家的インフラとして整備し始めた兆候といえる。
企業AIでは、RAGやLLM選定そのものよりも、権限管理、引用可能性、ログ監査、トークンコスト制御を統合するAI運用基盤の成熟度が導入成果を左右する。
Anthropicの悪用分析が示すように、AIは攻撃者の作業を単発支援する段階から、侵入後の複数工程を連鎖させる補助基盤へ進んでおり、防御側の検証環境整備が急務となる。
エージェント研究では、最終回答の正誤だけでなく、計画、証拠、ツール利用、実行来歴を追跡する評価体系が、信頼できるAI運用の前提条件になっていく。