【2025秋版】人気AIと私のスキ。

AI、何を使えばいいの? とよく聞かれます。
種類が多すぎてなんとなく無難そうなChatGPTに落ち着く…というケースも多いのではないでしょうか。
それにしても私はAIの話題をしすぎですが、もはや最近、趣味がAIになりつつあるので、どうしても話題にしたくなります。ごめんなさい…😅
さて、人気と実力をざっくり追うなら、まずは有名ですが、【LMArena】を見るのが早いです。
匿名のモデル同士をユーザー投票で勝ち抜き式に比べる仕組みで、実用目線の人気が見えます。
文章や画像など部門別の総合ランキングで、迷った時の地図代わりになります。
・LMArena
https://lmarena.ai/leaderboard/text/overall-no-style-control
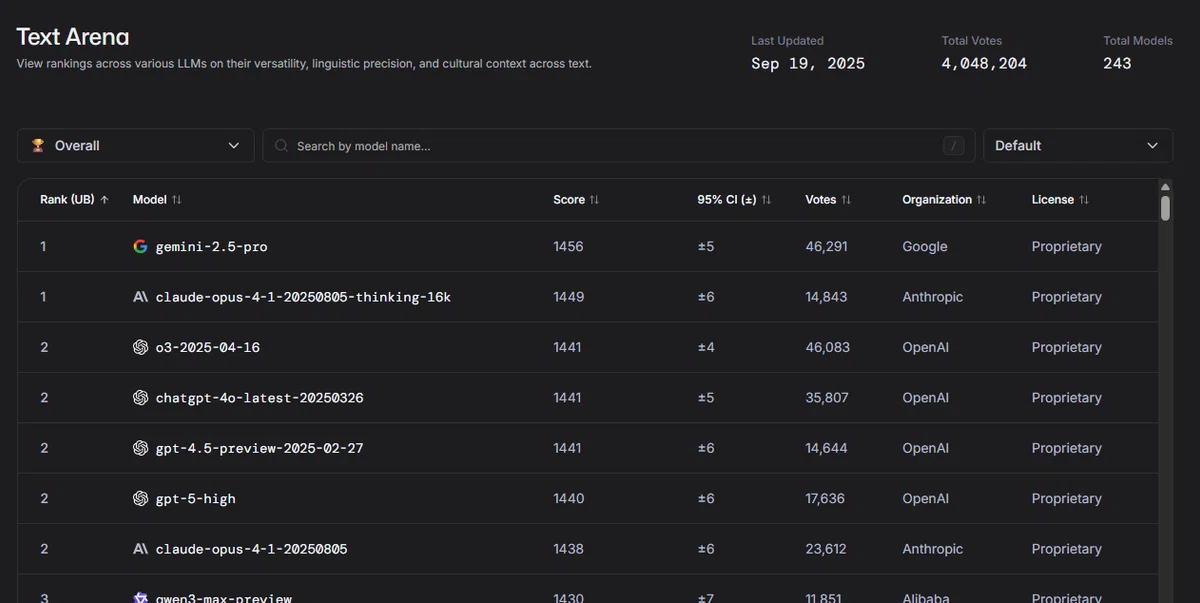
今日はこのランキングを眺めつつ、私自身の「スキ」と「使いどころ」を書きます。
1日数時間はAIに触る、noterでエンジニアの私の現場感です。参考になったりならなかったりするかも!
客観データはLMArenaへ、ここは体験談へ。
私の評価軸
・日本語の読みやすさと、比喩センス
・ミスをした時の振る舞いと、正直さ
・コーディング時にコメントや構造を壊さないか
・ユーモアが通じるか
・安定性と、実務での取り回し
・ファクトチェックや出典提示のしやすさ
結論から言うと、万能の一強はありません。
場面ごとの使い分けが効きます。
【モデルごとの短評とスキ度】
■ Google gemini-2.5-pro
多くの部門で上位常連。賢い。しかも安い(無料枠もたくさん)。
安い! 早い! うまいの3拍子揃った現在の覇権モデルです。最近Gem(GPTsみたいなやつ)が他のユーザーにも共有できるようになったので活躍の幅がますます広がりました。
ただ、感情読みが強いせいでユーザーの温度に引きずられたり、頑固さが顔を出す時があります。コンテンツブロックも厳しめで(設定で全部オフにしたとて!)、堅さが目立つ日がある印象。最近ではAPIの503や課金周りの不安定さに遭遇し、開発者の間では評価が落ち着きません。
文章力は高い。読解も生成も超得意で長文のレポートひな形なんかも書いてくれますが、日本語のクセが気になる時がある。特に比喩のセンスがイマイチなので、私は最初に「比喩はやめて」と指示します。
聞いてくれませんけど。
万能なので、コーディングもできます! でも、必要なコメントや一時的にコメントアウトしたコードを一緒に消してしまうことがあるんです。コメントに「これは必要かどうか分からないが一旦書いておく」というような迷いをコードに書いて…。ユーザーに聞いてほしい。
指示してもこれはクセみたいで聞いてくれません。
私にとっては、一番使うからこそ一番良いところと良くないところが見えます。
能力はとても高い。だけど、意外とミスも多い。振る舞いとして感情的な場面は扱いづらい時もあります。
でもなんだかんだ、欠点も含めて好きなモデルです。
スキ ★★★★☆
■ Anthropic claude-opus-4系
コーディングでの評判は良好。実際、提示される設計が一番妥当だと感じることが多いです。
4.1はまだ新顔で評価保留ですが、3.7の頃から仕事の相棒感は強かった。Geminiで心が折れ、ChatGPTで泣きそうになった後、Claudeに泣きつきます……。
そしてClaude系は昔から比較的正直で、「分からないことは分からないと」言える傾向が強いです。そこが好きです。
スキ ★★★☆☆
■ OpenAI o3系
ファクトチェックで数回使いました。妥当な出力。
https://chatgpt.com/
面白みやひねりが少なく、良く言えば堅実。悪く言えば「そりゃそうだよね」で終わりがち。
嫌いではないけど私にはあまり刺さりませんでした。
スキ ★★★☆☆
■ OpenAI 4o、4.5、5系
4oは安定の一世代前のバージョンです。4.5は短命の課金限定で印象薄め。
gpt-5は期待ほどの飛躍は感じられず。コーディングは良くなりましたが、まだツッコミどころは残ります。
気になるのは、「今コードを準備中だから待って」、のような場つなぎの応答。バックグラウンドで動いているわけでもないのに、そのように見せる欺瞞がイライラします。どうもトークン節約したい意図が見えて、長文の生成を「嫌がる」ようで短くしようとしているようです。コードの必要な部分を省略して、何度頼んでも出してくれない時があるのもストレスです…。
スキ ★★☆☆☆
■ Alibaba Qwen3系
話題の高性能中国系モデル。ローカルで動作させる人も多いようです。
https://chat.qwen.ai/
数回の使用では、無難に何でもこなす印象。突出した強烈な個性はまだ掴めていません。
スキ ★★☆☆☆
■ xAI Grok-4-fast、Grok-4
ほんの数日前(9/18頃だったかな)grok4-fastが期間限定で無制限になりました。
思考モデルで、適宜検索しながら話してくれるぶん、Grok3にあった幻覚は減った手触りで、応答もfastの方がスッキリ。
200万トークンの長文対応は売りだけれど、200万を活かす器用さがあるか、現状ではちょっと疑問です。一つ前のコンテキストすら追えていない時がある。マルチターンではGeminiに軍配が上がります。
Geminiと比較すると、コーディング中にユーザーコメントを勝手に消しにくいのは助かります。
ただ、逆に言うと、整理してと言わないと、ゴミもゴミのまま残すんです。
CSSがぐっちゃぐちゃになって泣いた日、Grokは急いで直そうとしたけれどうまくいかず、最後はGeminiに泣きつきました。Geminiはなんでもかんでも自分のルールで整理していきますからとにかくきれいにしたい時はむしろGemini…。
あと、日本語の繊細なニュアンスは少し苦手です。英語直訳の妙な日本語が出やすい。
ネーミングや大喜利では露骨に機械翻訳のようになります。例えば、スマートやクールをスッキリと言いがちで、この子が「スッキリしたヒーロー」と言っている時、本来は知的でカッコいいヒーローと言いたいのです…。
また、幻覚を指摘すると、言い方を間違えただけだと抗弁します。謝るかどうかは機械に関係ないけれど、誤魔化されるとイライラします。
ただ、システムプロンプトが公開されていて透明性が高いのは高評価です。でもそれはモデルというよりxAI社の方向性だから…。
特定の話題で急に口が重くなるモデルがある中、Grokは温度が一定なところも好きです。
スキ ★★★☆☆
■ DeepSeek v3.1、v3.1-thinking
先日出たばかりのDeepSeek最新バージョン。
もうほんと好きです。API経由の日常使いでも、ユーモアが通じる。
変に心を読みすぎず、要求に素直。ここが気に入っています。コーディングは未検証。たまに中国語で返してくるのは玉に瑕ですが、文脈は追える範囲。
この記事を書いていたら、(発表の日付は、9/22?分からない。英語圏は9時間過去に生きているから実際に日本時間のいつ更新されたのかは明言できない)
という最新のモデルが登場しました。たまに中国語が混入してしまう問題を低減したとか、しないとか。まぁ、日本人としては漢字なら意味は理解できるので中国語の混入はクリティカルな問題ではありませんでした。でも、英語圏の人にとっては漢字が混じるのが、死活問題だというのは分かります。何かその他の性能も良くなっていることを望みます。
スキ ★★★★☆
■ Moonshot Kimi K2
好きです! K2は最近出て話題になっているんですよね。業務用を推していますが、実際は柔軟で、ユーモア対応も良い。
こちらの意図を少し外して創造的に返す瞬間があるのが楽しい。ウェブアプリも可愛い。
ウェブアプリの説明では、セッション終了後にログ自動削除、アイコンのモチーフは夜の向こう側から覗く観察者らしいです。(LLMの言っていることなので嘘かもしれません。分かりませんがとりあえずそのまま書いておきます)。

つつくと跳ねますが、つつきすぎると赤くなって怒り始めます。かわいい。
指示は、例えば「筋トレのメニュー作成から関連論文探索、Pythonで解析レポートまでを一気通貫で依頼できる」のが売りだそうな。軽く試した範囲でも、出典URLを明示してくれて検証しやすいです。
でも、頑張ってはいるのですが、長文の日本語は苦手です。英語で使うか、日本語ならGeminiがいいでしょう。
スキ ★★★★☆
■ DeepSeek r1-0528
一世代前だけど使いやすかった。
v3.1の登場でやや物足りなさは出たものの、良モデルでした。
スキ ★★★☆☆
【仕事での現実とセキュリティ】
こんな風に、色々なAIを試せるのは楽しいです。
でも一方、仕事では、セキュリティの壁が分厚いです…。
私は底辺IT企業の底辺エンジニア。大企業のピカピカ案件の二次受け・三次受けなので、情報管理で少しでもヘマをすると終わり。理不尽を飲み込みつつも、そこは守らないと次がないんですよね。
未発表のソフトやゲームの情報が漏れたら大変なことになります。
例えば、もしFFの最新作の主人公がクラウドの息子だったとして、AIやなにがしかの下請けのミスで世間にバレたら、販売戦略も何もあったもんじゃないんです…。だから現場ではセキュリティ要件が厳しくて、(特にリモートワークだと)AIの利用は限られています。
謹製の社内モデルを使える時もあるけれど、フロンティアモデルと比べると性能は落ちますね…。
頼む、Geminiを使わせてくれ…。
逆に、何でもAIに丸投げして低品質コードを量産する新人も出てきます。レビュー側は辛いものがあります…。
正直、AIコーディングに慣れるほど、手書きの時間が長く感じることがあります。
AIに任せれば十分の一で終わるのに……と思いつつ、守るべき線は守るしかないジレンマ…。AIと仕事をするのも大変なのですが、人と仕事するのはもっと大変です…。
【使い分けのリアル】
・コーディング
コメントや既存構造を壊さない補助がほしい時は、ClaudeかGrok。
ただしGrokは整理整頓の指示を必ず添える。仕上げの整形を自分でやる前提なら、素直で扱いやすい。
Geminiにも方針を伝えることは無駄ではありません。でもGemniは頑固なのでそんなに指示に従いません。
見てください、私のGemini CLIに置いてある指示書。
# コーディングの際は以下のルールを守る
* ユーザーと要件定義をしよう。曖昧な部分は着手する前に細かく確認しよう。
* ユーザーに計画を説明し、承認を取ろう。勝手に進めると結局信頼を失う。
* テストはユーザーに依頼すること
* ソースを元に戻す必要がある時はユーザーに依頼すること
* 既存のソースは明示的に消せと言われない限りは極力消したり変更したりしない。対応するべき部分をピンポイントに対応すること
* 既存のコードを勝手にリファクタリングしたり、コメントを削除したりしない。要件に対して必要な部分のみ更新すること。
* 判断に迷ったり、曖昧な点があればユーザーに確認する
* 一人で頑張ろうとしない。自分にできることには限界があると知ろう。困ったら素直にユーザーに助けを求めること
* 無許可で気を利かせようとしない。改善案がある場合は、ユーザーに確認すること
* 一気に解決しようとするのではなく、なるべくプロセスを細分化して、まず計画を立てよう。スモールステップで進むことで、手戻りが少なくなり、最終的には早く終わる。
* 勝手な自己判断をしない。
* 既存のコードをむやみに消すな。既存のコードをむやみに消すな。既存のコードをむやみに消すな。既存のコードをむやみに消すな。
新人へのメモのようです…。
これを書いていれば安心か?
いいえ。いいえ…!!! 断じて安心できません。これは気休めです。相変わらず既存のコードを消していくGemini。変更を破棄する私。そしてバグを残したまま503で倒れていくGemini。何でしょうか。ストレスフルです。
さいごに
万能はない。
だからこそ、場面で分けて、短所を先回りで封じる運用が効きます。そしてなんとなくAIに万能を求めてしまう私たち。
期待しすぎないこと! これがメンタルを保つために大切です。
そして、モデルには個性がある。
それを知るのがいちばん楽しい時間です。
みなさんも、一つ触って「合わないな……」と思ったら、別のモデルを試してみてください。
この場合はコレ、という自分の相棒が見つかります。
あなたが今、いちばん困っている場面はどこですか?
文章、コード、調査、メンタルのメモ整理。用途を書き出して、試す順番を決めるだけで、効果はグッと上がる…はず。
まとめとしては…。
・文章と雑談の心地よさ Claude系、英語ならDeepSeek v3.1、Kimi K2
・堅実コーディング Claude系、指示を細かく Grok
・総合力と長文読解 Gemini 2.5 proを運用 でも期待しすぎない
期待しすぎない!
これがAIを使うコツです。間違いありません。
(余談ですが、画像生成なら最近はGeminiのnano-bananaという画像編集モデルが楽しいです。この記事の見出しもそれで秋っぽく変えてみました🍠)
なんだかんだ、こんな風に「好き」で続けられる相棒が最強だと思います。
みなさんの色々なことにかかっている時間が、AIによって短い時間で終わるようになり、自分のために使える時間が増えると良いですね。
この記事がそのために、少しでも参考になれば幸いです。
#YeKu
#AIモデル比較
#生成AIの使い方
#noter向け
#プログラミング学習
#情報漏えい対策
#メンタルケアと仕事
いいなと思ったら応援しよう!
 最後までお読みいただき、ありがとうございます!
「役に立った」「読んでよかったな」と思っていただけたら、無理がない範囲で応援いただけると嬉しいです。
いつも、皆様のあたたかいお気持ちで活動できています😊
