MAI-Thinking-1とは何者か ── Microsoft初の自前「推論モデル」を読み解く

2026年6月2〜3日のMicrosoft Build 2026で、MAI-Thinking-1 が発表されました。Microsoft AI(MAI)が自社開発した、**初のreasoningモデル(推論特化LLM)**です。
注目すべきは、これがMicrosoftの「自前モデル路線」を象徴する一台だということ。同時に発表された7つのMAIモデル群(コーディング向けのMAI-Code-1、画像のMAI-Image 2.5、音声のMAI-Voice 2、文字起こしのMAI-Transcribe 1.5など)の一角で、OpenAI依存からの「長期的な自立」を狙う動きの中心に位置しています。
ひとことで言えば、**「小さめのサイズで、フロンティア級の推論を、低コストで」**を体現しようとしたモデルです。
基本スペック
アーキテクチャ:35B active / 約1T total パラメータのMoE(Mixture of Experts)。リクエストごとに必要な部分だけを起動するため、能力を上げつつ計算コストの増加を抑えられる
訓練データ:クリーンで商用ライセンス済みのデータのみを使用(AI生成データを除外)。しかも他社モデルからのdistillation(蒸留)なしで、ゼロから訓練
コンテキスト長:256Kトークン(長文ドキュメント対応)※原案の値。公式仕様での最終確認を推奨
狙い:企業向け最適化。低トークンコスト・高効率推論で、日常的に回せるレベルを志向
Microsoftはこれを「中規模モデルながら、そのweight class(同じ規模帯)では最上位クラス」と位置づけています。訓練データを“きれいな商用ライセンス済み”に限定したのは、企業が気にする著作権・コンプライアンス上の不安を取り除く狙いでもあります。
性能:主なベンチマーク
Microsoft公式発表に基づく主なスコアです(2026年6月時点)。
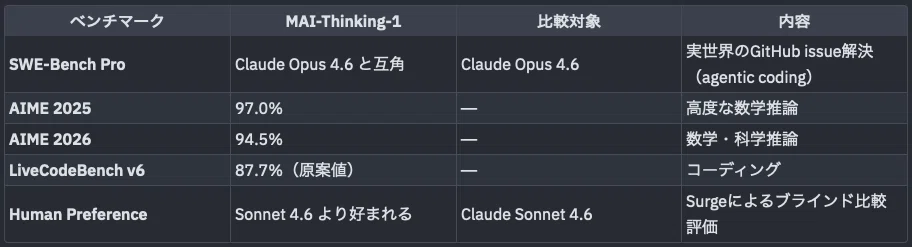
ポイントは2つです。
まず数学・科学推論。AIMEで97.0%/94.5%という数字は、規模帯を考えると相当に高い。次にソフトウェアエンジニアリングで、実世界のGitHub issueを解くSWE-Bench ProでClaude Opus 4.6と互角というのが目を引きます。35B activeというサイズでここに届くのは素直に印象的です。
加えて、人間によるブラインド評価(Surge)でClaude Sonnet 4.6より好まれた点も強調されています。ベンチマークの数字だけでなく「人にとって使い心地が良い」方向に振れている、というわけです。
注:原案にあった「SWE-Bench Pro ~52.8〜53%」「Surge 1,276タスク」などの細かい数値は、公式の互角・優位という主張は確認できたものの、具体値までは独立に確認できませんでした。本稿では断定を避けています。
他のトップモデルとの比較
Claude Sonnet 4.6 / Opus 4.6 ── 人間評価ではMAI-Thinking-1が優位(対Sonnet 4.6)。SWE-Bench ProではOpus 4.6と互角。Microsoftは「Sonnet 4.6より好まれる」と前面に出している
GPT-5.5シリーズ ── 直接比較は限定的だが、Microsoftは**「GPT-5.5比で最大10倍のコスト効率」**を主張(トークン消費が大幅に少ない)。一方、汎用性やagentic領域の総合力ではGPT-5.5が依然として強い可能性が高い
総合的な位置づけ ── 35B activeでフロンティア級のreasoningに届いたのが本質。特にcoding/mathで効率よく競争力を出す。純粋な規模勝負(数百B級〜)の超大型モデルにはまだ及ばない場面もありそうだが、コストパフォーマンスとデプロイのしやすさで差別化している
得意分野
複雑な推論・多段階タスク ── 数学、科学、agentic coding(コードを読む→編集→テスト→修正のループ)
ソフトウェア開発 ── SWE-Bench Proの高さが示す通り、実務レベルのコード生成・デバッグに強い
企業ユース ── 長文脈、function calling、安全性・コンプライアンス重視。低コストで日常運用でき、企業データでのfine-tuneもしやすい(プライベートデータを外部共有せずに済む設計)
人間らしい応答 ── 過度に冗長にならず、役立つバランスが良い。これが人間評価で勝っている理由とみられる
不得意・限界(推測を含む)
独立検証がまだ少ない ── 発表直後のため、現状はMicrosoftの主張が中心。第三者ベンチが揃うのはこれから
汎用クリエイティブ ── reasoning特化ゆえ、長文執筆や創造的ストーリーテリングの“書き味”では、ClaudeやGPTに譲る可能性
マルチモーダル非対応 ── 純粋なテキスト推論モデル。画像・音声は別のMAIモデル(MAI-Image / MAI-Voice など)と組み合わせる前提
実運用での成熟度 ── 訓練手法は新規性が高いとされるが、長期安定性やedge caseでの挙動は今後の検証待ち
一般的なLLMの限界(hallucination、最新情報の不足)は残る。ただし企業データでのfine-tuneで緩和しやすい
まとめ
MAI-Thinking-1は、「効率的なreasoning専門機」として位置づけられます。35B activeでClaude Opus級のcoding/mathを狙えるのは率直にインパクトがあり、特に開発者・企業にとって有力な選択肢になりそうです。
純粋性能ではGPT-5.5やClaude最新版と互角〜やや下という見方が妥当ですが、勝負どころはそこではありません。**コスト・デプロイのしやすさ・データ統制(クリーンな商用ライセンスデータ+蒸留なし)**で明確に差別化しています。「最強」を名乗るより、「企業が安心して回せる賢いエンジン」を狙った設計、と読むのがしっくりきます。
今後、独立評価が増えればより正確な立ち位置が見えてくるはずです。現在はMicrosoft Foundryでprivate preview中、近日public preview予定とされています。最新の数値や提供状況は公式ブログでの確認をおすすめします。
ハッシュタグ案
#MAIThinking1 #MicrosoftAI #LLM #推論モデル #MicrosoftBuild
出典(公式・主要報道)
Microsoft AI「Introducing MAI-Thinking-1」: https://microsoft.ai/news/introducing-mai-thinking-1/
Microsoft AI モデルページ「MAI-Thinking-1」: https://microsoft.ai/models/mai-thinking-1/
Microsoft Community Hub「New MAI models in Microsoft Foundry across text, image, voice, and speech」: https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/new-mai-models-in-microsoft-foundry-across-text-image-voice-and-speech/4524632
Thurrott「Build 2026: Microsoft Launches First Flagship Reasoning AI Model」: https://www.thurrott.com/a-i/336960/build-2026-microsoft-launches-first-flagship-reasoning-ai-model-and-more
GeekWire「Microsoft unveils seven homegrown AI models」: https://www.geekwire.com/2026/microsoft-unveils-seven-homegrown-ai-models-in-bid-for-long-term-self-sufficiency/
Neowin「Microsoft unveils MAI-Thinking-1 reasoning and MAI-Code-1 coding models」: https://www.neowin.net/news/microsoft-unveils-mai-thinking-1-reasoning-and-mai-code-1-coding-models/
いいなと思ったら応援しよう!
 サーバー代とコーヒー代になります☕ 役に立ったら応援よろしくお願いします!
