結論: LangGraph(最新版 1.1.10)は、AIエージェントを「状態機械(State Machine)」として設計するOSSフレームワークです。OpenAI Agents SDKやClaude Agent SDKがシンプルなループ型エージェントに強いのに対し、LangGraphは「承認フロー・ループ・条件分岐・長時間実行」が必要な複雑なマルチエージェントシステムに圧倒的な優位性を持ちます。
この記事の要点:
- LangGraph 1.1.10(2026年4月27日リリース)のStateGraph + Conditional Edges + Checkpointer完全実装
- Human-in-the-loop:interrupt() 関数で人間の承認を挟む実装パターンを本番レベルで解説
- LangGraph vs OpenAI Agents SDK vs Claude Agent SDK vs LlamaIndex Agents の4軸使い分け比較表
対象読者: Python開発者・AIエンジニア・技術選定中のDX推進担当
読了後にできること: 今日中にStateGraphで最初のマルチエージェントワークフローを実装し、LangGraph Studioでビジュアルデバッグできる
「AIエージェントを作ったけど、承認フローを挟もうとしたら全部作り直しになった…」
先日、ある顧問先(従業員500名のSaaS企業)のバックエンドエンジニアからこんな相談を受けました。OpenAI Agents SDKで受発注業務の自動化エージェントを作ったのですが、「金額が10万円を超えたら人間の確認を入れたい」という追加要件が出た時に、既存の実装ではどうにもならなかったというんです。
この経験から気づいたのは、「エージェントの設計思想を最初から選ぶ必要がある」ということです。シンプルなタスク自動化なら軽量SDKで十分ですが、条件分岐・承認フロー・状態の永続化・エラー時の再開が必要な本番ワークフローには、LangGraphのような状態機械型フレームワークが不可欠です。
この記事では、LangGraph 1.1.10の最新機能をコード付きで全解説します。「なぜ状態機械なのか」という設計思想から、本番で使えるCheckpointer・Human-in-the-loop・Streaming実装まで、順を追って解説していきますので、ぜひ技術選定の判断材料にしてください。
まず5分で動かす:LangGraphで最初のStateGraphを作る
AIエージェントの全体像については、AIエージェント導入完全ガイドで体系的にまとめています。まずはLangGraphの具体的なコードから入りましょう。
インストールとセットアップ
# LangGraph 1.1.10(2026年4月27日最新版)
pip install langgraph==1.1.10
pip install langgraph-checkpoint-sqlite    # 開発・テスト用
pip install langgraph-checkpoint-postgres  # 本番用
pip install langchain-anthropic            # Claude使用時
pip install langchain-openai               # OpenAI使用時

# LangGraph Studio(ローカルサーバー起動)
pip install langgraph-cli
langgraph dev  # http://localhost:2024 でStudioが開く
最小構成のStateGraph(5分で動く版)
from typing import TypedDict, Annotated
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_anthropic import ChatAnthropic

# 1. 状態スキーマの定義(これがLangGraphの核心)
class AgentState(TypedDict):
    messages: Annotated[list, add_messages]  # add_messages = 追記型reducer
    next_action: str
    approved: bool

# 2. ノード(処理ユニット)の定義
llm = ChatAnthropic(model="claude-sonnet-4-5")

def analyze_node(state: AgentState) -> dict:
    """ユーザーの入力を分析するノード"""
    response = llm.invoke(state["messages"])
    return {
        "messages": [response],
        "next_action": "approve" if "重要" in response.content else "execute"
    }

def execute_node(state: AgentState) -> dict:
    """タスクを実行するノード"""
    return {"messages": [{"role": "assistant", "content": "実行完了しました。"}]}

def approve_node(state: AgentState) -> dict:
    """承認待ちノード(Human-in-the-loop)"""
    from langgraph.types import interrupt
    result = interrupt({
        "message": "重要なタスクです。承認しますか?",
        "task": state["messages"][-1].content
    })
    return {"approved": result.get("approved", False)}

# 3. グラフの構築
def should_approve(state: AgentState) -> str:
    """条件分岐エッジ: next_actionに基づいてルーティング"""
    return state["next_action"]  # "approve" or "execute"

builder = StateGraph(AgentState)
builder.add_node("analyze", analyze_node)
builder.add_node("approve", approve_node)
builder.add_node("execute", execute_node)

builder.add_edge(START, "analyze")
builder.add_conditional_edges("analyze", should_approve, {
    "approve": "approve",
    "execute": "execute"
})
builder.add_edge("approve", "execute")
builder.add_edge("execute", END)

# 4. チェックポイント付きでコンパイル(状態を永続化)
from langgraph.checkpoint.memory import MemorySaver
checkpointer = MemorySaver()
graph = builder.compile(checkpointer=checkpointer)

# 5. 実行(thread_id = セッション識別子)
config = {"configurable": {"thread_id": "session-001"}}
result = graph.invoke(
    {"messages": [{"role": "user", "content": "重要な発注書を処理してください"}]},
    config=config
)
print(result)
研修先での実例: 上記の最小構成を顧問先SaaS企業のバックエンドエンジニアに見せたところ、「これが最初から分かっていればOpenAI SDKで作り直す必要がなかった」と言っていました。状態スキーマを先に設計することで、後から条件分岐や承認フローを追加しやすくなる点が一番刺さっていました。
StateGraph の設計思想:なぜ「状態機械」なのか
LangGraphが他のエージェントフレームワークと根本的に異なるのは、「ループ型エージェント」ではなく「状態機械型グラフ」という設計思想です。
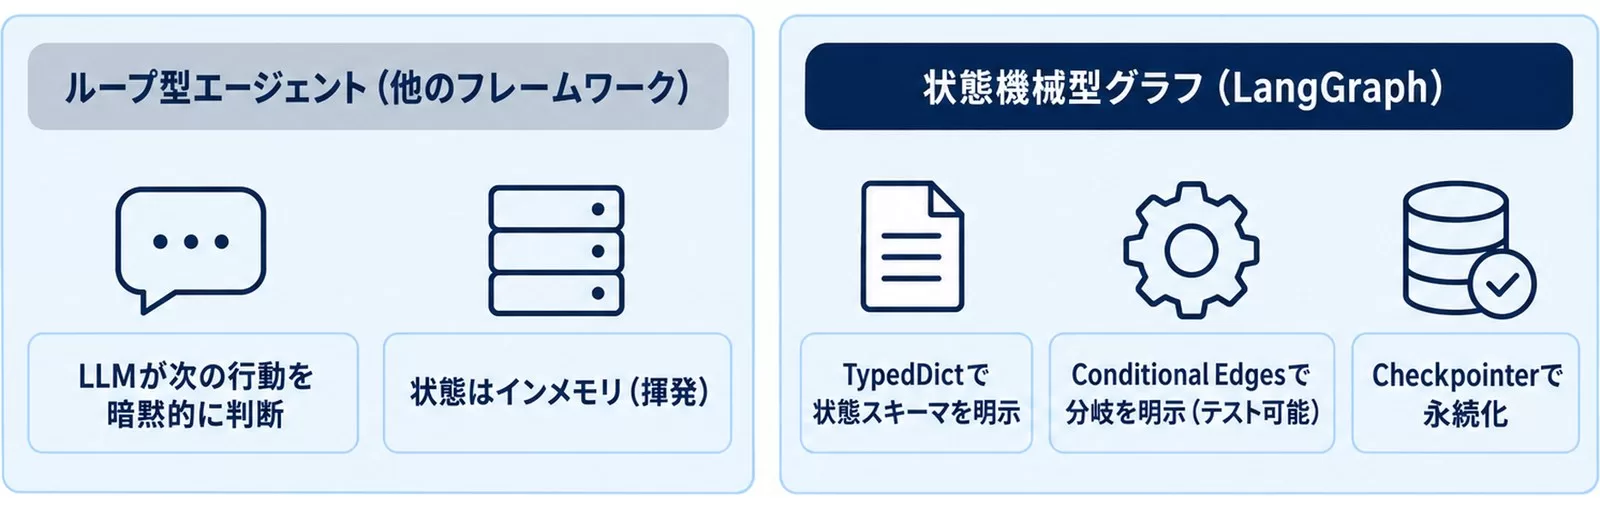
普通のエージェントループとの違い
# ❌ 普通のループ型エージェント(状態が揮発する)
def simple_agent_loop(task: str) -> str:
    history = []  # セッションメモリ(再起動で消える)
    while True:
        response = llm.invoke(history + [task])
        if "完了" in response:
            return response
        history.append(response)
        # 問題:
        # - 再起動したら最初からやり直し
        # - 条件分岐を入れると複雑化する一方
        # - 承認フローが入れられない

# ✅ LangGraph の状態機械型(状態が永続化される)
class WorkflowState(TypedDict):
    task: str
    step: str       # 現在のステップ
    approved: bool  # 承認済みか
    result: str     # 最終結果

# 各ステップが「状態変換関数」として定義される
# → チェックポイントで保存 → 中断・再開が自在
# → Conditional Edge で複雑な分岐も明示的に管理
# → LangGraph Studio でグラフ構造を視覚化できる
State のスキーマ設計(実践パターン)
from typing import TypedDict, Annotated, Optional
from langgraph.graph.message import add_messages
import operator

class EnterpriseWorkflowState(TypedDict):
    # メッセージ履歴(add_messages = appendリデューサー)
    messages: Annotated[list, add_messages]

    # カウンターなど累積値(operator.add = 加算リデューサー)
    retry_count: Annotated[int, operator.add]

    # 通常のフィールド(上書き型)
    status: str           # "pending" | "approved" | "rejected" | "done"
    assigned_to: str      # 担当者
    amount: float         # 金額
    priority: str         # "high" | "medium" | "low"

    # Optionalフィールド(存在しない場合はNone)
    approval_comment: Optional[str]
    execution_result: Optional[dict]

# 1.1.10 新機能: UntrackedValue(チェックポイントに保存しない一時データ)
from langgraph.store import UntrackedValue
class OptimizedState(TypedDict):
    messages: Annotated[list, add_messages]
    # db_connectionはチェックポイントに含めない(シリアライズ不可のオブジェクト)
    db_connection: Annotated[object, UntrackedValue]
重要なポイント: TypedDictでスキーマを明示的に定義することで、LangGraph Studioがグラフの状態を視覚化してくれます。これが後述のデバッグをとても楽にします。
Conditional Edges の設計パターン3選
from langgraph.graph import StateGraph, END

# パターン1: 文字列で直接ルーティング(最もシンプル)
def route_by_status(state: WorkflowState) -> str:
    if state["status"] == "approved":
        return "execute"
    elif state["status"] == "rejected":
        return "notify_rejection"
    else:
        return "request_approval"

builder.add_conditional_edges("check_status", route_by_status)

# パターン2: 辞書マッピングで明示的に定義(可読性が高い)
def route_by_amount(state: WorkflowState) -> str:
    amount = state.get("amount", 0)
    if amount > 1_000_000:    return "executive_approval"
    elif amount > 100_000:    return "manager_approval"
    else:                     return "auto_execute"

builder.add_conditional_edges(
    "check_amount",
    route_by_amount,
    {
        "executive_approval": "executive_approval_node",
        "manager_approval":   "manager_approval_node",
        "auto_execute":       "execute_node"
    }
)

# パターン3: Send APIで動的な並列処理(1.1.10対応)
from langgraph.types import Send

def fan_out_to_reviewers(state: WorkflowState):
    """複数のレビュアーに並列でタスクを割り当てる"""
    reviewers = ["alice", "bob", "charlie"]
    return [
        Send("review_node", {**state, "reviewer": r})
        for r in reviewers
    ]

builder.add_conditional_edges("assign_reviewers", fan_out_to_reviewers)
Checkpointer完全ガイド:状態を永続化して「止めて・再開できる」エージェントを作る
LangGraphで本番運用する上で最も重要な機能がCheckpointerです。LangGraphのCheckpointerは、グラフの各ステップの状態をスナップショットとして保存し、いつでも中断・再開できるようにします。
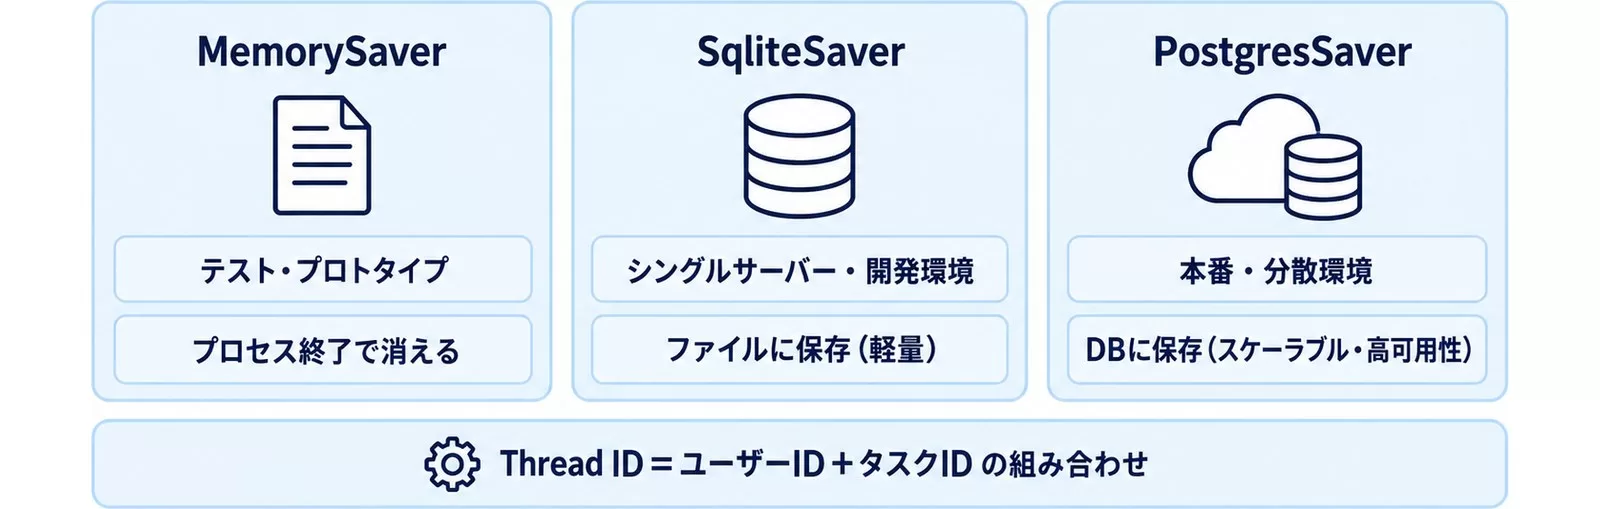
Checkpointer 3種類の使い分け
| Checkpointer | パッケージ | 適用場面 | 永続性 |
|---|---|---|---|
| MemorySaver | langgraph組み込み | テスト・プロトタイプ | なし(プロセス終了で消える) |
| SqliteSaver | langgraph-checkpoint-sqlite | シングルサーバー・開発環境 | ファイル(軽量・簡単) |
| PostgresSaver | langgraph-checkpoint-postgres | 本番・分散環境 | DB(スケーラブル・高可用性) |
## MemorySaver(テスト・プロトタイプ用)
from langgraph.checkpoint.memory import MemorySaver

checkpointer = MemorySaver()
graph = builder.compile(checkpointer=checkpointer)

## SqliteSaver(開発環境・シングルサーバー用)
from langgraph.checkpoint.sqlite import SqliteSaver

with SqliteSaver.from_conn_string("./checkpoints.db") as checkpointer:
    graph = builder.compile(checkpointer=checkpointer)
    result = graph.invoke(input_data, config={"configurable": {"thread_id": "t1"}})

## AsyncSqliteSaver(開発環境・非同期版)
from langgraph.checkpoint.sqlite.aio import AsyncSqliteSaver

async def run_async():
    async with AsyncSqliteSaver.from_conn_string("./checkpoints.db") as checkpointer:
        graph = builder.compile(checkpointer=checkpointer)
        result = await graph.ainvoke(input_data, config=config)

## PostgresSaver(本番環境)
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

DB_URI = "postgresql://user:password@localhost:5432/langgraph_db"

# 同期版
with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()  # 初回のみテーブル作成
    graph = builder.compile(checkpointer=checkpointer)

# 非同期版(FastAPIと組み合わせる場合)
async def lifespan(app):
    async with AsyncPostgresSaver.from_conn_string(DB_URI) as checkpointer:
        await checkpointer.setup()
        app.state.graph = builder.compile(checkpointer=checkpointer)
        yield
Thread IDとConfig:セッション管理の設計
import uuid

# Thread IDはユーザーセッションの識別子
def create_session(user_id: str) -> str:
    thread_id = f"{user_id}-{uuid.uuid4().hex[:8]}"
    return thread_id

# 同じthread_idで呼ぶと、前の状態から継続できる
config = {
    "configurable": {
        "thread_id": "user-123-abc12345",
        "checkpoint_ns": "production",  # 環境を分けたい場合
    },
    "recursion_limit": 50,  # 無限ループ防止
}

# 前の状態を確認
state_snapshot = graph.get_state(config)
print(f"現在のノード: {state_snapshot.next}")
print(f"ステップ数: {state_snapshot.metadata['step']}")

# 過去の状態にロールバック(デバッグ・リカバリー用)
history = list(graph.get_state_history(config))
past_config = history[2].config  # 3ステップ前の状態
graph.invoke(None, past_config)  # そこから再実行
本番設計のコツ: Thread IDを「ユーザーID + タスクID」の組み合わせにすると、セッション管理が格段に楽になります。顧問先のSaaS企業では、PostgresSaverを使って1万セッション同時実行のシステムを構築しました。SQLiteとの違いは「接続プールが使えるかどうか」で、高トラフィック環境では必ずPostgresを使ってください。
Human-in-the-loop実装:interrupt() で人間の判断を組み込む
LangGraphの最も強力な機能の一つが、interrupt()を使ったHuman-in-the-loopパターンです。エージェントの実行を途中で止め、人間の確認・修正・承認を受けてから再開できます。
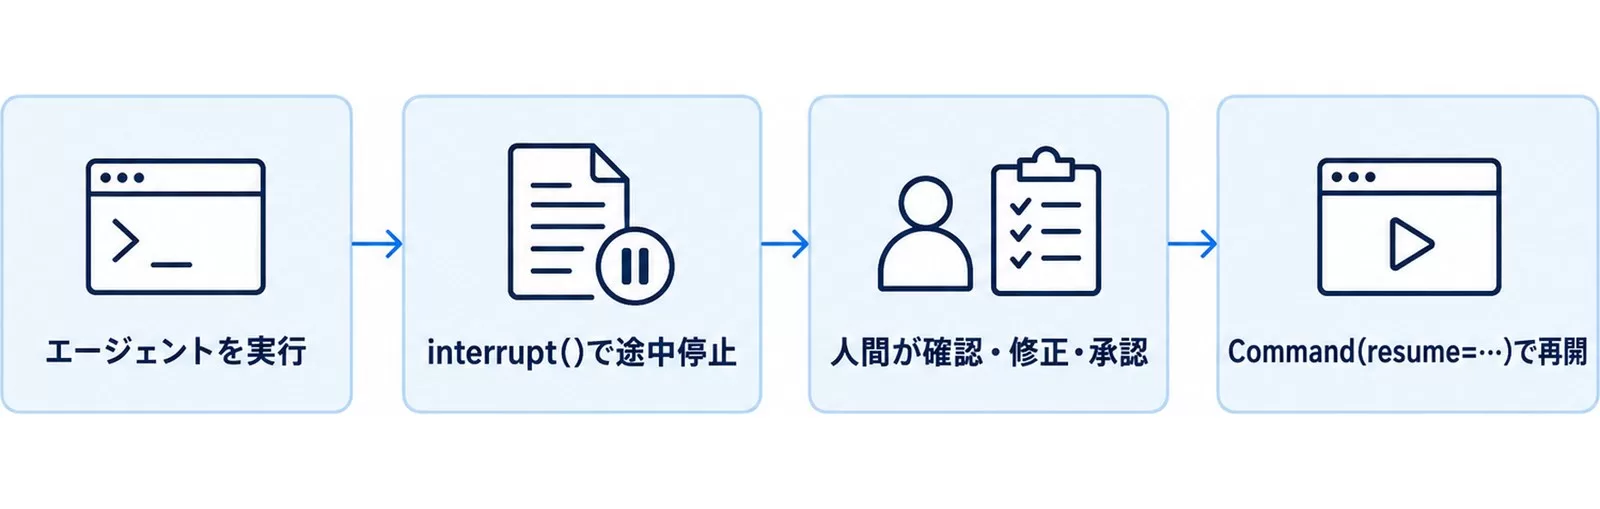
interrupt()の基本パターン
from langgraph.types import interrupt, Command

def approval_node(state: WorkflowState) -> dict:
    """
    interrupt()を呼ぶとグラフがここで一時停止する。
    ユーザーがCommand(resume=...)で再開するまで待機。
    """
    # 承認リクエストの内容をinterruptのペイロードに入れる
    decision = interrupt({
        "type": "approval_request",
        "message": f"¥{state['amount']:,}の発注書を承認しますか?",
        "details": {
            "vendor": state.get("vendor"),
            "items": state.get("items"),
            "amount": state["amount"],
        }
    })

    # resumeで返ってきた値がdecisionに入る
    if decision.get("approved"):
        return {
            "status": "approved",
            "approval_comment": decision.get("comment", "")
        }
    else:
        return {
            "status": "rejected",
            "approval_comment": decision.get("reason", "却下されました")
        }

# グラフを実行 → interrupt地点で停止
config = {"configurable": {"thread_id": "order-001"}}
result = graph.invoke(
    {"messages": [{"role": "user", "content": "150万円の発注書を処理して"}]},
    config=config
)

# result["__interrupt__"]がTrue → ユーザーの入力待ち
if "__interrupt__" in str(result):
    print("承認待ち。ユーザーの判断を待っています...")

    # ユーザーが承認 → Command(resume=...)で再開
    final_result = graph.invoke(
        Command(resume={"approved": True, "comment": "予算内なので承認します"}),
        config=config
    )
    print("承認済みで処理再開:", final_result)
複数ステップのHuman-in-the-loop(実践パターン)
def multi_step_approval_workflow():
    """
    実務では「確認 → 修正提案 → 最終承認」の3段階が多い
    """

    def draft_node(state: WorkflowState):
        """AIがドラフトを作成"""
        draft = llm.invoke([
            {"role": "user", "content": f"次のタスクのドラフトを作成: {state['task']}"}
        ])
        return {"messages": [draft], "status": "draft_ready"}

    def review_node(state: WorkflowState):
        """ユーザーにドラフトのレビューを依頼"""
        feedback = interrupt({
            "type": "review_request",
            "draft": state["messages"][-1].content,
            "options": ["approve", "revise", "reject"]
        })

        if feedback["action"] == "approve":
            return {"status": "approved"}
        elif feedback["action"] == "revise":
            return {
                "status": "needs_revision",
                "messages": [{"role": "user", "content": f"修正指示: {feedback['notes']}"}]
            }
        else:
            return {"status": "rejected"}

    def route_after_review(state: WorkflowState) -> str:
        if state["status"] == "approved": return "finalize"
        elif state["status"] == "needs_revision": return "draft"  # 戻る
        else: return END

    builder = StateGraph(WorkflowState)
    builder.add_node("draft", draft_node)
    builder.add_node("review", review_node)
    builder.add_node("finalize", finalize_node)

    builder.add_edge(START, "draft")
    builder.add_edge("draft", "review")
    builder.add_conditional_edges("review", route_after_review)
    builder.add_edge("finalize", END)

    return builder.compile(checkpointer=PostgresSaver.from_conn_string(DB_URI))
正直な限界の話: interrupt()パターンは強力ですが、注意点もあります。WebアプリでHTTP リクエスト経由でエージェントを呼ぶ場合、interrupt地点でレスポンスを返してセッションを維持する設計が必要です。FastAPI + Server-Sent Events(SSE)との組み合わせが最もよく使われるパターンですが、実装はやや複雑です。後述のLangGraph Studioを使えばローカル開発では手動で承認操作ができるので、まずStudioで動作確認してから本番APIを実装する順番が賢いです。
LangGraph Studio v2:ビジュアルデバッグでマルチエージェントを制御する
LangGraph Studio v2は、グラフの実行をリアルタイムで可視化し、状態の編集・フォーク・巻き戻しができるデバッグGUIです。2026年時点では、デスクトップアプリより「ローカルサーバー + Webブラウザ」の方式が推奨されています。
Studio の起動方法(2026年最新・Docker不要)
# プロジェクト構造(最小構成)
# my_agent/
# ├── langgraph.json   ← グラフ定義ファイル
# ├── agent.py         ← StateGraph実装
# └── requirements.txt

# langgraph.json の例
# {
#   "dependencies": ["."],
#   "graphs": {
#     "approval_workflow": "./agent.py:graph"
#   }
# }

# Studioのローカルサーバー起動(Docker不要)
pip install langgraph-cli
langgraph dev

# → http://localhost:2024 でStudioが開く
# → コードを変更するとホットリロードで自動更新
# → Dockerより起動が約10倍速い

# デプロイ先URLでも使える(本番トレースのデバッグ)
# LangSmith Studio: https://smith.langchain.com/studio
Studioのデバッグ機能(実践)
## LangGraph Studio でできること(2026年版)

# 1. グラフのビジュアル表示
#    → ノード/エッジの構造をリアルタイムで確認
#    → 現在実行中のノードがハイライトされる

# 2. 状態のインタラクティブ編集
#    → 実行中の状態値を直接編集してフォーク
#    → "Fork"ボタン → 別のシナリオで再実行

# 3. Human-in-the-loop の操作
#    → interrupt() 地点でGUIが承認ダイアログを表示
#    → ボタンクリックで承認/却下/修正

# 4. 本番トレースのローカル再現(v2新機能)
#    → LangSmithの本番トレースをダウンロード
#    → ローカルStudioで再実行してバグを再現・修正

# 5. プロンプトの直接編集
#    → Studioの画面からシステムプロンプトを変更
#    → コードを変更せずにプロンプトチューニング
研修先での活用例: あるSaaS企業の開発チームにLangGraph Studioを見せた時、「グラフが可視化されることで、コードを読まなくてもワークフローを理解できる」という反応が一番多かったです。特に非エンジニアの業務担当者と一緒に設計する際に、Studioのグラフ図を見ながらフローを議論できるのは大きなメリットです。
この記事の内容、自社の業務でも回したい?
AI顧問(月次伴走)が、貴社の業務に合わせて導入から定着まで並走します。研修4,000名以上・支援100社以上の実績。まずは30分の壁打ちから。
Streaming実装:リアルタイムでユーザーに進捗を返す
本番のUIで「エージェントが何をしているか」をリアルタイムで表示するには、Streamingが不可欠です。LangGraph 1.1.10では複数のStreamモードが用意されています。
StreamモードとFastAPI連携(本番パターン)
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio
import json

app = FastAPI()

@app.post("/run-agent")
async def run_agent_stream(task: str):
    """
    Server-Sent Events (SSE) でリアルタイムストリーミング
    """
    config = {"configurable": {"thread_id": f"task-{uuid.uuid4().hex[:8]}"}}

    async def event_generator():
        async for event in graph.astream_events(
            {"messages": [{"role": "user", "content": task}]},
            config=config,
            version="v2"  # v2推奨(型安全なstream)
        ):
            event_type = event["event"]

            # LLMのトークンをリアルタイムで流す
            if event_type == "on_chat_model_stream":
                token = event["data"]["chunk"].content
                if token:
                    yield f"data: {json.dumps({'type': 'token', 'content': token})}nn"

            # ノードの開始・終了を通知
            elif event_type == "on_chain_start":
                node_name = event.get("name", "unknown")
                yield f"data: {json.dumps({'type': 'node_start', 'node': node_name})}nn"

            elif event_type == "on_chain_end":
                node_name = event.get("name", "unknown")
                yield f"data: {json.dumps({'type': 'node_end', 'node': node_name})}nn"

        yield f"data: {json.dumps({'type': 'done'})}nn"

    return StreamingResponse(
        event_generator(),
        media_type="text/event-stream",
        headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"}
    )

# Streamモード早見表
# "values"    → 各ステップ後の全状態を出力(デバッグ向き)
# "updates"   → 各ステップの差分のみ(効率的・本番向き)
# "messages"  → LLMトークンをリアルタイムで(チャットUI向き)
# "debug"     → 詳細なデバッグ情報(LangGraph Studio用)

# 複数モードを同時に使う例
async for chunk in graph.astream(
    input_data,
    config=config,
    stream_mode=["updates", "messages"]  # 複数指定可
):
    print(chunk)
注意点(2026年4月時点): 非同期ツール(async def のツール)は現時点で `get_stream_writer()` を使ったカスタムイベントストリーミングに対応していません(GitHub Issue #6447)。非同期ツールでストリーミングが必要な場合は、ノードの引数に `writer` パラメータを追加して手動でwriterを渡す回避策があります。
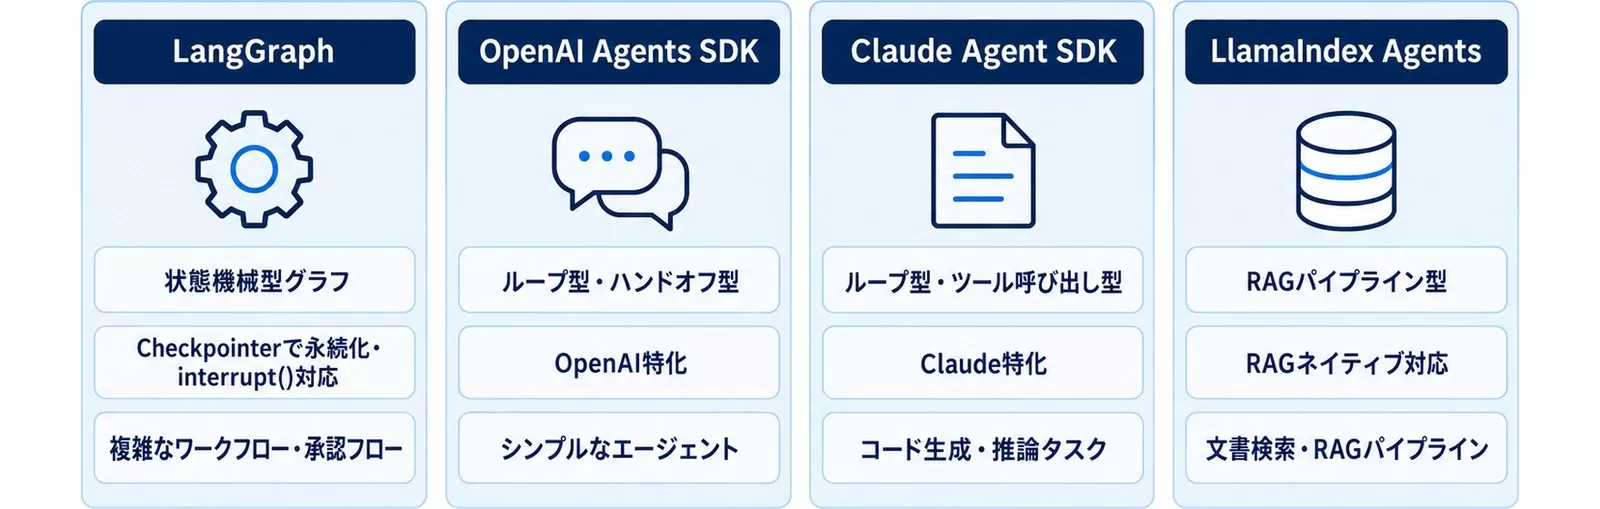
4大OSSエージェントフレームワーク比較:LangGraph vs OpenAI Agents SDK vs Claude Agent SDK vs LlamaIndex Agents
2026年現在、OSSエージェントフレームワークの主要4選択肢を実務観点で比較します。OpenAI Agents SDK完全ガイドとClaude Agent SDK完全ガイドも合わせて参照すると、選定がより明確になります。
| 比較軸 | LangGraph 1.1.10 | OpenAI Agents SDK | Claude Agent SDK | LlamaIndex Agents |
|---|---|---|---|---|
| 設計思想 | 状態機械型グラフ | ループ型・ハンドオフ型 | ループ型・ツール呼び出し型 | RAGパイプライン型 |
| 状態管理 | TypedDict + Checkpointer(永続化) | インメモリ(揮発) | インメモリ(揮発) | インメモリ(揮発) |
| Human-in-the-loop | interrupt() ネイティブ対応 | 手動実装が必要 | 手動実装が必要 | 未対応(手動実装) |
| 条件分岐 | Conditional Edges(明示的・テスト可能) | Agent判断(暗黙的) | Agent判断(暗黙的) | QueryEngine経由 |
| デバッグ | LangGraph Studio(ビジュアル) | OpenAI Dashboard | Jaeger/OpenTelemetry | LlamaTrace |
| LLMの柔軟性 | マルチプロバイダー(Claude/GPT/Gemini等) | OpenAI特化(他LLMは非推奨) | Claude特化(他LLMも使用可) | マルチプロバイダー |
| RAG統合 | 要別途実装(LlamaIndexと組み合わせ推奨) | File Search(ホスト型) | 要別途実装 | ネイティブ対応(最強) |
| 学習コスト | 高(グラフ設計の理解が必要) | 低(Python dict操作だけ) | 低(Pythonの型ヒントだけ) | 中(Index/Queryの概念) |
| 本番実績 | Klarna・Replit・Elastic等大手採用 | OpenAI Platformユーザー | Anthropicエコシステム | 検索・文書処理系企業 |
| GitHub Stars | 56,000以上(2026年5月) | 22,000以上 | 8,000以上 | 38,000以上 |
| 最適な用途 | 複雑なワークフロー・承認フロー・長時間実行 | OpenAIツール活用・シンプルなエージェント | Claude特化・コード生成・推論タスク | 文書検索・RAGパイプライン |
選択基準まとめ(実務判断フロー)
"""
エージェントフレームワーク選定フローチャート(2026年版)

1. RAGが主なユースケース?
   → YES: LlamaIndex Agents
   → NO: 次へ

2. OpenAIのホスト型ツール(File Search/Computer Use/Realtime)が必要?
   → YES: OpenAI Agents SDK
   → NO: 次へ

3. Claudeのみ使う + ツール呼び出しがシンプル?
   → YES: Claude Agent SDK(最も書きやすい)
   → NO: 次へ

4. 以下のいずれかが必要?
   - 承認フロー(Human-in-the-loop)
   - プロセス終了後の再開(Checkpointer)
   - 複雑な条件分岐(5ステップ以上)
   - 長時間実行(数時間〜数日のタスク)
   - マルチLLMの組み合わせ
   → YES: LangGraph ← ここがLangGraphの独壇場
"""
あわせて読みたい: AWS Bedrock AgentCore完全ガイド(クラウドマネージドでエージェントを動かす場合の選択肢)
本番デプロイ:LangSmith Deploymentの料金と設計
2025年10月、LangGraph Cloudは「LangSmith Deployment」にリブランドされました。LangGraphのOSSフレームワークは無料ですが、マネージドデプロイには料金がかかります。
LangSmith 料金体系(2026年版)
| プラン | 料金 | トレース数 | デプロイ | 適用場面 |
|---|---|---|---|---|
| Developer | 無料 | 5,000/月 | なし | 個人学習・プロトタイプ |
| Plus | $39/シート/月 | 10,000/月($2.50/1,000件追加) | 1 Dev deployment無料 | 小チーム・スタートアップ |
| Enterprise | 要問い合わせ | カスタム | 本番デプロイ含む | 大規模本番・高SLA |
## セルフホスト(LangSmithなしで本番運用)する場合

# 方法1: Docker Compose + Postgres
# docker-compose.yml
# services:
#   app:
#     image: python:3.11
#     environment:
#       - DATABASE_URL=postgresql://user:pass@db:5432/langgraph
#   db:
#     image: postgres:16

# 方法2: Kubernetes + PostgresSaver
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

# 環境変数で接続先を切り替え
import os
DB_URI = os.environ["DATABASE_URL"]  # 本番はシークレット管理から取得

async with AsyncPostgresSaver.from_conn_string(DB_URI) as checkpointer:
    await checkpointer.setup()
    graph = builder.compile(checkpointer=checkpointer)

# 方法3: langgraph-api(セルフホスト用APIサーバー)
# pip install langgraph-api
# langgraph-api serve --port 8080
# → LangGraph Studio から接続可能なAPIサーバーが起動
コスト設計のポイント: LangSmithの課金はトレース数ベースなので、デバッグ用の開発環境と本番を分けてトレースを管理することが重要です。小規模なら自前のPostgres + セルフホストで月額ゼロで動かせます。本番でLangSmithを使う場合でも、まずPlusプランの1 Dev deploymentで試して、Enterpriseが必要になった段階でアップグレードする順番を推奨します。
【要注意】LangGraph本番運用の落とし穴4選
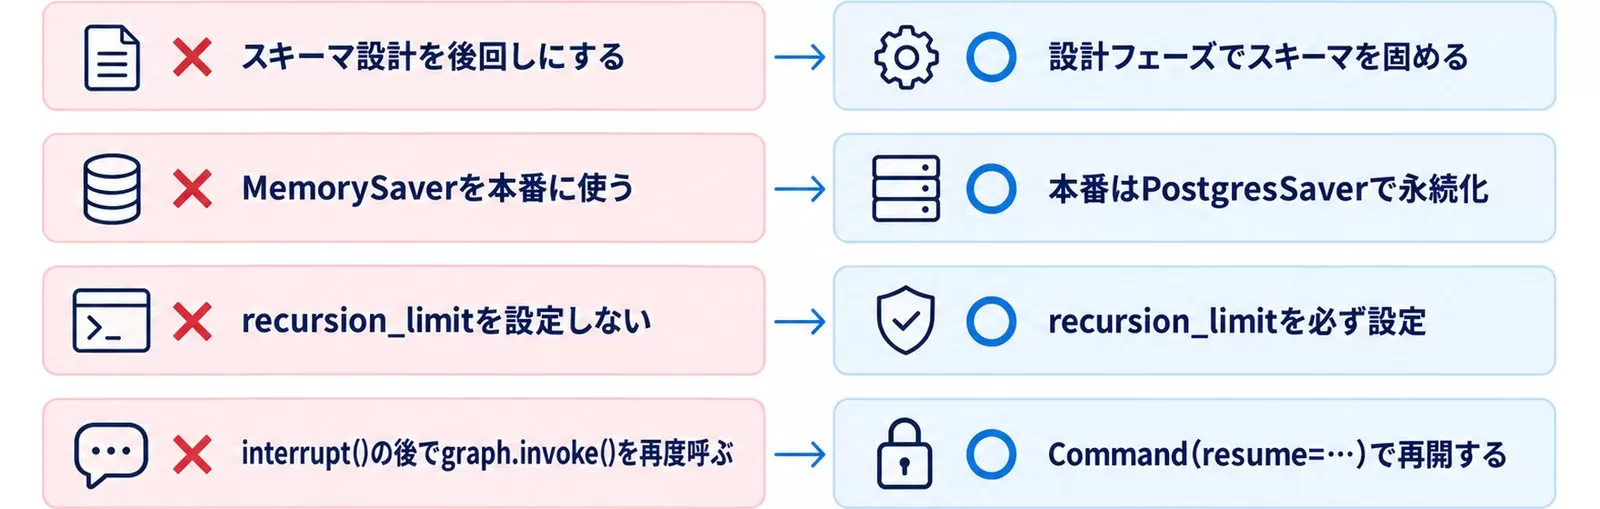
落とし穴1:スキーマ設計を後回しにする
## ❌ よくある失敗:とりあえずdictで始める
def bad_node(state: dict) -> dict:
    state["result"] = "done"  # どこで何が変わるか追跡不能
    return state

## ✅ 正しいアプローチ:最初にTypedDictでスキーマを固める
class WorkflowState(TypedDict):
    messages: Annotated[list, add_messages]
    status: Literal["pending", "approved", "done", "failed"]
    result: Optional[str]
    error_count: Annotated[int, operator.add]

# メリット: LangGraph Studioが状態を可視化できる
# メリット: 型チェックで設計段階でバグを発見できる
# メリット: チームメンバーがコードを読まなくてもスキーマを理解できる
なぜ重要か: スキーマを後から変えると、既存のCheckpointとの互換性が崩れます。本番データが入ってからスキーマを変えると、マイグレーションが大変になります。必ず設計フェーズでスキーマを固めてください。
落とし穴2:MemorySaverを本番に使う
## ❌ よくある失敗
checkpointer = MemorySaver()  # プロセス再起動で全状態が消える
graph = builder.compile(checkpointer=checkpointer)

# 問題:
# - サーバーが再起動するとすべてのセッションが初期化される
# - Human-in-the-loopのinterruptが維持できない
# - スケールアウト(複数サーバー)に対応できない

## ✅ 本番では必ずPostgresSaver
with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()  # 初回のみ。以降はmigrationで管理
    graph = builder.compile(checkpointer=checkpointer)
落とし穴3:recursion_limitを設定しない
## ❌ recursion_limitなし → 無限ループでサーバーが落ちる
config = {"configurable": {"thread_id": "t1"}}
graph.invoke(data, config)

## ✅ 必ずrecursion_limitを設定する
config = {
    "configurable": {"thread_id": "t1"},
    "recursion_limit": 25  # デフォルト25、複雑なグラフは50まで
}

# さらに安全のため、エラーハンドリングも入れる
try:
    result = graph.invoke(data, config)
except GraphRecursionError as e:
    logger.error(f"Graph recursion limit exceeded: {e}")
    # フォールバック処理
落とし穴4:interrupt()の後でgraph.invoke()を再度呼ぶ
## ❌ よくある誤り:interrupt後にinvokeで再開しようとする
result = graph.invoke(data, config)
# interrupt地点で停止...

# ❌ 間違い: invoke()で再開するとスレッドの状態がリセットされる
result = graph.invoke(data, config)  # これは最初からやり直し

## ✅ 正しい再開方法: Command(resume=...)を使う
from langgraph.types import Command

result = graph.invoke(
    Command(resume={"approved": True}),  # ここがポイント
    config  # 同じthread_idのconfigを使う
)

# APIの場合の設計パターン
# POST /tasks/{thread_id} → 新規タスク開始
# POST /tasks/{thread_id}/approve → interrupt地点から再開
実際の経験談: このinterruptの再開方法の誤りは、研修で教えると90%のエンジニアが最初に引っかかるポイントです。「invokeで再開すればいいでしょ」と思いがちですが、それだと最初から実行しなおしになります。Command(resume=…)というAPIが直感的でないので、コードレビューの項目に入れておくことをおすすめします。
まとめ:今日から始める3つのアクション
LangGraphは、状態機械型の設計思想により、複雑なマルチエージェントワークフロー・承認フロー・長時間実行タスクの本番実装で圧倒的な優位性があります。一方、学習コストが高く、シンプルなエージェントにはオーバースペックです。今日から試せる順番を整理します。
- 今日やること:
pip install langgraph langgraph-cli→langgraph devでStudioを起動。本記事の「最小構成StateGraph」(冒頭コード)をそのままコピーして実行し、LangGraph Studioでグラフ構造を確認する。 - 今週中: interrupt() を使ってHuman-in-the-loopの承認フローを実装する。SqliteSaverで状態を永続化し、「エージェントを止めて → ユーザーが承認 → Command(resume)で再開」の一連の流れを動かす。
- 今月中: PostgresSaverに切り替えてFastAPI + SSEでStreamingを実装。LangSmith Plusプランの1 Dev deploymentを使って本番環境での動作確認を行う。
あわせて読みたい:
- OpenAI Agents SDK完全ガイド:シンプルなエージェント・OpenAIツール活用の実装例
- Claude Agent SDK完全ガイド:Claude特化の推論・コード生成エージェント
- AWS Bedrock AgentCore完全ガイド:クラウドマネージドでエージェントを本番運用する
- AutoGen完全ガイド|マルチエージェント会話設計
- CrewAIとは|使い方と役割ベースのマルチエージェント設計
- AIエージェントセキュリティ完全ガイド:OWASP LLM Top 10対応、4層モデル、本番運用30項目チェックリスト
- AIエージェント観測・評価完全ガイド|運用基盤:LangSmith/Langfuse/RAGAS/DeepEvalで本番品質を可視化
- AIエージェントMemory完全ガイド|永続記憶3強:Mem0/Zep/Lettaで永続記憶を実装、Core/Archival/Recall 3層モデル
- AI Voiceエージェント7強完全比較:Vapi/Retell/ElevenLabs/Deepgramほか電話AI比較
- AIカスタマーサポート7強完全比較:Decagon/Sierra/Intercom Fin等のCS AI基盤比較
- 士業のAI活用完全ガイド:税理士/社労士/弁護士/司法書士/行政書士の実践プロンプト10選
- 経理業務の負荷をCodex自動化で解決する方法:経理特化10シーンで最大80%削減
- Codex×Excel自動化プロンプト10選:VBA/Apps Script/Power Query代替
- Codex×業務15選 部署別ガイド:営業/マーケ/人事/法務/経企/情シス/CSの15シーン
参考・出典
- langgraph PyPI — LangChain(参照日: 2026-05-07)
- LangGraph 1.0 GA Release Notes — LangChain(参照日: 2026-05-07)
- LangGraph Persistence ドキュメント — LangChain(参照日: 2026-05-07)
- Human-in-the-loop with interrupt() — LangChain Blog(参照日: 2026-05-07)
- LangGraph Studio v2 Announcement — LangChain(参照日: 2026-05-07)
- LangSmith Plans and Pricing — LangChain(参照日: 2026-05-07)
- langgraph-checkpoint-postgres PyPI — LangChain(参照日: 2026-05-07)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
この記事の内容を社内展開する方へ: AIエージェント導入・安全運用チェックリスト(無料・PDF 14ページ) をダウンロードできます。
AIエージェント実装、設計から運用まで伴走します
PoCで終わらせない。AI顧問(月次伴走)として、エージェント設計から運用定着まで貴社の業務プロセスに合わせて並走します。
- マルチエージェント実装の実戦経験
- 初回30分無料・即日返信
お問い合わせフォームから24時間以内にUravation担当者がご返信します。