



(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:MinerU2.5-Pro: Pushing the Limits of Data-Centric Document Parsing at Scale
论文作者:上海人工智能实验室、北京大学、上海交通大学与商汤
发表时间:2026年4月6日
目录
本文要点
(1)MinerU2.5-Pro是上海人工智能实验室等机构2026年4月发布的文档解析模型,1.2B结构与MinerU2.5相同。
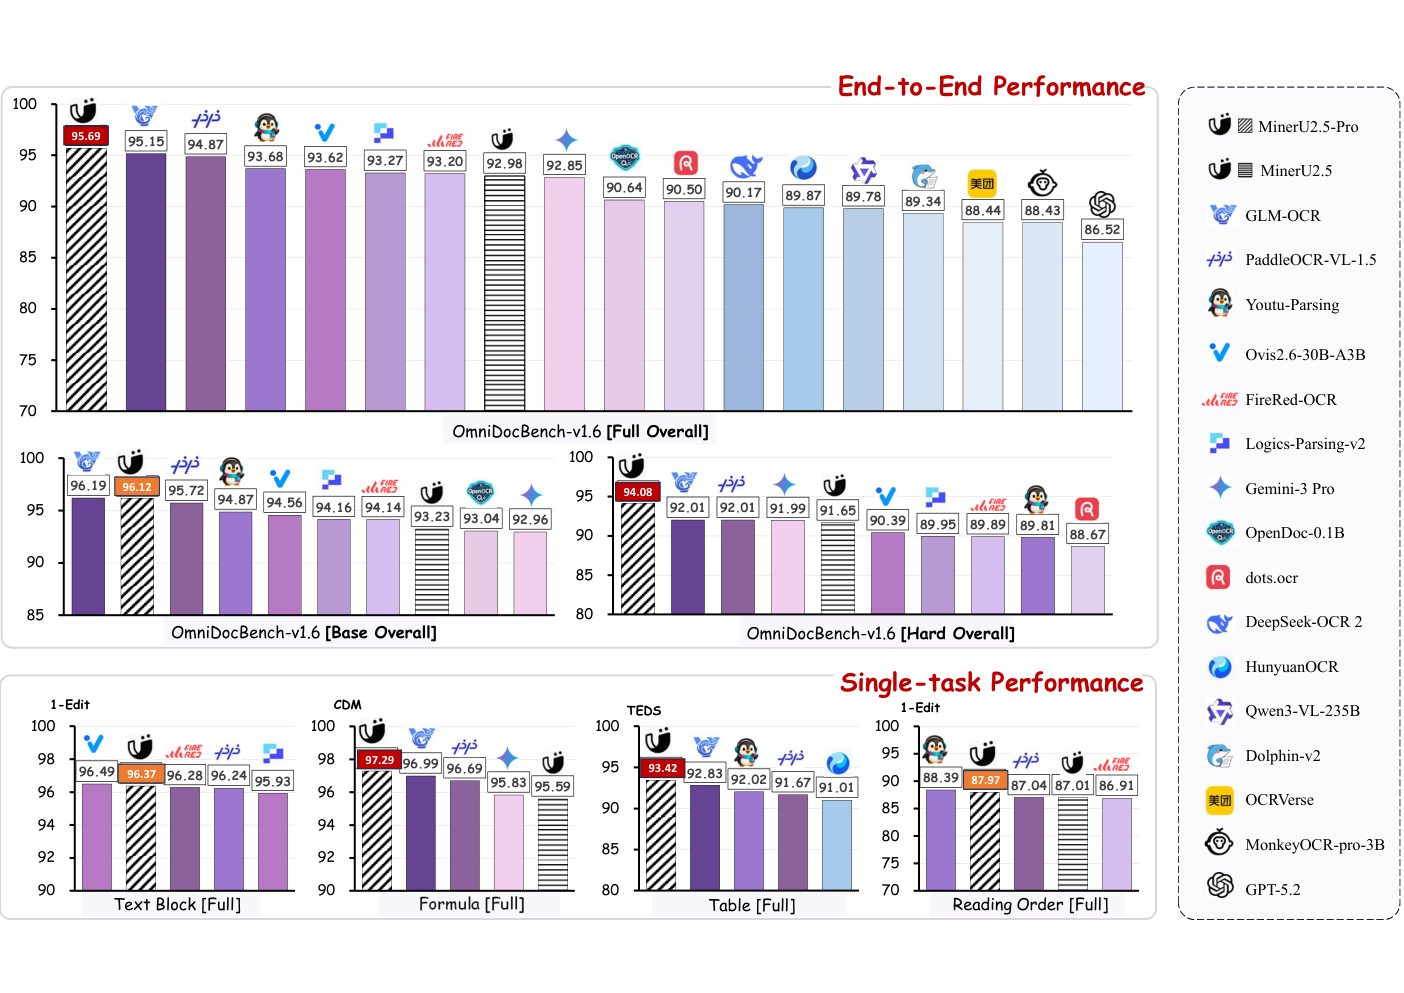
(2)OmniDocBench v1.6的Full分95.69,同架构相对92.98涨2.71分,Hard子集94.08。
(3)做法上三点最值得看,DDAS按多样性与难度扩样本,CMCV三分难度,Judge-and-Refine用渲染图修难样本标签。
(4)短板在Base输给GLM-OCR 0.07分,手写公式输给Qwen3.5-397B,图像分析尚未走完数据引擎。
(5)文末附模型卡的vLLM推理示例。
上海人工智能实验室联合北京大学、上海交通大学和商汤,在2026年4月6日把MinerU2.5-Pro挂上arXiv,编号2604.04771,9日改到v2。我对照的是HTML版和Hugging Face模型卡。
他们把MinerU2.5的1.2B结构原样留下,视觉编码器仍是NaViT-675M,语言模型仍是Qwen2-0.5B。四个子任务加图像分析一共6550万条训练样本。OmniDocBench v1.6的Full分从92.98到95.69,同架构涨了2.71分。
这份成绩在当时超过了GLM-OCR、PaddleOCR-VL-1.5,也超过了Gemini 3 Pro和Qwen3-VL-235B。
一、1.2B结构原样留下的对照实验
文档解析输入一页文档图,输出按阅读顺序组织的Markdown。MinerU2.5走解耦路线,先在降采样页上找块,再把原分辨率裁块送进识别。Pro没有改这条路。
报告做了一件更有说服力的对照。他们拿多种结构和体量的现成模型去扫同一批真实PDF,难样本上的失败模式高度重合。嵌套表、密公式这些坑,小模型和两百倍参数的大模型都会踩。
覆盖不够。MinerU2.5的训练数据不到1000万页,高频的论文和单栏报告占得太满,复杂嵌套表、密公式、非常规多栏很少。
标注更拧。最能拉动模型的难样本,恰好没有哪家能稳定解析对。脏标签进监督微调,错误会写进权重。只把数量堆上去,偏差和噪声会一起放大。
结构不动,只换数据和训练配方,涨分才能算到数据头上。
二、DDAS按多样性与难度重采样
数据引擎要同时做三件事。覆盖铺开,难样本进得去,标签经得住用。对应三个模块,DDAS负责采样,CMCV负责给难度分层,Judge-and-Refine负责把难样本的标签修干净。
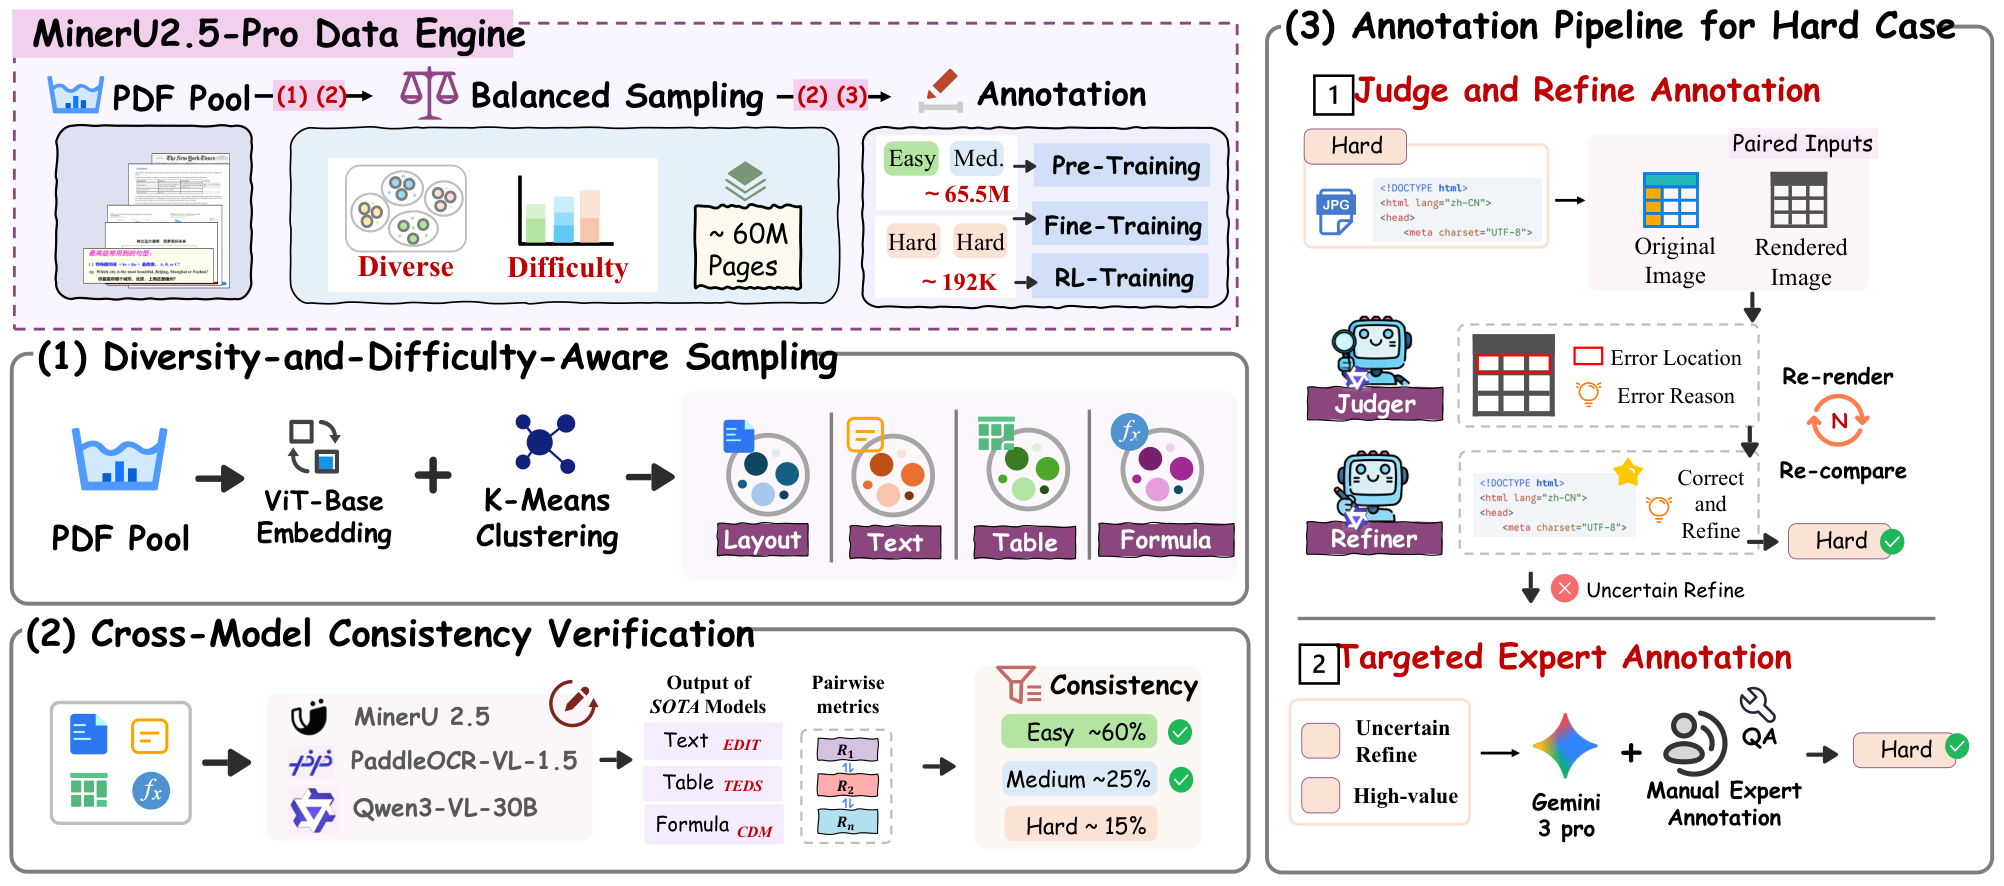
DDAS分两层。页级先用ViT-Base抽出512维特征,K-Means聚类,再让CMCV给每个簇打Easy、Medium、Hard。Easy扎堆的簇下调采样权重,难度分布散的簇上调,空白页和非目标语言直接丢掉。这一层大约收到6000万页。
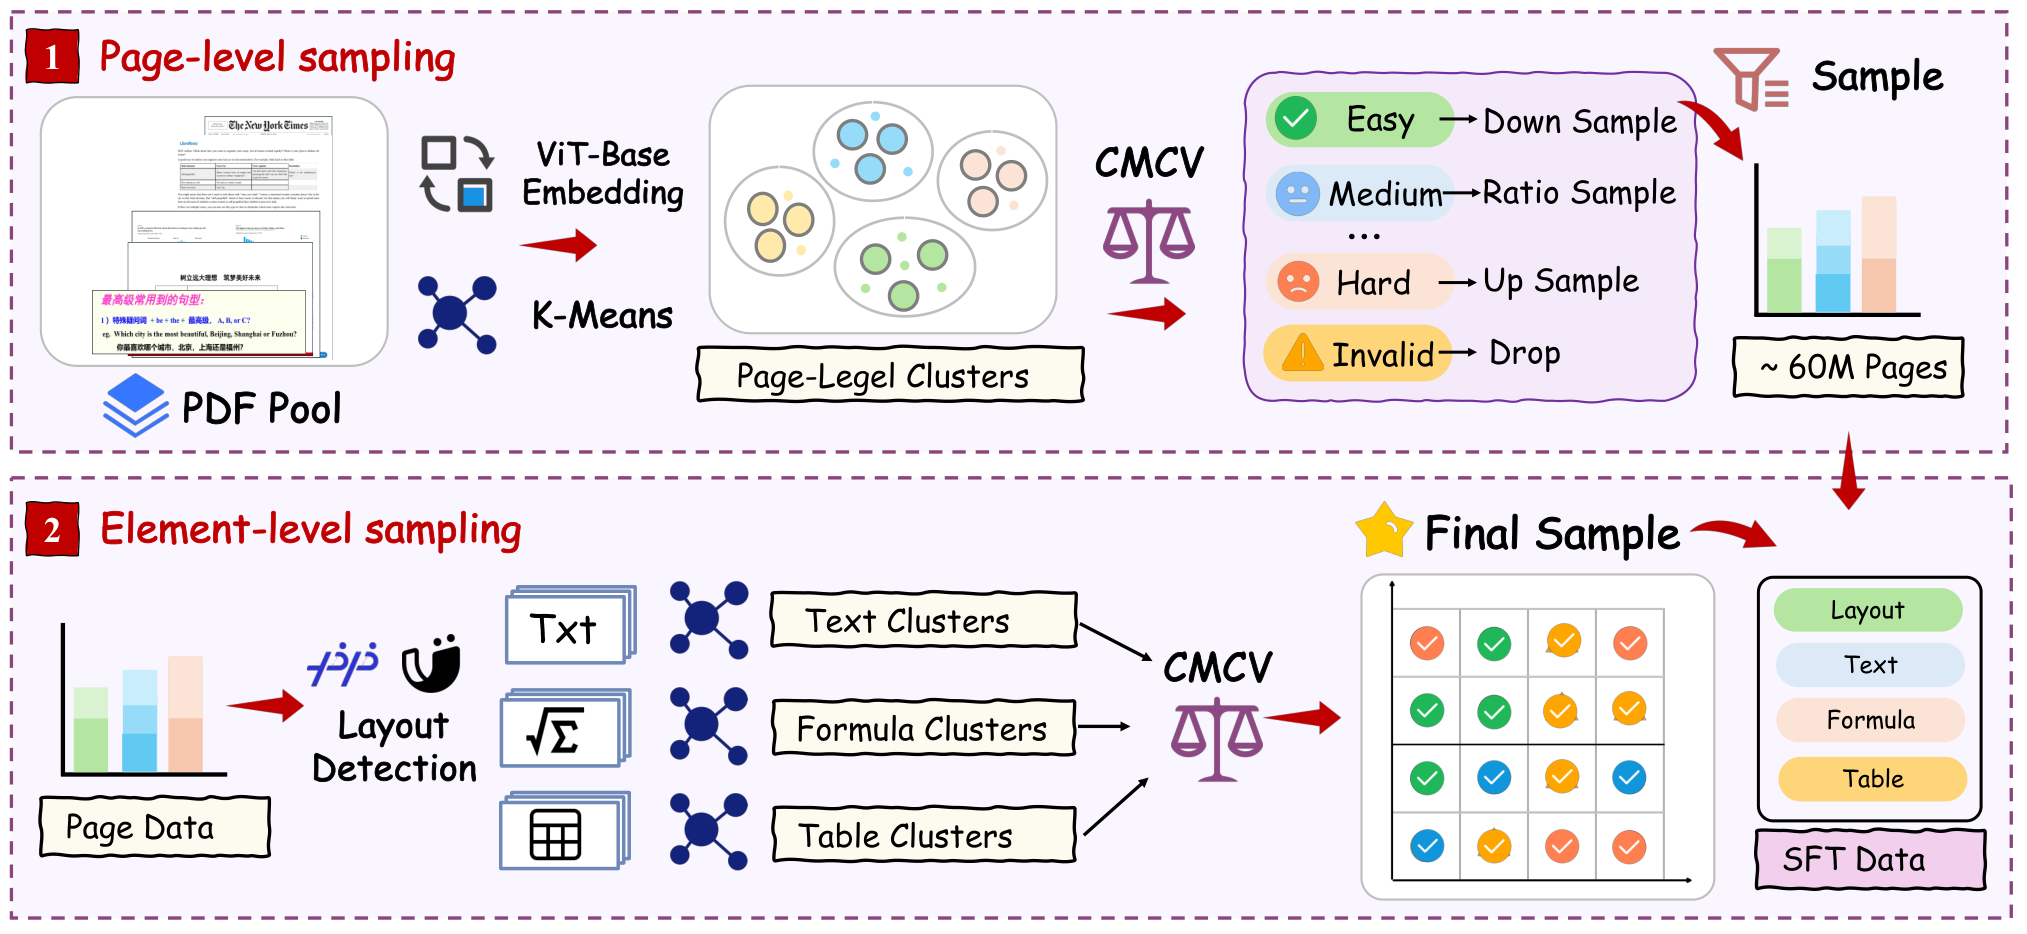
元素级把这些页拆成文本、公式、表格块,各自再聚类、再打难度。版面、文本、公式、表格四个子任务都有多样性和难度两个轴。大簇下调,小簇上调,Medium和Hard加权,最后拼成监督微调集。
三、CMCV三分难度与难样本修正
难度标签从哪来。MinerU2.5自己那套IMIC,还有PaddleOCR-VL-1.5的UACS,都是同一模型多跑几次看稳不稳。这只能看见自家的不确定,分不清是模型自己的盲区,还是谁都啃不动。
CMCV换成三家异构模型交叉核验。MinerU2.5、PaddleOCR-VL、Qwen3-VL-30B各跑一遍,文本看编辑距离,表格看TEDS,公式看CDM。
Easy,MinerU2.5至少和一家外部模型高度一致,标签可以直接用。
Medium,两家外部模型彼此一致,MinerU2.5却差得远,外部共识当伪标签,报告认为这批训练价值最高。
Hard,三家两两都对不上,共识给不出可靠标签。
Easy和Medium自动标注,大约6550万条,进第一阶段预训练。Hard要另走修补。
模型直接检查自己的LaTeX或HTML,容易自己给自己放行。公式和表格从结构化文本反推视觉长什么样,本来就难。他们改成先把LaTeX编译、HTML渲染成图,原图和渲染图成对送给判别模型。渲染会把漏掉的行列分隔符、没闭合的标签放大成版面乱掉,眼睛能看见。
判别和修正用的是Qwen3-VL-235B,故意不放进CMCV那三家,避免自己审自己。多轮仍修不好的,按修正效率和当前最弱的子任务分配人工额度。预标注用Gemini 3 Pro,同样不进CMCV池。最后留下19.2万条专家标注的Hard样本。
四、OmniDocBench v1.6上Full分95.69
结构仍是NaViT-675M加Qwen2-0.5B,从MinerU2.5的Stage 0检查点接着训。
第一阶段用6550万条Easy和Medium,文本2100万、版面1400万、公式1300万、表格1150万,外加600万图像分析。相对MinerU2.5 Stage 1每轮690万、跑两轮,体量大约一个数量级。Full分到94.29,单段涨了1.31分。
第二阶段用19.2万条Hard,再按子任务配回放。版面Hard与回放按6比1混合,文本1比50,公式1比25,表格1比10。版面难样本多、第一阶段已经较稳,回放可以少。文本难样本少,回放要多,免得把常见排版忘掉。学习率改成5e-5。Full到95.25,再涨0.96。表格TEDS从90.37到92.87,这一段主要补表。
第三阶段用GRPO,按组内相对好坏更新,不用另训价值网络。奖励直接用评测指标,文本编辑距离、公式CDM、表格TEDS、版面类别IoU。每条样本采16组,只留中等奖励区间。Full落到95.69,这一段再涨0.45分。公式CDM从96.48到97.29。
他们同时把评测协议升到OmniDocBench v1.6,修正了v1.5的元素匹配偏差,并加了296页Hard子集。Base 1355页,Full 1651页。匹配算法怎么改,留给OmniDocBench那篇,这里只看分数。
| 模型 | 参数量 | Full | Base | Hard |
|---|---|---|---|---|
| MinerU2.5-Pro | 1.2B | 95.69 | 96.12 | 94.08 |
| GLM-OCR | 0.9B | 95.15 | 96.19 | 92.01 |
| PaddleOCR-VL-1.5 | 0.9B | 94.87 | 95.72 | 92.01 |
| PaddleOCR-VL | 0.9B | 94.11 | 94.49 | 92.48 |
| MinerU2.5 | 1.2B | 92.98 | 93.23 | 91.65 |
| Gemini 3 Pro | 未公开 | 92.85 | 92.96 | 91.99 |
| Qwen3-VL-235B | 235B | 89.78 | 90.08 | 88.45 |
Full第一,95.69。Base上GLM-OCR 96.19,MinerU2.5-Pro 96.12,差0.07,标准页已经挤在一起。Hard上94.08,第二名是PaddleOCR-VL的92.48。HunyuanOCR从Base 92.45掉到Hard 82.69,掉了9.76分。MinerU2.5-Pro只掉2.04分。
阅读顺序Full上Youtu-Parsing的编辑距离0.116更好,MinerU2.5-Pro是0.120。手写公式HWE上Qwen3.5-397B拿到97.59,MinerU2.5-Pro是95.38。
中文公式子集上,原版MinerU2.5的95.50还略高于Pro的95.28。图像分析这条线报告自己承认,这版还没把数据引擎压上去。
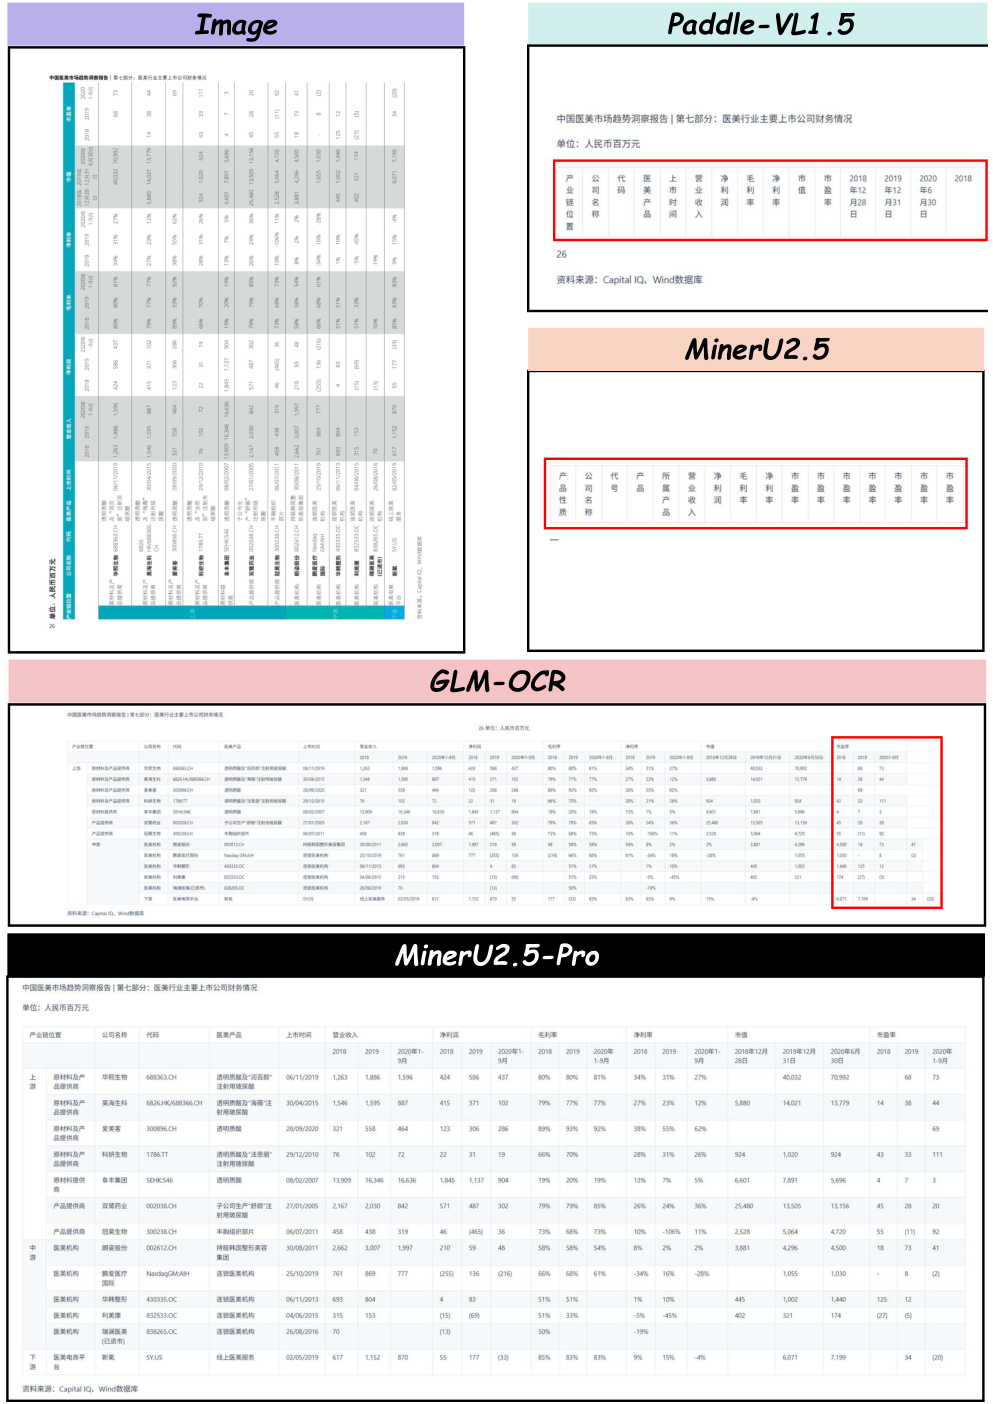
附录里旋转表格那组定性对比,PaddleOCR-VL、原版MinerU2.5、GLM-OCR都会错行或丢格,Pro把旋转结构和内容收回来了。
榜分测的是单页内容识别。附录另外写了截断段落合并、图表解析和表内图片。截断段落在相邻文本块边界上做合并不合并的二元判断,转Markdown时靠这个把碎段拼回去。
五、本地部署与推理实践
权重在Hugging Face,协议Apache 2.0。模型卡推荐vLLM,写明vllm-async-engine在一张A100上并发速度2.12 fps。封装用mineru-vl-utils,two_step_extract对应先版面后识别。
pip install "mineru-vl-utils[vllm]"
from vllm import LLM
from PIL import Image
from mineru_vl_utils import MinerUClient
from mineru_vl_utils import MinerULogitsProcessor  # if vllm>=0.10.1

llm = LLM(
    model="opendatalab/MinerU2.5-Pro-2604-1.2B",
    logits_processors=[MinerULogitsProcessor]  # if vllm>=0.10.1
)

client = MinerUClient(
    backend="vllm-engine", vllm_llm=llm,
    image_analysis=False
)

print(client.two_step_extract(Image.open("/path/to/page.png")))
几个值得留意的参数。image_analysis默认关,要解析图表再打开。vLLM不低于0.10.1时要挂上MinerULogitsProcessor。转Markdown用官方的json2md,它会按版面输出的合并标记把截断段落拼回去。跨页表格合并模型卡仍写着正在接入。
transformers后端的示例也在模型卡里,要求transformers不低于4.56.0,加载类是Qwen2VLForConditionalGeneration。
六、总结与思考
这篇报告把一次干净的对照做完了。1.2B不动,数据和配方换完,Full分到95.69。Base已经挤在小数点后,Hard才分得出谁在啃长尾。
CMCV把谁都不会和只有我不会分开,Medium直接拿外部共识当标签,这个分工很实用。Judge-and-Refine把渲染图塞回去,也比让模型在纯文本里自己反省靠谱。
短板写在纸上。标准页输给GLM-OCR一截,手写公式输给通用大模型,图像分析还没走完数据引擎,跨页表格合并到模型卡发布时仍未接入。文档内部的层级、图表和正文的绑定、跨页语义连续,报告把这些放到下一步,OmniDocBench也还测不到。
参考链接
- 论文原文 arXiv 2604.04771 v2,2026年4月
- 模型权重与推理示例 opendatalab/MinerU2.5-Pro-2604-1.2B
- 代码仓库 opendatalab/MinerU
- OmniDocBench榜单
- 对比方案 PaddleOCR-VL、GLM-OCR技术报告


 扫一扫


 156

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


