



(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:MonkeyOCR v1.5 Technical Report: Unlocking Robust Document Parsing for Complex Patterns
论文作者:金山办公追光AI Lab与华中科技大学(一作Jiarui Zhang)
发表时间:2025年11月13日
本文要点
(1)MonkeyOCR v1.5是金山办公追光AI Lab与华中科技大学2025年11月发布的文档解析系统,两阶段VLM先做版面和阅读顺序,再并行识别文本、公式和表格。
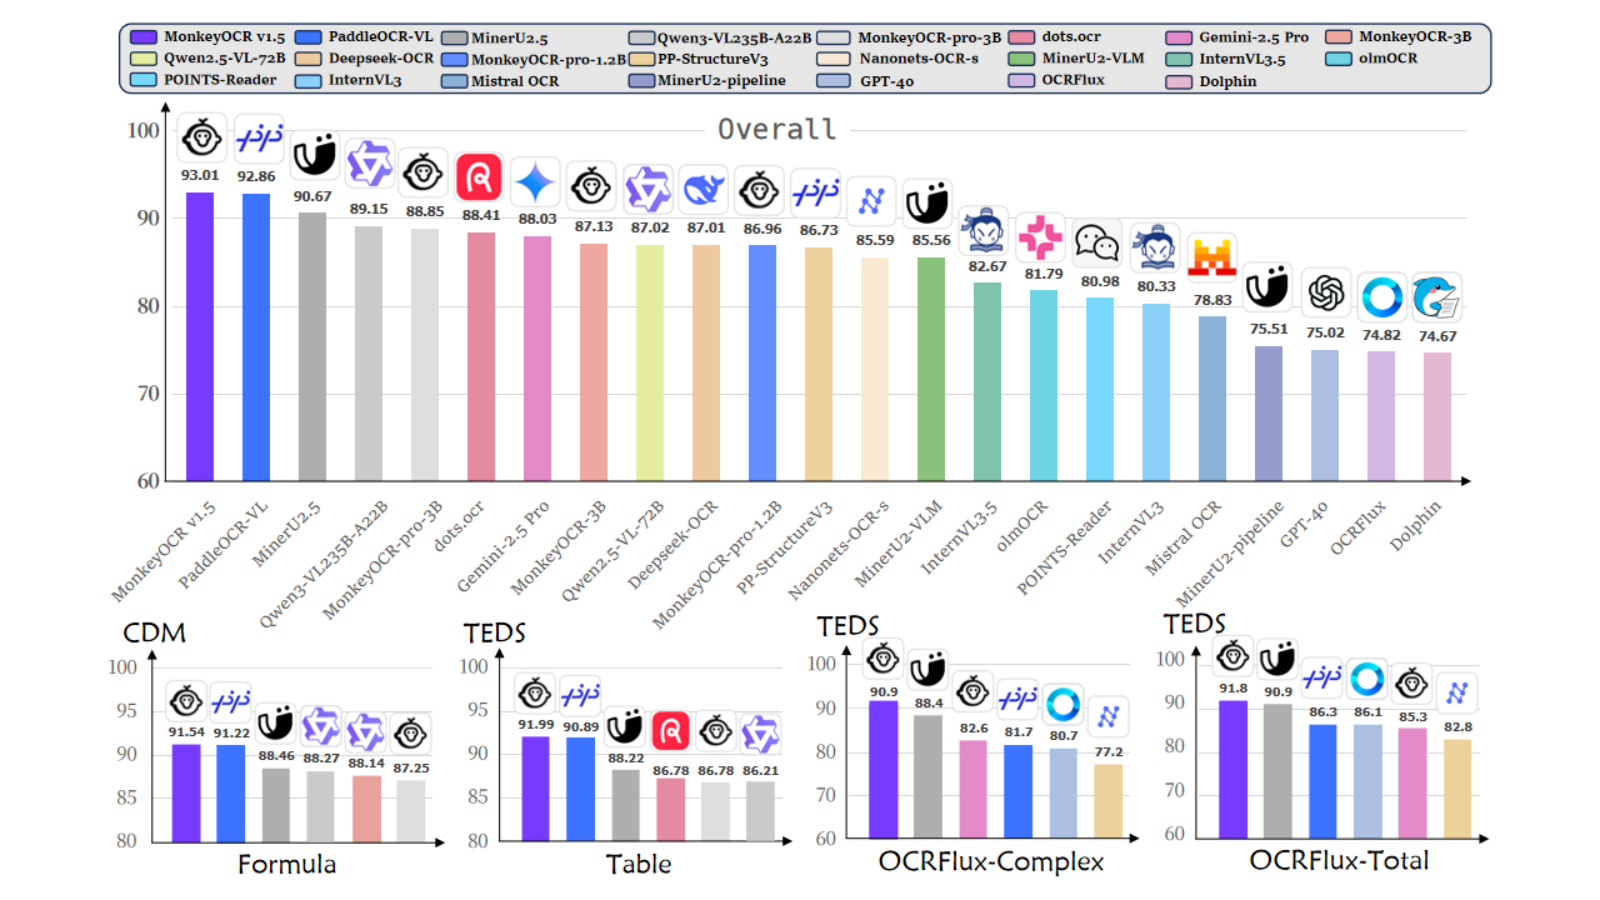
(2)OmniDocBench v1.5总分93.01,OCRFlux-complex表格TEDS 90.9,同一子集上PaddleOCR-VL是81.7。
(3)复杂表拆成三件事,渲染对照做强化学习,表内图先检测再占位,跨页跨栏续表按三种模式拼回去。
(4)短板是文本Edit和阅读顺序仍落后PaddleOCR-VL,简单表输给MinerU2.5,报告没给v1.5的参数量和消融。
(5)文末附官方安装与parse.py示例。公开可下的仍是pro系列,和报告里93.01那组数字对不上。
今天是2026年9月20日。我把arXiv 2511.10390的HTML版对了一遍,也看了GitHub仓库和Hugging Face上的权重卡。仓库News最上面已经是2026年7月的MonkeyOCRv2,这篇只读2025年11月那份v1.5技术报告。
金山办公追光AI Lab和华中科技大学,一作Jiarui Zhang。v1挂在11月13日,v2是16日。
复杂表是报告自己选的主战场。多级嵌套、格子里塞图、一张表被页眉或分栏切开,现成系统经常在这三类地方断掉。OmniDocBench v1.5总分93.01,只比PaddleOCR-VL高0.15。拉开差距的位置在OCRFlux-complex,表格TEDS到90.9,PaddleOCR-VL是81.7。
一、SRR三阶段收到两阶段流水线
初代MonkeyOCR走SRR。结构检测、内容识别、阅读顺序预测拆成三步,想少吃流水线的累积误差,也躲开整页一次喂进去把视觉token撑爆。v1.5把结构检测和阅读顺序收进同一段VLM,识别单独做第二段。
第一段看整页,一并给出每个区域的框、类别、阅读顺序编号,还带旋转角。第二段按框裁出来,转正,再按类别并行识别文本、公式、表格。同一套权重跑两段,图里画的是ViT加语言模型解码器。
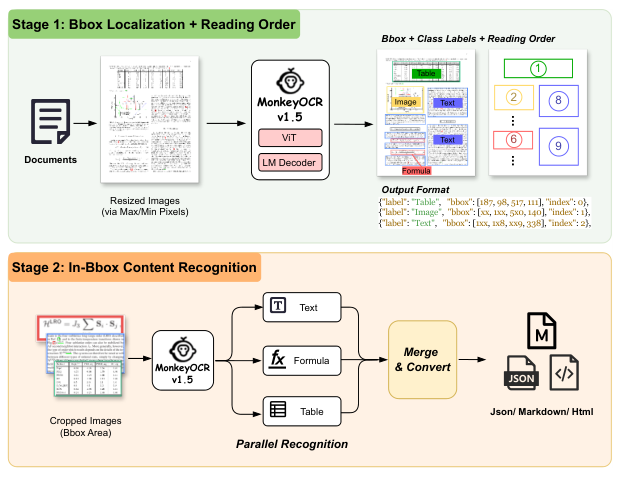
输出是约束解码后的JSON。字段就四类,框、顺序号、类别、旋转角。类别包括text、formula、table。裁切之后按标签分流,表格走tablebody这条识别头,最后按顺序号拼成整页Markdown或HTML。
旧版阅读顺序靠文本模型推断,报告说全局视觉上下文用不上。v1.5把顺序和框一起从画面里读出来,密栏报纸、多栏杂志这类版式才接得住。后面报纸和笔记两项,它也确实拿到了最好的编辑距离。
能力表比总分更能说明他们想补什么。表内图还原、跨页续表、跨栏续表、行被拦腰切开再续上,这几项里只有v1.5打满。
PaddleOCR-VL能还原表内图,跨页跨栏都不做。MinerU2.5和OCRFlux能并一部分跨页续表,并到重复表头和无表头为止,行拆分和跨栏没有。初代MonkeyOCR这几项全空。
二、视觉一致性GRPO与渲染对照
复杂表难标。单元格合并、嵌套、字体混排,人工HTML贵,用更强解析器造标签又脏。v1.5的办法是先让模型吐出表格,再把结果渲染成图,拿渲染图、原图、识别文本三件套去打分。
奖励模型是另一套VLM。正负样本两路来。一路改真值,造视觉上对不上的假表格。一路对微调后的识别模型多次采样,把错的和真值配成对。训练时奖励模型吃三元组,判断这份识别能不能把原表重建回来。
有了奖励模型再上强化学习。算法报告写成GRPO。图里画的是一组采样、组内相对优势,和DeepSeek那套Group Relative的计算方式对得上。报告英文展开写成了Generalized Reinforcement Policy Optimization,和常见展开不一致。
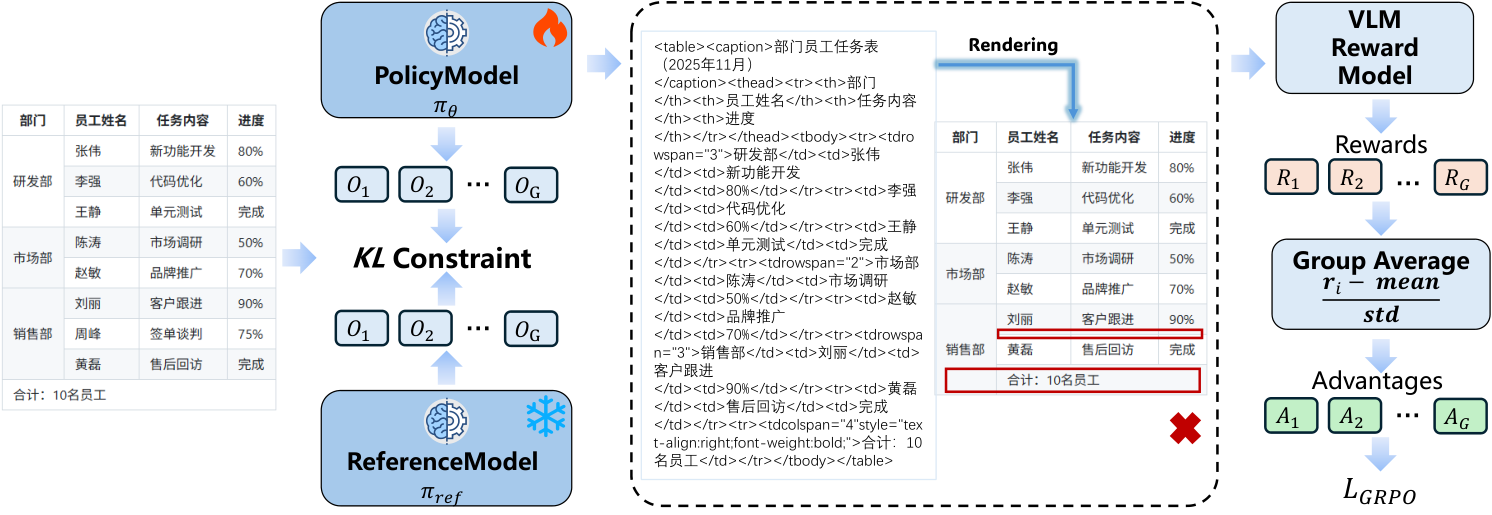
图里那张员工任务表把过程写死了。策略模型一次给出G个输出,冻结的参考模型在旁边卡KL。识别结果先变成HTML,再渲染回表格图。示例里刘丽那一行进度是90%,渲染出来变成了完成,直接打叉。VLM奖励模型给每个样本打分,再按组内均值和标准差做成优势,回传GRPO损失。
图注还写了规则检查和VLM奖励拼在一起。正文公式只留下reward = VLM(I^O, y, I^R),规则那一支没展开。渲染器用的哪套引擎,报告也没点名。能确定的是,无标注表格可以拿来继续训,不必再画一套精细HTML。
公式CDM在这张总图里排第一小格,v1.5拿到91.54,PaddleOCR-VL是91.22。CDM怎么定义,OmniDocBench原文已经写过,这里只记这个数。
三、表内图解耦与三类跨页续表
格子里嵌图,识别器容易把图当噪声,或者把整列读崩。他们把图和表拆开处理,模块名叫Image-Decoupled Table Parsing,短写IDTP。
先用YOLOv10在表格区域里检出内嵌图,按原尺寸盖上占位掩码,并留下编号到裁切文件的一一映射。掩码后的表再交给识别器。训练时多一个辅助目标,让模型把占位符当成原子token,中间HTML在对应位置写下图片标签。后处理按映射把原图填回去。
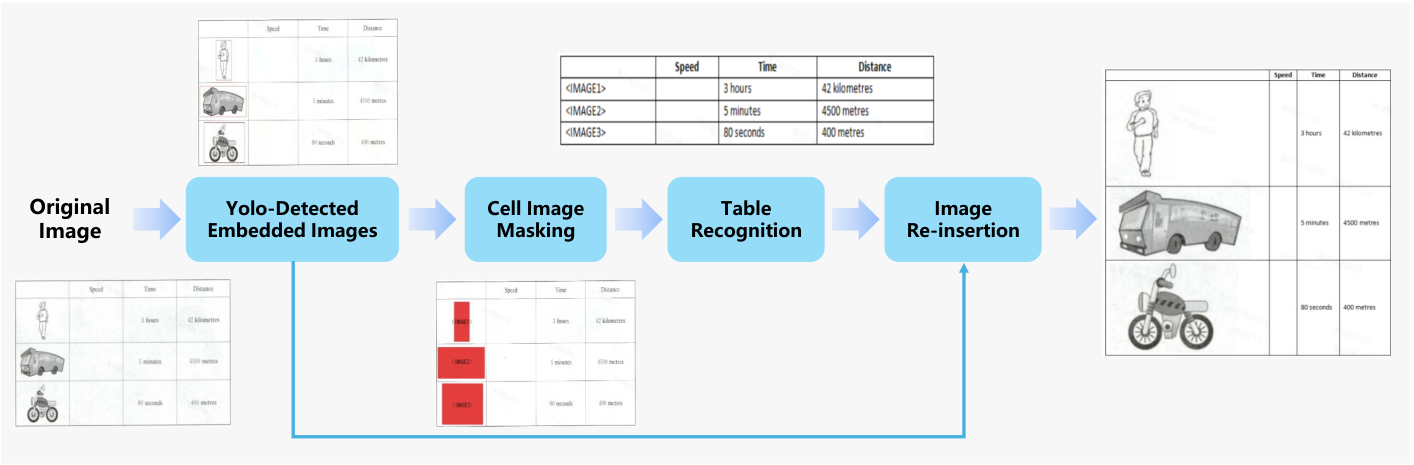
图里占位写成IMAGE1这类红块。正文说最终HTML用img标签。PaddleOCR-VL在能力表上也能做表内图检测和识别,MinerU2.5这一项是空的。定性对比里,MinerU2.5会把图丢掉,PaddleOCR-VL会出现多一列空列、表头单元格丢失。这些是报告对可视化样例的描述。
跨页和跨栏是另一件事。长表被排版切开以后,相邻碎片常见三种接法。
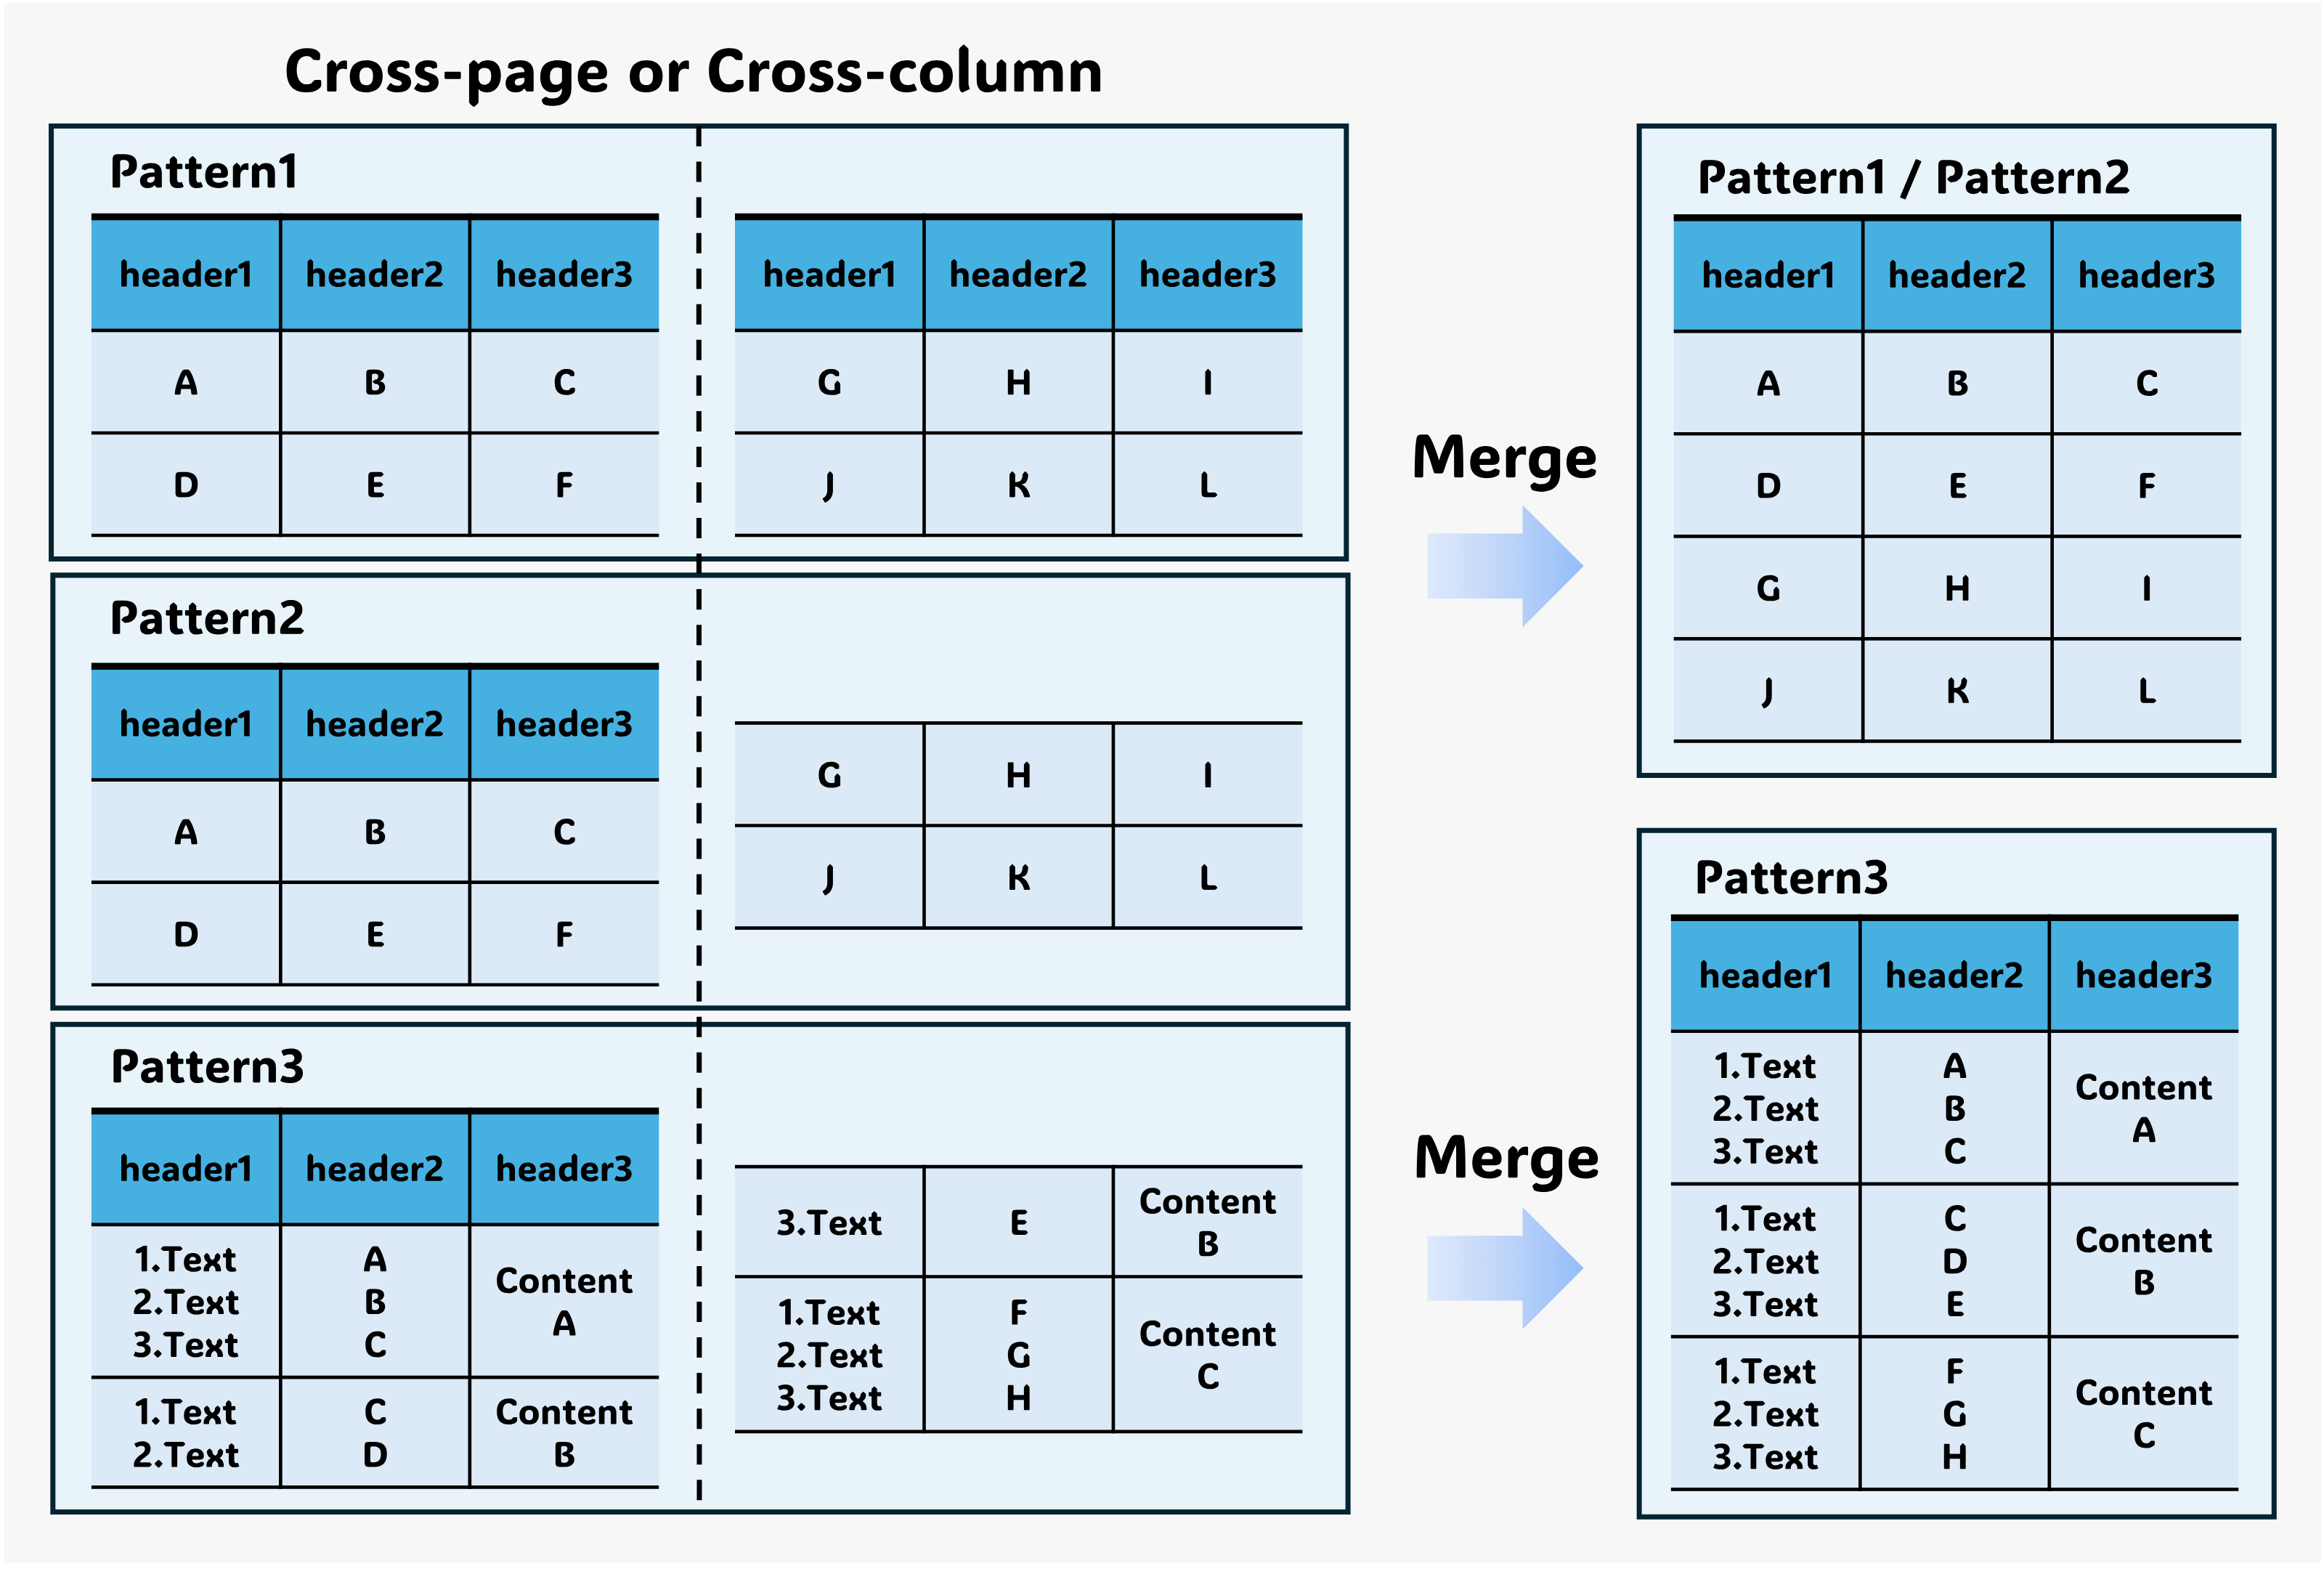
前两种最好认。后一段开头几行和前一段表头相同,就当重复表头的续表,删掉第二段表头再拼接,列还要对上。开头几行不同、断口处格子又没被切开,直接把表体接上,列结构保持原样。
还有一种更麻烦。某个单元格在断口处被劈成两截,得先把两段对应的跨度找回来并成一行,再拼接。
重复表头靠规则匹配,允许完全相同或近似相同。后两种靠一个BERT分类器,看后一段的首行是不是前一段末行的语义续写。判成续写就走行级合并,否则当无表头续接。合并时还要把各列对上、处理跨度冲突、把表头token规范化。BERT用的哪份权重,报告没写。
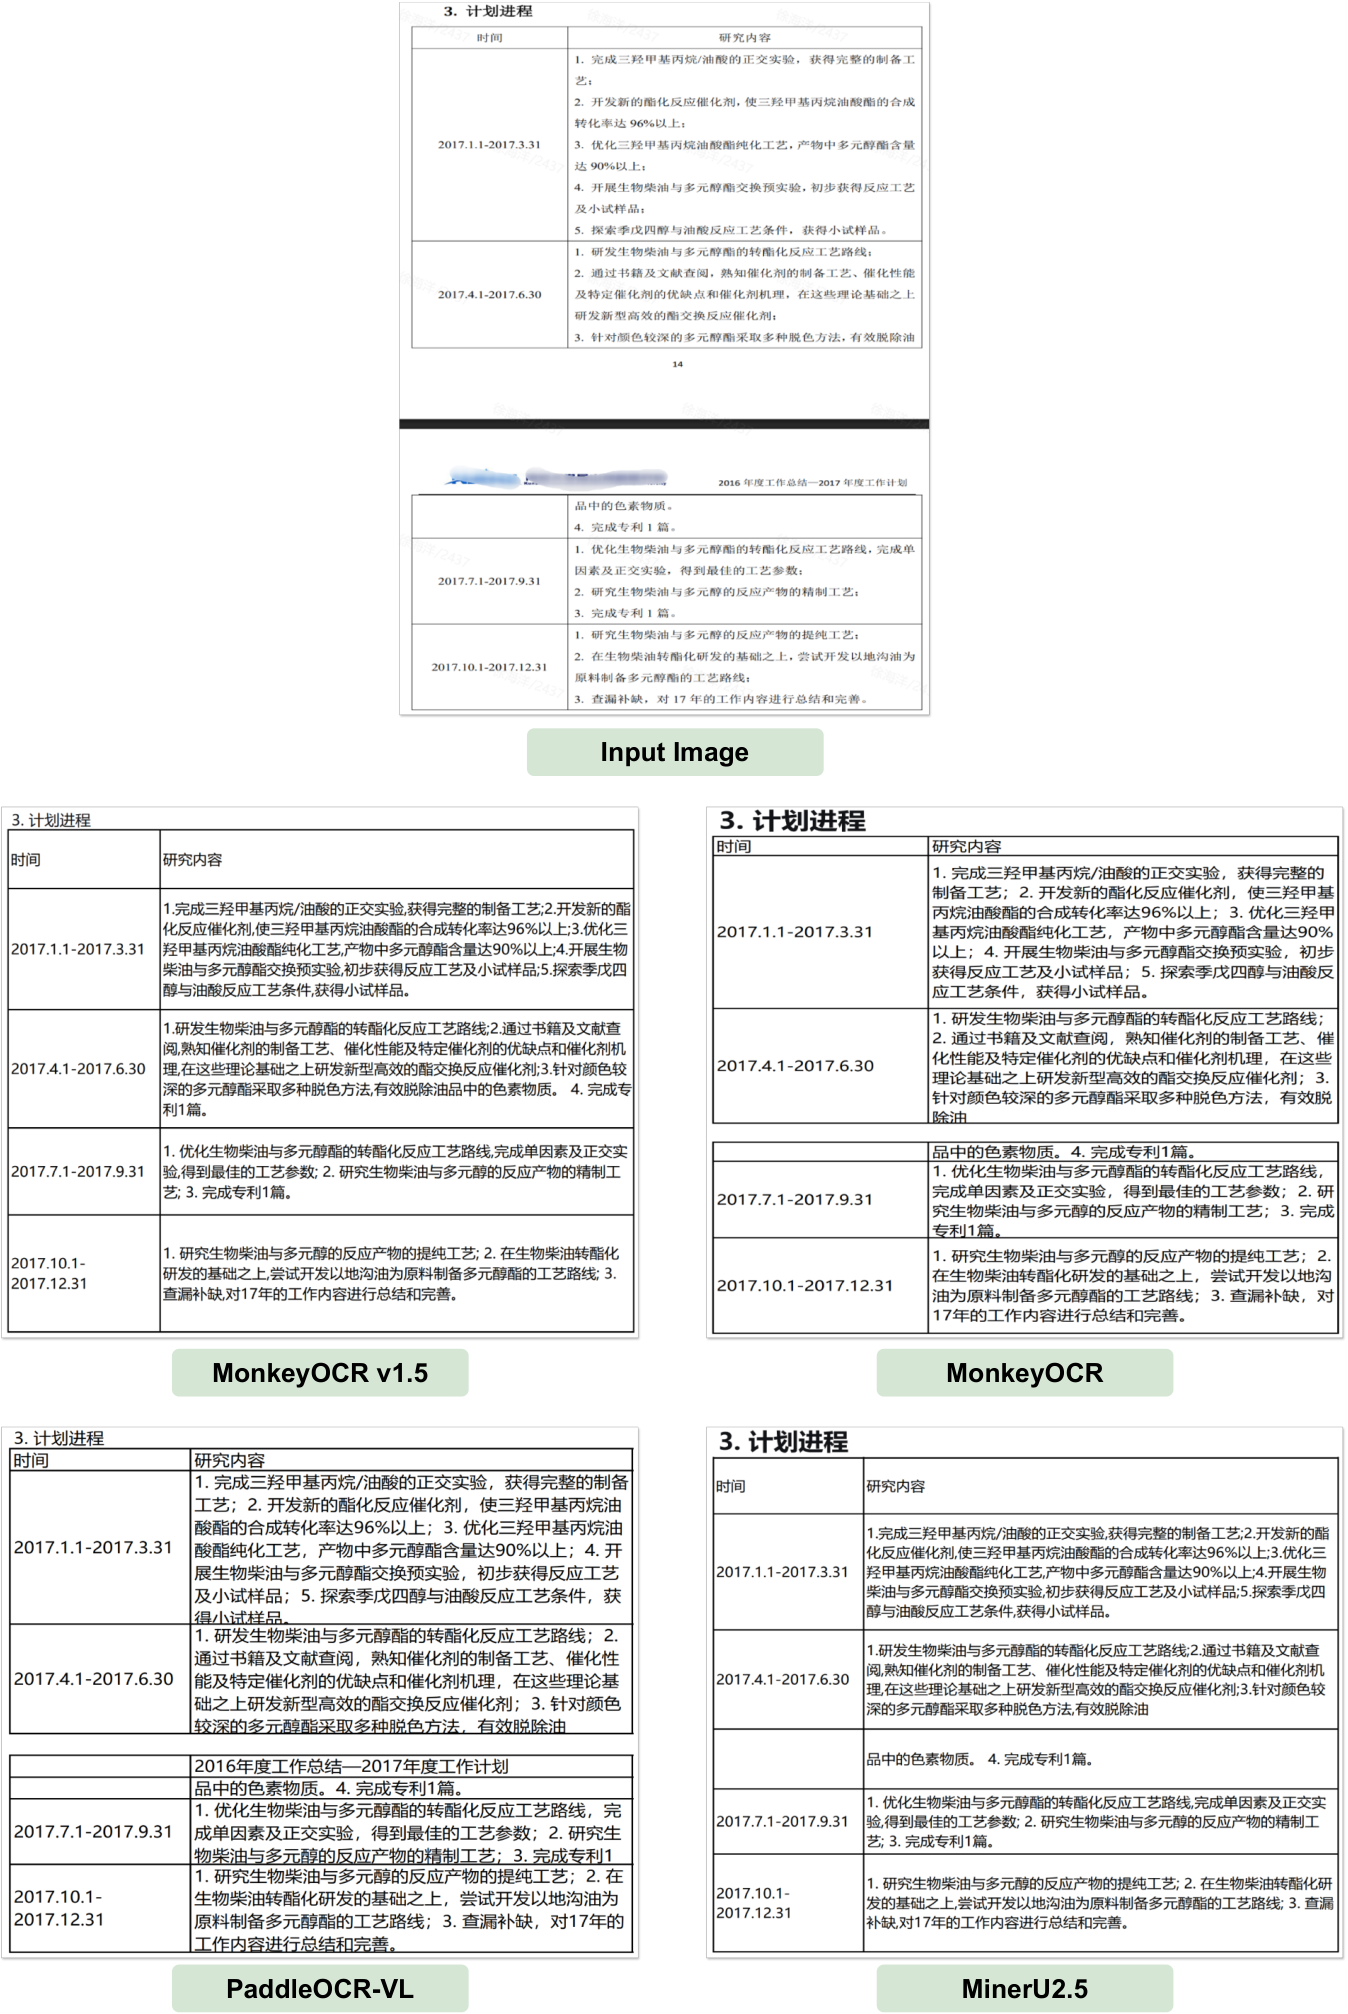
定性对比里有一张跨页计划表。原图在两页之间夹了一条页眉。MonkeyOCR v1.5把四段时间接成一张完整表。PaddleOCR-VL把页眉写进了表体。MinerU2.5第三行从色素物质半截起头,上一页没写完的格子没有接上。
四、OmniDocBench v1.5总分93.01
先把总表和复杂表放在一起。OmniDocBench v1.5是当时文档解析最常被引用的公开榜。表格TEDS把表当成树算相似度。OCRFlux-complex来自OCRFlux-pubtabnet-single的复杂子集。Edit越低越好。
| 模型 | Overall↑ | 公式CDM↑ | 表格TEDS↑ | OCRFlux-Complex | OCRFlux-Simple | 文本Edit↓ | 阅读顺序Edit↓ |
|---|---|---|---|---|---|---|---|
| MonkeyOCR v1.5 | 93.01 | 91.54 | 91.99 | 90.9 | 92.6 | 0.045 | 0.049 |
| PaddleOCR-VL | 92.86 | 91.22 | 90.89 | 81.7 | 90.7 | 0.035 | 0.043 |
| MinerU2.5 | 90.67 | 88.46 | 88.22 | 88.4 | 93.3 | 0.047 | 0.044 |
| MonkeyOCR-pro-3B | 88.85 | 87.25 | 86.78 | 未报告 | 未报告 | 0.075 | 0.128 |
| Qwen3-VL-235B | 89.15 | 88.14 | 86.21 | 未报告 | 未报告 | 0.069 | 0.068 |
| Gemini-2.5 Pro | 88.03 | 85.82 | 85.71 | 未报告 | 未报告 | 0.075 | 0.097 |
总分93.01,比PaddleOCR-VL高0.15,比MinerU2.5高2.34。公式和表格两项也是第一,表格TEDS比PaddleOCR-VL高1.10。这些零点几到两点,在已经挤满的榜上谈不上碾压。
复杂表那一列就不一样。OCRFlux-complex上v1.5拿到90.9,MinerU2.5是88.4,PaddleOCR-VL是81.7。第三节正文写成超出PaddleOCR-VL 9.2个百分点,和表4对得上。引言里同一对比写成8.2%,和表不一致,这里按表走。
简单表他们没有赢。OCRFlux-simple上MinerU2.5是93.3,v1.5是92.6。PubTabNet上v1.5是90.7,MinerU2.5是89.1,PaddleOCR-VL是85.2,这一项他们仍是第一。Nanonets、初代MonkeyOCR、OCRFlux在PubTabNet上未报告。
文本和阅读顺序两项,PaddleOCR-VL更低。文本Edit 0.035对0.045,阅读顺序0.043对0.049。v1.5没有拿下全部单项。
文档类型那张表,越低越好。报纸0.049、笔记0.059两项第一。
幻灯片0.034,dots.ocr和MinerU2.5都是0.029。学术论文0.029,MinerU2-VLM是0.010。教材0.071,MinerU2.5是0.050。财报0.023,dots.ocr是0.008。杂志0.032,和MinerU2.5并列,Gemini-2.5 Pro是0.016。
密栏报纸和笔记页,这套两阶段更稳。干净论文页和财报,别人仍有专长。
报告没有给出RL、IDTP、续表合并各自拿掉以后掉多少分。复杂表的9.2,无法拆成哪一块模块贡献了多少。
五、本地部署与推理实践
代码在Yuliang-Liu/MonkeyOCR,Apache 2.0。我查的时候仓库大约6600星。
Hugging Face官方卡是echo840/MonkeyOCR、echo840/MonkeyOCR-pro-3B、echo840/MonkeyOCR-pro-1.2B,另有一张pro-0.6B。没有单独叫MonkeyOCR-v1.5的权重仓库。
同一张OmniDocBench v1.5表里,MonkeyOCR-pro-3B总分88.85,v1.5是93.01。按官方脚本把pro-3B下下来,对不上报告里那组第一。
在线试用页在vlrlabmonkey.xyz:7685,README写最新模型可选,页上有没有v1.5这张卡,公开材料没有写死。
安装以仓库README指向的CUDA安装文档为准。当前推荐路径要先装PaddleX,再用LMDeploy当推理后端。官方内部测速排序是LMDeploy不低于vLLM,两者都远快于transformers。
conda create -n MonkeyOCR python=3.10
conda activate MonkeyOCR
git clone https://github.com/Yuliang-Liu/MonkeyOCR.git
cd MonkeyOCR

export CUDA_VERSION=126
pip install paddlepaddle-gpu==3.0.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu${CUDA_VERSION}/
pip install paddlex[base]==3.3.0
pip install langchain==0.3.26

pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cu${CUDA_VERSION}
pip install -e .
pip install lmdeploy==0.9.2
20系、30系、40系和V100上,LMDeploy可能报shared memory不足。官方补丁是python tools/lmdeploy_patcher.py patch,会改当前环境里LMDeploy的源码。3090上他们测过,打补丁后0.338页每秒,transformers只有0.015页每秒。
权重下载和推理命令出自仓库README。
pip install huggingface_hub
python tools/download_model.py -n MonkeyOCR-pro-3B
# 也可换成 MonkeyOCR-pro-1.2B 或 MonkeyOCR

python parse.py input.pdf
python parse.py input.pdf -o ./output
python parse.py input.pdf -s
python parse.py image.jpg -t table
-s按页拆结果。-t table只跑表格识别,输出Markdown。完整解析会写出三样东西,最终Markdown、画在原页上的版面PDF、带框和类别的中间JSON。本地Gradio是python demo/demo_gradio.py,默认7860端口。FastAPI是uvicorn api.main:app --port 8000。
仓库README把拍照件、手写、繁体、多语列成尚未完全支持。这是开源线的能力边界,不是v1.5报告里的实验结论。v1.5自己的参数量、训练数据规模、显存占用,报告都没写。
六、总结与思考
结构对不上,整张表就废了。单个格子认错,后面往往还能补。v1.5把结构这件事拆开处理。识别结果先渲染成图再和原图对,格子里的图先抠走再填回来。跨页跨栏要先判断接法,重复表头、无表头续接还是行被切开,拼法不一样。
我更看重渲染对照这条奖励。表格HTML的合法写法很多,字符串对不上不等于结构错了。把输出画回一张图,奖励才能跟阅读者看见的东西对上。无标注页也能继续训,这点对文档解析这种标注极贵的任务很实在。
短板同样清楚。总分只比PaddleOCR-VL高0.15,文本和阅读顺序还落后。简单表输给MinerU2.5。报纸和笔记第一,论文页和财报没有拿到第一。没有消融,就不知道视觉一致性RL、表内图解耦、续表合并各值多少分。公开权重也还停在pro系列,报告数字和可下载模型中间空着一截。
2026年7月已经有MonkeyOCRv2。若要复现这篇报告里的93.01和90.9,现成的download_model.py还不够。
参考链接
- 技术报告原文 arXiv 2511.10390 v2,v1于2025年11月13日,v2于2025年11月16日,HTML版
- 初代方法 MonkeyOCR SRR论文,2025年6月
- 代码仓库 Yuliang-Liu/MonkeyOCR,安装见 docs/install_cuda_pp.md
- 公开权重 echo840/MonkeyOCR、echo840/MonkeyOCR-pro-3B、echo840/MonkeyOCR-pro-1.2B
- 在线试用 vlrlabmonkey.xyz:7685
- OmniDocBench榜单
- 对比方案 PaddleOCR-VL、MinerU、OCRFlux


 扫一扫


 294

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


