AI辅助开发新体验,用自然语言对话快马平台定制专属卷积神经网络模型

Linux实战:rMATS可变剪切分析从零到一,避坑指南与结果深度解析 本文详细介绍了在Linux系统上从零开始部署rMATS进行可变剪切分析的完整流程,包括环境搭建、安装避坑指南、参数优化及结果解读。特别针对gfortran依赖、数学库配置等常见问题提供解决方案,并深入解析JC与JCEC结果的差异及可视化技巧,帮助生物信息学研究者高效完成可变剪切分析。 阅读详情

最近在做一个医学影像相关的项目,需要用到卷积神经网络(CNN)进行图像分割。传统的U-Net结构虽然经典,但面对我们特定的数据(比如分辨率极高或通道数特殊),直接套用效果总是不尽如人意,需要调整网络深度、宽度或者引入一些注意力机制。手动设计和调试这些网络结构,从写代码到跑通验证,耗时又费力,一个不小心,维度对不上就得调试半天。

就在我为此头疼的时候,我尝试了一种新的开发方式——利用AI辅助来定制我的卷积神经网络。整个过程就像和一个经验丰富的架构师对话,我描述需求,它来生成代码并解释原理,效率提升非常明显。今天就把这个体验和背后的思路梳理一下,分享给可能遇到同样问题的朋友。

  1. 从需求描述到代码生成:自然语言驱动的开发起点 整个过程始于一个明确的自然语言描述。我不需要先去查PyTorch的API文档,或者回忆卷积层、池化层的参数顺序,而是直接向AI描述我的核心需求。例如,我会说:“我需要一个用于肝脏CT影像分割的模型,输入是512x512的灰度图,输出是同尺寸的分割掩码。希望基于U-Net结构,但在编码器的下采样部分,每层之后加入一个SE注意力模块来增强特征表征。另外,由于数据量有限,希望初始的通道数可以小一些,比如从32开始。” 这个描述包含了任务类型(分割)、数据规格(512x512灰度图)、基础架构(U-Net)、定制化需求(加入SE注意力模块)和优化考虑(小通道数以应对小数据)。AI模型(比如平台集成的Kimi或DeepSeek)会解析这段描述,将其分解为多个可执行的子任务:构建编码器-解码器骨架、插入注意力模块、设置初始通道数、确保输入输出维度匹配等。

  2. 解析与生成:不仅仅是代码,更有设计意图的解读 很快,AI就会生成一套完整的PyTorch模型类代码框架。这不仅仅是代码片段的堆砌,而是一个结构清晰、可以直接运行或微调的项目雏形。更让我惊喜的是,它会为生成的关键代码段附上自然语言解释。 比如,在生成SE注意力模块的代码时,它会附带说明:“此处插入Squeeze-and-Excitation模块,首先通过全局平均池化获取通道级别的全局信息(Squeeze),然后通过两个全连接层学习各通道的重要性权重(Excitation),最后将权重乘回原特征图。这能让模型更关注信息量丰富的通道,可能提升对细微病灶的识别能力,但会略微增加计算量。” 对于编码器中的下采样部分,它会解释:“这里使用步长为2的3x3卷积进行下采样,而非最大池化。这样做可以在下采样的同时保留并学习更丰富的空间信息,但可能会使训练速度稍慢于池化操作。” 这些解释就像一位导师在旁白,让我清楚地知道每一行代码“为什么”要这么写,以及它可能带来的利弊。这对于学习网络设计和调试模型至关重要,尤其是对初学者或尝试新结构的开发者。

  3. 交互式优化:基于反馈的模型迭代 生成第一个版本的代码后,事情并没有结束。真正的AI辅助开发体现在持续的交互优化上。当我运行初步生成的模型,发现参数量过大,在目标设备上内存占用过高时,我可以直接给出反馈:“模型参数量太大,训练慢,且部署到边缘设备有困难。” 这时,AI不会简单地回复“减少层数”或“减少通道数”,而是会提供结构化的优化建议并生成修改后的代码。例如,它可能会建议:“可以考虑将标准卷积替换为深度可分离卷积。这将显著减少参数量和计算量,尤其适用于移动端或嵌入式场景,但可能会带来轻微的精度损失。以下是修改后的卷积块代码示例。” 它生成的修改代码会具体到将原来的 nn.Conv2d 替换为 nn.Sequential 包裹的 nn.Conv2d(深度卷积)和 nn.Conv2d(逐点卷积),并调整好输入输出通道。我还可以继续追问:“有没有在保持精度的前提下压缩模型的方法?”它可能会进一步提出知识蒸馏、剪枝或量化等建议,并给出相应的代码实现思路或关键步骤。

  4. 功能整合与项目构建:超越单文件的智能协作者 一个完整的CNN项目远不止一个模型定义文件。AI辅助可以扩展到整个开发流程。基于我的初始描述,它除了生成模型类(model.py),还可以建议并生成配套的数据加载与增强管道(dataset.py),里面可能包含针对医学影像的随机旋转、对比度调整等增强策略。同时,它也能生成一个基础的训练脚本(train.py),包含损失函数(如Dice Loss + CrossEntropy Loss对于分割任务很常见)、优化器设置以及简单的训练循环。 这意味着,通过几次自然语言对话,我就能获得一个可运行、可迭代的完整项目框架,极大缩短了从想法到原型的时间。AI在这里扮演的不是简单的代码补全工具,而是一个理解领域知识(如医学影像处理常用技巧、模型优化技术)并能进行综合应用的智能协作者。

  5. 实践中的体会与注意事项 在实际使用中,我总结了几个关键点。首先,需求描述要尽可能具体和结构化。模糊的描述会导致生成的代码过于通用或不符合预期。明确输入输出尺寸、任务类型、性能约束(速度、精度、模型大小)和已知的偏好结构(如“基于ResNet34”),能获得更精准的结果。 其次,要善用交互和反馈。不要期望第一次生成的代码就完美无缺。把它当作初稿,通过运行测试、分析性能瓶颈,然后给出具体的反馈(“第三层卷积后特征图尺寸计算有误”、“训练初期损失不下降”),AI才能提供更有针对性的优化。 最后,理解AI生成代码的逻辑至关重要。AI提供的解释是学习的绝佳材料。通过理解其设计意图,我能更好地掌握CNN架构设计的原理,未来即使脱离AI辅助,也能独立进行更自主的设计和调试。

这次利用AI辅助定制卷积神经网络的体验,让我深刻感受到开发方式正在发生变化。核心的创造性工作和问题定义仍然在开发者这里,但那些繁琐的、模式化的代码编写和知识检索工作,可以交给AI高效完成,让我们能更专注于架构设计和算法优化本身。

整个体验过程,我是在一个叫 InsCode(快马)平台 的网站上完成的。它比较好的地方是,打开网站就能直接用,不需要在本地安装任何Python环境或者PyTorch库,对于快速验证想法、做技术演示或者学习新模型结构特别方便。我只需要在它的AI对话区描述我的CNN需求,它就能理解并生成出对应的代码框架和解释。
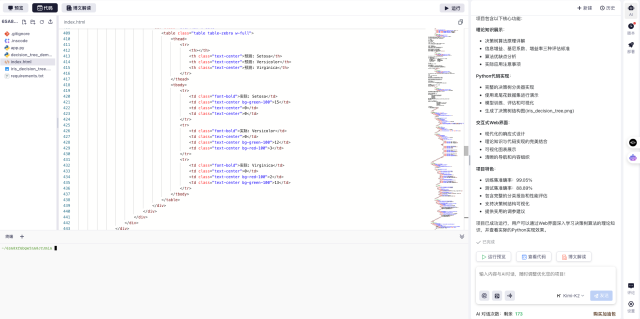
示例图片

而且,对于这类生成出来的、可以持续运行并提供服务或界面的项目(比如一个完整的训练脚本或一个带有简易前端展示的模型应用),平台还支持一键部署。这意味着我不需要自己去租服务器、配置Web环境,点一下就能把项目变成一个可以公开访问的在线应用或API服务,分享给同事查看效果或者集成测试都非常省心。
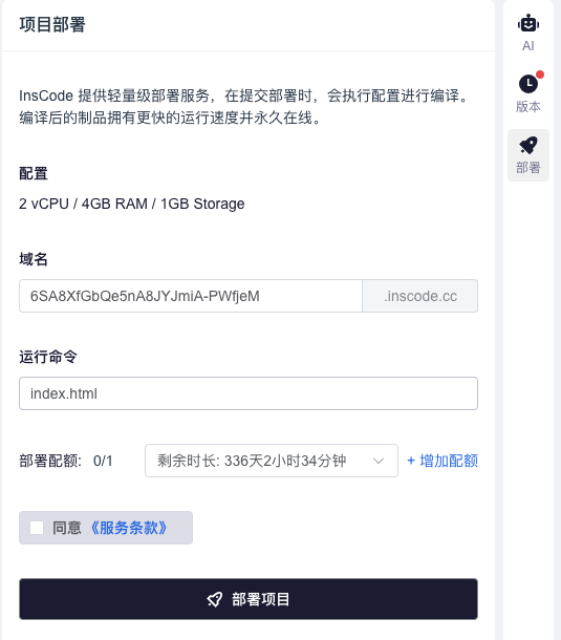
示例图片

对于像我这样经常需要快速原型验证的开发者来说,这种从“描述需求”到“生成代码”再到“部署演示”的流畅体验,确实把很多重复性的准备工作简化了,能更直接地聚焦在模型设计和算法本身。如果你也对AI辅助开发或者快速构建深度学习原型感兴趣,不妨去试试看,或许会有新的发现。

一文学会Inner-MPDIoU:YOLOv11边界框回归优化全解析 Inner-MPDIoU 凭借“辅助边框+最小点距离”的双重创新,成功解决了传统 IoU 损失在小目标、遮挡场景、位置偏差场景下的收敛和判别难题,为 YOLOv11 注入了更强的边框回归能力。从原理剖析到代码集成,本教程已为你铺就了一条“定位精度跃升”的实战路径。现在,不妨亲自上手尝试,让你的目标检测模型在各类数据集上都能交出一份“定位精准”的答卷——相信我,当你看到检测框完美贴合目标的那一刻,你会明白这份尝试的价值。我很乐意在你实践过程中帮你解决任何问题,让我们一起推动目标检测在边框回归领域的边界。 阅读详情

相关推荐

我想自己组装一台服务器,微调大模型通义千问2.5 Omni 72B,但是我是个人购买,资金非常有限,最省的方案

阶段动作✅ 推理用 GGUF + llama.cpp + 4090 加载 14B INT4✅ 微调训练 Qwen2.5-7B-Chat,使用 LoRA / QLoRA❌ 放弃Qwen2.5-Omni-72B 全量微调(显存需求 >160G,不现实)

AngelCryToo的专栏 2793

AI如何帮你快速搭建CNN模型?快马平台实战

增加了学习率调度器添加了TensorBoard日志记录修改了卷积核数量平台的内置编辑器有智能提示,修改起来非常顺畅。最棒的是可以实时看到代码变更的效果,不用反复运行调试。

ObsidianRaven13的博客 774

使用 Restart Extension 继续解决 Ansys 机械分析

您正在执行复杂或大型的多步有限元分析,突然,您意识到经过数小时的求解后,您需要添加或修改边界条件。在本篇博文中,您将了解如何利用 Ansys Mechanical 中的 RestartAnalysis 扩展来扩展多步分析,方法是合并额外的时间步骤和边界条件,而不会丢失已计算的结果。幸运的是,在 Mechanical 中,有一种直接的方法可以实现这一点,而不会损害您之前的结果,而这在添加新边界条件和使用重新启动点时经常发生。得到的结果符合预期,您可以看到施加的力产生的这两个部分之间的相对位移。

jkh920184196的博客 1223

用AI快速构建CNN模型:快马平台实战指南

但在快马平台,只需要用自然语言描述需求,AI就能生成完整项目代码。我简单说明了想用CIFAR-10数据集做图像分类,需要包含数据增强和评估功能,系统很快就给出了可运行的项目框架。从项目生成到训练部署,所有流程都能在浏览器里完成,连GPU资源都自动分配好了。我这样没有深厚机器学习背景的人,也能轻松实现专业级的模型开发,这种感觉实在太棒了!不需要纠结环境配置,不用手动处理繁琐的代码细节,只要清楚地描述需求,就能获得可立即运行的项目。这些原本需要几十行代码的操作,现在都自动完成了,省去了大量查文档的时间。

SunstoneLion34的博客 697

CANoe实战:LIN Slave一致性测试全流程解析

本文详细解析了使用CANoe进行LIN Slave一致性测试的全流程,包括测试概述、环境搭建、模块集成、测试用例详解及报告分析。通过实际案例分享,帮助工程师掌握LIN 2.0/2.1/2.2、SAE J2602和ISO 17987等标准的自动化测试方法,提升汽车电子从节点的可靠性和兼容性验证效率。

weixin_42665725的博客 527

MacOS上VScode配置PlatformIO Core的疑难杂症与提速实战

本文详细解析了在MacOS上使用VScode配置PlatformIO Core时遇到的安装卡死、新建项目缓慢等常见问题,并提供了官方脚本安装、网络优化、命令行预下载等实用解决方案。通过环境变量配置和镜像源加速,大幅提升开发效率,特别适合ESP32等嵌入式开发场景。

weixin_42567046的博客 217

1小时打造CNN原型:快马平台极速验证AI创意

上,从零开始到可演示的CNN原型,实际编码时间不到40分钟。特别是部署环节,点击按钮就直接生成可分享的演示链接,省去了传统方式配置服务器的麻烦。对于需要快速迭代的AI项目,这种效率提升是决定性的。在探索AI创意的过程中,快速验证想法的可行性往往比完美实现更重要。内置的Python环境开箱即用,还能随时切换不同版本的运行环境做对比测试。通过简单的HTML+CSS布局,配合Python后端的Web框架,实现了无需额外部署的即时演示效果。最惊喜的是这些功能都不需要自己安装依赖,平台已经预装了常用库。

NightshadeEagle34的博客 829

睿尔曼超轻量仿人机械臂--机械臂接口介绍

本文介绍了睿尔曼超轻量仿人机械臂的控制器接口及末端接口。

realman_Rop的博客 3420

用AI加速卷积神经网络开发:快马平台实战

明确需求描述:给AI的指令越具体,生成的代码越符合预期分阶段验证:先生成基础框架,再逐步添加复杂功能善用注释:AI生成的注释很有价值,能帮助理解代码逻辑适度调整:生成代码后,可以根据实际需求进行优化对于想快速入门深度学习的朋友,我强烈推荐试试InsCode(快马)平台。它不仅让复杂的CNN开发变得简单,还能一键部署模型,省去了大量环境配置的麻烦。我的实际体验是,从零开始到拥有可用的图像分类API,整个过程不到1小时,这在以前简直不敢想象。

BlackStone33的博客 614

Windows下CMake的下载与安装详解

目录一、CMake介绍二、CMake的下载与安装 一、CMake介绍 CMake是一个跨平台的安装(编译)工具,可以用简单的语句来描述所有平台的安装(编译过程)。它能够输出各种各样的makefile或者project文件,能测试编译器所支持的C++特性,类似UNIX下的automake。 二、CMake的下载与安装 CMake下载链接:https://cmake.org/download/。 下载最新稳定版即可(Latest Release): 下载完成后,单击“Next”按钮,在下图中勾选“I acce

Wendy的博客 8万+

方法二:旋转机械动平衡精度计算

本文以实际案例为基础,系统阐述基于ISO 1940标准的动平衡精度G GG等级计算方法。通过角速度转换、许用剩余不平衡量e p e r e_{per}e per ​ 推导及G GG等级公式应用,结合惯性力偶矩、转子质量等参数,得出某转子系统的动平衡精度为G 40 G40G40。文中详细解析了公式原理与参数单位转换要点,并附完整ISO 1940动平衡等级参考表,为工程师提供从理论到实践的完整解决方案。研究结果表明,该方法可有效量化旋转机械的平衡精度,适用于风机、泵类等中低速设备的设计与调试,对提升设备运行

weixin_46153372的博客 915

快马AI平台:一键定义和部署你的机器学习模型

预定义模型架构:快马平台提供了多种主流模型架构,如CNN(卷积神经网络)、RNN(循环神经网络)和Transformer等,用户可以根据需求快速选择合适的架构,省去了从头开始构建的繁琐过程。自定义参数和层结构:平台支持用户灵活调整模型的参数和层结构,无论是修改神经元数量、添加新的网络层,还是调整激活函数,都可以通过简单的操作完成。AI辅助代码生成:集成Kimi-K2和DeepSeek等AI模型,平台能够根据用户的需求自动生成高质量的模型代码。这对于不熟悉底层实现的开发者来说,是一个巨大的便利。

SilverfoxOwl19的博客 1021

ransac拟合2D圆(三点定圆 c++详细版)

RANSAC(Random Sample Consensus,随机采样一致性)算法是一种基于随机采样的迭代算法,主要用于从一组包含大量噪声和异常值(外点)的数据中估计数学模型的参数。

twnkie的博客 1040

AI辅助开发新体验:让快马AI成为你研读OpenCode的智能导师

整个过程下来,感觉就像有位经验丰富的同事坐在旁边,随时解答我的疑惑,还能给出专业的改进思路,对于想要深入钻研某个技术领域或开源项目的开发者来说,这确实是一个很实用的工具。为了更进一步,我基于AI已分析过的代码,提出了一个具体的优化需求:“请建议一种性能优化方案,例如引入早停法(Early Stopping)或学习率调度(Learning Rate Scheduler),并生成相应的代码修改示例。集成了AI辅助开发的功能,就想着能不能让AI来当我的“智能导师”,帮我拆解和分析这个项目。

NightshadeEagle34的博客 210

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

AI辅助开发CNN:让快马平台AI为你设计和优化卷积神经网络模型

比如输入"需要识别5种花卉,图片尺寸224x224,希望模型轻量化",AI会推荐使用类似MobileNetV3的架构,并说明选择理由:深度可分离卷积节省计算量,适合移动端部署。数据不足是常见问题。特别的是,它能根据类别数量平衡建议增强幅度,比如样本少的类别增强幅度更大。作为一个经常和图像分类打交道的开发者,我发现传统的手动调参和架构设计实在太耗时了,直到尝试了AI辅助开发,效率直接翻倍。AI不仅提供代码,还会用注释解释每个模块的作用,比如为什么在某层后添加BatchNorm,这对学习模型设计思路很有帮助。

AmberLeopard26的博客 196

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

零代码玩转CNN:用快马AI平台5分钟搭建图像识别应用

最惊喜的是部署环节,不需要处理Nginx配置或购买云服务,直接获得可分享的演示链接。对算法工程师来说,这种低代码方式特别适合快速验证idea,把节省的时间留给核心算法优化。能直接用AI生成可运行的CNN项目代码,整个过程就像搭积木一样简单。记录下这个超实用的开发体验,尤其适合需要快速原型验证的朋友。标签自动one-hot编码,处理我的自定义数据集也没报错。batch_size建议从32开始尝试,太大容易爆显存。最近工作中需要快速验证一个图像分类方案,偶然发现。以前搭建CNN至少要配置半天环境,现在用。

SilvermistFalcon19的博客 926

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

传统开发vsAI辅助:CNN模型开发效率对比

的一站式体验——从AI生成代码到直接运行调试都在浏览器里完成,连我最头疼的环境配置都省了。特别是训练完点击部署按钮就能生成可对外提供服务的API,这种流畅感是传统开发难以比拟的。为了公平对比,我设定了相同的项目目标:构建一个能识别10类常见物体的CNN模型,使用相同的数据集(CIFAR-10)和评估指标。| 代码行数 | 280 | 150 || 环境配置难度 | 高 | 无需配置 || 评估维度 | 传统开发 | AI辅助开发 |

SilverfoxOwl19的博客 954

CNN开发效率对比:传统vs快马AI编程

最惊艳的是能直接部署测试模型效果,不用折腾环境配置。| 架构搭建 | 3小时 | 0.13小时 | 23倍 || 参数调试 | 6小时 | 1.5小时 | 4倍 || 性能优化 | 4小时 | 0.75小时 | 5.3倍 || 文档编写 | 2小时 | 0.25小时 | 8倍 || 环节 | 传统方式耗时 | 快马平台耗时 | 效率提升 |

SilvermistRaven28的博客 742

AI辅助开发:让快马平台的Kimi帮你实现CNN与Transformer的融合模型

传统CNN通过卷积核的局部感受野提取特征,但对于相隔较远的特征关联性捕捉不足。比如当我对Transformer的位置编码设计有疑问时,直接通过平台的智能对话功能就能获得优化建议,还能自动生成符合PyTorch最新API规范的代码片段,省去了反复查文档的时间。这个想法源于我在做细粒度图像识别时遇到的瓶颈——传统CNN模型在捕捉长距离依赖关系上表现有限,而Transformer虽然擅长这个,但计算开销又太大。完成开发后,不需要折腾服务器配置,直接就能把训练好的模型部署成可交互的演示应用,方便快速验证效果。

SapphireOwl29的博客 29

解密Logits:如何用快马AI平台5分钟打造智能分类器

在实际应用中,我们既需要关注最终的分类概率,也需要查看原始logits值来分析模型的决策过程。logits是模型输出的原始预测值,直接反映了模型对各个类别的置信度。最棒的是,平台提供了一键部署功能,几分钟就能把开发好的应用发布上线,完全不需要操心服务器配置和环境搭建的问题。后端接收到图片后,首先进行必要的预处理(如尺寸调整、归一化等),然后输入CNN模型获取logits输出。在实际部署时,可以考虑模型量化、缓存机制等优化手段。可以设计一个调试模式,输出模型各层的特征图和注意力权重,帮助理解模型的决策过程。

GoldEagle19的博客 651

用AI一键生成ResNet50代码:快马平台实战

ResNet50的核心在于残差连接的设计,有效解决了深层网络的梯度消失问题。主要包含多个残差块,每个块内部采用1x1、3x3、1x1的瓶颈结构,既能保持性能又减少了参数量。

AgatePanther34的博客 926

如何用AI快速构建神经网络模型?快马平台实战指南

对于刚入门深度学习的朋友,这种"描述需求-生成代码-可视化结果"的闭环开发方式,比传统调试方法友好得多。关键是所有步骤都在同一个平台完成,避免开发环境配置的"地狱难度"初体验。最惊喜的是部署体验——训练好的模型可以直接发布为在线API。点击部署按钮后自动生成访问链接,省去了服务器配置的麻烦。对于需要演示的课程项目或技术分享,这个功能实在太实用了。下面以图像分类任务为例,分享我的实践过程。特别省心的是自动划分训练集/测试集的功能,避免手动写数据拆分逻辑。预测接口封装成可直接调用的函数,方便后续集成。

SilvermistFalcon19的博客 590

传统CNN开发vs快马AI生成:效率对比实验

AI辅助开发显著提升效率:对于常见的深度学习任务,使用AI生成代码可以节省大量重复性工作,让开发者更专注于问题本身而非实现细节。适合快速原型开发:当需要快速验证想法或构建原型时,快马平台是极佳的选择。生成的代码质量足够用于初步验证和演示。学习辅助工具:生成的代码可以作为学习参考,帮助理解CNN的标准实现方式,比自己从头摸索更高效。仍需人工优化:虽然AI生成的代码已经很好,但对于特定需求或性能优化,仍需要人工调整和优化。

AmberLeopard26的博客 1021

利用快马平台ai辅助,五分钟搭建你的第一个卷积神经网络cnn模型

首先需要加载MNIST数据集,这个数据集包含6万张28x28像素的手写数字图片。通过平台内置的torchvision工具,可以一键下载并自动完成数据预处理。对于想快速验证模型效果的情况,还可以直接点击部署按钮,把训练好的模型变成可交互的演示应用。的AI辅助功能可以快速搭建基础模型,特别适合像我这样的初学者。建议刚开始学深度学习的朋友都可以试试这种方式,既能快速看到成果,又能通过阅读生成的代码学习标准实现。上,类似的AI辅助项目还有很多模板可以参考,确实大大降低了入门门槛。

StarfallRaven13的博客 20

3步玩转MNIST:用快马AI平台零代码构建手写数字识别系统

传统方式需要半天的工作量,现在喝杯咖啡的时间就能看到运行效果。特别推荐给需要教学演示或项目原型开发的同行,这种低门槛的AI应用开发方式确实能节省大量重复劳动。这个经典数据集包含了6万张训练图片和1万张测试图片,每张都是28x28像素的灰度图。整个过程完全不需要配置环境或调试依赖包,点击部署按钮就能获得可分享的在线应用。我在手机上测试发现,识别准确率能达到98%以上,响应速度也非常快。特别方便的是,平台会自动保存最佳模型权重,省去了手动设置检查点的麻烦。上,不写一行代码就完成数字识别应用的。

GoldenleafLynx28的博客 991

用Grad-CAM可视化模型决策:AI辅助深度学习的秘密武器

Grad-CAM是一种基于梯度的类激活映射技术,它通过计算目标类别对最后一个卷积层特征图的梯度,生成热力图来展示模型关注的重点区域。这种方法不需要修改模型结构,适用于大多数CNN架构。

AgatePanther34的博客 588
上一篇: 新手友好:通过快马平台生成的Touchgal示例项目轻松入门移动手势开发
下一篇: Nano-Banana惊艳效果展示:电子产品爆炸图与组件清单AI生成
AmberLeopard26
博客等级 码龄2年 705粉丝 4121原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

AmberLeopard26

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值