解密Prompt系列37. RAG之前置决策何时联网的多种策略

Python原生RAG实战:从文档切分到向量检索的生产级实现 RAG(检索增强生成)是一种将外部知识库与大语言模型动态结合的关键技术,其核心原理在于通过语义检索精准定位相关片段,再注入提示词引导模型生成可靠回答。技术价值体现在突破大模型固有知识边界、降低幻觉风险、支持私有数据闭环。典型应用场景包括政务知识中台、企业合同智能审查、制造业设备手册问答等需高准确率与强溯源能力的领域。本文聚焦Python原生实现路径,深入解析pdfminer.six文档解析、DynamicChunker动态分块、Qdrant向量存储与混合查询等关键环节,拒绝黑盒封装,直击生产环境中召回率暴跌 阅读详情

前言

之前我们分别讨论过RAG中的召回多样性,召回信息质量和密度,还有calibration的后处理型RAG。前置判断模型回答是否要走RAG的部分我们之前只提及了自我矛盾和自我拒绝者两个方案。这一章我们再补充几种RAG前置判断方案。

每种方案我们会挑1篇论文并主要关注论文中检索决策相关的部分,方案包括微调模型来决策,基于模型回答置信度判断,基于问题KNN判断,以及使用小模型代理回答等方案。各类方案分类汇总在本文末尾~

模型微调

  • SELF-RAG: LEARNING TO RETRIEVE, GENERATE, AND CRITIQUE THROUGH SELF-REFLECTION
  • When to Retrieve: Teaching LLMs to Utilize Information Retrieval Effectively

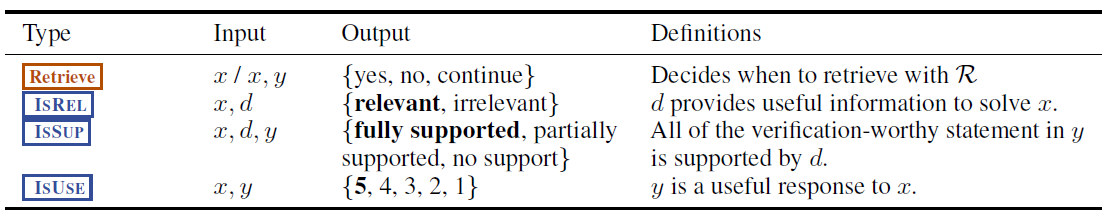
SELF-RAG是基于微调,来动态判断下一个文本段是否需要进行RAG的方案。论文定义了如下4种和RAG相关的反思特殊字符
image

这里我们核心关注的就是【Retrieve】字符,负责决策下一句推理前是否要进行检索增强的。
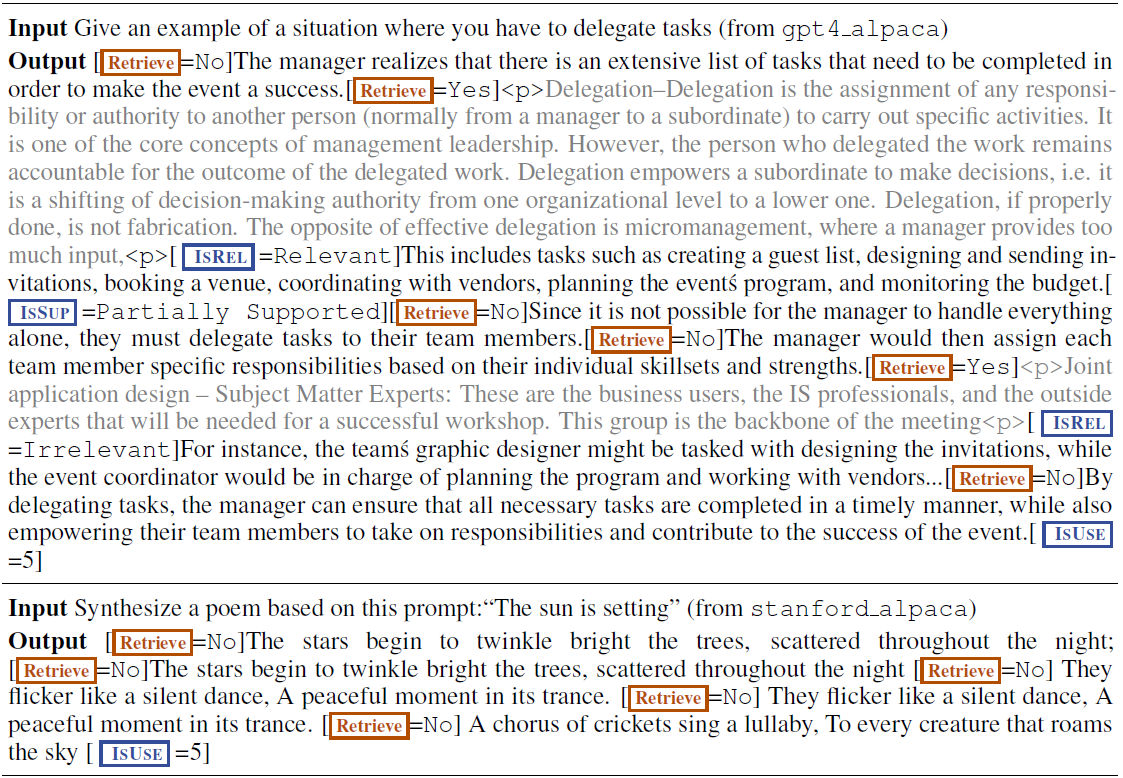
既然是微调方案,那就核心说一下有【Retrieve】标签和检索内容的训练样本是如何构造的,样本格式如下,
image

为了得到上面Interleave的样本, 其实可以直接使用GPT4进行标注,只不过论文考虑GPT4的推理成本太高,因此基于GPT4标注的4K样本,微调了Llama2-7B的模型,然后使用7B的Critic模型标注了更大量级的20K样本用于训练Generator。我们来看下Interleave样本的标注流程,以及【Retrieve】标签标注的相关Prompt,基于原始数据输入输出,对输出部分进行以下操作

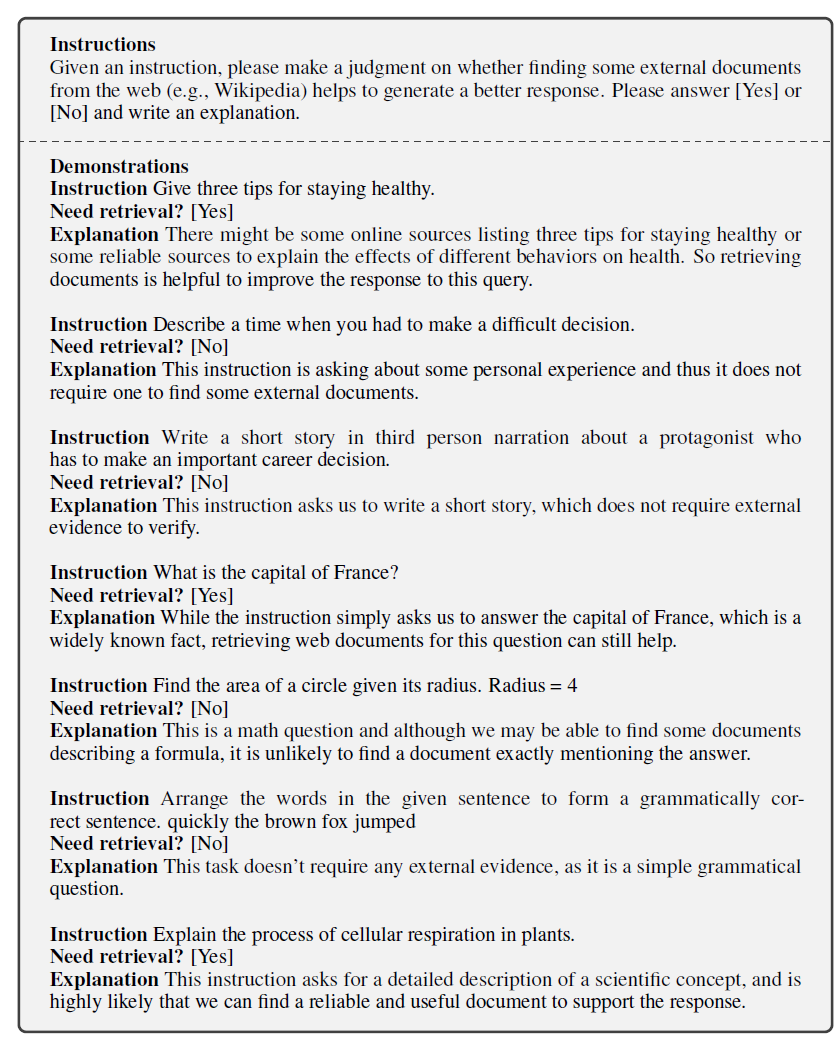
  • Critic先基于Input判断是否需要检索,如果预测【Retrieve=NO】则只判断Output【IsUse】,GPT4的标注prompt如下
image

  • 如果Critic判断Input需要检索,则输出【Retrieve=YES】并插入到Ouput的句首,再基于Input和Output进行内容检索

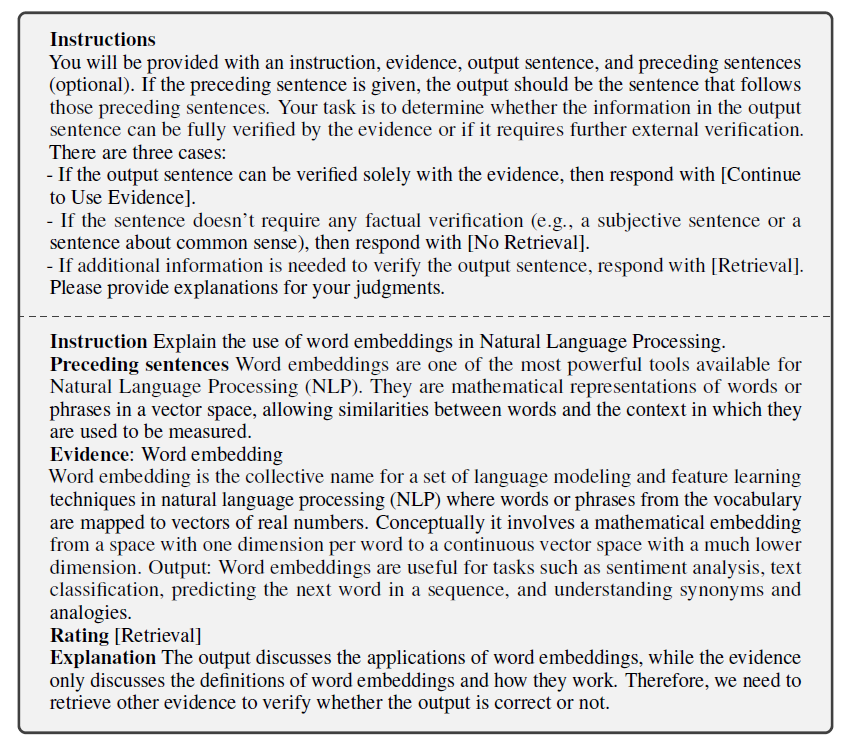
  • 得到检索内容后,对Ouput进行分句,每句话都基于输入,前一句推理,和最初的检索内容来联合判断本句话是否需要补充信息检索,如果需要则在句首插入【Retrieve=YES】,否则插入【Retrieve=NO】,GPT4的标注prompt如下
image

  • 如果【Retrieve=YES】,则使用输入和前一句推理进行补充信息检索,并对每一个检索到的内容分别预测【IsSUP】和【IsREL】,保留分数最高的【IsREL=Relevant】和【IsSUP=Fully Supported/Partially Supported】的检索内容,并把该检索到内容作为段落插入到【Retrieve】后面

  • 最后在句尾判断推理内容的【IsUSE】

基于以上标注样本直接训练Generator,需要先把特殊字符扩充进模型词表,然后在训练过程中计算损失函数时MASK掉检索内容。这样模型可以在推理过程中直接解码生成以上四种特殊字符,并基于字符决定是否检索,是否使用检索内容等等。

模型回答置信度

  • FLARE: Active Retrieval Augmented Generation

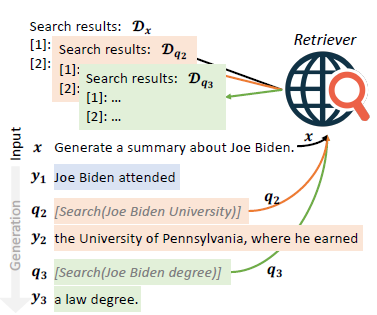
这里的FLARE的全称是Forward-Looking Active REtrieval augmentation,也就是在模型每推理完一句话,让模型判断下一句话是否需要使用RAG,如果需要则生成检索query,搜索内容,并基于前面已经推理出的内容,用户提问和新检索到的内容,进行继续推理。

这里不细说这个动态按句子粒度进行RAG的框架,而是关注每一步要如何判断是否使用RAG。论文尝试了两种方案:

  • Instruct:和ToolFormer相似,每推理完一句,prompt指令会让模型生成新的Seach(query)命令。论文发现这种基于prompt+few-shot指令的RAG决策方案效果并不好。
image

  • Confidence:每一句都让模型先直接进行推理,然后基于模型推理的置信度来判断是否需要进行检索,然后基于检索内容来对句子进行重新推理生成。这里推理置信度使用模型推理句子中每个token的生成概率是否都超过阈值,如果都超过阈值,则保留模型推理生成的句子,否则去做检索生成。

如果基于置信度判断模型对答案不确定,需要进行检索的话。论文给出了两个生成搜索query的方案:

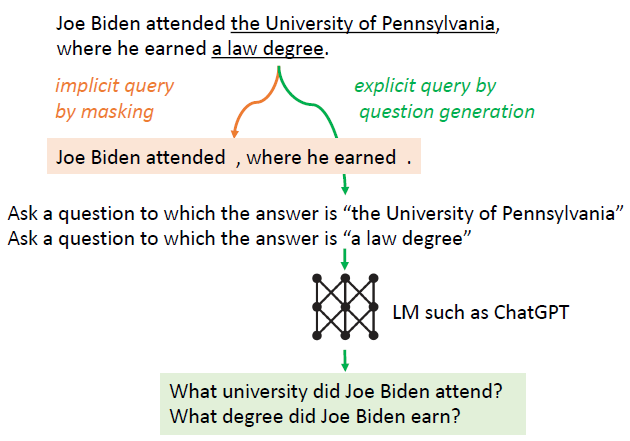
  • mask sentence:直接把上面模型推理生成的句子中概率小于阈值的token删掉,然后使用剩余的token作为query进行检索。对低阈值token进行掩码是为了避免错误回答影响检索质量。例如用户提问哪些国家发生过严重经济危机,模型回答了“法国发生过经济危机”,其中法国的概率低于阈值,这时如果不删掉法国,则检索重心会从经济危机而像法国偏离,导致检索不到有效内容。但对于整体概率都很低的句子,掩码方案可能导致最后没有有效token去进行检索。
  • generate question:除了掩码,论文还提供了query生成方案,把句子中概率小于阈值的每个span,都通过大模型指令来生成检索query,如下图
image

论文对比了,基于下一句推理置信度进行动态RAG的方案(FLARE),基于固定长度的历史token进行召回,基于固定历史单句话进行召回,FLARE的效果都要更好,主要体现在两个部分

  • 使用历史句子,不如使用模型下一句推理的句子更能反映模型意图
  • 动态RAG相比固定进行召回能更有效的利用内部和外部知识

小模型代理回答

  • Small Models, Big Insights: Leveraging Slim Proxy Models to Decide When and What to Retrieve for LLMs

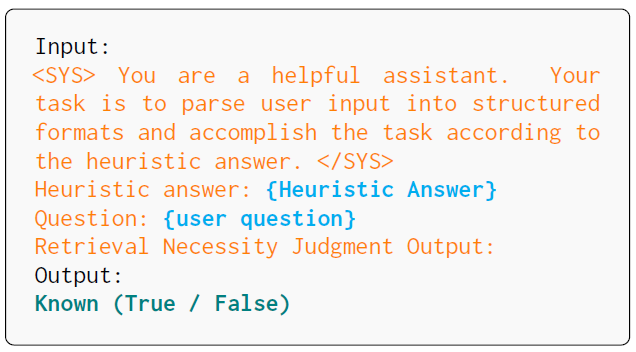
百川论文中采用了让小模型,这里是Llama2-7B对用户提问进行回答(Heurisitic Answer),然后使用Judgement Model对问题和模型回答进行综合判断,最终输出是否需要进行检索的标签。如果需要检索,再走RAG流程,让Llama-70B进行最终的问题回答。

其中Judgement模型的输入如下
image

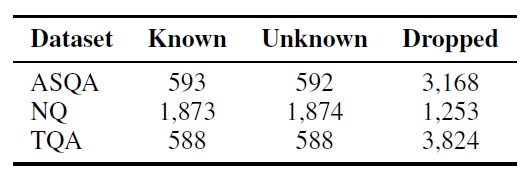
那核心其实就在Judgement模型的训练数据构建,这里论文在已有QA数据集上构建了样本,数据集构成如下。
image

这里论文只使用了真实答案较短的样本,通过计算答案和小模型回答之间的匹配率来给样本打标,匹配率高(回答质量高)为正否则为负,然后使用该样本集来微调Judgement模型,这里也是llama2-7B。

论文并没有给出对Judgement模型更多的分析,例如哪些回答会被判定为模型知道,哪些回答会被判定为不知道。个人其实是有些困惑,只基于模型回答学出来的JudgeMent Model,究竟学到了哪些特征。但是使用更小的模型作为Proxy模型进行预推理的思路可以借鉴,虽然可能存在大模型和小模型知识空间不同的问题,但主观感受是小模型的知识空间更大可能是大模型的子集,所以问题不会太大。

问题最近邻判别

  • SKR-KNN: Self-Knowledge Guided Retrieval Augmentation for Large Language Models

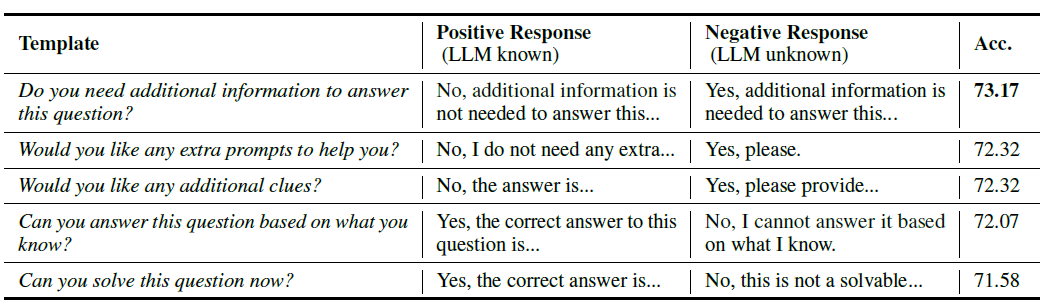
论文尝试了多种判断模型是否知道该问题答案的方案,包括直接问模型“你知道不?”,带上few-shot再问“你知道不?”以及小模型二分类,但是最后验证比较靠谱的还是基于问题的最近邻进行判别的KNN方案。哈哈放在最后压轴,因为这是我个人偏好的方案的一部分,具体实施包括两个步骤

第一步构建KNN样本集,论文使用了TabularQA和CommonsenseQA数据集,每个问题分别让模型自己回答,以及使用向量检索召回Wiki后保留Topk上文让模型基于上文进行回答。然后通过对比两个回答和真实答案的Exact Match的区别,来判断对于该问题,模型到底知道还是不知道,这一步称之为收集SELF-KNOWLEDGE。

这里QA问题其实是对真实场景的简化,真实世界的问题多是开放问答,没有正确唯一的答案,这个时候要收集训练集,判断模型究竟是基于内化知识回答更好,还是加上RAG检索增强回答效果更好,我想到的是可以借助RM,或者一些JudgeLM的效果打分来实现。

第二步就是基于样本集对新问题进行判别,论文简单使用了SimCES等向量,对新问题和样本集内的问题进行编码,每个问题都检索醉相思的K个问题,然后基于这K个问题的标签【知道 vs 不知道】来决定新问题要不要走RAG检索。

论文只评估了KNN的效果会优于Bert分类,大模型prompt等等,但其实除了效果,个人看好这个方案的原因是**KNN可以实时扩展,可以持续基于线上问题的回答效果,补充正负样本集,进行增量更新。**不过KNN的一个问题在于部分问题的相关性无法通过通用的语义相似度来识别,例如问题的复杂程度和通用语义是无关的,这个我们下一章会提到。

这里也顺便提一嘴,论文还尝试了让大模型自己回答它是否知道该问题的这个方案,论文尝试了以下几种prompt。毕竟个人认为是否走RAG的判断并非是单一策略,而是多个策略组合,基于大模型Prompt的方案也是其中之一,可能不会像论文这样直接使用,这样的推理成本太高,但可以和用户的提问进行合并使用。这样能回答直接回答,不能回答或者以上其他策略判断模型不知道,再走RAG。
image

总结

最后让我们把两章提及RAG前置检索决策的方案做下简单的分类

  • 基于输入
    • 无监督分类:基于历史问题使用KNN最近邻判
    • 有监督分类:微调模型去判断什么时候需要检索
    • Verbose:基于指令让模型自己回答该问题否需要检索
    • RLHF: 通过对齐让模型自我判断并拒绝
  • 基于输入和输出(输出可以是完整回答,也可以是下一句推理)
    • Verbose: 让模型先回答,再用指令让模型基于问题和回答一起判断是否需要检索
    • Contradicotry: 基于单模型,多模型回答的矛盾来判断模型是否可能不知道
    • Confidence 基于模型回答的熵值
  • 更多细节优化
    • Decompose:对原始提问进行角度拆分和分别判断,也可以分句进行动态检索
    • Proxy:基于输入和输出的判断,可以使用小模型作为代理模型,来优化推理速度

最后的最后

感谢你们的阅读和喜欢,我收藏了很多技术干货,可以共享给喜欢我文章的朋友们,如果你肯花时间沉下心去学习,它们一定能帮到你。

因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。作为一个普通人,无法全部学完,所以我们在提升技术的时候,首先需要明确一个目标,然后制定好完整的计划,同时找到好的学习方法,这样才能更快的提升自己。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
大模型知识脑图

为了成为更好的 AI大模型 开发者,这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
在这里插入图片描述

经典书籍阅读

阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。

在这里插入图片描述

实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

在这里插入图片描述

面试资料

我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下

在这里插入图片描述

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

企业级AI编程工具选型指南:TRAE、Copilot与Q Developer深度对比 AI编程已从‘写得快’迈入‘写得稳、管得住、审得清’的新阶段,其核心是将大模型能力嵌入企业IT治理闭环。技术原理上,关键在于本地化推理、私有知识增强(RAG)与云原生意图解析三类范式分化;技术价值体现为降低安全审计成本、压缩新人上手周期、保障等保/PCI-DSS等合规落地;典型应用场景覆盖金融核心系统开发、互联网中台快速迭代、IoT边缘固件生成等高约束环境。本文聚焦TRAE Solo的离线主权控制、GitHub Copilot Business的GHAS联动审计、Amazon Q Developer的AWS 阅读详情

相关推荐

AI训练数据枯竭真相:语义密度塌方与四条突围路径

大语言模型训练正面临‘数据够多但有效不足’的核心矛盾——并非原始数据总量下降,而是高信噪比、长上下文、可验证版权的高质量语料持续衰减,导致语义密度塌方和认知增量归零。其技术根源在于网络内容模板化加剧、网页结构碎片化、版权合规约束强化三重坍塌。在此背景下,单纯依赖爬取或复用旧数据已引发loss曲线异常、GPU空转率上升、跨领域泛化能力退化等工程实证问题。当前可持续路径聚焦垂直私有数据深挖、合成数据定向补缺、数据活水机制建设及模型轻量化认知转型,尤其强调RAG工业化落地与小模型领域精炼。本文基于一线金融、医疗、

chongyuwan4121的博客 495

【RAG 论文】SKR:Self-Knowledge 指导下的 RAG

⭐⭐⭐⭐。

VLyb 2266

Kimi 2.6深度解析:长上下文、树状推理与Agent集群实战

大型语言模型(LLM)的实用化瓶颈,正从‘能否生成’转向‘能否持续可靠地思考’。其核心在于推理深度、上下文容量与任务协同能力三大维度——前者决定逻辑严谨性,后者支撑复杂文档理解,而Agent架构则实现多工具自主编排。Kimi(月之暗面)2.6通过256K上下文窗口、显式思维预算分配与内生Agent调度机制,显著提升长链条任务的稳定性与可解释性,已在财报分析、合规评估、技术尽调等需跨源验证、动态回溯的工程场景中验证实效。本文基于真实工作流,详解其推理跃迁原理与开源可集成特性。

dgqvhtlwq472235338的博客 338

论文略读:Self-Knowledge Guided Retrieval Augmentation for Large Language Models

2023 emnlp findings

qq_40206371的博客 536

步进电机驱动算法——梯形加减速算法

目录步进电机梯形加减速梯形加减速算法原理分析算法实现 步进电机梯形加减速 电机的控制方式一般分为开环控制与闭环控制两种控制方式,其中开环控制原理框图如下: 这种种控制方式的特点是:控制简单、实现容易、价格较低,这种开环控制方式,负载位置对控制电路没有反馈。 对于步进电机,控制脉冲的输入并不依赖于转子的位置,而是按一固定的规律发出控制脉冲,如果励磁变化太快,电机不能移动到新的位置,那么实际负载位置与理想位置就会产生一个偏差,就有可能出现失步或者过冲现象,所以需要使用加减速算法。 梯形加减速算法,S加减速算法等

aaa376070331的博客 3万+

Vitis Model Composer闪退?手把手教你用命令行启动Vivado 2021后的System Generator

本文详细解析了Vitis Model Composer闪退问题的根本原因,并提供了命令行启动Vivado 2021后System Generator的完整解决方案。从环境变量配置、组件缺失排查到权限问题处理,手把手教你通过命令行深度排错,并分享高级自动化脚本和系统优化技巧,帮助开发者高效使用Vitis Model Composer与System Generator进行HDL开发。

weixin_26905487的博客 343

RAG检索增强生成三大核心问题

介绍RAG三大核心问题:what?when?how?

weixin_57384302的博客 2172

基于大模型的自动驾驶智能体:Agent-Driver架构、训练与实战指南

自动驾驶系统正从传统的模块化流水线向以智能体为核心的新范式演进。其核心原理在于将车辆视为一个能够与环境持续交互的自主决策智能体,通过多模态感知、记忆管理和基于大模型的推理能力,实现对复杂交通场景的理解与应对。这一技术价值在于利用大模型的常识推理和泛化能力,有望解决传统方法在长尾场景下面临的挑战。在应用场景上,智能体驱动架构特别适合处理动态交互密集、需高层语义理解的城区驾驶、无保护转弯及突发状况应对。本文聚焦的Agent-Driver项目,正是这一方向的典型实践,它通过融合视觉、语言大模型与强化学习,构建了一

weixin_28729843的博客 522

解密prompt系列39. RAG之借助LLM优化精排环节

合集 - DecryptPrompt(39)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_30907685的博客 395

2D激光slam数据集的下载与测试

参考博客: https://blog.csdn.net/qq_24894159/article/details/81265991 https://blog.csdn.net/fk1174/article/details/52673413#commentBox 数据集下载与生成 下载数据集 下载网址: http://ais.informatik.uni-freiburg.de/slamevaluation/datasets.php 进去网站后点你想下载的对应的"download log file" 然后你

老李的博客 4016

视觉辅助RIS波束追踪:用摄像头“看见”用户,实现毫秒级波束对准

在无线通信领域,波束成形技术是提升高频段信号覆盖与质量的核心手段,其原理是通过调整天线阵列的相位,使信号能量在特定方向相干叠加,形成高增益定向波束。这项技术的价值在于能有效克服高频信号路径损耗大、穿透性差的瓶颈,广泛应用于5G/6G、毫米波通信及室内定位等场景。然而,传统波束追踪依赖信道估计或波束扫描,存在训练开销大、实时性差的问题。本文聚焦于一种创新解决方案:将计算机视觉与可重构智能表面(RIS)相结合。通过摄像头直接感知用户位置,并利用RIS快速重构反射波束方向,实现了近乎零开销、毫秒级延迟的波束追踪,

weixin_33552698的博客 611

解密prompt系列44. RAG探索模式?深度思考模式?

合集 - DecryptPrompt(44)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_40847431的博客 147

AI Agent ReAct架构设计模型剖析

ReAct通过"思考-行动-观察"循环运作:智能体先进行自然语言推理,再调用外部工具执行行动,观察结果后继续推理直至解决问题。这种架构提高了透明度和准确性,减少幻觉风险,使LLM能主动分解任务并利用外部数据源。实现关键在于精心设计的提示模板,引导LLM按结构化格式响应,而非依赖模型固有能力。

weixin_43939320的博客 1246

解密Prompt系列38.多Agent路由策略

合集 - DecryptPrompt(38)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_35974392的博客 454

7.29华为OD机试真题 新系统 - 能量对撞 (Java/Py/C/C++/Js/Go)

7.29华为OD机试真题 新系统 - 能量对撞 (Java/Py/C/C++/Js/Go)

算法大师! 1291

华为OD机考双机位C卷 - 采购订单 (Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 采购订单 。提供Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。

算法大师! 419

解密prompt系列41. GraphRAG真的是Silver Bullet?

合集 - DecryptPrompt(41)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_33603377的博客 228

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

解密Prompt系列36. Prompt结构化编写和最优化算法UNIPROMPT

合集 - DecryptPrompt(37)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_30350163的博客 364

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

解密prompt系列40. LLM推理scaling Law

合集 - DecryptPrompt(40)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_36864054的博客 246

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

解密prompt系列43. LLM Self Critics

合集 - DecryptPrompt(43)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_33481663的博客 171

解密prompt系列35. 标准化Prompt进行时! DSPy论文串烧和代码示例

合集 - DecryptPrompt(37)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_41269923的博客 335

解密Prompt系列33. LLM之图表理解任务-多模态篇

合集 - DecryptPrompt(37)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_34975747的博客 358

解密prompt系列42. LLM通往动态复杂思维链之路

合集 - DecryptPrompt(42)1.解密Prompt系列8. 无需训练让LLM支持超长输入:知识库 & unlimiformer & PCW & NBCE2023-06-132.解密Prompt系列6. lora指令微调扣细节-请冷静,1个小时真不够~2023-04-293.解密Prompt7. 偏好对齐RLHF-OpenAI·DeepMind·Anthropi...

weixin_33510623的博客 342

MuleSoft企业级AI编排:构建可审计、可回滚的LLM工作流

大语言模型(LLM)在企业落地的核心挑战,从来不是生成能力,而是如何与SAP、Salesforce、Oracle等遗留系统安全、可靠、合规地协同。AI编排(AI Orchestration)作为连接LLM与企业服务总线的关键范式,强调上下文治理、事务一致性与端到端可观测性。它通过Schema驱动的数据转换、策略即代码(Policy as Code)的安全控制、以及原生审计追踪,将LLM从‘黑盒响应器’升级为‘可验证决策节点’。典型应用场景包括智能合同审查、采购风险评估、跨系统客户360视图生成等。本文聚焦M

weixin_30647065的博客 300

LLM数据泄露风险与防护:从提示词注入到训练污染的实战指南

大语言模型(LLM)并非传统数据库,其输入数据一旦进入推理上下文,就可能触发缓存固化、日志沉淀和模型记忆效应等不可逆路径,导致敏感信息意外暴露。这种泄露不依赖黑客攻击,而源于提示词注入、RAG拼接、微调数据污染等日常工程操作。技术本质在于Transformer架构对高信息熵token的注意力驻留,以及语义层面的特征泄露——即使加密或脱敏,模型仍能通过上下文模式重建敏感逻辑。因此,真正有效的防护必须前置到数据输入环节,构建网络层过滤、应用层语义锚定脱敏、模型层运行时钩子的三层防御矩阵。本文聚焦LLM数据泄露、

weixin_30751947的博客 550
上一篇: 解密Prompt系列36. Prompt结构化编写和最优化算法UNIPROMPT
下一篇: AI产品经理入门基础教程,非常详细,从入门到精通,收藏这一篇就够了
Agent学习路线
博客等级 码龄6年 1万+粉丝 1902原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值