北京大学刘利斌:「元宇宙」支撑技术大揭秘——角色动画生成

966521d387a487ac94ae631ba6dd1343.png

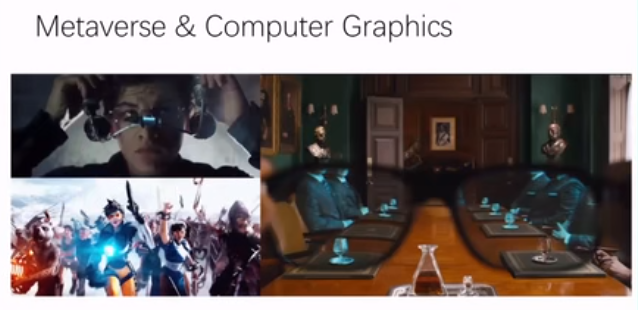
【栏目:前沿进展】说到 2021 年与计算机相关的最火的概念,一定少不了「元宇宙」。元宇宙是一个庞大的工程,而计算机图形学则是对元宇宙起到支撑作用的一系列关键技术。借着「元宇宙」的东风,计算机图形学有望焕发「第N春」。
52f5e81d9ff5fe9946dd2cc58d94d5a5.png

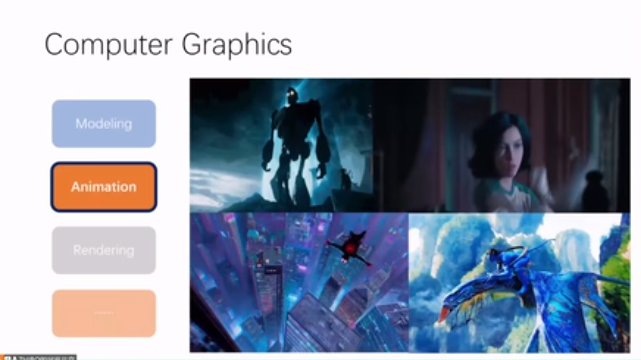
计算机图形学包含几何建模、渲染、计算机动画等研究方向。与其它方向相比,计算机动画的特点在于其研究主要面向场景中能够运动的物体。刘利斌博士主要的研究方向为「角色动画」,即场景中所有能够主动运动的物体(例如,人、动物)。
db484d6408e2cf5adbf5ad966493411e.png

2021 年 9 月 30 日,北京大学前沿计算研究中心助理教授、智源新星刘利斌在青源 Talk 第 6 期上发表了题为「角色动画生成」的演讲。本文整理自报告,视频回放链接:https://hub.baai.ac.cn/live/?room_id=167
b25f687ca09088ac61546b793f3c7f62.png


48b3e734c9e5d95689746dd11520d15a.png

刘利斌,2009于清华大学获得数理基础科学专业学士学位,2014年在清华大学获得计算机科学与技术专业博士学位。加入中心之前,刘利斌博士曾于加拿大不列颠哥伦比亚大学(The University of British Columbia)及美国迪士尼研究院(Disney Research)进行博士后研究,后加入美国硅谷创业公司DeepMotion Inc.担任首席科学家。刘利斌博士的主要方向是计算机图形学、物理仿真、运动控制以及相关的优化控制、机器学习、增强学习等领域。截止2021年9月,刘利斌博士在计算机图形学领域顶级国际会议及期刊上发表论文十余篇,引用近700次,并曾多次担任图形学主要国际会议如SIGGRAPH、PacificGraphics、Eurographics等的论文程序委员。


报告人:刘利斌

整理:熊宇轩

编辑:李梦佳

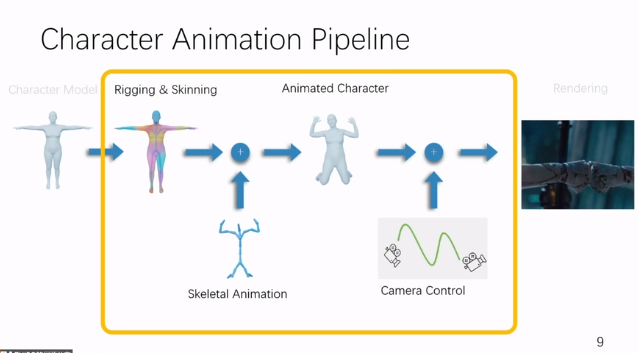
在传统角色动画的生成过程中,我们首先需要通过机器学习、计算机视觉、图形学方法对角色进行建模。
9bb7fcedc6eb743e9d13507d0b512642.png

图 1:角色动画生成流程

接着,我们需要进一步进行计算机动画的处理,将角色模型绑定到骨骼模型之上。这样一来,我们就可以通过改变骨骼的姿态来改变人、动物等角色的姿态。为了将该模型展示出来,我们需要进行相机控制。最后,我们通过渲染在场景中生成动作。上述过程往往需要耗费大量的时间和人工劳动成本。因此,研究人员试图通过人工智能技术加速角色动画的生成过程。

绑定
8dfdc257ea6eb4d734e19c0ef71bc64f.png

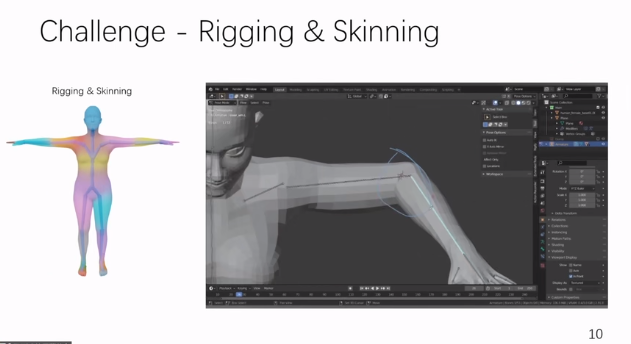
图 2:绑定过程中的挑战

以绑定过程为例,动画师需要手工地通过专业软件为皮肤刷上权重,保证骨骼在运动时产生自然的外观形变。为了提升上述过程的效率,我们试图通过算法实现自动绑定。在得到角色模型后,我们需要通过算法提取出复合实际情况的骨骼框架,并计算出蒙皮的权重,从而将皮肤绑定到骨骼上。
c7d38c08a784112669f08bbe4412c502.png

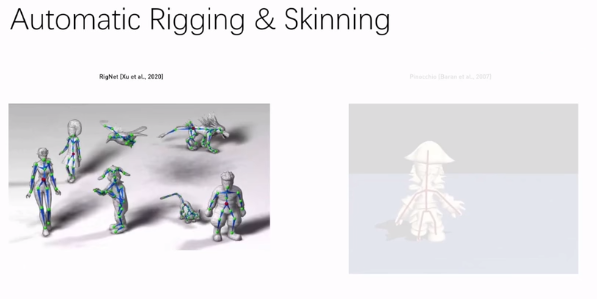
图 3:automatic rigging & skinning

早在 2007 年,Baran 等人基于几何操作提出了 Pinocchio 算法来实现自动绑定。2020 年,Xu 等人在 SIGGRAPH 大会上提出了著名的 RigNet,通过神经网络完成几何操作,实现更加鲁棒、漂亮的骨骼提取和绑定,同时也允许用户在一定程度上干预绑定过程(例如,调整骨骼密度、关节位置)。

不过由于该方法不支持用户自定义的骨骼结构,在实际应用中经常需要解决诸如动作重定向等问题,在一些任务场景中需要往往额外的工作才能保证动作的质量。

2710ac20d51919f086669213f701370e.png

图 4:Learning Skeleton Articulations with neural blend shapes

为了解决这个问题,我们在 SIGGRAPH 2021 上提出了完全基于神经网络学习的自动绑定方法。该方法能够自动根据输入的角色模型提取出符合预先设定的骨骼结构的骨骼模型,并且完成自动的绑定。在完成绑定之后,将动作(例如,关节旋转)导入到模型中,就可以直接驱动角色来产生相应的外观变化。

3361f4be75a425a7d9f2e3818feb3bc3.png

图 5:Envelope branch

该方法通过基于 MeshCNN 的架构根据输入的模型提取每个顶点绑定的权重,并估计出骨骼的位置,从而真正提取出骨骼的结构。由于原始的蒙皮权重刻画了骨骼的运动,会影响顶点网格模型的影响力,我们可以根据估计出的蒙皮权重反推出骨骼 模型。具体而言,我们通过 skinning based pooling 将蒙皮权重和顶点上的特征转化成骨骼特征,并最终提取到骨骼结构。

04a2ac7fd524b12692b056ff72314b40.png

图 6:运动质量

LBS 是目前广为使用的线性混合皮肤模型,其主要的缺陷在于:形变较大时,会出现体积的损失。为了弥补该缺陷,人们通常会采用手动创建的 Blend Shapes 方法将体积损失补全。

c2a885afacccdf406181a5ec91f7ab9a.png

图 7:Residual Branch

我们的模型提供了相应的组件,能够根据输入数据估计出 Blend Shapes,改善形变较大时的绑定效果。网络架构如图 7 所示,在推理时,我们会根据角色当前的姿态计算将 Blend Shapes 融入骨骼的程度。

16bdb5117d9154a77e8bd51c3a67f6ca.png

图 8:训练过程

由于我们才训练时并不知道骨骼的 Skinning 权值和 Blend Shapes 的真实值,所以采用了间接监督的训练方式,模型输入为样本的姿态及其形变情况。我们采用 SMPL 作为训练数据集,并且加入了额外的连通性数据增强方式提升网络的鲁棒性。

2d4971f52bc3bf601f9b125cfda8cce5.png

图 9:实验结果

实验结果表明,加入了神经 Blend Shapes 组件之后,可以在大型形变的场景下显著改善动画质量,使用 Envelope 模型估计出的 Skinning 权值也优于原始的 LBS 对比基线。

57fe237c623d2015eeb1c19e47fd1dbf.png

图 10:细节形变

值得注意的是,我们的模型具备很强的对人体细节形变(例如,肌肉的抖动)的捕捉能力。

相机控制

c24975430e55854573eebd8df5a85bb3.png

图 11:相机轨迹规划

在游戏、电影等场景下,相机的镜头语言也是叙事的重要部分,我们需要实时、自动地生成相机运行轨迹,形成某种镜头语言和风格。

10042a207a9c851144b4285c9a13cb8b.png

图 12:传统方法

传统意义上,我们可以根据摄影、艺术方面的一些技术和先验知识设计优化目标,从而生成相机轨迹。然而,我们有时难以通过语言或数学方式来描述这样的先验知识。

473837576529cf9a5c1731ceb64a3cd7.png

图 13:Example-driven Virtual Cinematography by Learning Camera Behaviors

我们在 SIGGRAPH 2020 上发表了论文「Example-driven Virtual Cinematography by Learning Camera Behaviors」,试图从输入视频中提取出对风格的表示,使拍摄虚拟动画场景的过程展现出相似的风格。

6f6330649d4fb601d31e7305c7225ea9.png

图 14:建模相机行为

在拍摄电影时,运镜的过程在很大程度上是由人物之间的相对关系决定的。基于这一观察,假设在场景中始终至少有两个角色,我们可以将两个角色的相对关系、它们跟镜头之间的关系、人的朝向、相机的位置等信息表示成一个特殊的场景特征。具体而言,我们在表示物体位置时,采用了完全局部的环面坐标系,从而过滤掉全局运动的影响。

c954f14bb734bf57c86b957ce3bce2a0.png

图 15:Mixture of Experts

为了提取到这种表示,我们提出了如图 15 所示的 Mixture of Experts 架构,将不同拍摄场景对应的不同风格的 Expert 混合起来。首先,我们通过门控神经网络得到各个场景特征的权重,并根据该权重混合不同的 Experts,从而得到具有特定风格的相机运动轨迹。

e9d0d7a0d309d6afdebdef6fc27f8076.png

图 16:Camera Keyframing with Style and Control

然而,「Example-driven Virtual Cinematography by Learning Camera Behaviors」中的方法并不能让用户参与到相机轨迹的控制中,无法通过指定关键帧等方式干预相机运动的过程。

bdaa93cf84d497015c47ab824ab8ad1f.png

图 17:两阶段的工作流程

为了实现上述目标,我们在「Example-driven Virtual Cinematography by Learning Camera Behaviors」的基础上,在相机轨迹生成部分将关键帧信息、当前帧和关键帧相对位置关系作为额外的输入。

动画生成

7f080a06be242954c75789ecf1eaed79.png

图 18:动画生成

起初,动画师需要通过调整角色关键帧中的姿态等方式生成动画,这一过程十分耗时。如今,在电影、游戏产业中,我们往往首先对真人进行动作捕捉,然后将捕捉到的动作映射到虚拟角色上,从而生成角色动画,这大大降低了制作成本,提高了动作的丰富性。

88d8b17e14f8437bece42b8f1d0ed08c.png

图 19:Unsupervised Co-part Segmentation through Assembly

然而,进行动作捕捉的设备往往十分昂贵。为此,一些研究人员试图估计出视频中人的姿态(例如,OpenPose)。但是这些姿态估计方法大多是有监督学习方法,要求我们首先对图像进行大量的标记。对于人的姿态标记相对容易,但是对于如图 21 所示的动物、机械臂的动作进行标记则较为困难。为了解决这一问题,我们在 ICML 2021 上发表了论文「Unsupervised Co-part Segmentation through Assembly」,充分利用视频中与动作相关的每个部位的相对信息,从而更好地对视频中的物体进行分类。

6ca7c33e45408923785d8520423ddaee.png

图 20:自监督组装

为了进行自监督的训练,我们从不同的图片中分割出不同的部位。如果分割结果合理,我们可以将这些部位按照对应图片的形变进行仿射变换,再将变换后的部位组装回原图中。

2d420cbe64b2cee932a0e0a90d1c0215.png

图 21:部位组装——编码器

首先,我们通过编码器提取部位的特征以及部位对应的变换。

dc8d68d6831681ba8af048a4b964161a.png

图 22:部位组装——解码器

接着,我们分别将每个部位的特征解码为对应的部位图。

c5c9e3f0291ebe5af04eff59d666c56f.png

图 23:部位组装

最后,我们将部位图组合起来,恢复出原始图片。

7516ad0e7d00c76af6623851dd87b1dd.png

图 24:训练过程与损失函数

在输入两张图片时,我们首先通过编码器编码源图片的部位特征和变换以及目标图片的变换。

接着,我们用目标图片的变换方式对源图片的部位特征进行变换。通过组装变换有的源图片的部位图,我们试图重构目标图片。

0f0e5c13b3d16710a14b16865cb9335b.png

图 25:变换损失函数

除了重建损失函数之外,我们还引入了一个变换损失函数。由于我们需要在区分部位的同时,在正则空间中估计角色的姿态。因此,我们假设所有部位在正则空间中为一个处于原点的形状,其变换对应于形状本身的协方差所在的方向。通过这个变换损失函数,我们可以赋予变换一定的物理意义。

fad476f71fe69aa63356e24930076ca3.png

图 26:交互式场景

对于电影来说,通过上述方法得到的一次性的高质量角色动画可以满足要求。然而,对于游戏、虚拟数字人、VR、服务机器人等交互式场景,我们希望它们能够随着与用户的交互实时产生满足要求的自然的高质量的动作。从理论上说,我们不可能完全依靠动作采集获取到动作空间中所有的动作,需要重用已经采集到的动作。

d8670422a072021195f59692878959ea.png

图 27:运动图

早期,研究人员采用运动图(Motion Graph)等基于状态机的方法完成上述目标,通过图模型根据动作之间的逻辑关系将它们结合起来。然而,如果涉及到的动作很多,状态机就会十分复杂,难以进行进一步的编辑。

0aed0de29070f7539bfed0d2bcb4cfea.png

图 28:生成运动

为此,研究人员试图直接从无结构数据中学习嵌入在其中的策略,并通过学习一个能够根据用户指令产生新动作的生成模型。在神经网络被广泛使用之前,人们尝试过通过高斯过程、高斯混合模型完成上述任务。

c7d230a5ed025a4f26b3e178eafe32ee.png

图 29:神经运动生成

近年来,一些基于自回归神经网络的动作生成模型纷纷涌现出来。我们将角色当前的状态、用户输入的指令、环境的变化输入给生成网络,网络会根据上述信息迭代更新角色的状态。其中,神经网络可以为门控网络、LSTM、标准化流等模型。然而,这些基于数据的方法本质上还是对已有数据的混合和重放,无法产生新的动作。

d63a560c619b2143de6c84d60959cae3.png

图 31:基于物理的角色动画

此外,人摔倒等动作是一个物理过程,由此衍生出了基于物理仿真的角色动画。该方向的研究目标是在虚拟世界中还原真实世界的物理过程。然而,实现这种控制过程往往是十分困难的。

7867849f95de4ee08be888b6cd561334.png

图 32:基于强化学习的方法

在机器人领域中,一些学者试图对一些共性的动作展开研究。然而,这些研究缺乏对细节的刻画,机器人角色完成动作的样子与人类有较大差距,并不自然。近年来,随着强化学习的发展,很多工作基于强化学习使智能体模仿人的运动来学习控制器,从而控制角色运动。

具体而言,智能体与所处的环境不断交互,并根据交互结果更新控制策略。我们通过奖励函数使仿真结果与输入的动作尽可能接近。由于仿真过程往往是黑盒,我们会使用 Reward-Weighted Regressoin 等模型无关的方法来求解。

c909d7796c93d99b0af11d8e166a6a13.png

图 33:组合控制策略

除了基于简单的强化学习策略让角色学习灵活的动作,我们还可以对身体的不同部分采用不同的控制策略(例如,下半身保持平衡,上半身做出其它动作)。

23de3c41d547eff2f888b90775d8ad3e.png

图 34:多功能角色的控制图

使角色同时学习到多种动作对于基于物理的动画来说是一个重要的目标。如前文所述,研究人员通过基于状态机的方法应用到基于物理仿真的角色动画中,将不同的运动控制策略结合起来,使角色实时地与物体和用户交互。

698cfa52bbad3182d8e9b852d6b0ed4c.png

图 35:固定时间序号追踪的弊端

在进行模仿学习时,我们希望生成的动作与参考数据一致。然而,在动态场景下,会出现一些与理想环境不符的突发状况。为了解决该问题,我们需要对运动控制策略进行规划,在跟踪原始参考数据无法成功时,需要跳过一部分参考数据进行新的尝试。

aeeba543265f51a2f72f09867c9a428b.png

图 36:用于动作规划的 Q 网络

为了在规划时从较长的应用数据中挑选出合适的数据,从而成功地完成动作,我们设计了一种基于深度 Q-学习网络的方法,从而实现了滑板、杂技运动等复杂的角色动画。

0980ebe3c43cd93b2cccccc67da3da66.png

图 37:运动生成+基于物理的跟踪控制

为了生成新颖的动作,我们试图将运动生成模型与物理仿真的追踪控制结合在一起。然而,由于生成的往往是物理不准确的,所以通过基于物理的方法跟踪这些动作时往往无法保证质量。

a8320d02ca3fcdbc78adeb3fcc4d0512.png

图 38:生成运动控制

近年来,一些研究人员也试图首先采集大量的动作样本,然后通过自编码器寻找共同的隐空间,进而在隐空间中学习新的高层策略。这样一来,我们可以使角色同时掌握大量的动作来完成目标,但是在这个空间中的训练过程同样没有考虑到物理过程,动作的质量仍然较低。

24b5b27d94fcc7b1140864b0d58a68a4.png

图 39:生成对抗模仿学习

此外,一些研究者试图将生成对抗网络(GAN)与强化学习/模仿学习相结合,从而考虑各种突发情况和物理参数的变化。然而,GAN 和强化学习的训练都较为不稳定,因此得到的动作也不够自然,质量较低。今年,来自加州大学伯克利分校和上海交通大学的研究者提出了对 GAN 中判别器的改进,加入了一些人为的干预从而生成更加自然的动作。

Q&A

Q1:角色动画生成未来的发展趋势如何?会遇到哪些新的机遇和挑战?

A:角色动画最早在游戏和动画中应用地较多,目前工业界的标准范式还是基于状态机的方法。近年来,育碧、EA 等大型游戏公司开始注意到机器学习可以有效提升角色动画制作流程的效率。最近,国内一些公司尝试将角色动画技术应用到融媒体、数字人、直播带货等场景下。

基于物理的角色动画具有巨大的潜力,今年大火的元宇宙概念的头部公司也将基于物理仿真的角色动画应用到产品中,但是该技术目前还不够成熟。

Q2:「元宇宙」概念的发展前景如何?会发展成「头号玩家」等电影中描绘的形式吗?

A:这一目标非常吸引人,但是要想实现这一目标,我们仍然还有很长的一段路要走。举例而言,VR、AR 是元宇宙的重要呈现形式,但是目前这些领域的算力支持还不够充足。元宇宙是一个很宏大的概念,角色动画等领域的研究往往只能触及其中的一个小的部分。

Q3:能否预测一下角色动画、物理仿真等研究方向在未来的 5-10 年会有怎样的突破?
A:我的研究工作的目标是试图构建一个「人工小脑」,让角色能够本能地维持正常的运动,这就要求角色能够学习到大量的动作技能,并将其转化为经验表示。从宏观意义上说,这也是通用人工智能的研究目标。

相关推荐

2026智源大会议程公开丨从 Token 到世界状态预测,多模态的下一场范式革命

从2021年开始,带领团队和OpenAI团队紧密合作,对GPT系列模型进行了效率、鲁棒性和扩展性优化,推动相关服务和应用的产品化,包括以GPT-4作为主要模型的New Bing、由GPT-3.5提供后台服务的Github Copilot以及由DALL-E-2提供支持的Image Creator。2. 从2D到3D,构建空间感知基础模型:突破现有模型对物理世界三维空间理解的局限,探讨如何通过空间感知基础模型的研究,让AI真正理解几何、遮挡与物理规律,为具身智能和三维世界模型奠定底层能力。

BAAIBeijing的博客 765

2026智源大会议程公开|人才发展交流会

2026北京智源大会将举办人工智能人才发展交流闭门会, 诚邀您共同探讨人工智能人才发展的关键议题。论坛将聚焦世界模型、具身智能、AI for Science等前沿领域方向进行讨论,为您提供与智源科学家面对面交流的机会,探讨职业发展规划,共同开启思想碰撞,引领前沿发展。倾听青年学者分享他们的科研成果、职业规划,从中汲取灵感、借鉴经验,拓展自己的学术视野。提供一个开放的平台,让青年学者共同探讨人工智能领域技术创新和人才发展的趋势。提供一个理想的交流平台,链接学者,促进跨领域的学术交流与合作,并提供。

BAAIBeijing的博客 265

2026智源大会议程公开丨当AI学会自我超越,自进化论坛定义下一个极限

研究方向为脑启发的持续学习理论与方法,并推动其在科学智能、智慧医疗、具身智能等关键场景中的应用,研究成果以第一/通讯作者多次发表在 Nature Machine Intelligence、Nature Communications、TPAMI、Patterns、NeurIPS、ICML、ICLR 等人工智能相关领域的顶级期刊和会议。兼任蚂蚁技术研究院顾问。从代码智能体的涌现,到大模型在交互中的自我对齐与架构重塑,AI 正在重写自身演进的底层法则——不再是人类推着 AI 走,而是 AI 学会自己驱动自己走。

BAAIBeijing的博客 453

2026智源大会议程公开|Agent for Science论坛

黄超,现任香港大学助理教授、博士生导师。以第一 / 通讯作者在 ICLR、ICML、NeurIPS、CVPR、Nature Methods、IEEE TMI、MedIA 等国际顶刊顶会发表多篇论文,代表性工作有 FedBN、BrainGNN、FairMedFM、GMValuator 等,研究覆盖可信联邦学习、大语言模型训练评估、生成模型数据估值、时间序列预测等前沿方向。在 SIGMOD、VLDB、ICML、ICLR、KDD 等顶会发表论文 60 余篇,在研项目包括国家科技重大专项课题、国自然青年项目等。

BAAIBeijing的博客 1142

图灵奖得主领衔,中国大模型第一梯队集结,2026智源大会引领下一代智能

来自谷歌、Meta、英伟达、Stanford、Harvard、MIT等20+全球顶尖科技企业与高校科研机构的代表,将与阿里、腾讯、智谱、阶跃星辰、MiniMax、北大、清华、人大等中国AI行业最核心的创新力量同场交流,共同探讨超级模型、多 Agent协同、世界模型、具身智能与真实世界部署等关键方向。与此同时,世界模型也是实现具身智能的重要支撑性技术。无论你是深耕实验室的学者、奋战产业一线的工程师、推动AI落地的企业管理者,还是怀揣AI梦想的青年创业者——2026智源大会,都有属于你的舞台!

BAAIBeijing的博客 224

97后AI研究者,青源InnoVibe喊你来智源大会搞事情了!

18位来自北大、清华、DeepSeek、英伟达等机构的青年学者,以扎实前沿的工作交流火爆全场。他们围绕多模态、智能体、AI4S、AI安全,从基础理论到产业前沿,与AI共振,共赴无国界思想派对。如果你长期活跃于AI社区,拥有高星开源项目、学术服务经历,或在AI交叉领域与产业转化中取得突破性成果,欢迎大胆亮出属于你的独特“徽章”。2026「青源 InnoVibe」共创场,聚光灯已就位,青年学者招募正式启动!,现场分享AI前沿成果,激发思想碰撞,让世界聆听你的时代主张。「青源InnoVibe共创场」,

BAAIBeijing的博客 104

2026智源大会议程公开丨强化学习论坛

以第一作者或通讯作者在ICML、NeurIPS、ICLR、CVPR、ECCV、CoRL、IROS、ICRA、TMLR、RAL等国际高水平会议与期刊发表论文50余篇,谷歌学术引用超过5500次。俞扬,南京大学人工智能学院教授。主要研究方向为深度强化学习及其在具身系统中的应用,在IEEE TNNLS/TCYB/TSMCS等国际期刊和NeurIPS,ICLR,RSS,CVPR,ICRA,CoRL等国际会议上发表论文50余篇,承担和参与了国家自然科学基金青年项目、国家自然科学基金重大项目子课题、以。

BAAIBeijing的博客 498

这是我的科研好搭子!智源大会Agent4S征集——全自动科研,距离我们有多远?

扫码或直接提交链接:https://baai.org/l/JHNfn。提交作者/团队信息、作品信息;入围作品海报、视频等将在6月12日-13日智源大会现场进行展示。查资料、做实验、写论文,能干活、能落地、能复现,欢迎来冲!包含作品名称、核心功能、技术亮点、应用价值及团队信息。优胜队伍将在6月13日智源大会AI4S舞台进行报告。展示Agent核心功能、操作流程及科研应用效果。图灵奖得主、国内外AI顶尖学者、产业大佬齐聚。✅ 站上智源大会舞台,面向顶尖学者公开宣讲。作品征集:5月10日 — 5月30日。

BAAIBeijing的博客 163

智源TALK|NeurIPS/ACL/ICLR顶会洞察:可扩展强化学习的三条边界

强化学习正在重塑大模型能力边界——OpenAI o3、DeepSeek-R1、Gemini 3 等顶尖模型借助大规模 RL 刷新推理天花板,但核心问题始终是:RL 的 Scaling 边界究竟在哪里?欢迎大家一起讨论交流。第三,相比稀疏的结果奖励,On-Policy Distillation 提供的密集 token 级监督看似是"免费的午餐",但这顿午餐,真的没有代价吗?研究方向为大模型对齐与强化学习,曾在 ACL、ICLR、NeurIPS 等人工智能国际顶级会议发表论文,谷歌学术引用量超1800次。

BAAIBeijing的博客 236

智源社区@2050 | 从大脑到代码,你真能被上传吗?

备受关注的"数字果蝇"研究显示,基于约12.5万个神经元、5000万突触的完整神经连接图,大脑模型已可接入虚拟身体,形成"感知—决策—行动"的闭环——行为从结构中自然产生。以Meta近期发布的工作为代表,不再执着于理解大脑的内部结构,而是收集"大脑看到刺激时产生的响应",用大模型直接模拟这一映射关系——输入一段文字,预测大脑的fMRI信号。自底向上建模的问题是神经科学知识永远不完备,大模型建模的核心困难在于不唯一性——同一个输入输出,可以由无数种内部结构实现,模型复刻的往往是一类人,而非一个人。

BAAIBeijing的博客 192

智源TALK|多模态效率提升至19倍,视频理解前沿进展,伯克利&MIT&英伟达

实验结果表明,AutoGaze 可将视觉token数量减少 4倍至100倍,并使ViT与MLLM推理速度提升最高 19倍,从而支持模型处理 1000帧、4K分辨率 的超长视频,并在多个视频基准测试中取得领先表现(例如在 VideoMME 上达到 67.0%)。多模态大语言模型(MLLMs)在通用视频理解方面取得了显著进展,但在处理长时长、高分辨率视频时仍面临效率瓶颈:现有视觉Transformer(ViT)和MLLM通常对所有像素一视同仁地进行计算,忽略了视频中大量存在的时空冗余信息。

BAAIBeijing的博客 114

报名 | 第八届智源大会 相约6月12日-13日

从“回答问题”到“完成任务”,从单轮交互到长时序闭环,人工智能正在走向参与行动与决策的系统形态。更重要的变化是,人工智能正在从“能力竞赛”走向“系统落地” —— 如何在真实世界中稳定运行、持续演化,并真正嵌入人类社会与产业体系。延续七载硬核学术基因,汇聚图灵奖得主、海内外顶尖学者与产业领袖,智源大会将在在思辨与实证中,让智能真正落地生根,为下一代人工智能的发展建立更清晰的坐标系。从多模态理解到空间与动态建模,AI开始以“状态”为核心刻画现实世界的演化规律与因果机制,从“生成符号”走向“与物理世界互动”。

BAAIBeijing的博客 440

FlagOS 核心算子库 FlagGems 全量支持 DeepSeek V4 算子,多芯片适配与多项首创性能优化技术同步落地

KernelGen 构建了一套基于 Agent 的自动化算子优化 pipeline:以初始 Triton kernel 和 reference 实现为起点,Agent 在每轮迭代中自主分析当前 kernel 的性能瓶颈与历史优化数据,自动实施优化策略,并完成正确性验证与性能 benchmark,全程无需人工干预,持续迭代直至达到目标性能,能够从朴素实现逐步逼近甚至超越手工调优的 TileLang baseline。算子层面的跨芯统一编程模型,已经具备与专用优化竞争的实力。

BAAIBeijing的博客 307

专访清华大学OpenMAIC作者于济凡:AI让教育技术走进“科幻时代”

当大模型的浪潮席卷各行各业,教育领域正经历一场深刻的智能变革。从清华校园的科研探索到悟道大模型的实践深耕,从传统教育技术的局限突围到多智能体系统的创新落地,直到MAIC的出现,为教育AI 打开了全新可能。近日,我们专访了清华大学教育学院助理研究员于济凡,听他拆解MAIC理念以及OpenMAIC开源项目的诞生初心、技术路径与实践温度,探寻人工智能如何真正融入教育肌理,重塑学习的未来形态。采访&编辑:梦佳 熊宇轩要点速览从清华在线教育出发:研究生期间进入清华在线教育研究中心,2020年加入悟道2.0团队,成为中

BAAIBeijing的博客 676

报名|ICLR 2026 RSI Workshop 闭门晚宴,开放少量专属席位

智源社区作为本次Workshop的支持方之一,将携手主办方,致力于汇聚全球最前沿的研究力量,共同攻克RSI核心难题。然而,如何让RSI从理论走向可靠、可衡量、可部署的工程实践,仍然是全球顶尖研究者共同面对的核心挑战。依托ICLR 2026 RSI Workshop,智源社区&青源会特别策划了一场 Invite-only 闭门晚宴,为全球顶尖AI研究者打造一个高密度的深度交流场域——没有PPT,没有聚光灯,只有来自不同机构、不同文化背景的顶尖大脑,展开一场真正意义上的"里约论道"。

BAAIBeijing的博客 509

活动报名 | ICLR2026 重磅集结!三十余位中稿讲者,邀你共赴学术盛宴

赵昊,清华大学智能产业研究院助理教授,智源学者,于清华大学电子工程系获得学士和博士学位,曾于英特尔中国研究院担任研究员,曾在北京大学从事博士后研究。DeepTech成立于2016年,是一家专注新兴科技的资源枢纽与服务机构,独家运营《麻省理工科技评论》,为产业、政府、高校、科研院所、资本等科技生态的关键角色提供服务,使命是链接国内外科创资源,加速科研成果产业化落地。展开,从研究选题到审稿意见回复,全方位拆解顶会论文中稿的核心要素,针对大家投稿时的常见痛点、难点给出实用解决方案,干货满满,不容错过!

BAAIBeijing的博客 319

明日直播|ICLR2026,首个可Scaling!FeatureBench打造Agentic Coding评测新框架

其工作 FeatureBench 提出了一种自动化抽取代码仓 feature 的方法,打破了SWE-bench 为代表的 PR-driven 自动提取评测任务的方法,将 Code Agent 的评测从修 bug 转变为了实现全新的 feature。本期报告提出了全新的 FeatureBench 评测框架,立足实际开发场景打造高质量评测基准,同时搭建起全流程开源的技术基础设施,既为当下 Code Agent 的能力评估提供了科学标准,也为后续相关模型的训练与优化筑牢了数据基础。首个可Scaling!

BAAIBeijing的博客 203

活动|ICLR2026中稿先讲,来智源在顶会前先遇见你的学术同行

DeepTech成立于2016年,是一家专注新兴科技的资源枢纽与服务机构,独家运营《麻省理工科技评论》,为产业、政府、高校、科研院所、资本等科技生态的关键角色提供服务,使命是链接国内外科创资源,加速科研成果产业化落地。2025年在智源社区共有近百场学术报告,顶会Best Paper的10余位讲者,来自海内外高校和研发机构、优秀企业研究员进行最前沿的学术探索。ICLR 2026 接收,欢迎来到智源,与最懂这篇工作的同行一起,提前开启顶会级交流!:成为讲者活动,与顶尖学者近距离交流,拓展学术人脉。

BAAIBeijing的博客 91

上交大穆尧:数据为王,2026具身智能迎来“数据规模化元年”丨独家

人工智能与物理世界的深度融合正成为推动机器人技术革新的关键力量,上海交通大学助理教授穆尧博士,作为多模态具身智能(Embodied AI)和机器人学习领域的杰出研究者,围绕具身认知、行为生成、策略学习与统一基础模型构建等关键方向,取得了一系列具有代表性和影响力的研究成果,包括具身思维链模型 EmbodiedGPT、多模态机器人代码生成框架 RoboCodeX、可迁移视觉控制表征模型 CtrlFormer、双臂协同生成式数字孪生平台 RoboTwin,以及基于离散扩散理论的具身基础模型 MM-ACT。

BAAIBeijing的博客 766

专访KAUST诸葛鸣晨丨2026 Agent最大突破是“递归自进化”,三年后有望实现“神经计算机”

也许你会意外的发现,2025年David Silver和Richard Sutton主推的Learning from Experience,以及2025年下半年到2026年上半年硅谷各大公司的老大比如Elon、Sam、Dario最近爱谈的Recursive Self-Improvement,三年前我以精准的terminology将其写入 MetaGPT 附录,如今它们正在逐步成为行业讨论的重点。最近有一个叫Ralph Loop的概念,他们强调在循环过程中,重要的不仅仅是智能体的能力,还需要好的评测手段。

BAAIBeijing的博客 711

智源Workshop33期丨Agent如何进化,内行人视角看OpenClaw

Agent 正从实验室的构想加速走向产业实践的前沿,从单一大模型的“单兵作战”到多智能体系统的“兵团协作”,从封闭环境的有限探索到开放生态的无限可能,智能体展示了 AI 在复杂场景下的协同能力,Agent正在经历一场前所未有的“模块重组”,其进化路径正在被重新定义。本期智源Workshop,我们特邀六位深度参与这场变革的学术工作者和探索者,以内行人的视角看OpenClaw现象,探路Agent未来发展趋势。

BAAIBeijing的博客 90

新“顶流”出道!让智源Robo,承包你的科研日常!

每一位搞科研的我们,都不满足于微小的涟漪,都坚信扎实的研究、默默的坚守与开放的行动,终将汇聚成推动技术前进的巨浪。左手是熬夜深耕的学术理想,右手是盼望丰收的烟火现实,两者都是咱们向上的劲儿!反复“对话”,一次次迭代优化,一点点调试参数,有崩溃、有挫败,但只要看到模型变好,就觉得一切都值得,这就是咱们AI科研人最真实的日常呀。科研就像种萝卜,越专注、越投入,就越陷越深~ 码代码、改论文,一晃就是一下午,哪怕熬到头疼,看到一点进展就又充满动力,这种痛并快乐着的沉浸感,是咱们科研人独有的浪漫!

BAAIBeijing的博客 296

携手ICLR 2026 RSI Workshop,解锁 AI 自进化新可能

它曾被视为遥不可及的科幻愿景,而今正成为迈向通用人工智能(AGI)的关键路径。想要使RSI成为可靠、可衡量和可部署的技术,需要有原则的方法、系统设计和评估。)获取最新动态,期待与各位相聚里约热内卢,现场交流探讨,共探 AI 递归自改进的未来之路,解锁通用人工智能发展新可能!参与支持,旨在汇聚全球顶尖研究者,共同探讨如何让AI实现可衡量、可靠且可部署的自我进化。:参数、世界模型、记忆、工具与技能、架构等。:软件、游戏、机器人、科学发现、企业应用等。:奖励/价值学习、模仿学习、进化搜索等。

BAAIBeijing的博客 251

Nature|全球首个医学循证推理DeepRare智能体,上交助理教授吴超逸分享

累计开源8个医学基础模型、7个大规模数据集和4个评测集,构建了当前医疗领域最大规模的多语种、多模态开源训练语料(涵盖1600万样本、255亿Token、六大语种),在GitHub及HuggingFace上收获超4600星标与24万次下载。论文数据显示,在仅提供患者临床表型信息而不包含基因数据的情况下,DeepRare展现出了惊人的“表型解码”能力。在多模态数据的加持下,其在复杂病例中的综合首位诊断准确率(Recall@1)一举突破70.6%,显著优于目前国际通用的Exomiser工具(53.2%)。

BAAIBeijing的博客 132

2026青源学术年会成功举办,青年力量共探“走向世界的模型”

从开发高精度触觉传感器,到推动AI在生物医药领域的应用,青年学者们的研究充满创新活力,彰显了全球华人青年AI研究社区的蓬勃生机。10日恰逢中国传统小年,年会特别策划了温馨的“小年夜”活动。随后的“围炉夜话”环节更是气氛热烈,大家围炉而坐、畅所欲言,在观点的交锋和跨学科对话中,深化了友谊,拓展了合作的边界。本届年会以“AI 前瞻:走向世界的模型”为主题,汇聚了来自中国、新加坡、美国、加拿大、澳大利亚、德国、沙特等10余个国家和地区的40余位优秀青年华人学者,为AI领域的青年力量搭建了开放、深入的交流平台。

BAAIBeijing的博客 196

本周四|香港大学&KiMi,开源OpenCUA:每人都可造专属电脑智能体

(3)一个可扩展的处理流程,能将操作演示转化为带有反思性长链思维推理(Chain-of-Thought)的状态-动作对,从而在数据规模扩大时持续保持性能提升。特别是OpenCUA-32B在OSWorld-Verified测试中取得了平均34.8%的成功率,成为开源模型中的新标杆(SOTA),并超过了OpenAI的CUA模型(GPT-4o)。由于这些代理将越来越多地介入我们的数字交互,并代表我们执行具有实际影响的决策,研究界迫切需要开放的CUA框架,以研究其能力、局限性和潜在风险。计算机使用任务跨操作系统。

BAAIBeijing的博客 138

刘知远深度分享:AI 浪潮之下,泳姿不重要,关键是先入水|智源专访

当 AI 领域的“玩家们”执着于 “更大模型、更多数据” 的规模扩张洪流时,刘知远早已锚定了一条务实且坚定的差异化路径。他跳出单纯追逐参数的内卷,以密度法则重构模型价值,在端侧智能与产研融合中探寻通用人工智能的落地密码。这位深耕 NLP 领域近二十年的清华大学长聘教授、面壁智能联合创始人和青源会发起人,见证并推动了中国的大模型浪潮,也在技术热潮中保持独有的清醒。从早年跟进 word2vec 深耕知识表示学习,到主导研发 ERNIE 预训练模型、参与打造 “悟道” 万亿大模型,再到推出 MiniCPM 端侧模

BAAIBeijing的博客 661

预告 | 2026 智源学者年会重磅来袭!

智源学者年会是智源研究院面向智源学者、顶尖AI研究者举办的年度生态大会,立足人工智能前沿、推动学术生态建设。大会将正式揭晓2025年度智源学者计划入选名单,并迎来新晋学者的首次集体亮相,同时由基础软硬件、具身智能等前沿方向的学者作报告分享。大会旨在搭建薪火相传的交流桥梁,凝聚学界共识,共迎产业变革,共塑可持续发展的AI学术生态高地。2月3日,让我们相聚智源学者年会,与百余位顶尖同行共话人工智能未来,在思想碰撞中寻找创新答案!本次活动以邀请制为主,秉承开源开放的理念,特开放部分公众报名名额。

BAAIBeijing的博客 142

<span class=“js_title_inner“>预告 | 2026 智源学者年会重磅来袭!</span>

智源学者年会是智源研究院面向智源学者、顶尖AI研究者举办的年度生态大会,立足人工智能前沿、推动学术生态建设。大会将正式揭晓2025年度智源学者计划入选名单,并迎来新晋学者的首次集体亮相,同时由基础软硬件、具身智能等前沿方向的学者作报告分享。大会旨在搭建薪火相传的交流桥梁,凝聚学界共识,共迎产业变革,共塑可持续发展的AI学术生态高地。2月3日,让我们相聚智源学者年会,与百余位顶尖同行共话人工智能未来,在思想碰撞中寻找创新答案!本次活动以邀请制为主,秉承开源开放的理念,特开放部分公众报名名额。

BAAIBeijing的博客 65

直播|AAAI 2026 Outstanding Paper Award 微软亚洲研究院,多模态表征模型能力边界LLM2CLIP

受大语言模型(LLM)在语言理解与知识建模方面快速进展的启发,本报告将介绍 LLM2CLIP:一种将 LLM 高效引入 CLIP 体系、显著扩展其多模态表征能力的通用框架。具体而言,LLM2CLIP 首先对 LLM 进行面向 CLIP 场景的“嵌入化”(embedding-ization),随后通过一个轻量级适配器将其与预训练的 CLIP 视觉编码器进行耦合,仅需在数百万规模的图文数据上进行微调即可完成训练,无需大规模重训模型。杨一帆,北京大学硕士。本期报告将由微软亚洲研究院杨一帆进行分享。

BAAIBeijing的博客 296
上一篇: 青源 LIVE 预告 | McGill李岳&Mila唐建团队新作:可迁移、可解释的单细胞RNA测序模型...
下一篇: 视觉Transformer快速入门指南!
智源社区
智源社区 企业官方账号 企业官方账号
博客等级 码龄6年 1629粉丝 629原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值